Google nano-banana(Gemini 2.5 Flash Image)をさらに使ってみる

こんにちは、Browncatです。
今回は、編集機能つき画像生成AIのうち、特にGoogle nano-banana(Gemini 2.5 Flash Image)に注目し、その使い方と、他モデルとの比較をさらに検証します。(2025.9.4、9.16改訂)
※nano-bananaという名称はもともと、Googleの編集機能つき画像生成AI「Gemini 2.5 Flash Image」のテスト版で、ベンチマーク時に出所を知られないためにつけられていた仮称ですが、それががリリース後も一般に定着し、Google自身すらその呼称を認めたため、以降は当ブログでも「nano-banana」と呼ぶことにします。
(1)イラストのフォトリアル画像化
前回記事で、nano-bananaによるイラストのフォトリアル画像化を他のモデルへの適用例にならってやってみたところ、うまくいかなかったため、前回記事はnano-bananaによるフォトリアル化の実例を出せず、やむなくフォトリアル画像のイラスト化他の検証を先に載せるという状況でした。
あれこれ試しているうちに、イラストの人物をコミケでコスプレしている姿に変換する事例が登場しました。
他の4人も。
— らけしで / Mizmic Studio (@lakeside529) August 28, 2025
プロンプトは「Generate a photo of a girl cosplaying this illustration, with the background set at Comiket.」
色々と再現度すご😳 https://t.co/AkonQGyriE pic.twitter.com/Gok5E5Me3g
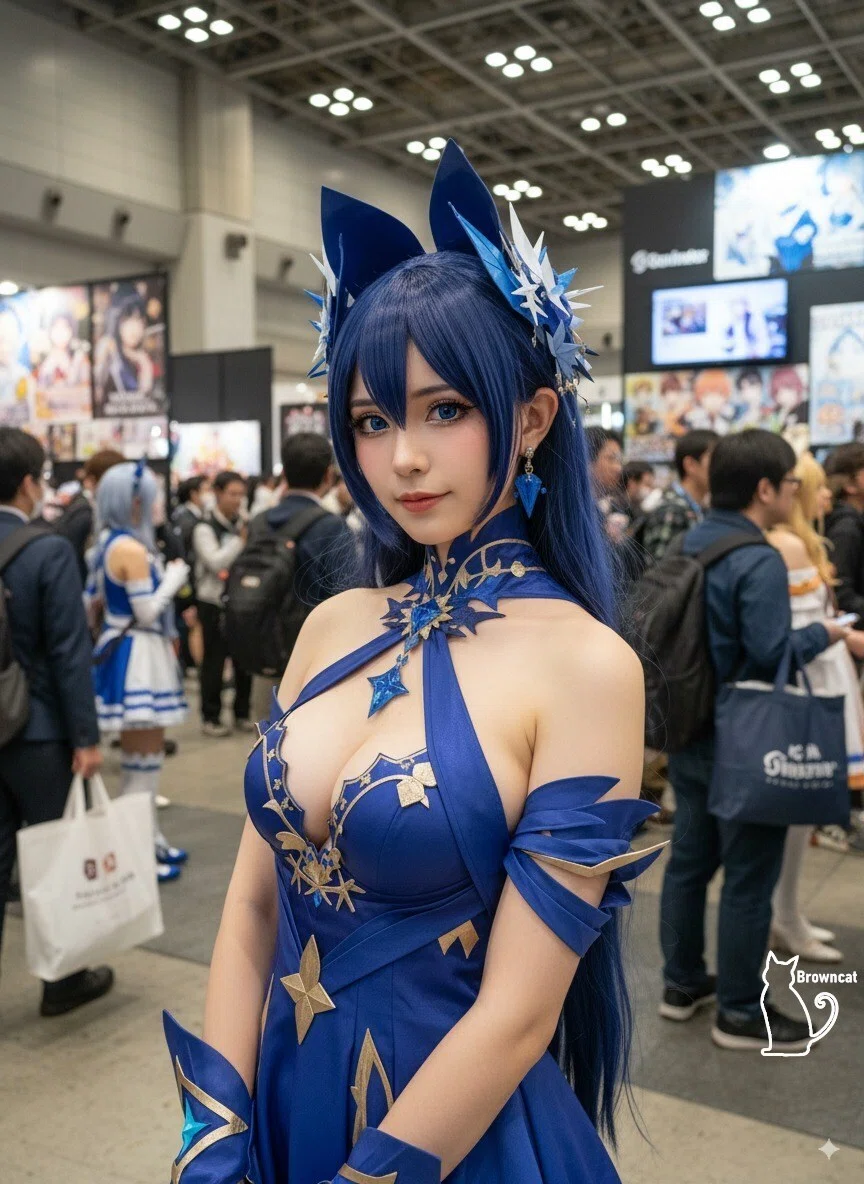
悔しい・・・という気持ちはできるだけ抑えて、とりあえず公開されているプロンプトをそのまま流用した結果、確かにイラストのフォトリアル画像化ができました。
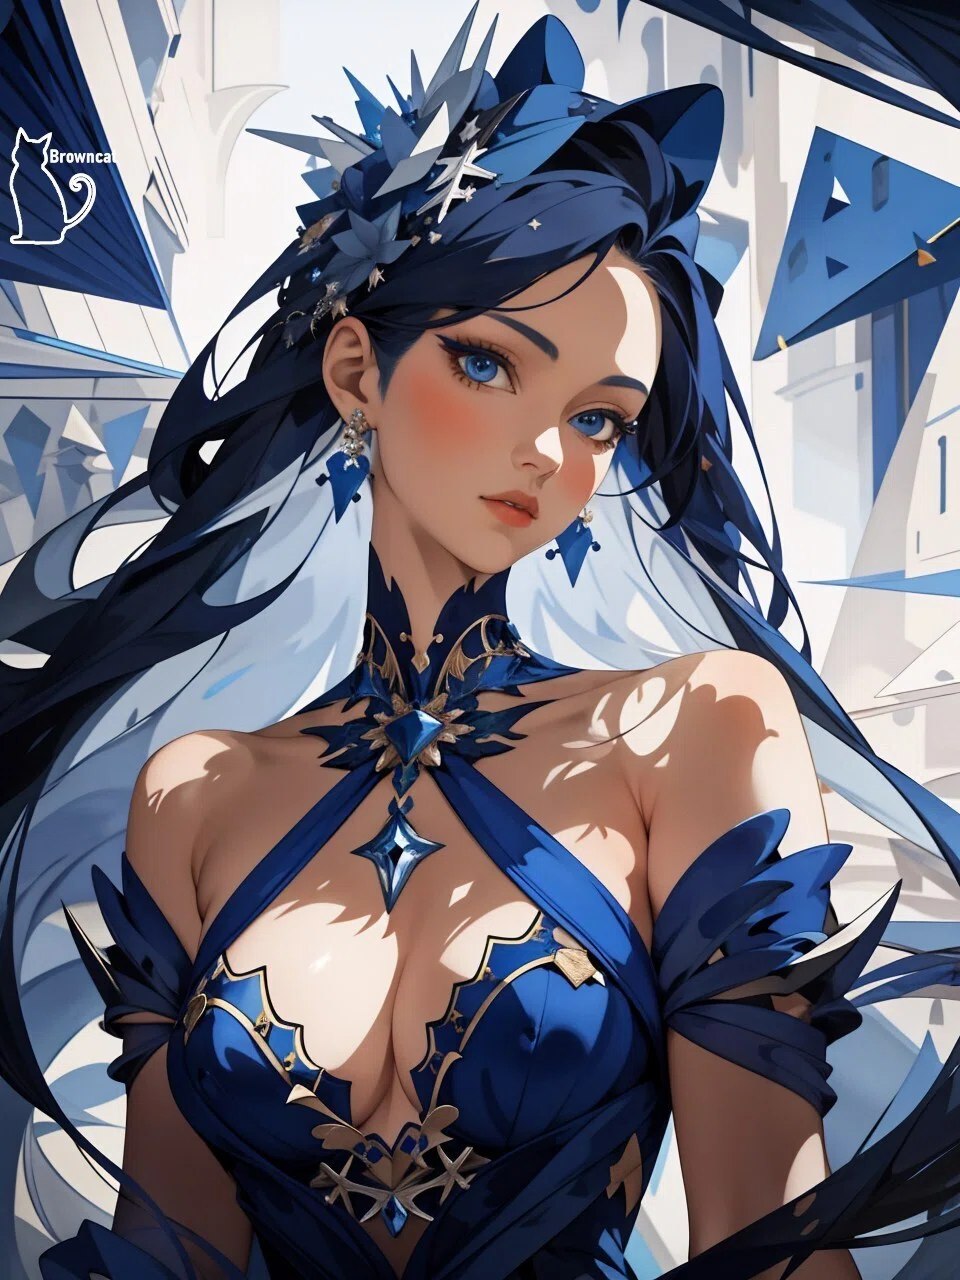
【元画像】(再掲)
【nano-banana】
【プロンプト】
Generate a realistic photo of a girl cosplaying this illustration, with the background set at Comiket.
ではGPT-Image-1など他モデルではどうかといえば、それぞれ出ます。以下はGPT-Image-1の例です。
【GPT-Image-1】
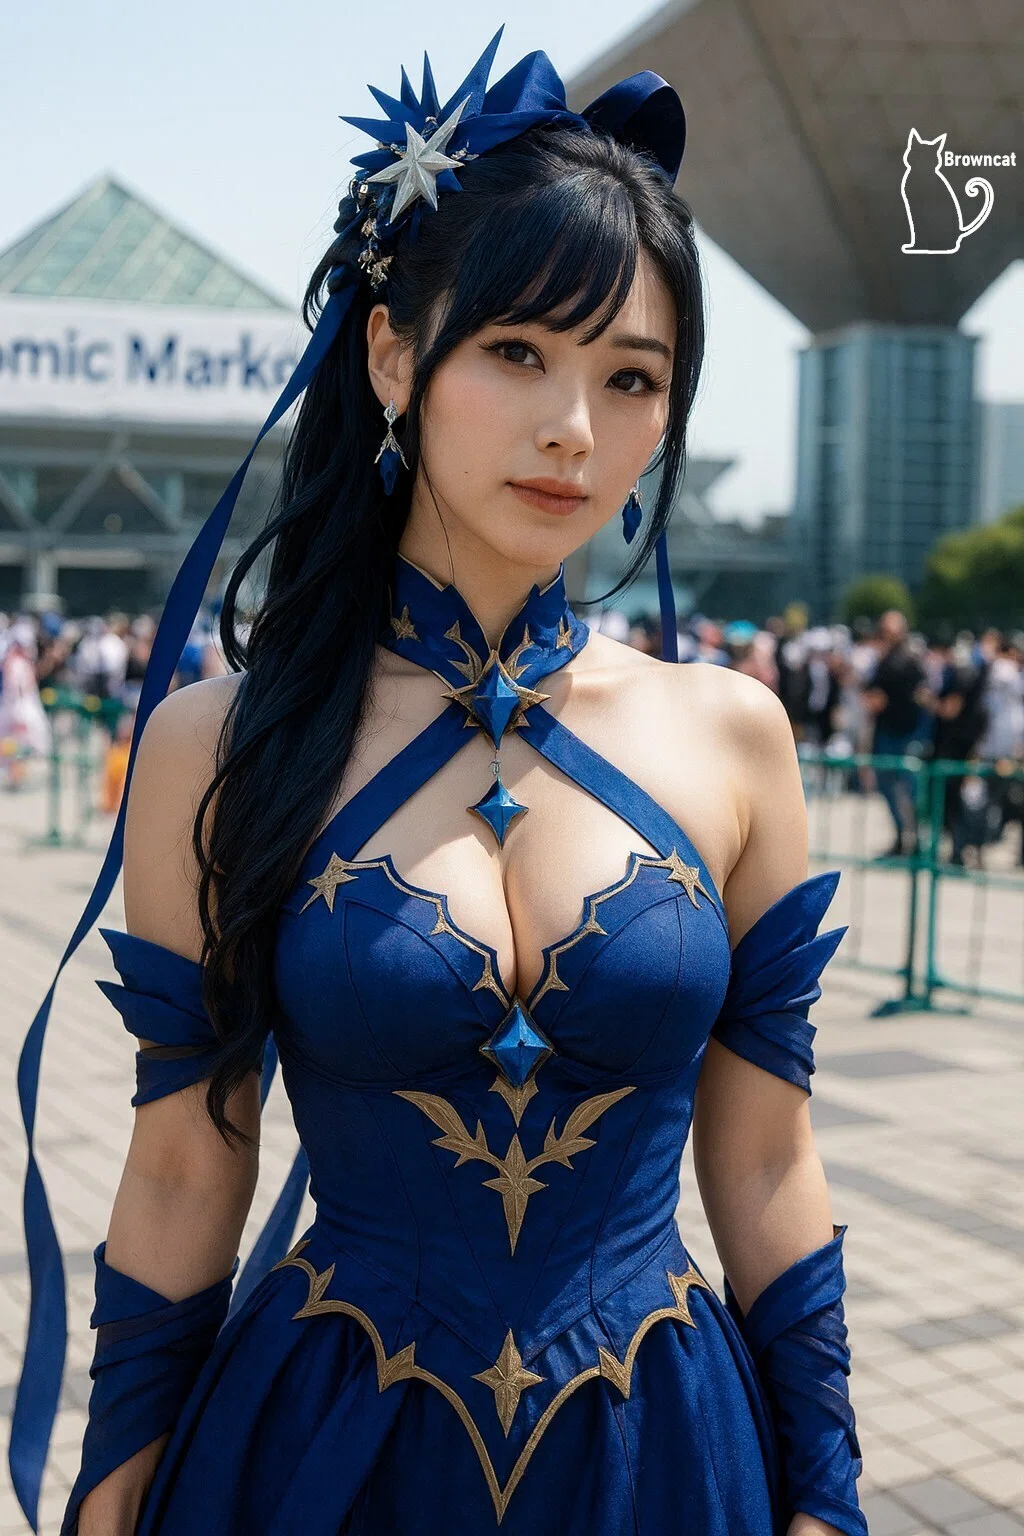
ただし、背景の詳細さと臨場感、それに生成速度は、いずれもnano-bananaが他を上回ります。言い換えれば、nano-bananaはサクッと綺麗な編集ができるということです。
SNSには背景がコミケ会場の画像が多く出回っていますが、プロンプトを変えれば、背景はコミケ以外も可能です。以下は背景をコミケ会場から城に変更したものです。
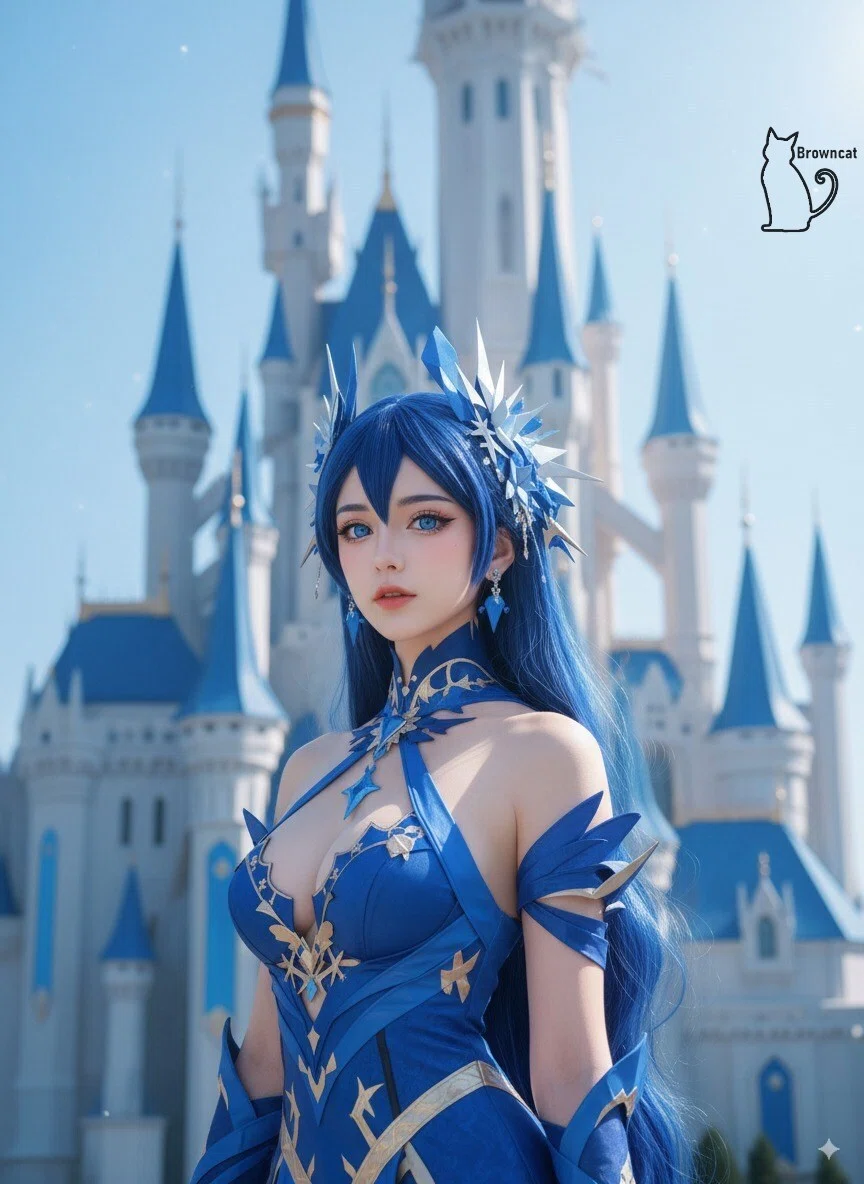
要は、背景を指示さえすれば、イラスト画像のリアル化の成功確率が高くなるということだったのです。逆に、nano-bananaに背景なしでただ実写化してくださいと指示してもうまくいきません。
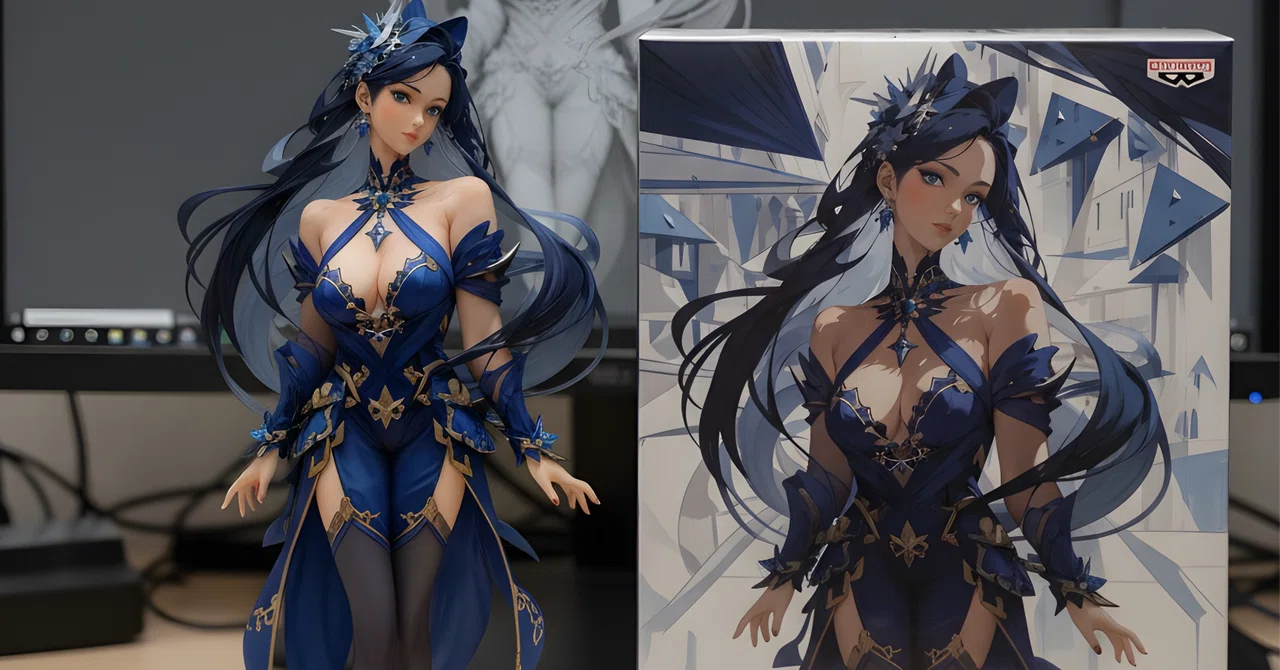
(2)入力画像のフィギュア化
入力画像のフィギュア化もSNSでよく見ます。
筆者は下記のSNS記事を参考にしました。https://x.com/YunFeng_cc/status/1960595387716112555
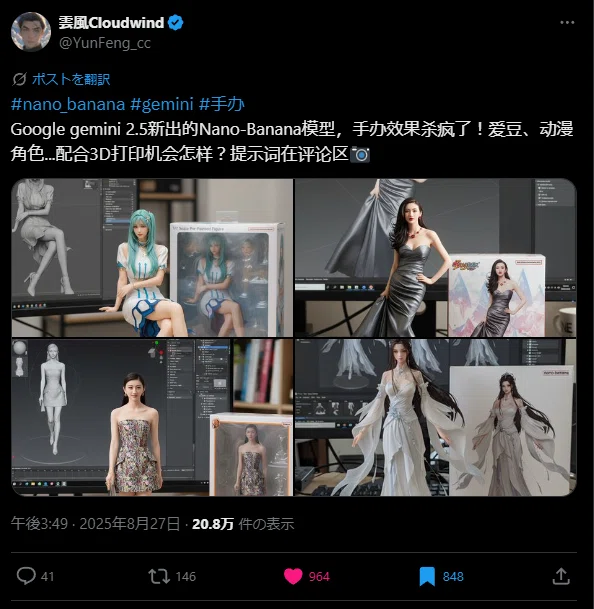
【プロンプト】
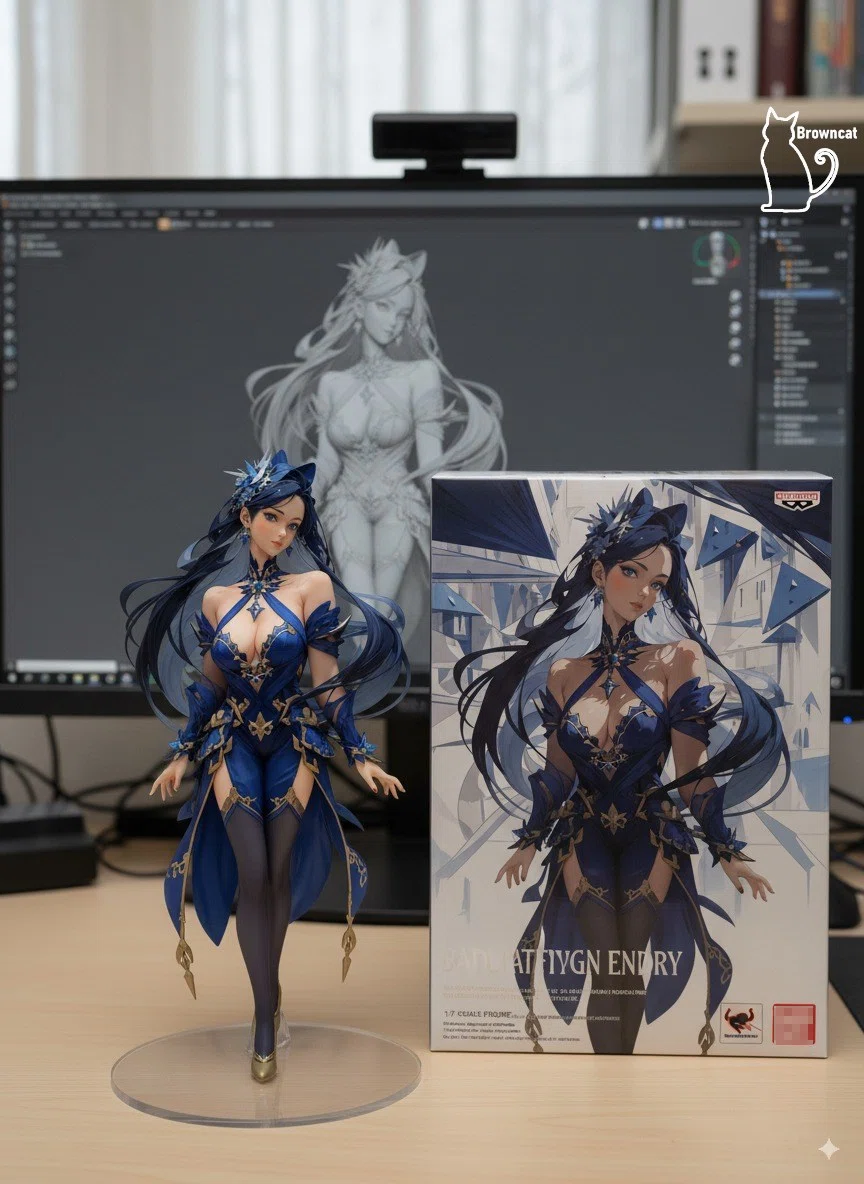
create a 1/7 scale commercialized figure of the character in the illustration, in a realistic style and environment. Place the figure on a computer desk, using a circular transparent acrylic base without any text. On the computer screen, display the ZBrush modeling process of the figure. Next to the computer screen, place a BANDAI-style toy packaging box printed with the original artwork.
【入力画像】
フォトリアル系でもイラスト系でも生成可能ですが、イラストのほうが2次元→3次元変換を楽しめるので、今回は上の(1)と同じイラストを試してみました。
【nano-banana】
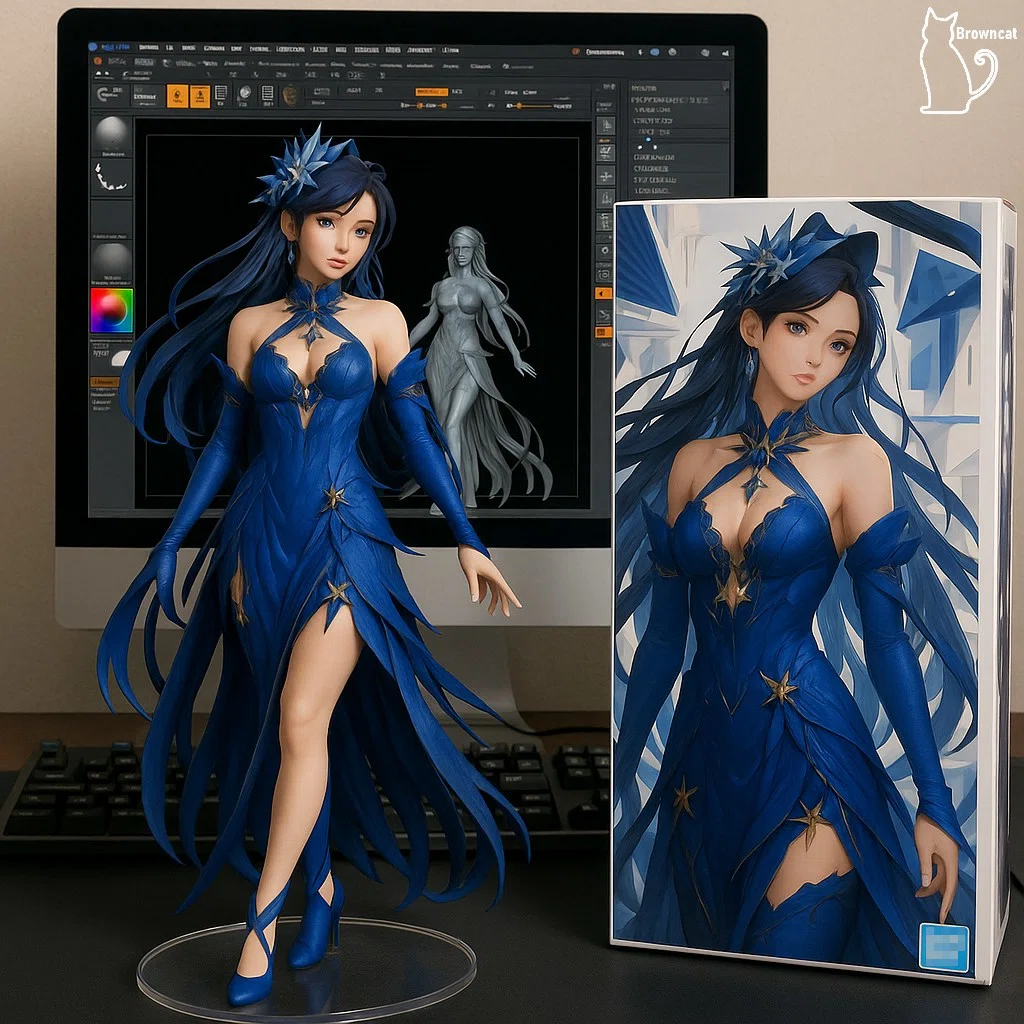
【GPT-Image-1】
こちらも他モデルでもできて、やはりGPT-Image-1の例を挙げます。しかし、フィギュアの元画像からの忠実度や、生成の速さという点でnano-bananaは魅力的です。
(3)線画と文字によるポーズの指示
線画と文字によるポーズの指示も試してみました。
【入力画像】
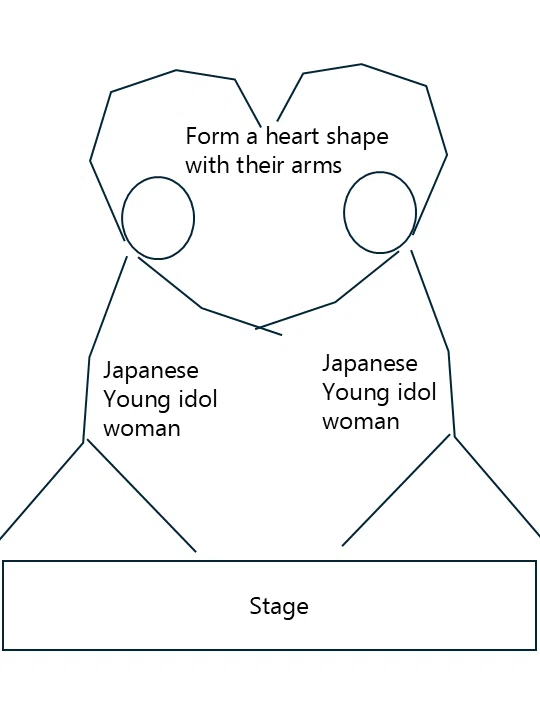
アイドル2名が、舞台の上で全身と腕を使ってハートマークを作るという状況を具現化します。
そこでまずは、以下のような線画と文字による指示をつけたものを作成し、図1とします。
非常に概念的な図ですが、これでもうまくいきます。
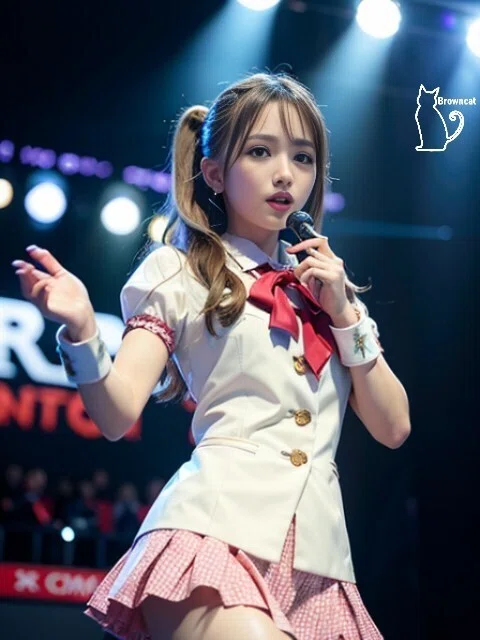
次に、線画に実体としての人物像を与える画像を入力し、図2とします。
ここでは画像のようなピンク色の制服を着たアイドルを指定します(2年以上前に、SD1.5で生成していたものです)。今回は二人とも同じ衣装を前提としていますが、左右それぞれに異なる衣装の画像を与えることも可能です。
プロンプトは以下のようにします。
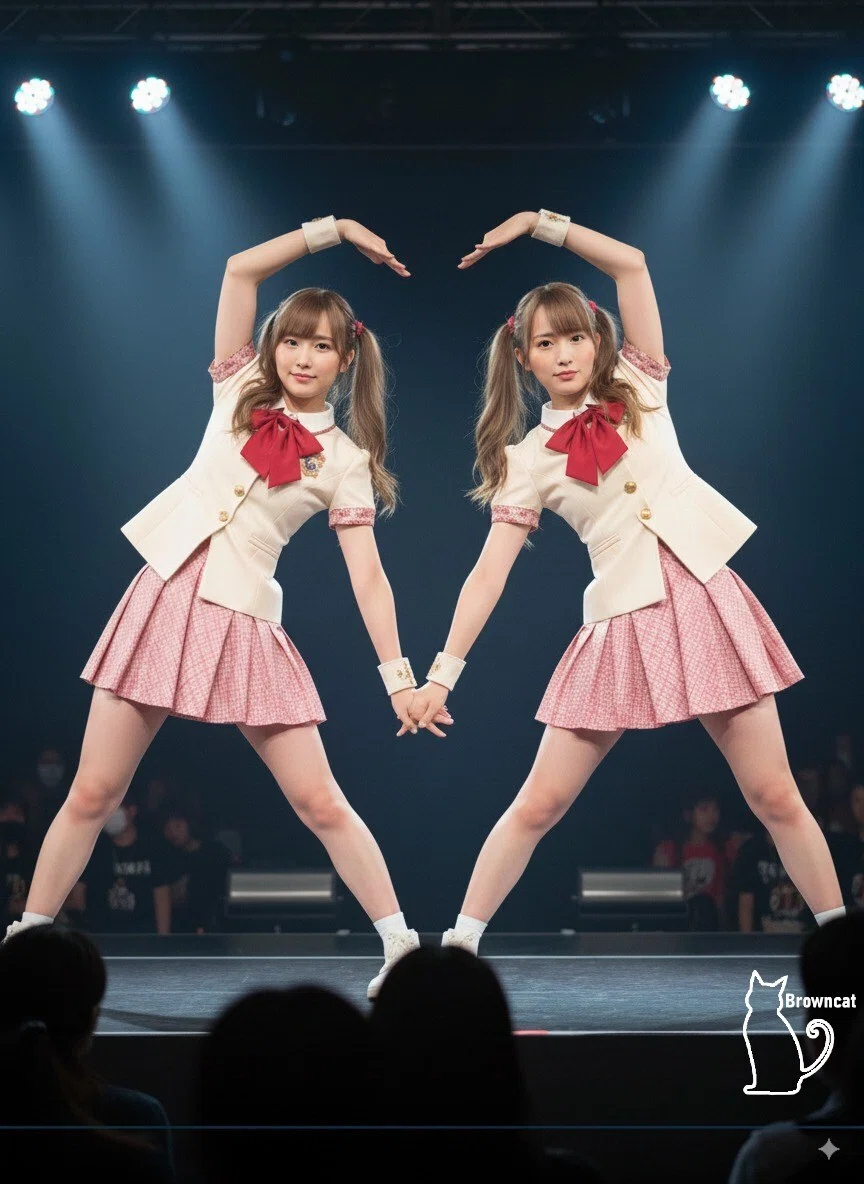
Please have the two young, beautiful Japanese female idols strike the pose shown in the first attached image on stage. Their costumes are as shown in the second image. They are holding both hands together.
【nano-banana】
結果は以下のようになります。
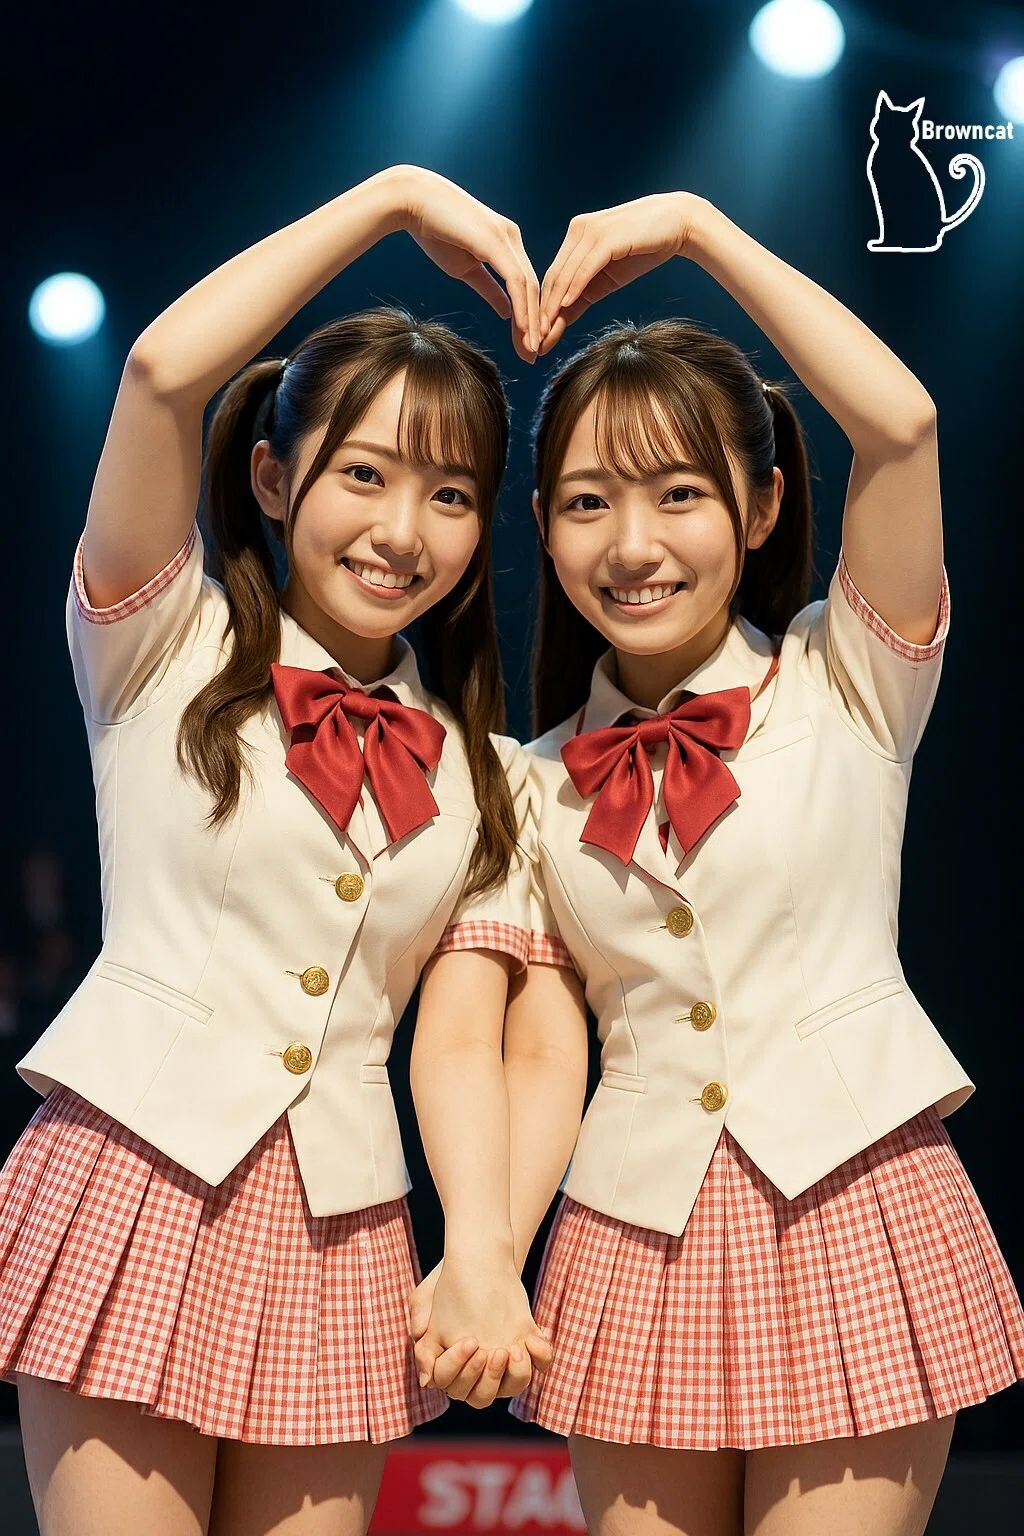
【GPT-Image-1】
こちらも他モデルでもできます。またしてもGPT-Image-1の例を掲げますが、やはり生成速度がnano-bananaのほうが速いです。
他の事例
以下の記事に、nano-banana(Gemini 2.5 Flash Image)による「ポーズ・表情・ズームの変更」「白黒画像のカラー化」「フォトリアル画像のイラスト化」の事例を他モデルと比較しておりますので、併せてご参考ください。
また、nano-bananaの事例に関しては、以下のサイトに豊富な種類の事例があります。
まとめ
編集機能つき画像生成AI「nano-banana(Gemini 2.5 Flash Image)」について、イラストのフォトリアル画像化を試したほか、入力画像のフィギュア化、線画と文字によるポーズの指示も試してみました。
それらはGPT-Image-1など他モデルでもできるものの、nano-bananaには、他に比べ生成速度が速い、元画像からの忠実度が高いなどのメリットがあります。
ここまでお読みくださり、ありがとうございました。
参考
・Googleによる公式のnano-banana画像生成ガイド
