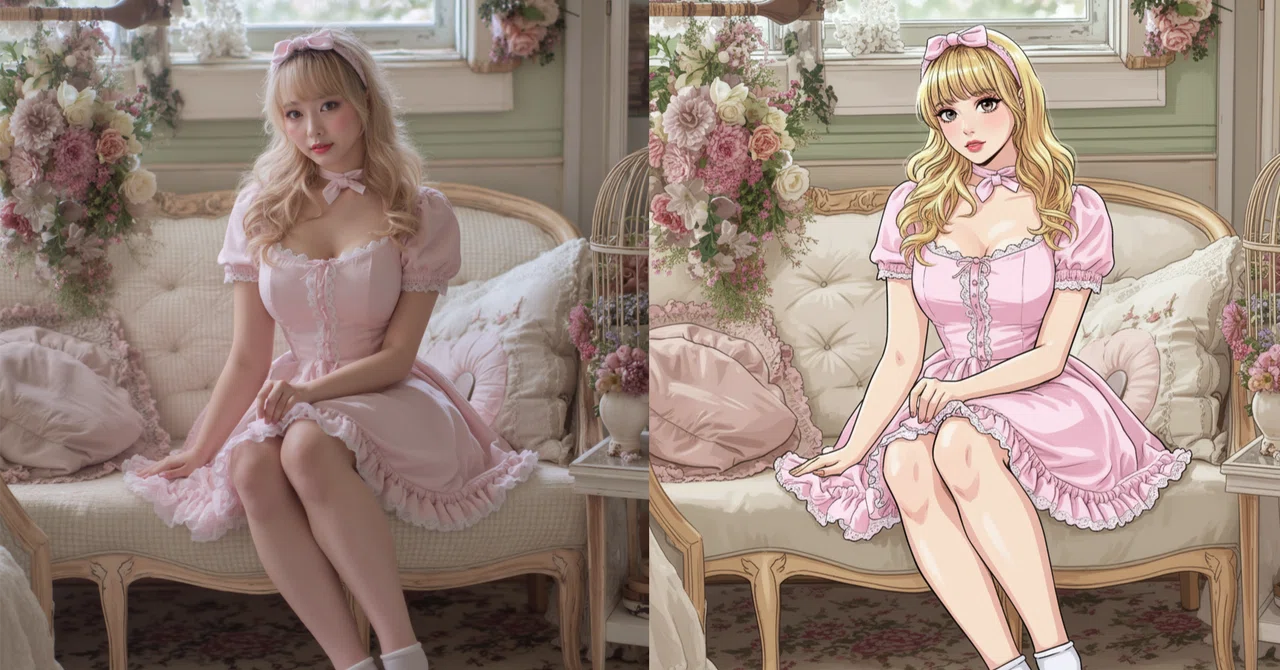
編集(Edit)機能つき画像生成AIの比較~FLUX.1 Kontext[dev]、Qwen-Image-Edit、nano-banana(Gemini 2.5 Flash Image)

こんにちは、Browncatです。
動画生成AIが普及しても、静止画生成AIのリリースが止まりません。
ここでは、最近特に話題になっている、編集(Edit)機能つき画像生成AIをとりあげ、各モデルを比較します。(2025.9.4、9.27改訂)
編集(Edit)機能つき画像生成AIについて
ここでは総称して、「編集(Edit)機能のある画像生成AI」と呼びますが、それは従来のテキストから画像へ(t2i)や、画像から画像へ(i2i)とは異なり、入力画像に所定の効果を得るための指示をして、効果がかかった画像を出力するというものです。
画像入力があるという点はi2iと同じですが、i2iは基本的に、プロンプトにはt2iと同様に「何を描かせるか」を書きますが、編集機能のある画像生成AIは、入力画像にどんな効果を与えるかを書きます。
言葉で説明してもわかりづらいので、以降は、画像生成AIモデルを紹介してから、典型的な編集機能を、生成例によって示そうと思います。
編集機能つき画像生成AIの種類
以下、今回比較対象にする編集機能つき画像生成AIの種類を簡単に説明します。
FLUX.1 Kontext [dev]
FLUX.1 Kontext [dev]は、FLUX.1を開発したBlack Forest Labs社が25年6月26日にリリースした編集機能つき画像生成AIです。
FLUX.1 Kontext系列には、「FLUX.1 Kontext [dev]」の他に「FLUX.1 Kontext [pro]」と「FLUX.1 Kontext [max]」がありますが、devと他との大きな違いは、dev版がオープン化されていることです。
他のpro版とmax版はオープン化されておらず、それらの使用には、「fal.ai」などの生成AIクラウドサービスを利用することになりまます(もちろん、[dev]版もfal.ai等で利用可能)。
一方、FLUX.1 Kontext [dev]は、オープンゆえにローカル環境での利用が可能で、開発・AI生成環境の「ComfyUI」を使って、比較的楽に導入できます。
インストールには、ComfyUIの「テンプレートを利用して開始」から「Flux Kontext Dev」を選択すれば、必要なワークフローをダウンロードできます。
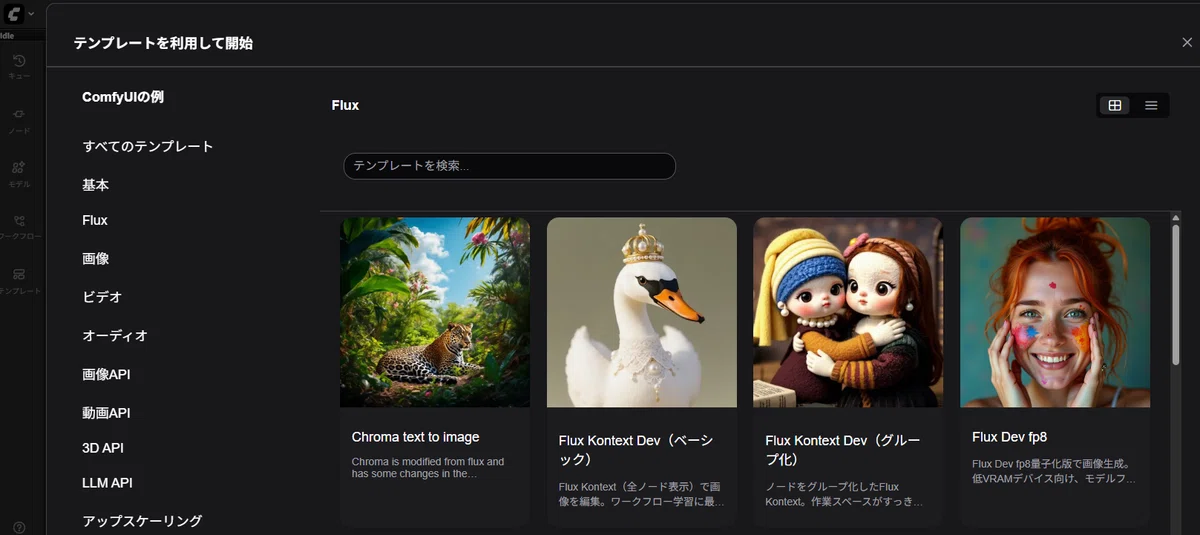
ComfyUI自体のインストールから、モデルのダウンロードまでの手順について詳しくは、「AI愛create」さんのブログ(note)をご覧ください(新技術導入から記事化までが短く、説明が平明かつ正確なので、私もたびたびお世話になっています)。
Qwen-Image-Edit
Qwen-Image-Editは、中国Alibabaの大規模言語モデル「Qwen」シリーズのひとつで、8月19日にリリースされました。先行してリリースされた画像生成AI「Quen-Image」の画像編集版といえます。
(Alibabaにはもうひとつ、動画生成モデル「Wan」シリーズから派生したものもあり、2系統の画像生成AIが並立しています)
Qwen-Image-Editもまたオープン化されており、ComfyUI等を使ってローカル環境にインストール可能です。ComfyUIの「テンプレートを利用して開始」でインストールするのがわかりやすいです。インストール方法は「AI愛create」さんのブログを参照してださい。
【追記ーQwen-Image-Edit-2509について(2025.9.27)】
Alibabaは9月に、Qwen-Image-Editの改善版である「Qwen-Image-Edit-2509」をリリースしました。
Qwen-Image-Editの元の版は、下記の通り編集により画像が縮小してしまう問題がありましたが、それは2509版で改善されました。
さらに2509版では、3枚までの画像を編集用として入力できるようになりました。ComfyUIも同版に対応しています。
2509版による改善状況も後述します。
今後は、Qwen-Image-Editは、画像1枚の編集であっても、2509版の使用を強く勧めます。
nano-banana(Gemini 2.5 Flash Image)
Googleは2025年8月26日、編集機能つき画像生成AI「Gemini 2.5 Flash Image」を公開しました。
それ以前は、ベンチマークサイト「LMArena」で、「nano-banana」という謎の名前で試運転されており、リリース前からずいぶん話題になっていました。
Our new native image generation and editing is state-of-the-art, and ranked #1 in the world. And we're rolling it out for free to everyone today.
— Google Gemini App (@GeminiApp) August 26, 2025
You’ve got the tools. Now go bananas. Ideas & inspiration in the 🧵below. pic.twitter.com/mw7XyG5nes
Gemini 2.5 Flash Imageは非オープンで、Googleの生成AIプラットフォーム「Gemini」の一部で、同社の生成AIポータル「Google AI Studio」で使用可能になっています。
なおGoogleも静止画生成AIは、対話的に画像編集が可能な「Gemini」系列と、高画質フォトリアル生成AIの「Imagen」系列の2系統になっています。
※Googleはモデルのリリース後、Gemini 2.5 Flash Imageを公式に「nano-banana」と呼び始めましたが、本稿では同モデルを「nano-banana(Gemini 2.5 Flash Image)」と呼ぶことにします(本稿より後の記事では、単に「nano-banana」と呼ぶこともあります)。(2025.9.4)
GPT-Image-1(参照用)
詳しくはこちらをご覧ください。リリース当時は「4o Image」と呼ばれていました。
編集機能つき画像生成AIの比較
それでは、以前の記事『OpenAI 「4o Image」の使用経験』に倣って、いくつかの使用例でFLUX.1 Kontext[dev]、Qwen-Image-Edit、Gemini 2.5 Flash Imageと、参照用にGPT-Image-1を相互比較します。
ポーズ・表情・ズームの変更
今回は以前の記事と異なる絵柄で、ポーズ・表情・ズームの変更を試みます。
こちらは元画像です(Reveで生成)。
【元画像】
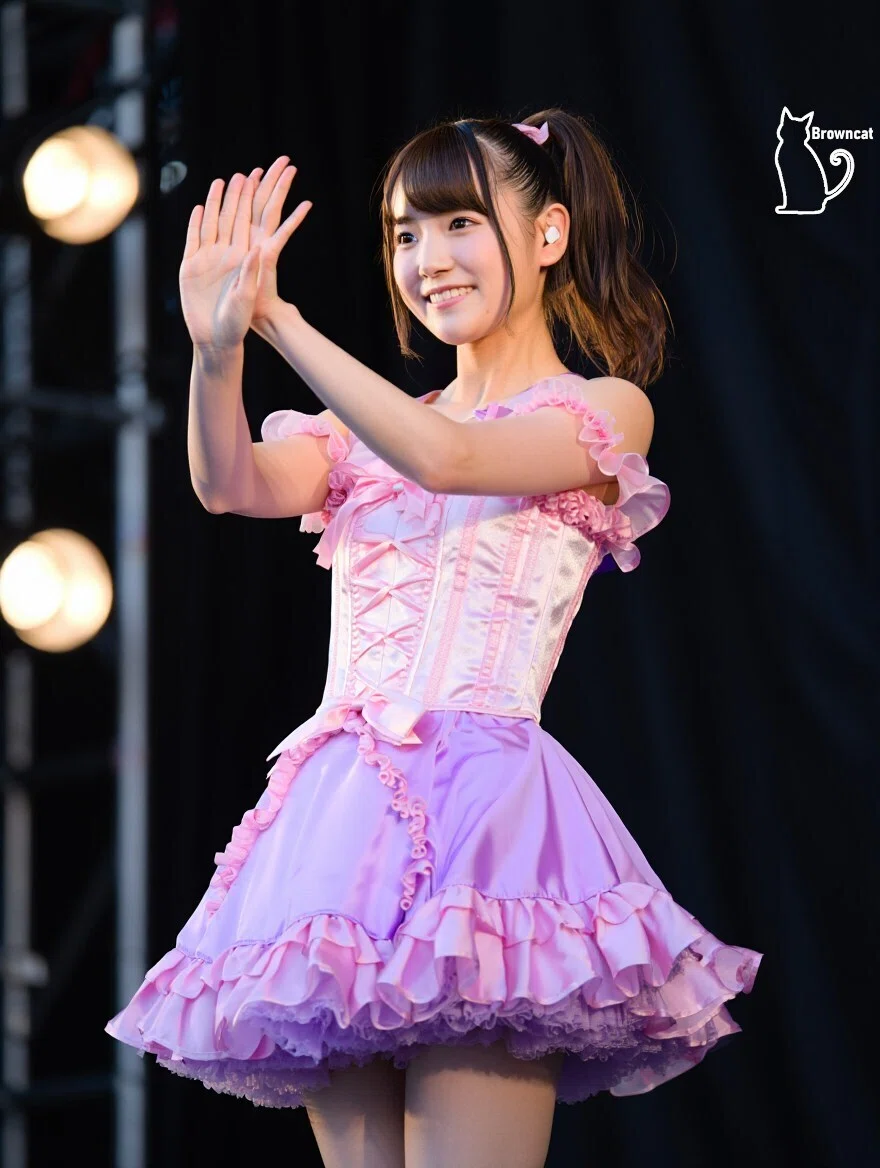
この画像を以下のプロンプトで編集します。
A cinematic continuous shot: A young Japanese woman smiles and forms a heart shape with both hands. As she poses, the camera gradually zooms in from medium shot to close-up, capturing her face and heart gesture with smooth motion.
このプロンプトにより、「微笑み、両手でハート形を作る」対象人物の動作と、「中距離ショットからクローズアップへと徐々にズームイン」というカメラの動作を実現します。
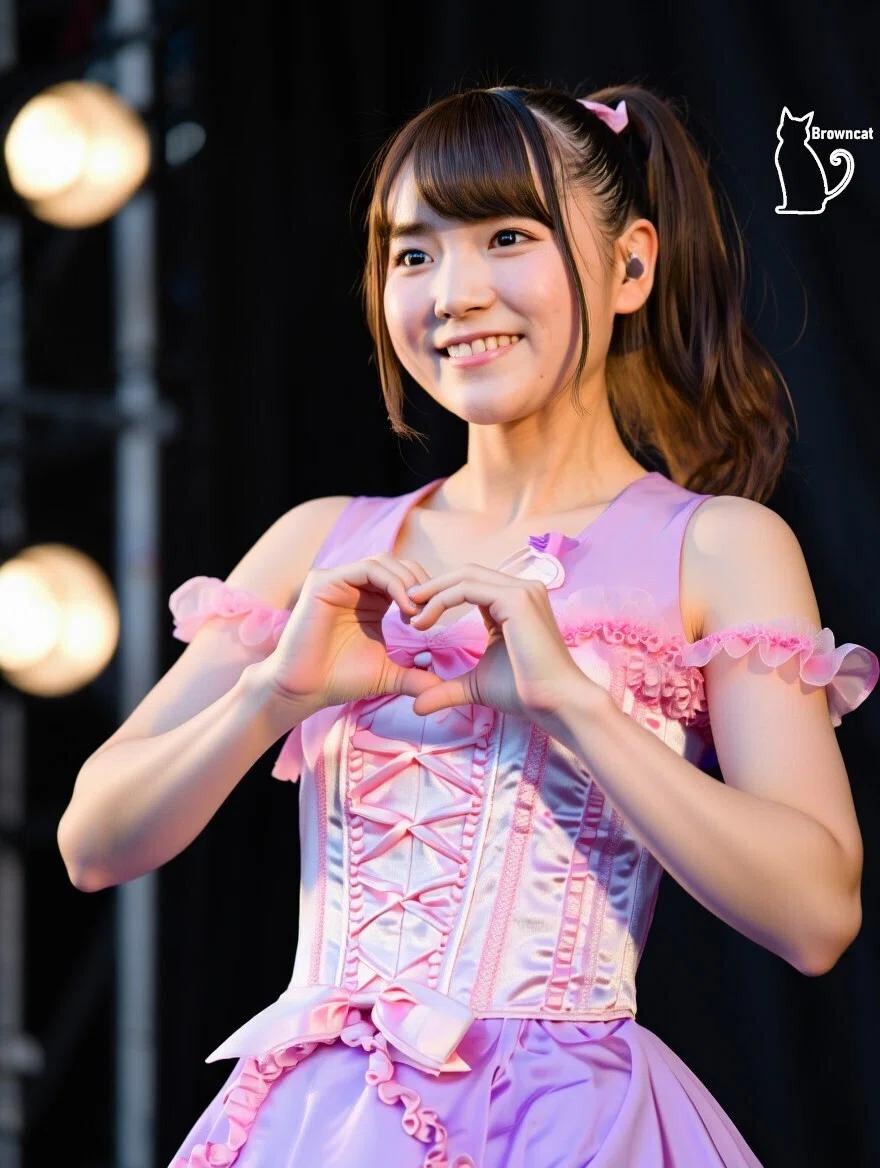
【FLUX.1 Kontext [dev]】
【Qwen-Image-Edit】
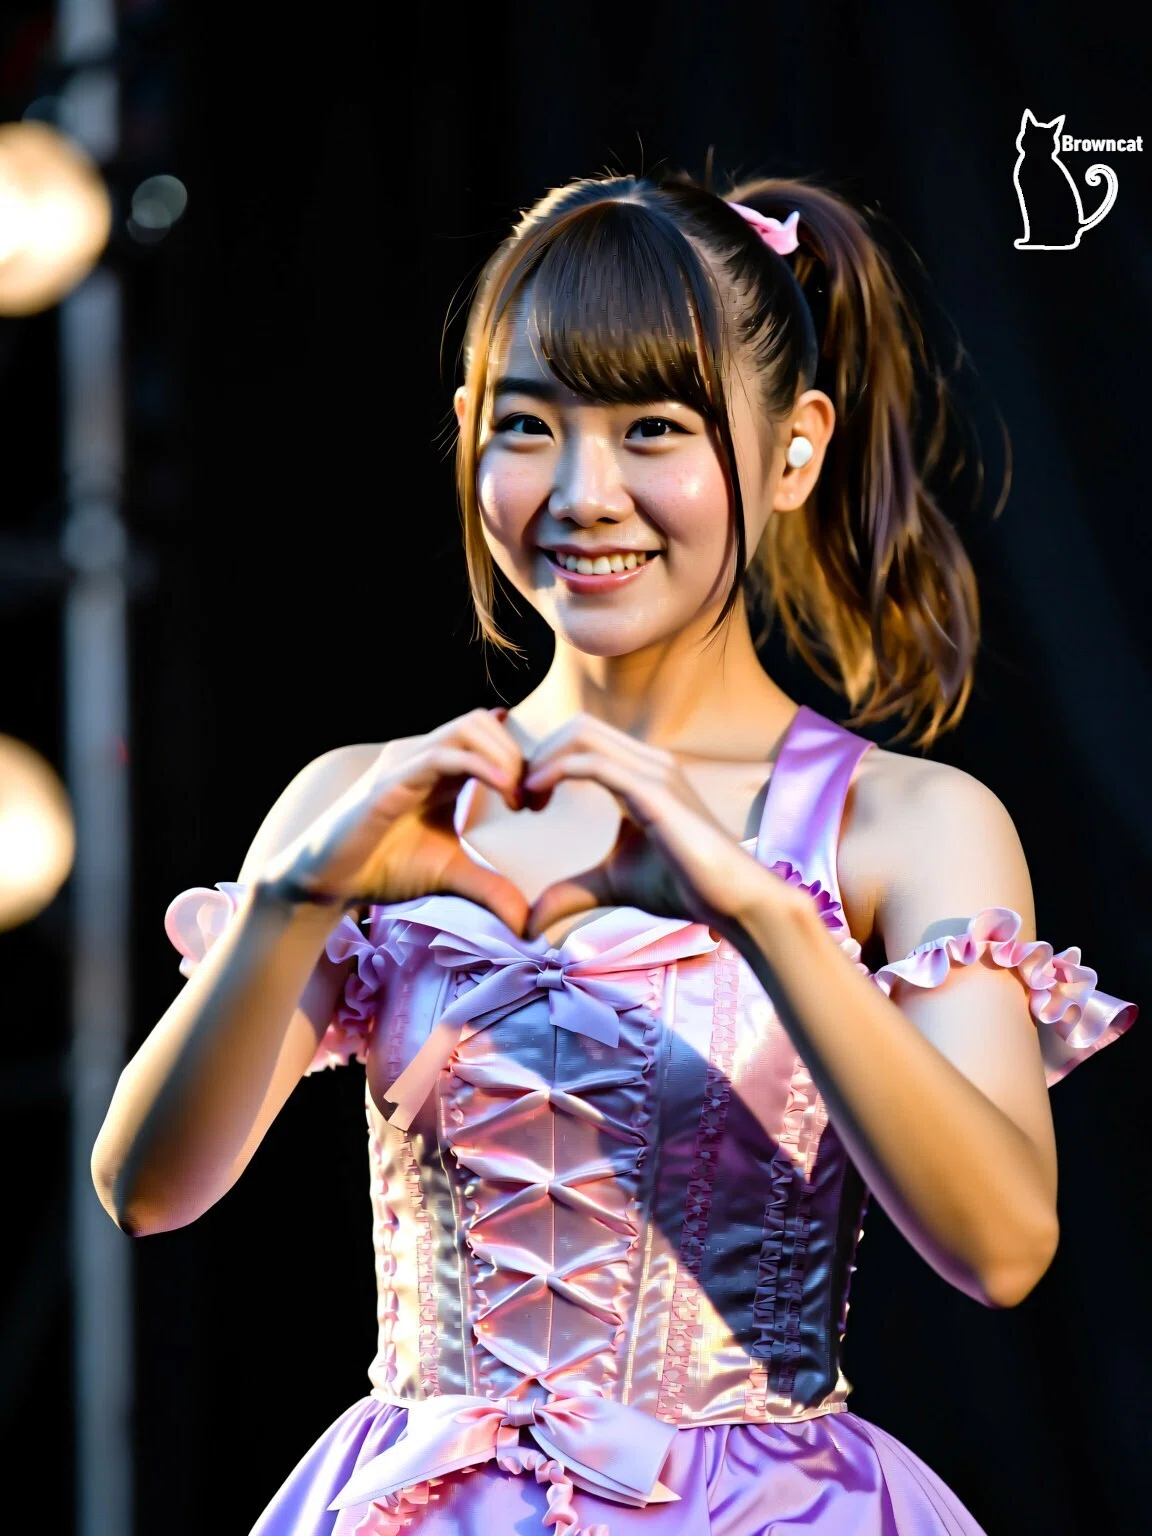
【nano-banana(Gemini 2.5 Flash Image)】
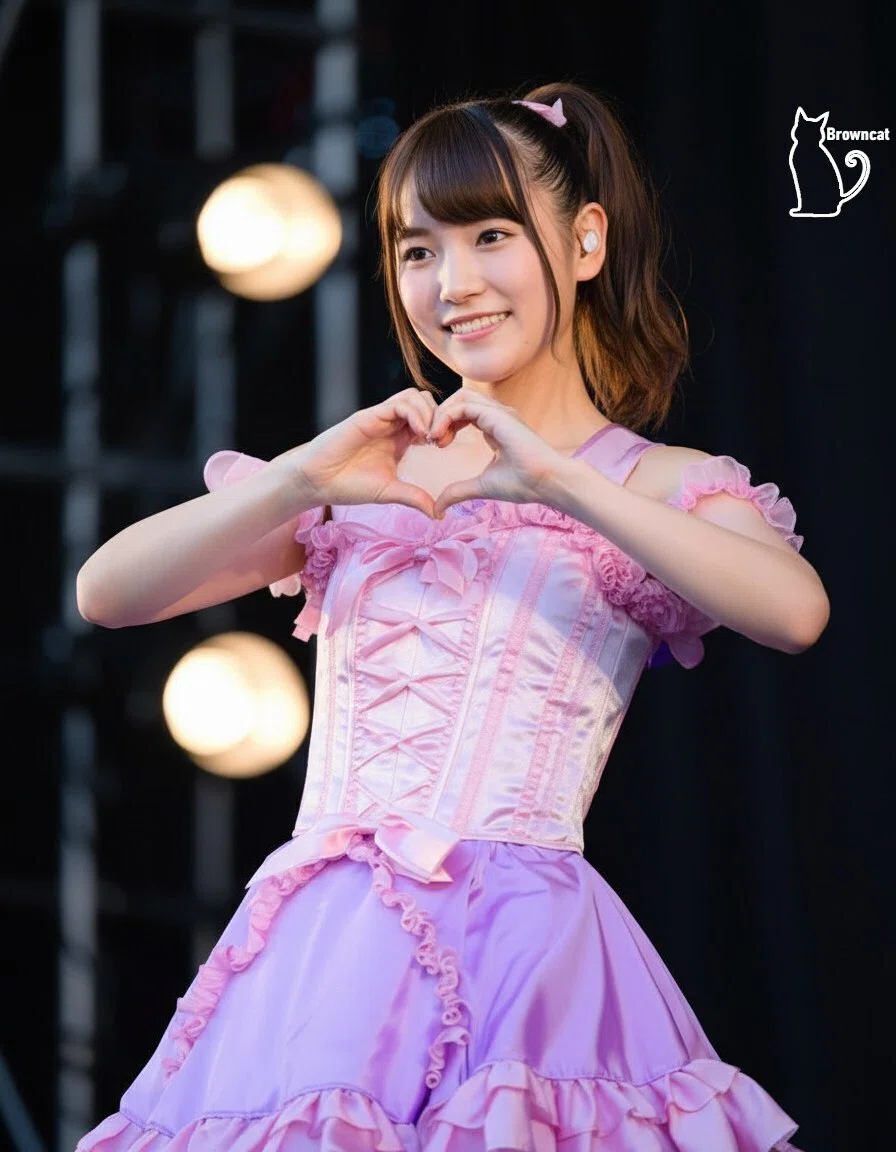
【GPT-Image-1】
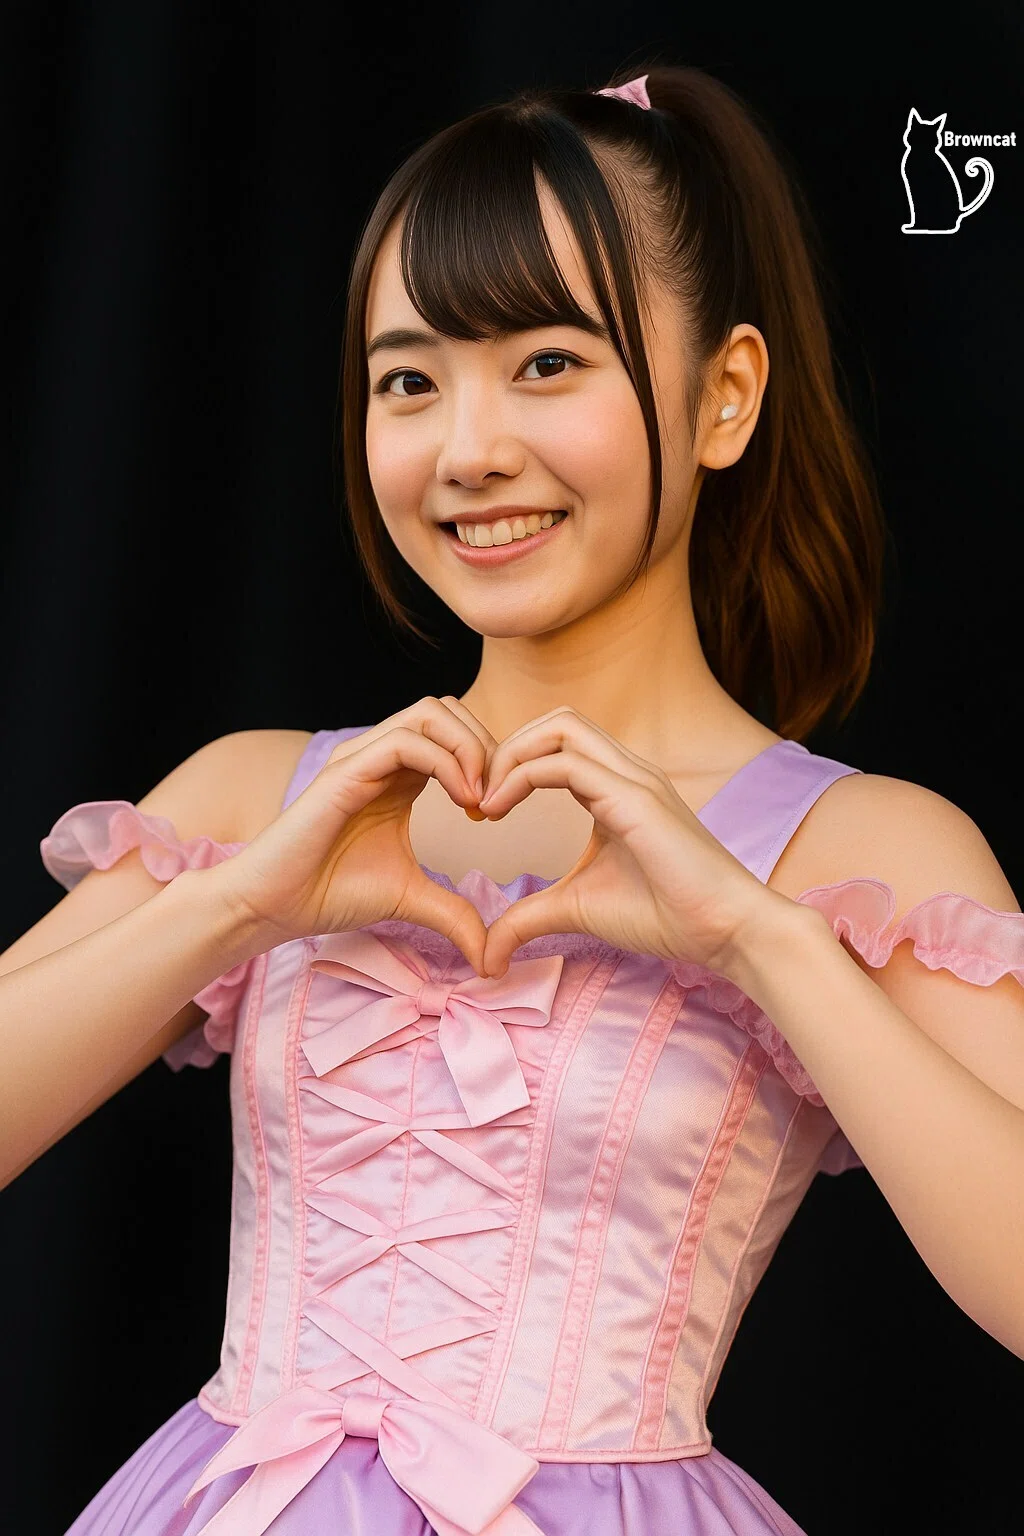
どれが最もよいかは一概に言えませんが、やや厳しめに評価すれば、概要以下の通りになるでしょう。
FLUX.1 Kontext [dev]:画像のコントラストは元画像に近い。ハートを形作る手の形が若干あいまい。イヤホンの色が違う。
Qwen-Image-Edit:ハートを形作る手の形状は良好だが、フォーカスがやや外れたように見える。画像のコントラストが元画像より強い。
nano-banana(Gemini 2.5 Flash Image):人物の一貫性や輝度コントラスト・色の同一性は、こちらが最も自然。ハートの手の形状も安定している。一方、ズームの倍率はこちらが最も小さい。
GPT-Image-1:ハートを形作る手の形状が綺麗で、高精細でくっきりしている。しかし色温度が元画像から変わってしまう。
FLUX.1 Kontext [dev]は何回か繰り返しましたが、やはり手の形があいまいになる傾向が見られます。この点では、max版やpro版のほうが良好な結果になる傾向があるのはわかっています。
白黒画像のカラー化
白黒画像のカラー化の自動化は、生成AIが普及する以前から需要があった分野ですが、各モデルで白黒画像のカラー化を試してみました。
元画像は、GPT-Image-1の検証の時にImagen 3で生成していたものです。
【元画像】
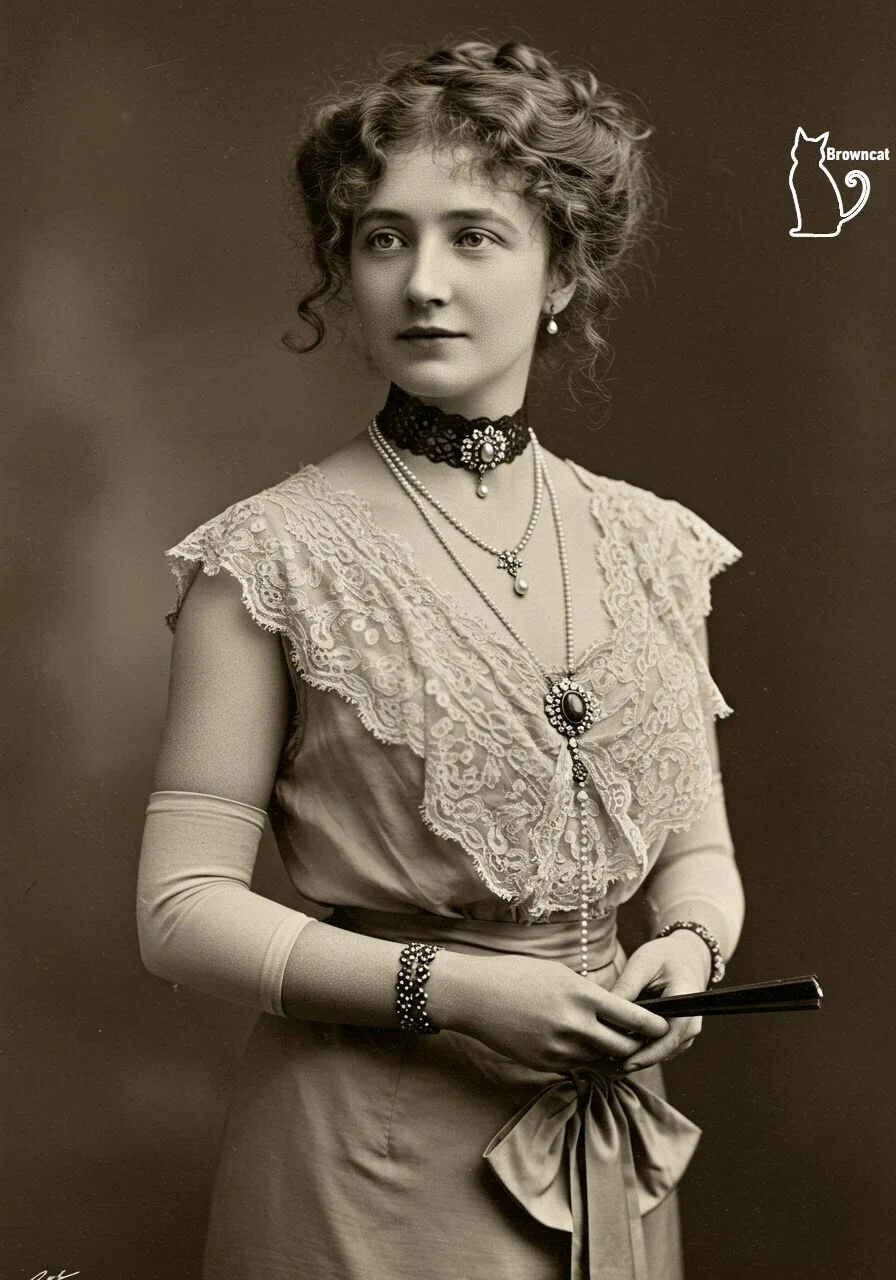
この白黒画像に対し、以下のプロンプトでカラー化を行います。
Colorize the retro picture to a modern, very high reality super resolution digital photograph.
結果は以下の通りです。
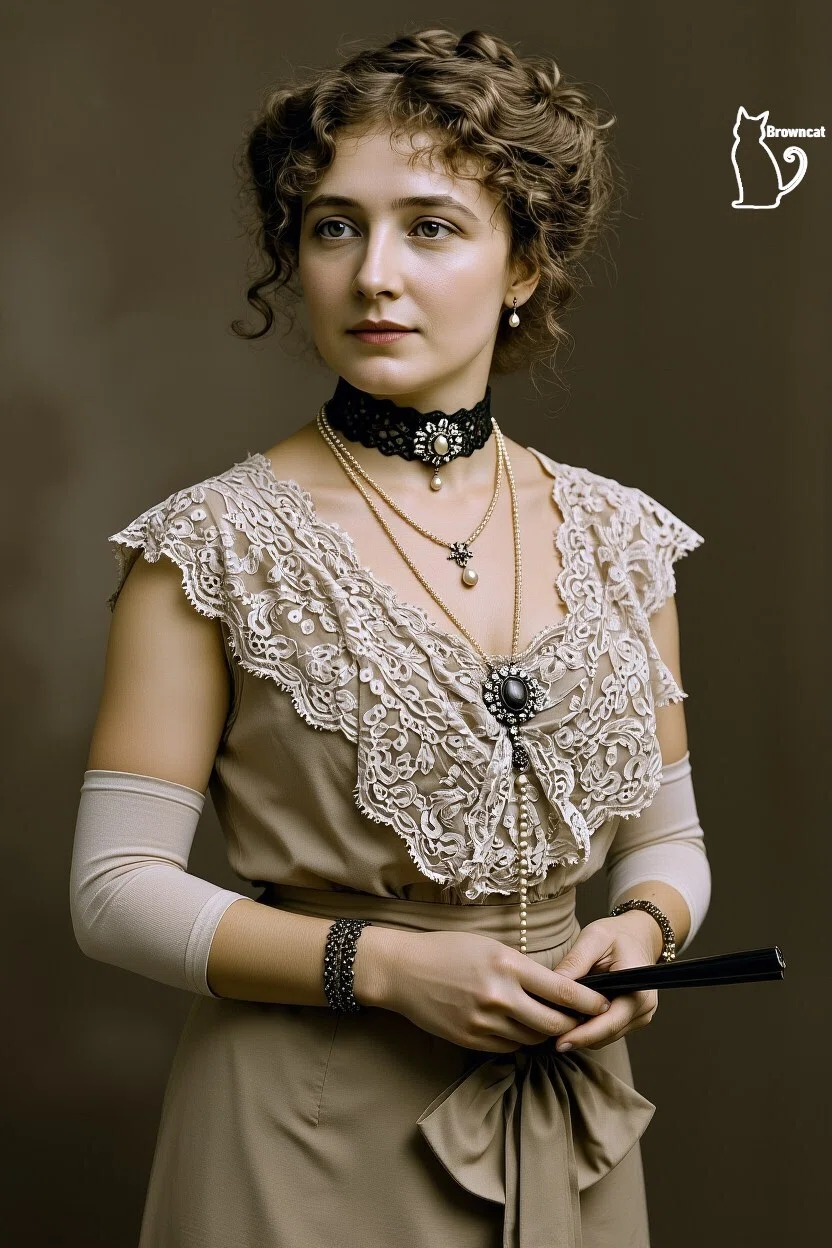
【FLUX.1 Kontext [dev]】
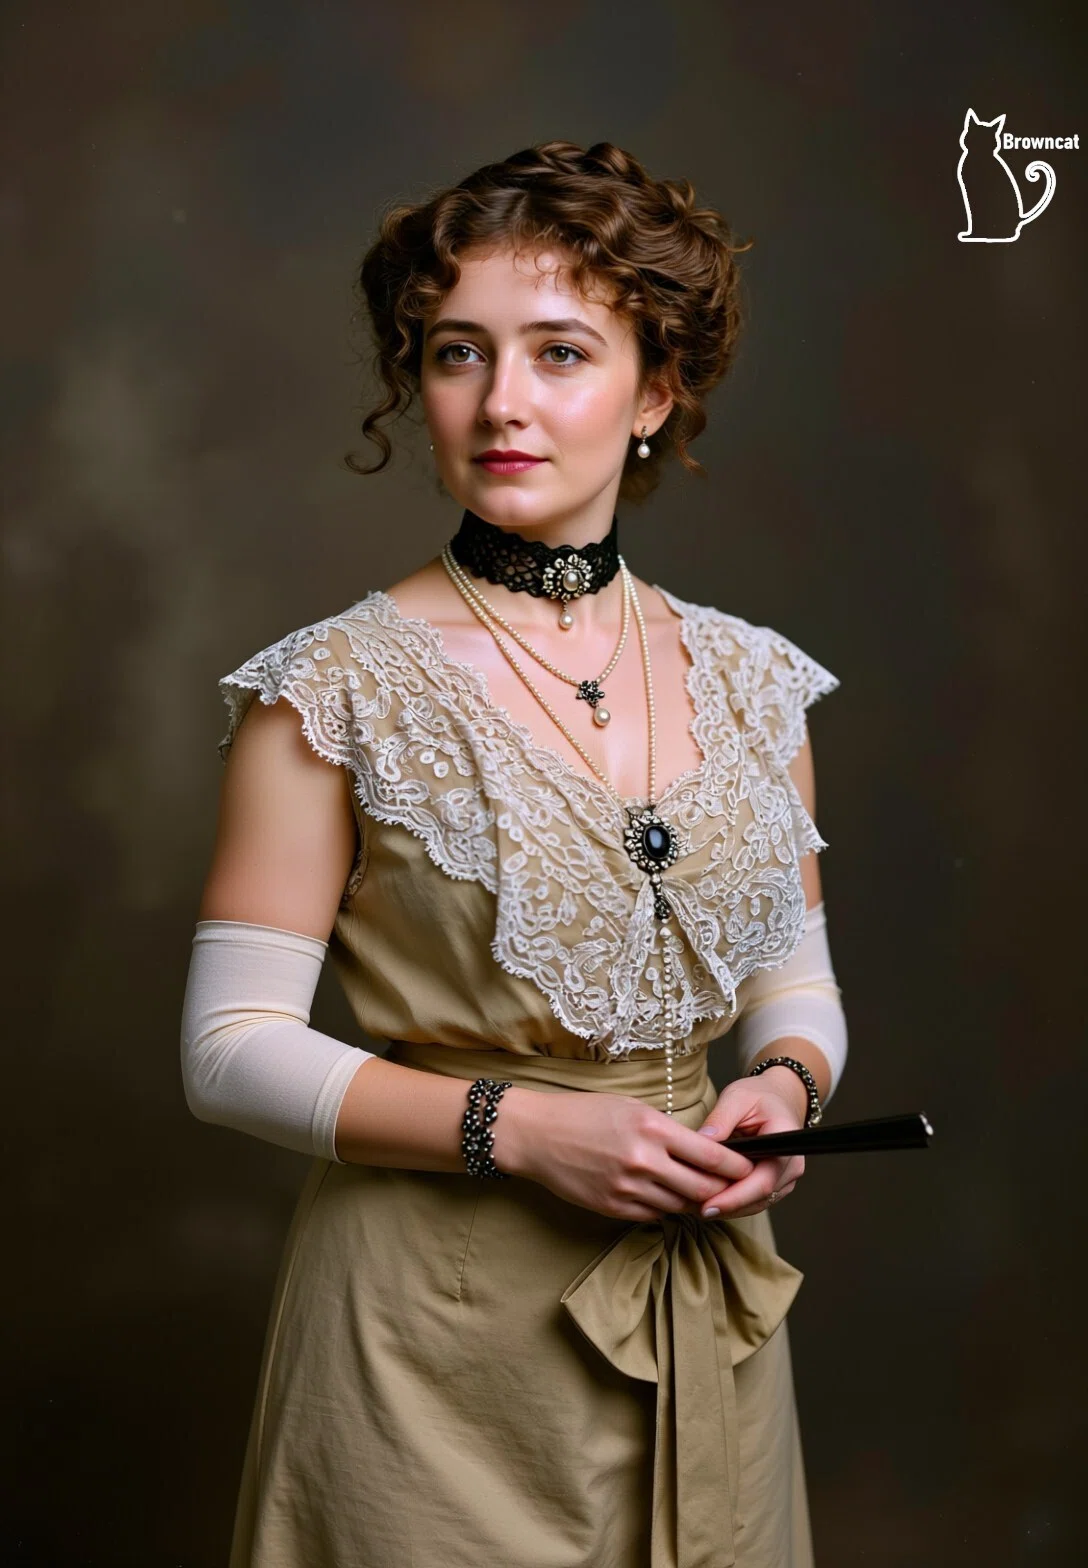
【Qwen-Image-Edit】
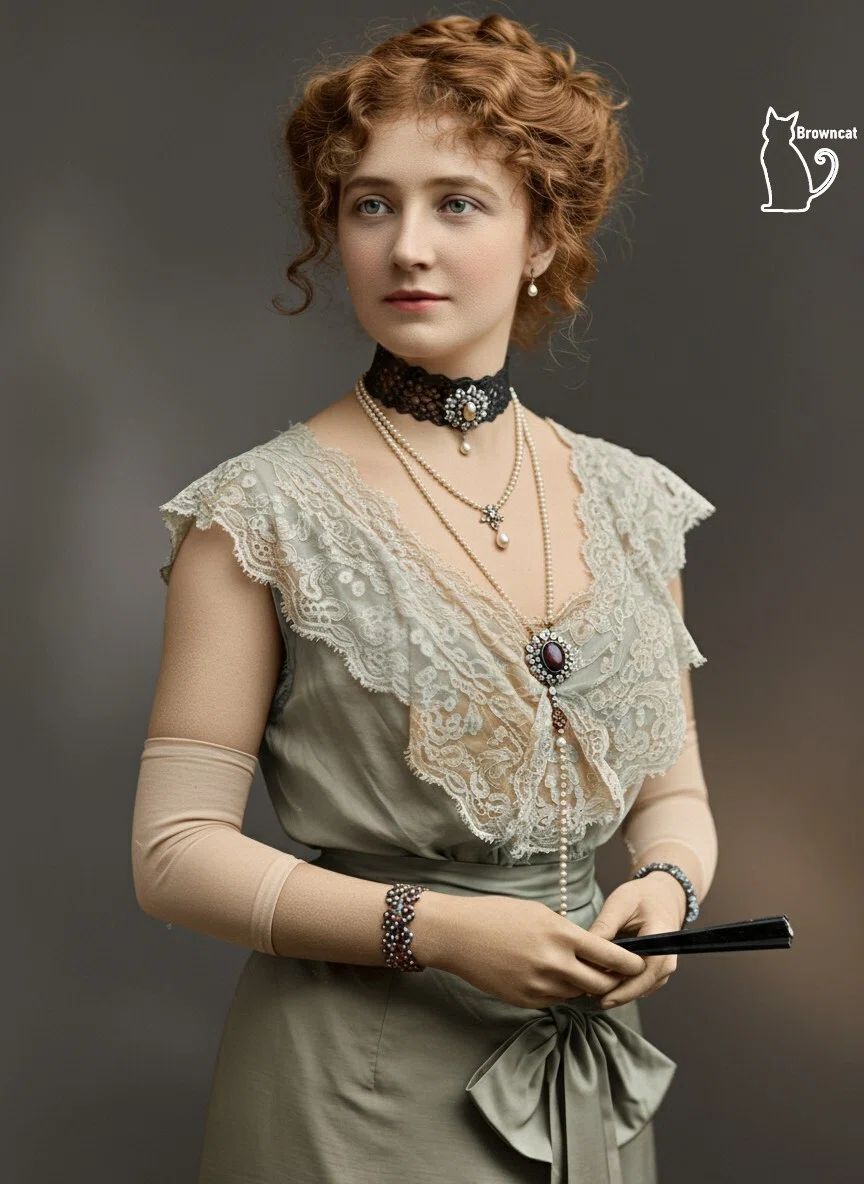
【nano-banana(Gemini 2.5 Flash Image)】
【GPT-Image-1】(再掲)
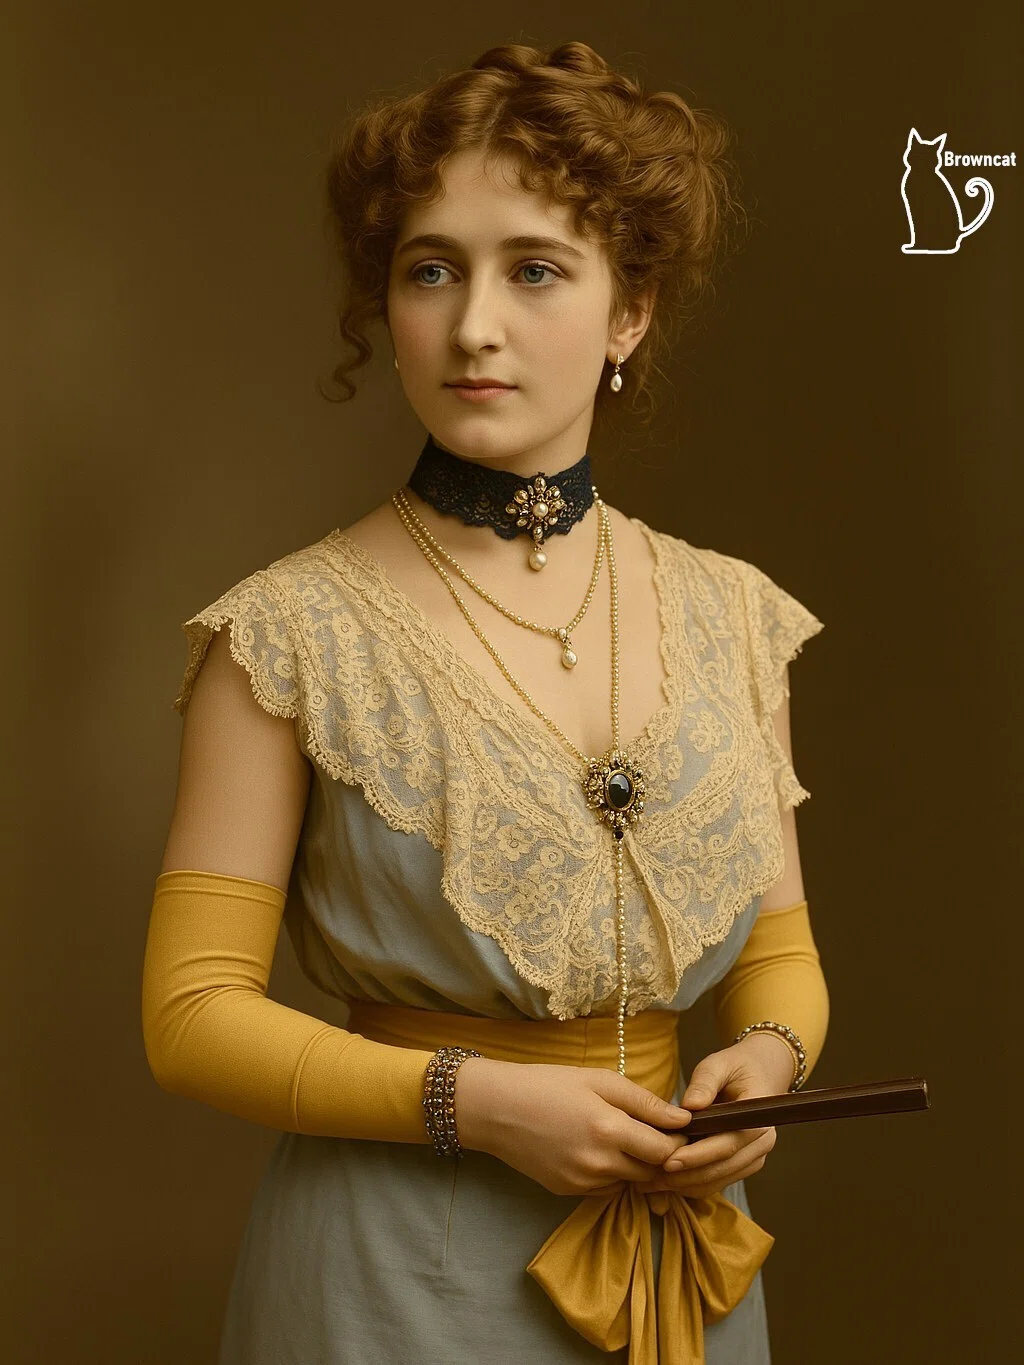
一見、nano-banana(Gemini 2.5 Flash Image)は他に比べ効果が弱いように見えますが、実は生成前後の人物の変形が最も少ないのがnano-bananaで、縦横比の関係で倍率にわずかな違いがあるものの、他の違いは色の有無だけ、すなわちグレースケール化すれば元画像に戻るというのが同モデルの地味にえらいところです。
他は姿が似ていればよいという考え方でカラー化が行われていて、特にQwen-Image-Editは、これに限らず生成によって必ず画像の縮小が起こります。おそらく画像の境界部の処理にかかわる問題だと思いますが、境界のマージンをAI画像処理後切り取らずそのまま出力してしまうという、ユーザにとって全く不要なことをしてしまっています。
【Qwen-Image-Edit-2509による改善(2025.9.27)】
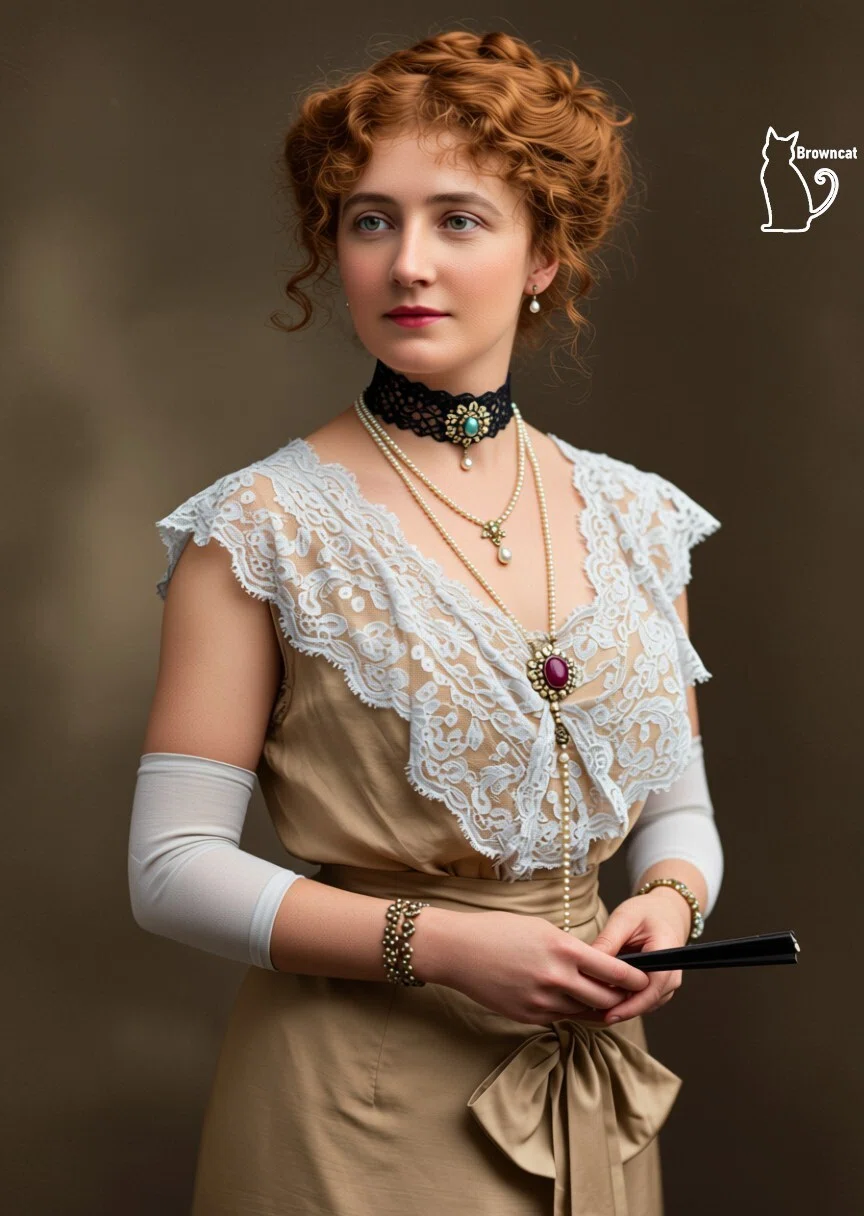
この記事の初版ではQwen-Image-Editの画像の縮小に言及しましたが、その後の改善版「Qwen-Image-Edit-2509」で、縮小が起こらないことを確認しました。
Qwen-Image-Edit-2509は、複数入力に対応する点が前回との大きな違いですが、実際に使用してみて、プロンプトの効きが以前より良くなっていて、こういう地味な改善がうれしかったりします。
フォトリアル画像のイラスト化
今回はフォトリアル画像のイラスト化を新たに試してみました。元画像はMidjourney V7で作ったものです。
【元画像】
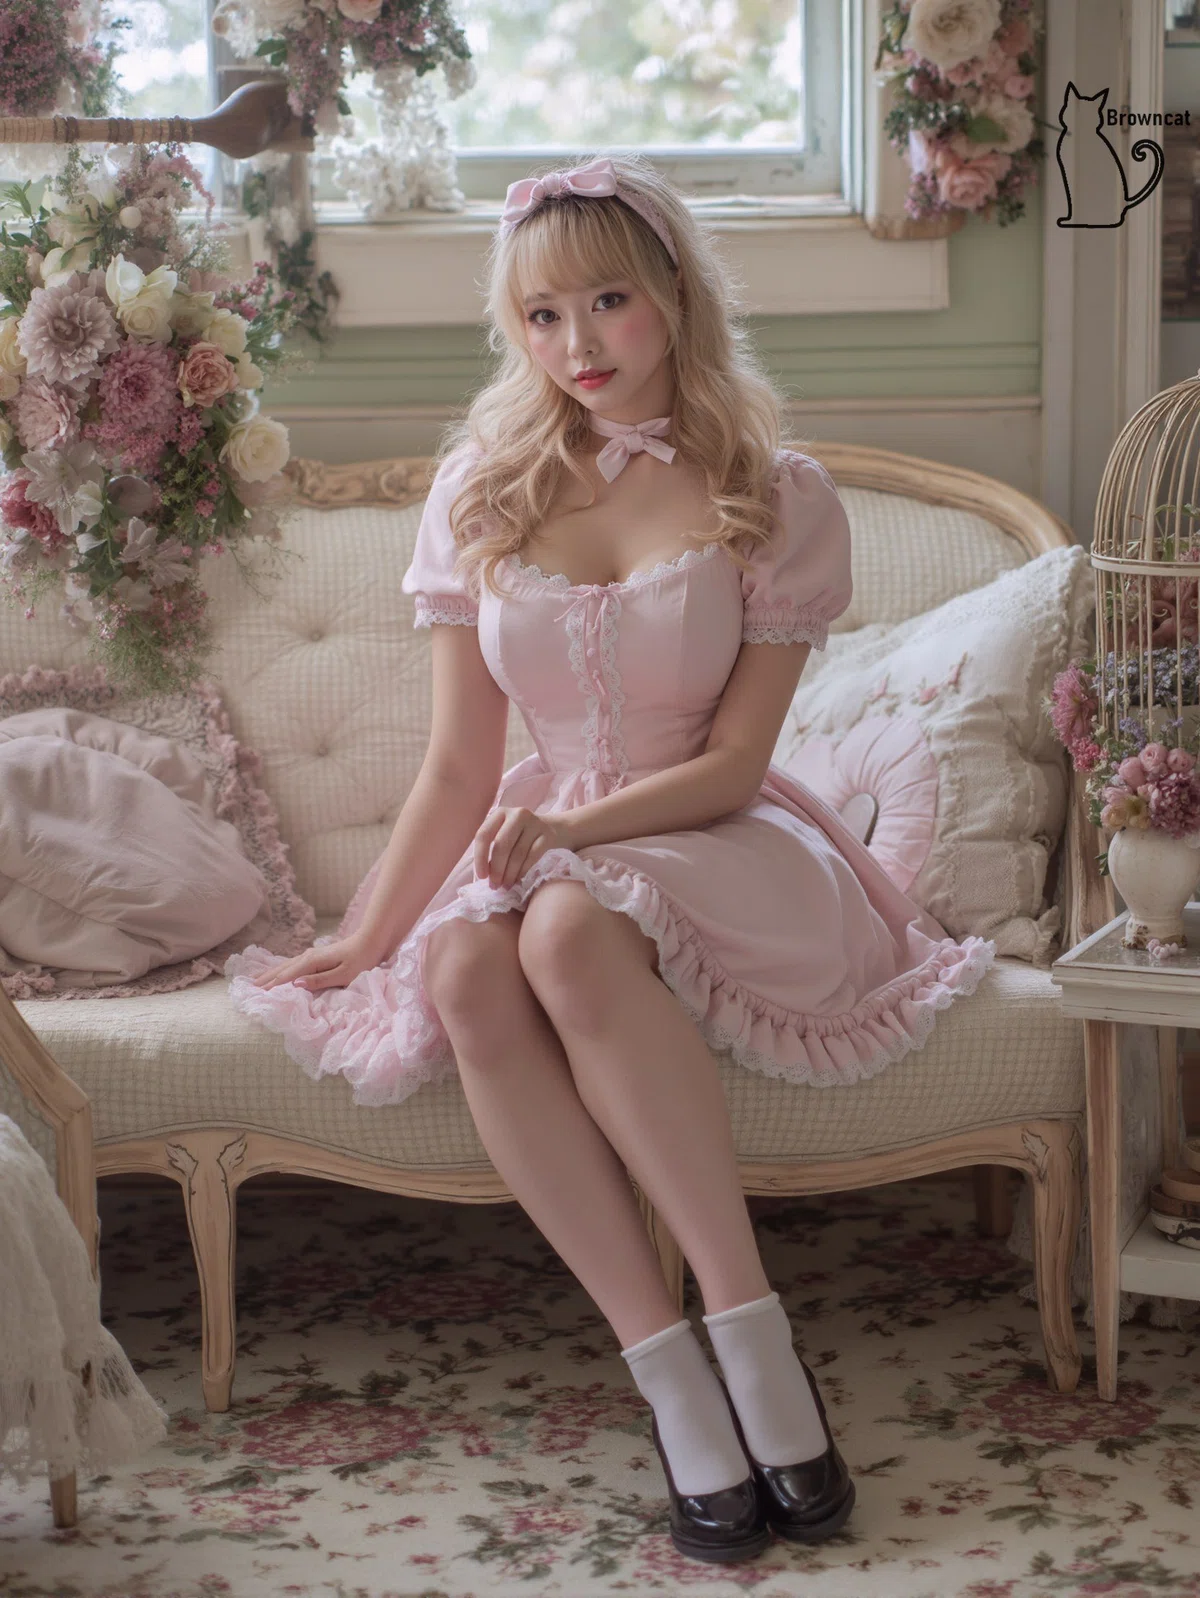
プロンプトは以下の通りです。
Change the photo realistic image to illustration for manga anime.
【FLUX.1 Kontext [dev]】
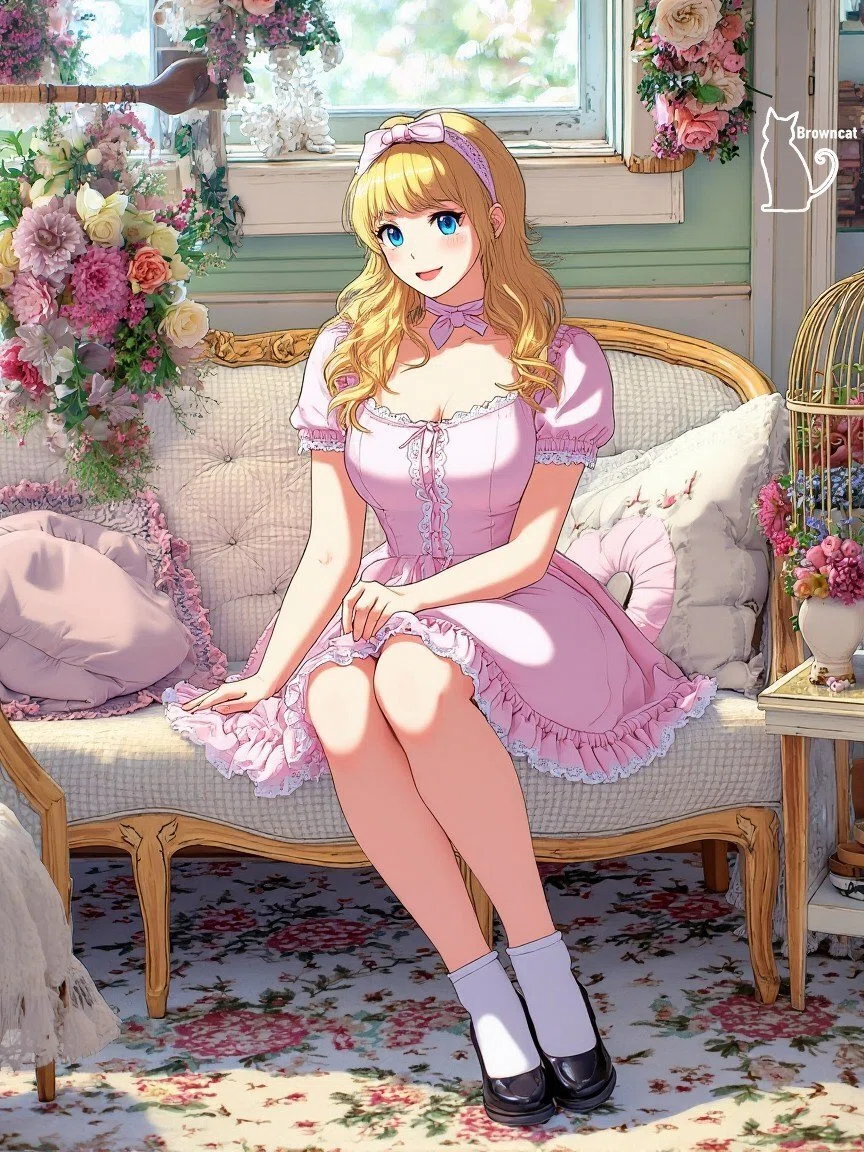
【Qwen-Image-Edit】
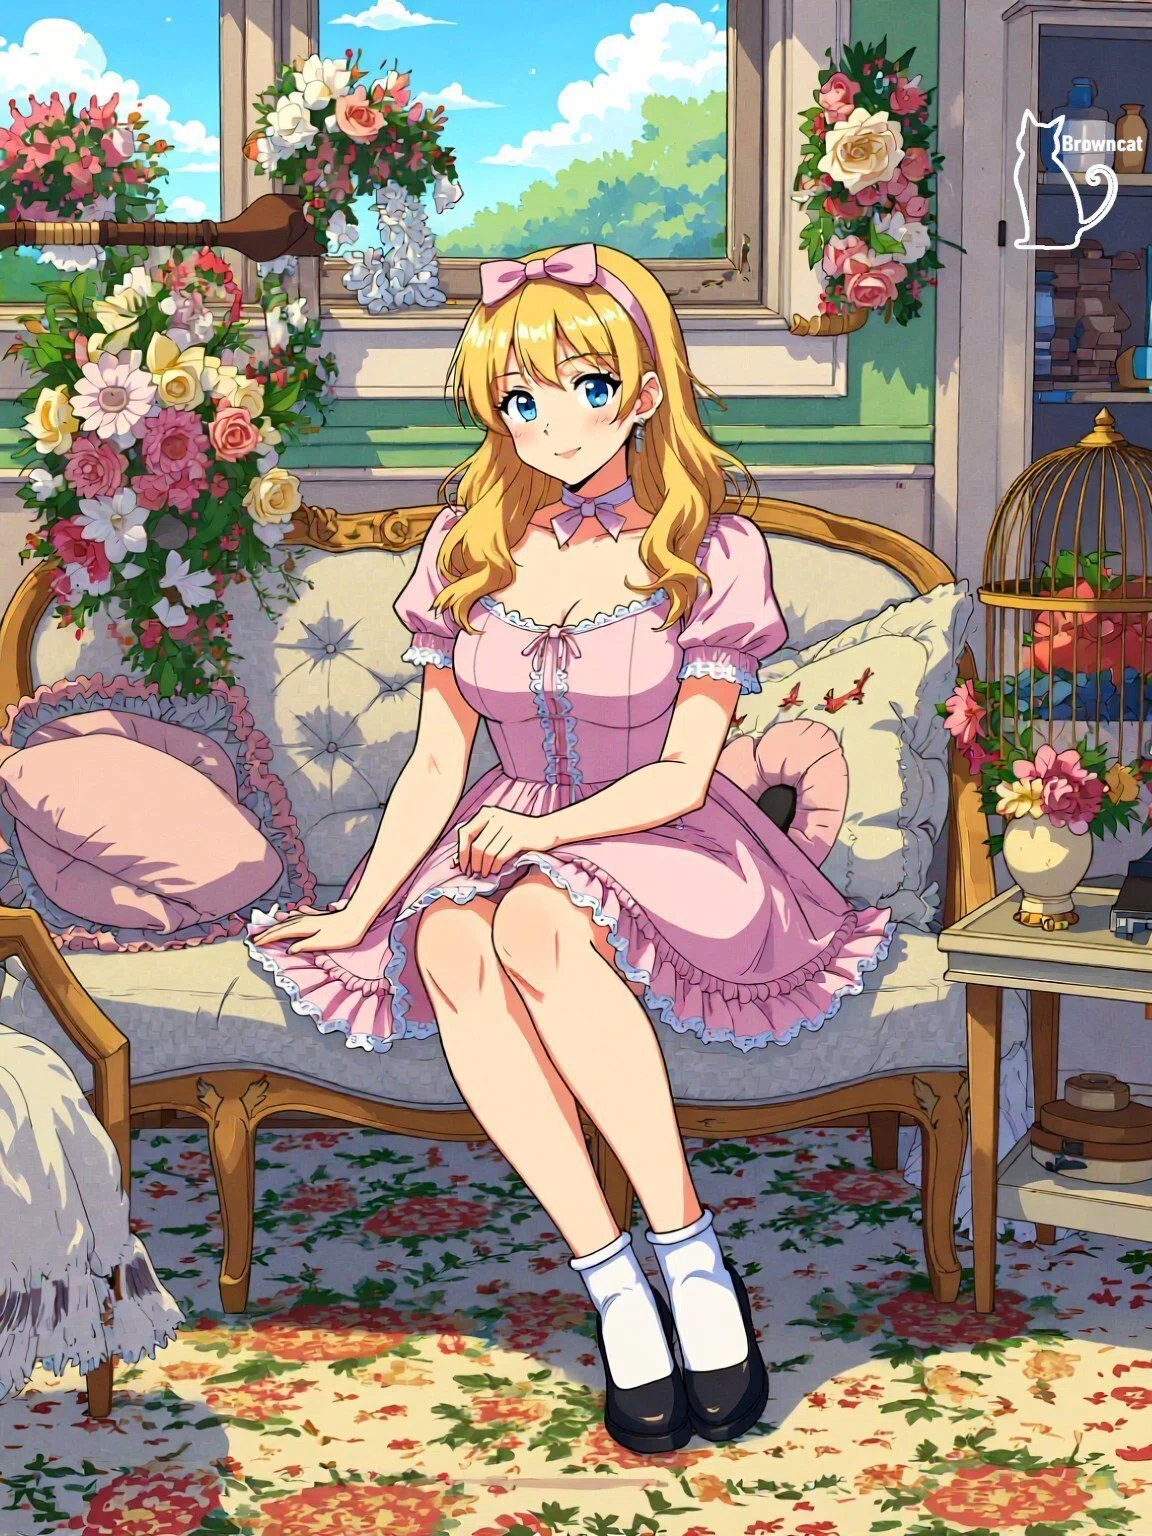
【nano-banana(Gemini 2.5 Flash Image)】
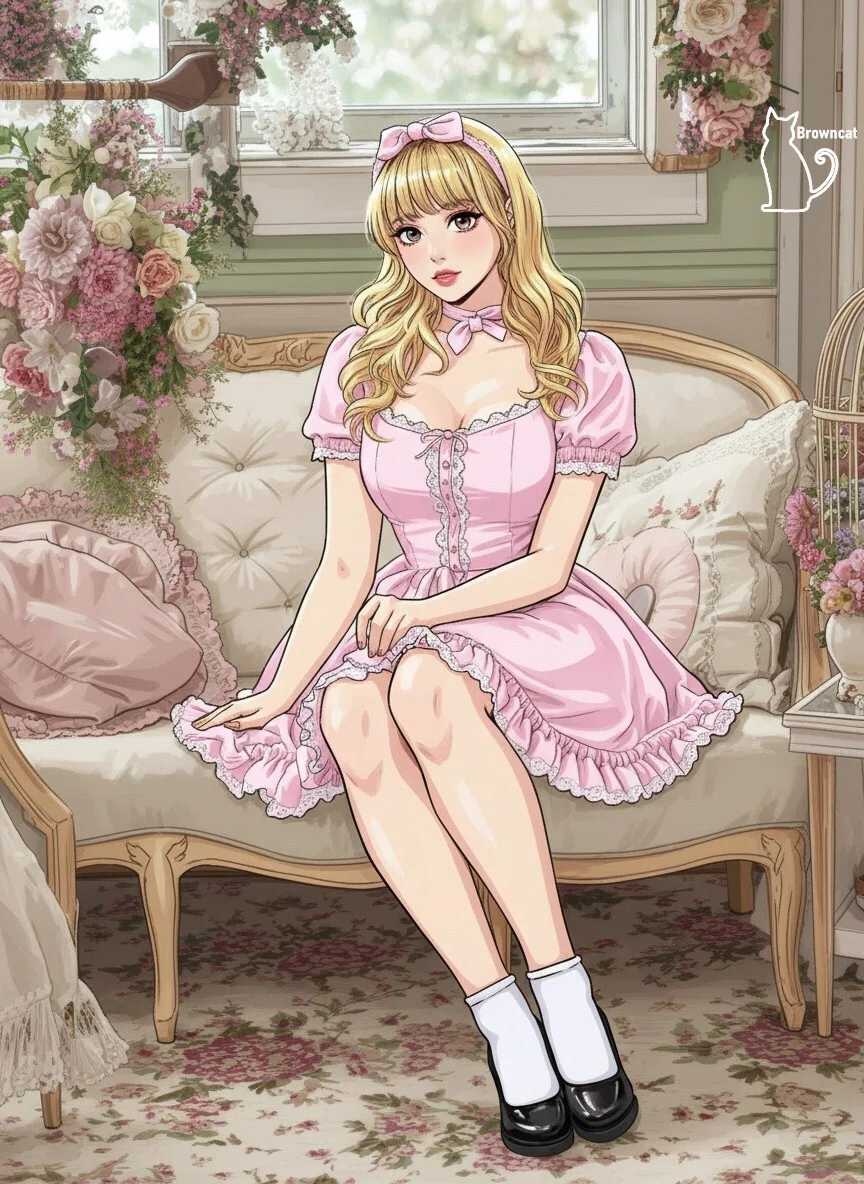
【GPT-Image-1】
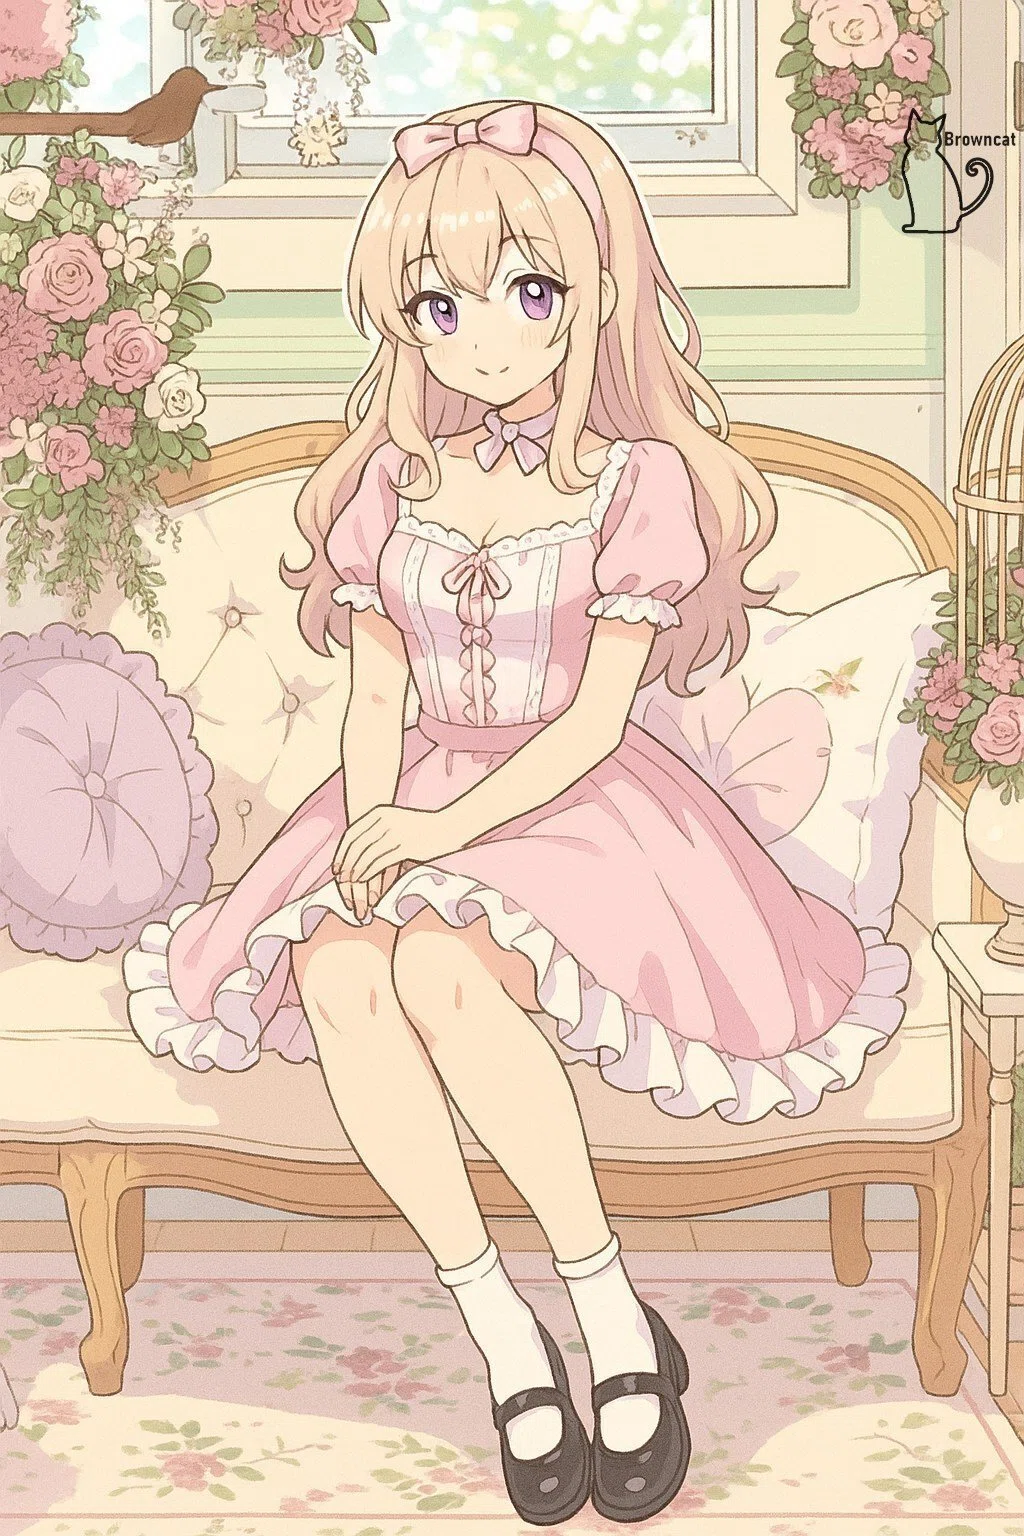
上記結果を比較すると、FLUX.1 Kontext [dev]とnano-banana(Gemini 2.5 Flash Image)は比較的フォトリアルに近く、Qwen-Image-Edit、GPT-Image-1の順に様式化の度合いが強くなっているという興味深い結果になりました。
イラストのフォトリアル画像化【保留】
フォトリアル画像のイラスト化ができたなら、次はイラストのフォトリアル化、といきたいところですが、今回は保留としています。
理由は以下の通りです。
あるイラスト画像を入力にして、nano-banana(Gemini 2.5 Flash Image)で何度か編集処理しましたが、全くうまくいかず、規制されているのかも含めてさらに検証を進めていますが、nano-bananaのイラスト編集やリアル化にどうも他と異なる思想があるようで、この点についてもう少し調べてから、次はnano-banana中心の記事で、検証結果を述べたいと思っています。
※nano-bananaのイラストのフォトリアル画像化については、本稿の続きになる以下の記事で検証しています。
まとめ
編集(Edit)機能つき画像生成AIのうち、最近リリースされた、FLUX.1 Kontext[dev]、Qwen-Image-Edit、Gemini 2.5 Flash Imageについて、それらより先行してリリースされていたGPT-Image-1と比較してみました。
これら4種類のモデルにはそれぞれ個性的な特徴があり(まだ把握しきれていると言えません)、条件を一定にして厳密に比較しようとすると、かえってそれぞれの良さを訴求できなくなる根本問題がありますが、それでもこのように所定の条件でベンチマークすることには一定の意義があると思っています。
ここまでお読みくださり、ありがとうございました。
