生成 AI のモデルは 5 種類で整理できる|自己回帰・拡散・フロー・GAN・VAE の違い

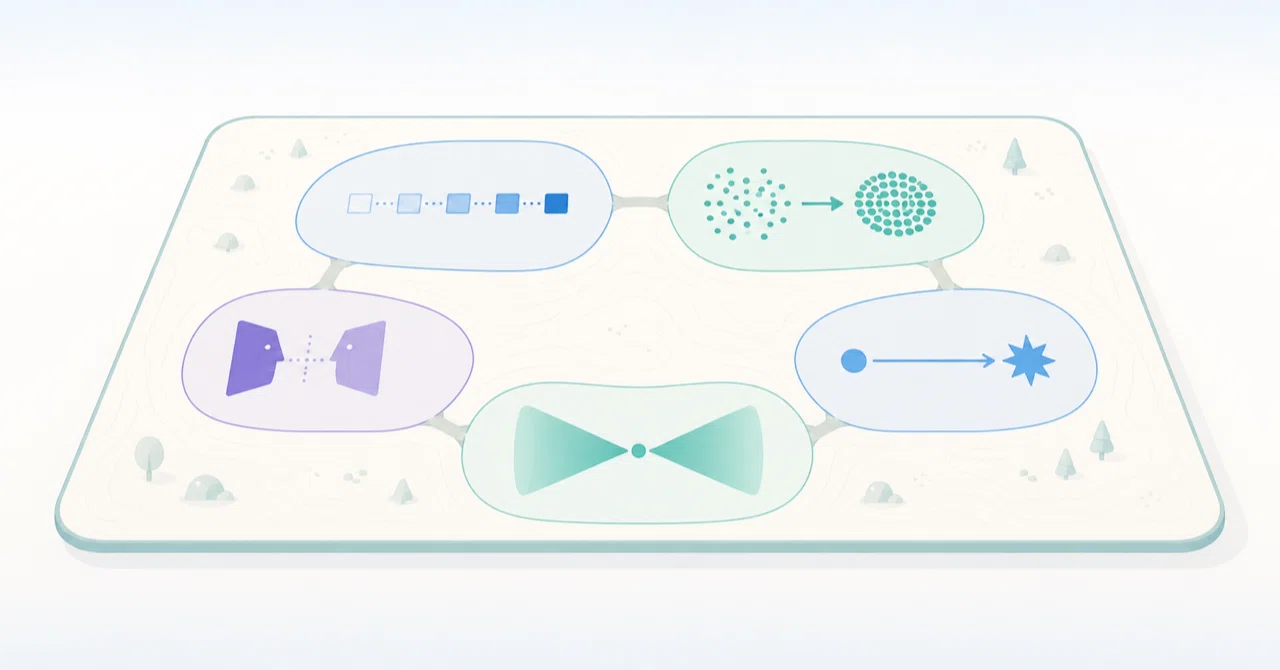
ChatGPT と Stable Diffusion は、どちらも「生成 AI」と呼ばれますが、中身の仕組みは別物です。生成 AI のモデルは、自己回帰・拡散・フローマッチング・GAN・VAE の 5 つの生成方式で整理できます。よく名前を聞く Transformer は方式ではなく、これらの方式を実装するための部品(アーキテクチャ)です。
この記事の目的は 1 つ、5 つの方式の違いを一枚の地図として渡すことです。あわせて 2025 年に商用サービスへ広がった変化、つまり「拡散で文章を書くモデル」と「自己回帰で画像を描くモデル」の実用化を、公式の数値で確認します。それぞれの方式の歴史・仕組みの詳細・使われている場所は、今後 1 本ずつ個別記事にしていく予定です。この記事はその入口になります。
この記事でわかること
生成 AI のモデルを分ける 5 つの生成方式と、それぞれの 1 文定義
Transformer が「方式」ではなく「アーキテクチャ」である理由と、3 つの軸(方式・アーキテクチャ・モダリティ)
「文章は自己回帰、画像は拡散」という対応が、2025 年の商用サービスでどう崩れたか(一次ソースの数値付き)
結論
生成 AI のモデルは、生成方式で見ると自己回帰・拡散・フローマッチング・GAN・VAE の 5 種類に整理できる
Transformer は方式ではなくアーキテクチャで、自己回帰と拡散のどちらにも使われる。モデルは「方式 × アーキテクチャ × モダリティ」の 3 軸で見る
画像生成の主流は GAN(2014〜)→ 拡散(2020〜)→ フローマッチング(2024〜)と移った。VAE は潜在拡散の部品として現役
2025 年、拡散で文章を書く Gemini Diffusion(1,479 tok/s、HumanEval 89.6%)と Mercury Coder が商用規模で登場した。自己回帰で画像を描く GPT-4o も同年に登場した。研究では以前からあった組み合わせで、「文章は自己回帰、画像は拡散」は方式の性質ではない
多くの生成 AI のサービスは、BERT や CLIP のような非生成モデルと組み合わせて動いている
生成 AI のモデルにはどんな種類がありますか?
生成方式で分けると 5 種類です。 どれも「学習データに似た新しいデータを作る」目的は同じですが、確率分布をどう学び、どう出力を組み立てるかが異なります。
自己回帰モデル(Autoregressive Model): 直前までの出力を条件に、次の 1 要素(トークン)の確率を出して 1 つずつ生成する。ChatGPT などの Large Language Model(LLM)の方式
拡散モデル(Diffusion Model): 既知の手順でデータにノイズを加えて壊し、それを元に戻すノイズ除去(逆過程)を学ぶ。生成時はノイズから復元する。Stable Diffusion や DALL·E 2・3 の方式
フローマッチング(Flow Matching): ノイズとデータを結ぶ「流れ」(ベクトル場)を直接学び、少ないステップで変換する。Stable Diffusion 3 や FLUX.2 の方式
敵対的生成ネットワーク(GAN): 生成器と識別器の 2 つのネットワークを競わせて学習する。2014 年から 2020 年頃まで画像生成の主流だった方式
変分オートエンコーダ(VAE): データを低次元の潜在変数に圧縮し、その分布からサンプルして復元する。現在は単体より「潜在空間を作る部品」として現役
登場順は VAE(Kingma & Welling、2013)、GAN(Goodfellow ら、2014)、拡散モデル(Sohl-Dickstein ら、2015)の順です。その後にフローマッチング(Lipman ら、2022)が続きます。自己回帰は統計学では古くからある考え方ですが、生成 AI の主流になったのは GPT 系の LLM が広がってからです。
この 5 つが「方式」の軸です。以降ではまず、この軸と混同されやすい Transformer の位置づけを整理し、その後で 5 つの方式を 1 つずつ見ていきます。
Transformer はモデルの種類ではないのですか?
Transformer は生成方式ではなく、方式を実装するためのアーキテクチャ(ネットワークの形)です。 自己回帰と拡散のどちらにも使われます。だから「Transformer と拡散のどちらか」という二択は成り立ちません。
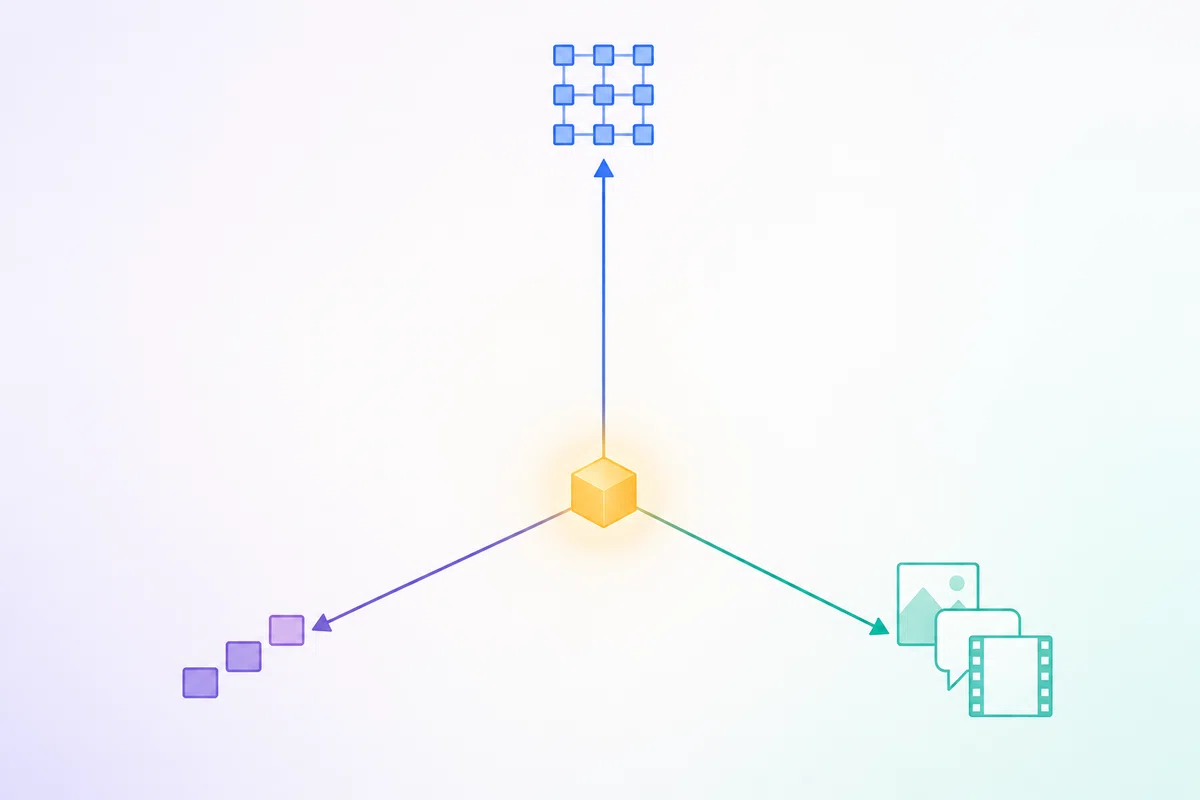
生成 AI のモデルは、次の 3 つの軸で見ると整理できます。
生成方式: 自己回帰 / 拡散 / フローマッチング / GAN / VAE。「確率分布をどう学び、出力をどう組み立てるか」
アーキテクチャ: Transformer / U-Net / 状態空間モデル(SSM)など。「ネットワークの中身をどう組むか」
モダリティ: 文章 / 画像 / 音声 / 動画。「何を生成するか」
Transformer は Vaswani ら(2017)が提案した、注意機構(attention)を中心にしたアーキテクチャです。GPT 系の LLM は、Transformer のデコーダ部分だけを使う decoder-only Transformer で自己回帰生成を行います。拡散モデルの初期は、U-Net というアーキテクチャでノイズを除去していました。Peebles & Xie(2023)の Diffusion Transformer(DiT)以降、これを Transformer に置き換える構成が広がりました。Stable Diffusion 3 と Sora はこの系統です。
アーキテクチャの軸には Transformer 以外の選択肢もあります。Gu & Dao(2023)の Mamba は選択的 SSM に基づき、系列長に対して線形時間で推論できます。NVIDIA の Nemotron-H(2025)は Mamba と Transformer を組み合わせたハイブリッドです。論文は、同規模の Transformer モデルと同等以上の精度を保ちながら推論を最大 3 倍高速にしたと報告しています。これらはすべて「自己回帰という方式を、別のアーキテクチャで実装した」例です。
つまり「GPT は Transformer、Stable Diffusion は拡散モデル」という並べ方は、軸が違うものを比べています。正確には「GPT は自己回帰方式を Transformer で実装したモデル、Stable Diffusion は拡散方式を U-Net(後に Transformer)で実装したモデル」です。
自己回帰モデルとは何ですか?
自己回帰モデルは、直前までの出力を条件に「次の 1 要素」の確率分布を出し、それを 1 つずつ積み上げて系列を生成する方式です。 ChatGPT が「次の単語を予測している」と説明されるのは、この方式を指しています。
学習は「次トークン予測」です。大量のテキストを与え、途中まで見せて次のトークンを当てさせ、外れた分だけ重みを更新します。生成時は、出力した確率分布からトークンを 1 つ選び、それを入力の末尾に足して、また次の分布を出します。この繰り返しが文章になります。それだけです。
強みは 2 つあります。第一に、系列全体の確率(尤度)を正確に計算できるため、学習の目標が明確なことです。第二に、前の出力を必ず参照するため、文脈の一貫性が保たれやすいことです。弱みは速度です。1 トークンずつしか出せないので、生成時間は出力の長さに比例します。長い文章ほど待たされる、というわけです。この点が、後述する拡散言語モデル(Diffusion Language Model)が挑んでいる課題です。
代表例は ChatGPT をはじめとする LLM です。アーキテクチャは decoder-only Transformer が主流ですが、前節のとおり Mamba やハイブリッドも登場しています。また、自己回帰は文章専用ではありません。OpenAI は GPT-4o のネイティブ画像生成(2025 年 3 月 25 日)を自己回帰モデルだと明記しています(詳細は後述)。
自己回帰モデルは大きくなくても成立します。私たちは以前、9 つの意図に絞った 30M パラメータの自己回帰モデルをゼロから学習し、38MB で意図分類正解率 91.11% に達した実測を記事にしました。方式の詳しい歴史と用途は、個別記事「自己回帰モデルの歴史・詳細・用途」(公開予定)で扱います。
「次の単語を予測するだけ」でなぜ会話ができるのですか?
次トークン予測だけを学んだモデルでも、質問文の続きとして答えを生成できます。GPT-3(2020)は、例示を添えた few-shot 設定で、追加学習なしに質問回答をこなしたと報告しています。ただし応答の形式は安定しません。会話サービスでは、「指示と望ましい応答」の組で Supervised Fine-Tuning(SFT)などの追加学習を行い、指示に従う形式を安定させています。生成の仕組み自体は変わらず、1 トークンずつの確率的なサンプリングです。詳細は個別記事で扱います。
拡散モデルとは何ですか?
拡散モデルは、データに少しずつノイズを加えて壊す手順を固定し、それを元に戻すノイズ除去の逆過程を学ぶことで、ノイズから新しいデータを生成する方式です。 現在の画像生成 AI の多くが、この方式とその発展形(次節のフローマッチング)を使っています。
原型は Sohl-Dickstein ら(2015)にありますが、実用水準に達したのは Ho らの DDPM(2020)です。DDPM は CIFAR10 で Fréchet Inception Distance(FID)3.17 を記録しました。256×256 の LSUN では、当時の主流だった GAN 系(ProgressiveGAN)と同等の品質に達しています。拡散モデルが GAN に並んだのは、この時点です。
さらに Rombach ら(2022)の潜在拡散は、画像そのものではなく、VAE で圧縮した小さな潜在空間で拡散します。論文は、ピクセル空間の拡散モデルに比べて学習・推論の計算量を下げたと報告しています。これが Stable Diffusion の基礎です。強みは、学習が安定していることと、出力の多様性が高いことです。弱みは、ノイズ除去を何十〜何百ステップも繰り返すため、1 回の生成に時間がかかることです。
代表例は Stable Diffusion と DALL·E 2・3 です(OpenAI はシステムカード補遺で DALL·E を拡散モデルと明記)。なお初代 DALL·E(2021)は、テキストと画像のトークンを 1 つの系列として自己回帰的に生成する Transformer で、拡散モデルではありません。動画生成の Sora も、OpenAI が 2024 年の技術レポートで diffusion transformer と表現している拡散モデルです。方式の詳しい歴史と用途は、個別記事「拡散モデルの歴史・詳細・用途」(公開予定)で扱います。
ノイズから画像ができるのはなぜですか?
学習時は「きれいな画像 → 少しノイズ → もっとノイズ → 完全なノイズ」という順方向の過程を用意し、各段階で「今のノイズをどれだけ取り除けば 1 段階前に戻るか」をネットワークに当てさせます。生成時はこれを逆に使い、完全なノイズから始めて 1 段階ずつ取り除きます。テキストの指示は、この「取り除く方向」を決める条件として各ステップに与えられます。
フローマッチングは拡散モデルと何が違いますか?
フローマッチングは、ノイズとデータを結ぶ「流れ」を直接学ぶ方式で、拡散モデルより少ないステップで同等以上の画質を出せます。 Stable Diffusion 3(2024 年)と FLUX.2(2025 年)がこの方式を採用しています。
前身はフローベースモデル(正規化フロー)です。可逆な変換を重ねて単純な分布を複雑な分布に写す方式で、尤度を正確に計算できる利点がある一方、手で設計できる可逆な変換に限られる制約から、画質で GAN や拡散に及びませんでした。Lipman ら(2022)のフローマッチングは、同じ連続正規化フローを、ノイズからデータへ向かうベクトル場の回帰で学ぶ方法です。学習時に軌道を数値積分する高価なシミュレーションを回避できます。論文は、学習に使う条件付き経路として最適輸送(OT)に基づく直線的な経路を選ぶと、拡散型の経路より学習とサンプリングの両方で効率的だと報告しています。
拡散モデルとの違いは、学習に使う経路の選び方です。拡散モデルはノイズを加える確率過程を逆にたどるため経路が曲がります。フローマッチングは経路を選べ、rectified flow はノイズとデータの直線補間を経路として学習します。生成時の軌道が直線に近づくほど、少ないステップで進めます。Esser ら(2024)の Stable Diffusion 3 は、この rectified flow と Transformer ベースのアーキテクチャ(MM-DiT)を組み合わせています。論文は、高解像度の text-to-image で既存の最先端モデルを上回ったと報告しています。Black Forest Labs の FLUX.2 [dev](2025-11-25)も 32B パラメータのフローマッチング Transformer です。
本記事では両者を別の方式として扱いますが、数学的には連続的な関係にあります。方式の詳しい歴史と用途は、個別記事「フローモデル・フローマッチングの歴史・詳細・用途」(公開予定)で扱います。
GAN はなぜ画像生成の主流から外れたのですか?
学習が不安定で、拡散モデルが 2020 年に同等の画質に達したためです。 GAN は 2014 年から 2020 年頃まで画像生成の主流だった方式です。消えたわけではありません。速さが求められる用途では現役です。
敵対的生成ネットワーク(GAN)は Goodfellow ら(2014)が提案しました。偽物を作る生成器と、本物か偽物かを見分ける識別器を同時に学習させ、生成器が識別器をだませるようになるまで競わせます。
強みは生成の速さです。学習が終われば、ノイズを 1 回ネットワークに通すだけで画像が出ます。拡散モデルのように何十ステップも繰り返す必要がありません。弱みは学習の不安定さです。生成器と識別器のバランスが崩れると、生成器が少数のパターンしか出さなくなる「モード崩壊」が起き、出力の多様性が失われます。
DDPM(2020)が LSUN 256×256 で ProgressiveGAN と同等の品質に達し、その後の潜在拡散で実用性が確立したことで、text-to-image の主流は拡散に移りました。現在 GAN が使われるのは、超解像や画像変換、顔の生成など、1 回の順伝播で結果が欲しい場面です。方式の詳しい歴史と用途は、個別記事「GAN の歴史・詳細・用途」(公開予定)で扱います。
VAE はなぜ今も重要なのですか?
VAE は単体の生成器としては主流から外れましたが、Stable Diffusion の内部で「潜在空間を作る部品」として現役だからです。
変分オートエンコーダ(VAE)は Kingma & Welling(2013)が提案しました。エンコーダが入力を低次元の潜在変数の確率分布に写し、デコーダがそこからサンプルした値を元のデータに復元します。学習後は、潜在空間の任意の点をデコーダに通すことで新しいデータを生成できます。
強みは潜在空間が連続で扱いやすいことです。2 つの画像の潜在変数の中間をとれば、その中間の画像が出ます。弱みは、単体で生成した画像がぼやけやすいことです。確率分布を平均的に再現する学習目標のため、細部が失われます。
この「ぼやける」弱みは、オートエンコーダ側の改良と拡散モデルとの組み合わせで補われました。Rombach ら(2022)の潜在拡散では、まずオートエンコーダで画像を小さな潜在表現に圧縮します。その潜在空間の中で拡散モデルを動かし、最後にデコーダで画像に戻します。論文は、オートエンコーダ自体を知覚損失と敵対的学習で訓練してぼけを抑えると説明しています。拡散モデルが担うのは、その潜在表現の分布を生成する役割です。VAE は圧縮と復元、拡散は潜在分布の生成という分担です。Stable Diffusion を使うたびに、VAE は必ず動いています。目立たないだけです。方式の詳しい歴史と用途は、個別記事「VAE の歴史・詳細・用途」(公開予定)で扱います。
「文章は自己回帰、画像は拡散」という区別は今も正しいですか?
方式の性質としては元から正しくなく、2025 年には商用サービスでも崩れました。 研究では自己回帰の画像生成(PixelRNN、2016)や拡散の文章生成(Diffusion-LM、2022)が以前からあります。2025 年に変わったのは、拡散で文章を生成するモデルと自己回帰で画像を生成するモデルが、公式の数値付きの商用規模モデルとして登場したことです。生成方式とモダリティは独立した軸です。
拡散で文章を生成するのが拡散言語モデル(Diffusion Language Model)です。Inception Labs の Mercury Coder(2025 年 2 月 26 日)は、同社が商用規模では初と位置づける拡散言語モデルです。論文によれば、NVIDIA H100 上で Mercury Coder Mini がトークン毎秒(tok/s)で 1,109、Small が 737 を出します。Google DeepMind の Gemini Diffusion(2025 年 5 月 20 日発表)は、オーバーヘッドを除いて 1,479 tok/s で生成します。コーディングでは自己回帰の Gemini 2.0 Flash-Lite と同等です(HumanEval 89.6% 対 90.2%、MBPP 76.0% 対 75.8%)。
ただし汎用性能では差があります。同じ公式ページで、GPQA Diamond は 40.4% 対 56.5%、Global MMLU (Lite) は 69.1% 対 79.0% です。どちらも Gemini Diffusion が自己回帰版に届いていません。拡散言語モデルは現時点では「速度と、系列全体を一度に見直せる整合性」を強みとする実験的な選択肢であり、汎用の知識・推論では自己回帰が優位のままです。
逆方向の例が自己回帰の画像生成です。OpenAI は GPT-4o のネイティブ画像生成(2025 年 3 月 25 日)について、次のように明記しています。「拡散モデルとして動く DALL·E とは異なり、4o の画像生成は ChatGPT に組み込まれた自己回帰モデルである」という記述です。原文は "Unlike DALL·E, which operates as a diffusion model, 4o image generation is an autoregressive model natively embedded within ChatGPT." です。文章と同じ仕組みで画像のトークンを 1 つずつ生成するため、言語モデルの知識を画像生成に直接使えます。
示唆は明確です。「文章 = 自己回帰、画像 = 拡散」は、商用サービスで長く続いた経験的な対応であって、方式の性質ではありません。どの方式をどのモダリティに使うかは、速度・整合性・精度のトレードオフで選ばれるようになっています。この転換の詳細は、個別記事「拡散言語モデルの歴史・詳細・用途」(公開予定)で扱います。
生成しない AI モデルにはどんな種類がありますか?
エンコーダ型モデルと埋め込みモデルです。 生成はしませんが、検索・分類・生成モデルの条件付けを担います。Stable Diffusion のようなテキスト条件付きの画像生成や、ベクトル検索を使う検索拡張生成では、生成モデルと組み合わせて動いています。
代表は BERT(Devlin ら、2018)です。Transformer のエンコーダ部分だけを使い、文章全体を双方向に読んで各トークンの表現を出します。次の単語を予測する自己回帰とは異なり、「文章の意味を数値の並び(ベクトル)に変える」ことが役割です。この表現は分類や検索に使われます。検索拡張生成(Retrieval-Augmented Generation、RAG)で LLM に渡す文書を探す部分は、この系統の埋め込みモデルが担っています。
画像とテキストをつなぐのが CLIP(Radford ら、2021)です。画像とその説明文を同じベクトル空間に埋め込むよう対照学習し、「この画像とこの文章は対応しているか」を測れるようにします。Stable Diffusion は公開時の READMEで、プロンプトの理解に CLIP のテキストエンコーダ(ViT-L/14)を使うと明記しています。つまり、拡散モデルが「何を描くか」を知るために、非生成モデルが働いています。
生成方式の地図に非生成モデルを加える理由はここにあります。自己回帰の LLM 単体でも文章は生成できますが、Stable Diffusion やベクトル検索を使う RAG のように、生成モデルと非生成モデルを組み合わせて成り立つサービスが多くあります。なお、モデル内部の埋め込み層と、独立した埋め込みモデルは別のものです。この系統の詳細は、個別記事「エンコーダ型・埋め込みモデルの歴史・詳細・用途」(公開予定)で扱います。
自分の用途にはどの種類のモデルを選べばいいですか?
2026 年 9 月時点の主流は次のとおりです。 ただし前節のとおり境界は動いており、これは方式の性質ではなく現時点の整理です。
文章・コード生成: 自己回帰(LLM)が主流。速度を優先する場合に拡散言語モデルが選択肢になる
画像生成: 拡散モデルとフローマッチングが主流。Stable Diffusion 3 や FLUX.2 はフローマッチング。GPT-4o のように自己回帰で描くモデルも登場
動画生成: 拡散モデルを Transformer で実装した系統(Diffusion Transformer(DiT)。Sora など)
超解像・画像変換: 速さが要る場面では GAN が現役
検索・分類・RAG の検索部分: エンコーダ型・埋め込みモデル(生成しない)
圧縮・潜在空間の構築: VAE(拡散モデルの部品として)
選ぶときの観点は 3 つです。出力の長さに比例して時間がかかってよいか(自己回帰)、反復ステップの時間を許容できるか(拡散・フロー)、1 回の順伝播で終わらせたいか(GAN)。精度・多様性・速度のうち何を優先するかで方式が決まります。迷ったら、この 3 つの問いに戻れば十分だと思っています。
まとめ
生成 AI のモデルは、生成方式で見ると自己回帰・拡散・フローマッチング・GAN・VAE の 5 種類に整理できる
Transformer は方式ではなくアーキテクチャで、自己回帰と拡散のどちらにも使われる。モデルは「方式 × アーキテクチャ × モダリティ」の 3 軸で見る
画像生成の主流は GAN(2014〜)→ 拡散(2020〜)→ フローマッチング(2024〜)と移った。VAE は潜在拡散の部品として現役
2025 年、拡散で文章を書く Gemini Diffusion(1,479 tok/s、HumanEval 89.6%)と Mercury Coder が商用規模で登場した。自己回帰で画像を描く GPT-4o も同年に登場した。研究では以前からあった組み合わせで、「文章は自己回帰、画像は拡散」は方式の性質ではない
多くの生成 AI のサービスは、BERT や CLIP のような非生成モデルと組み合わせて動いている
このシリーズでは今後、次の個別記事を 1 本ずつ公開する予定です。各記事は「歴史・できた背景」「特徴・詳細」「具体的に使われている場所」の 3 節で構成します。
自己回帰モデル
拡散モデル
フローモデル・フローマッチング
GAN
VAE
拡散言語モデル
エンコーダ型・埋め込みモデル
公開後、この記事から各記事へのリンクを追記します。私たちの記事は 1 テーマを 1 本にまとめる方針なので、正直に言うと長いです。長文記事を AI に渡して読む方法も参考にしてください。
FAQ
生成 AI のモデルは何種類ありますか?
生成方式で分けると、自己回帰・拡散・フローマッチング・GAN・VAE の 5 種類に整理できます。Transformer はこれらの方式を実装するアーキテクチャであり、方式の 1 つではありません。
ChatGPT と Stable Diffusion は同じ仕組みですか?
異なります。ChatGPT は自己回帰モデルで、次のトークンを 1 つずつ予測します。Stable Diffusion は拡散モデルで、ノイズを段階的に除去して画像を生成します。ただし Stable Diffusion も、プロンプトの理解には Transformer 系のテキストエンコーダ(CLIP)を使います。Stable Diffusion 3 以降はノイズ除去部分も Transformer です。
拡散モデルで文章は作れますか?
作れます。Google DeepMind の Gemini Diffusion(2025 年 5 月 20 日発表)は 1,479 tok/s で生成します。HumanEval 89.6% と、自己回帰の Gemini 2.0 Flash-Lite(90.2%)に匹敵します。ただし GPQA Diamond は 40.4% 対 56.5% で、汎用性能では自己回帰に届いていません。
GAN は今も使われていますか?
text-to-image の主流ではなくなりましたが、1 回の順伝播で生成できる速さから、超解像や画像変換などの用途で使われています。
フローマッチングと拡散モデルの違いは何ですか?
どちらもノイズからデータへ変換しますが、フローマッチングは学習に使う経路を選べます。rectified flow のように直線的な経路で学習すると、生成時の軌道も直線に近づき、少ないステップで生成できます。Stable Diffusion 3 と FLUX.2 が採用しています。
参考リンク
Sohl-Dickstein ら, Deep Unsupervised Learning using Nonequilibrium Thermodynamics(2015)
Li ら, Diffusion-LM Improves Controllable Text Generation(2022)
Ramesh ら, Zero-Shot Text-to-Image Generation(初代 DALL·E、2021)
Rombach ら, High-Resolution Image Synthesis with Latent Diffusion Models(2022)
Peebles & Xie, Scalable Diffusion Models with Transformers(2023)
Esser ら, Scaling Rectified Flow Transformers for High-Resolution Image Synthesis(2024)
OpenAI, Addendum to GPT-4o System Card: Native image generation(2025)
