GPT-6AstraはAGIか? 〜99.9%に、注釈がついてます〜

御社の役員会、来週こんな一言から始まりませんか。
「OpenAIがAGIって言ってるらしいじゃないか。うちはどうするんだ」
言われた側の情シスや企画の人は、たぶんこう返したいはずです。誰が、何を根拠に、どの条件で言ったんですか、と。
その答えを、今日は全部一次情報で持って帰れるようにします。
先日書いた値札の話の続きです。あの記事は「同じ10ドル50ドルで、違うものを売っている」という話でした。今回はその片方、GPT-6 Astraの、いちばん派手な数字の裏側です。
99.9%という数字には、ちゃんと注釈がついています。そしてその注釈のほうが、本文より面白い
時間がない人向けまとめ
2026年9月3日、OpenAIはGPT-6 AstraがARC-AGI-3を99.9%で飽和させたと発表。同日、社長のBrockman氏が「AGI時代に入ったと感じても不合理ではない」と発言
ARC-AGI-3を運営する第三者機関ARC Prize財団の検証では、他社と同条件のStandardハーネスで62.7%、OpenAI専用のProvider Adapterハーネスで99.9%
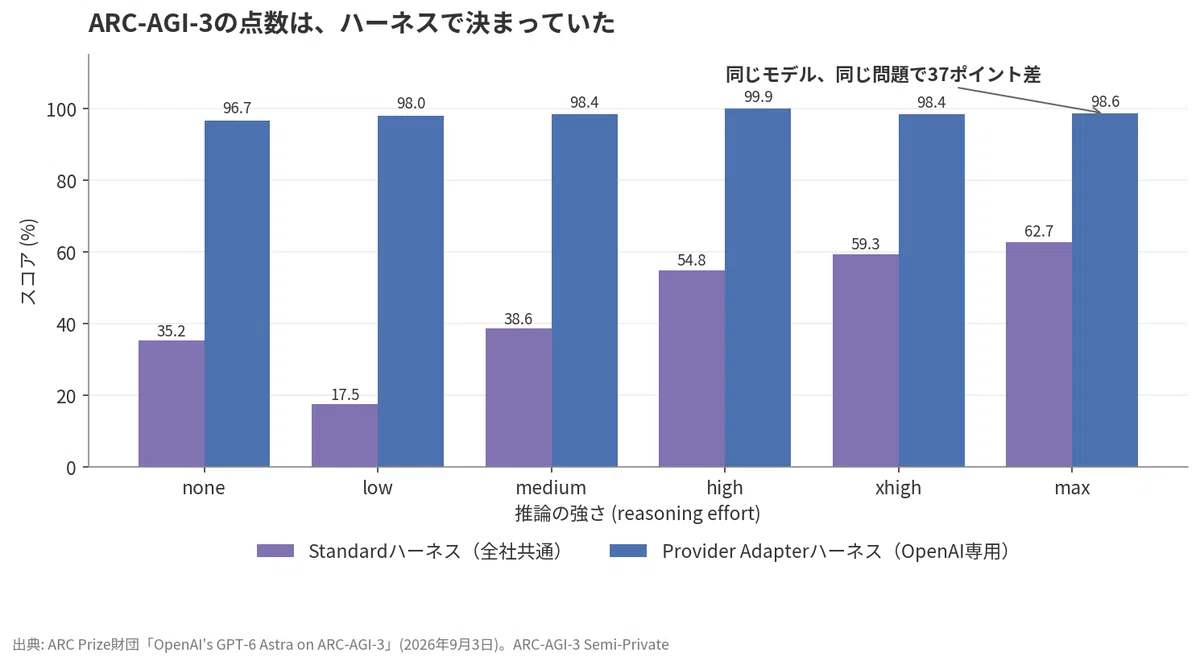
同じモデル、同じ問題で、ハーネスの違いだけで約37ポイント差。ARC Prizeは今後この2条件を分けてリーダーボードに載せる
費用は、Standardが26,098ドル、約406万円。Provider Adapterが18,817ドル、約293万円。点数の高いほうが安い
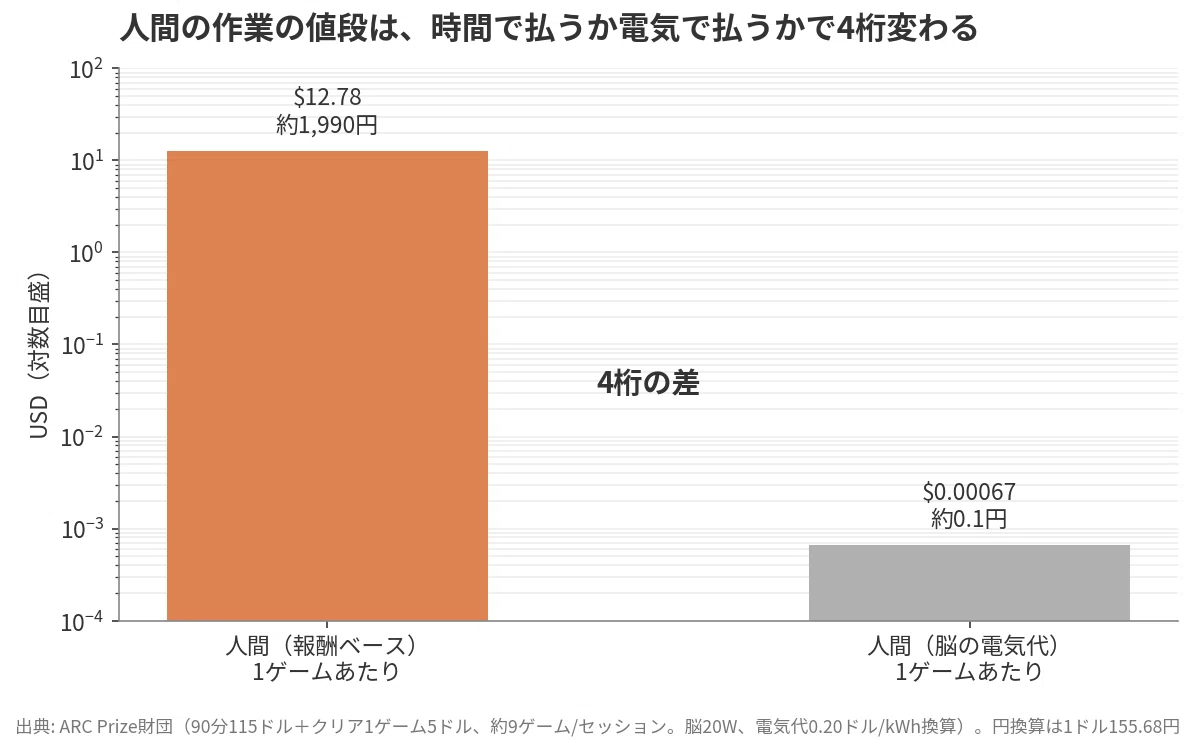
人間の被験者は1ゲームあたり約12.78ドル、約1,990円。ただし脳の消費電力だけで見れば1ゲーム0.067セント、約0.1円
行動効率では、Astraは96%のレベルで人間の中央値より少ない手数でクリア。平均51.7%少ない
そしてARC Prize自身が「Astraは意味のある前進だが、AGIだとは主張しない」と明記
稟議書に書くべきは、AGIという言葉ではなく、この62.7と99.9の2つの数字と、その差の理由
先に結論を書きます。AGIかどうかは、モデルではなく、ハーネスを見ないと語れなくなりました
まず、誰が何を言ったのか
3人の発言を、出典つきで並べます。
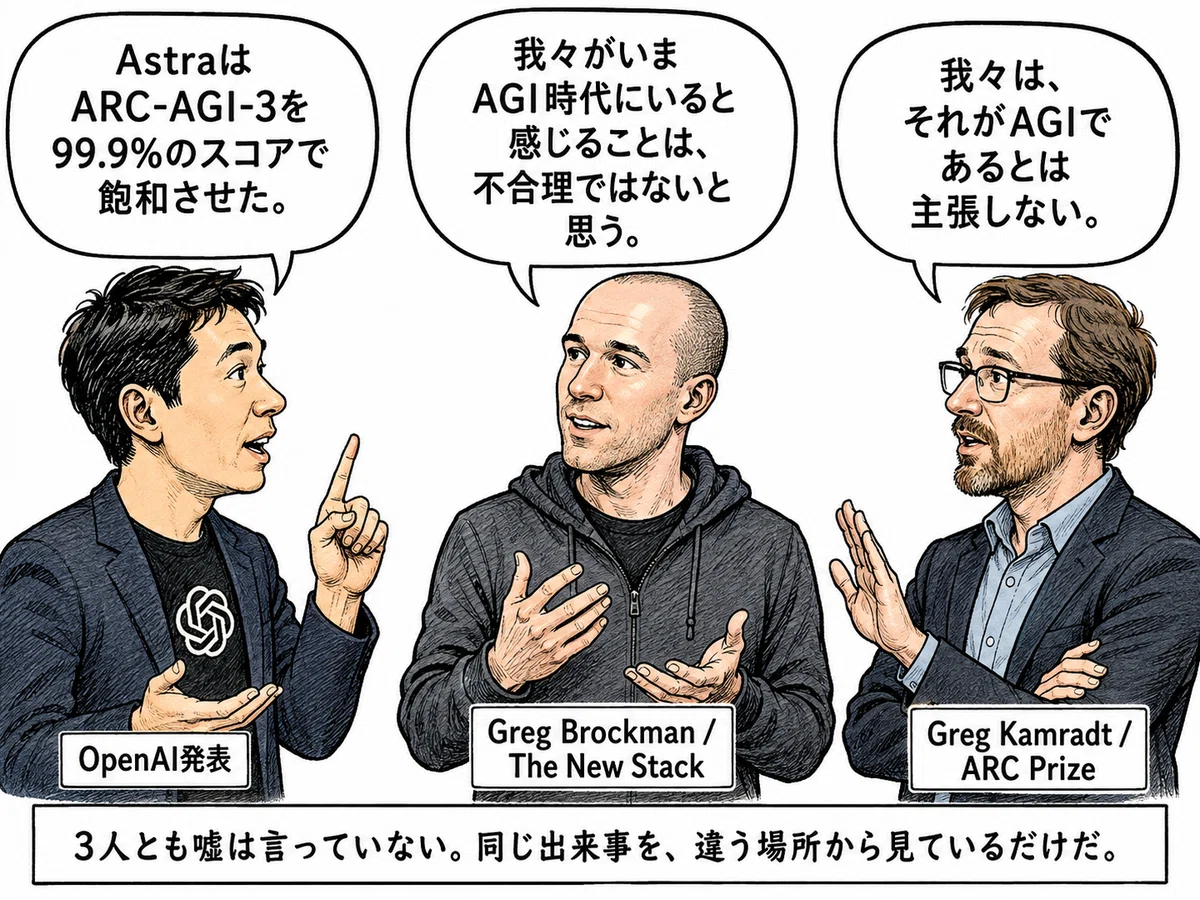
1人目。OpenAIの発表ページです。
https://openai.com/index/gpt-6-astra/
Astra saturates ARC-AGI-3 with a 99.9% score
和訳: AstraはARC-AGI-3を99.9%のスコアで飽和させた。
saturate、飽和。もう測れない、という意味で使う言葉です。
2人目。OpenAI社長のGreg Brockman氏。The New Stackの記者会見記事から。
I think it's not unreasonable to feel that we are now in the AGI era
和訳: 我々がいまAGI時代にいると感じることは、不合理ではないと思う。
not unreasonable to feel。感じることは不合理ではない。断言ではなく、二重否定と「感じる」で二段階ぼかしてあります。この慎重さは、ちゃんと評価したい。
3人目。ARC-AGI-3を作って運営している、ARC Prize財団のGreg Kamradt氏。9月3日の公式ブログです。
we are not claiming that it is AGI
和訳: 我々は、それがAGIであるとは主張しない。
作った側が、飽和させた側に対して、AGIではないと書いている。
3人とも、嘘は言っていません。同じ出来事を、違う場所から見ているだけです。ここからその「場所」の話をします。
ARC-AGI-3とは、何を測っているのか
ざっくり言うと、説明書のないパズルゲームです。
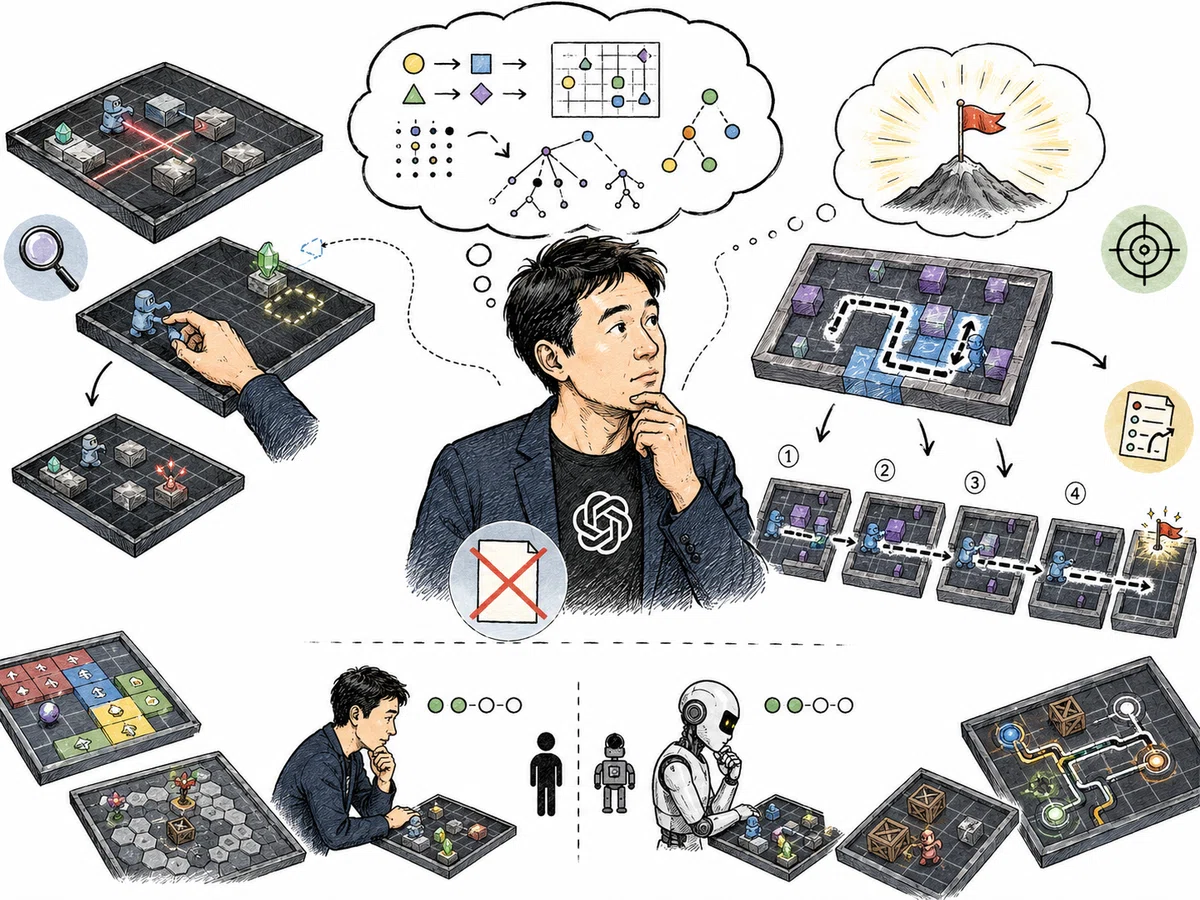
画面にゲームが出てくる。ルールは書いていない。ゴールも書いていない。自分で触って、何が起きるかを観察して、ルールを推測して、ゴールを見つけて、たどり着く。それを初見のゲームで何十本もやります。
ARC Prizeはこれを、探索、モデル化、目標設定、計画と実行の4つの能力を測るものだと説明しています。従来のARC-AGI-1や2が「1枚の図形パズルを解けるか」だったのに対し、3は「知らない世界に放り込まれて、自力で仕組みを理解できるか」です。
そして重要なのが、人間のベースラインの取り方です。ARC Prizeは公開前に、パズル経験で選抜していない一般の約500人にプレイさせて、各レベルをクリアするのに必要だった手数の中央値を記録しています。
つまりこのベンチマークは、解けたかどうかだけでなく、人間と同じくらい少ない手数で解けたかを測っています。彼らのAGIの定義がそのまま設計になっている。人間が獲得できるあらゆるスキルを、人間と同じくらい効率的に獲得できるシステム、という定義です。
62.7%と99.9%。同じモデルで、なぜ違う
ここが本題です。
ARC Prizeの検証結果を、推論の強さ(effort)ごとに書き出します。左がStandardハーネス、右がProvider Adapterハーネスです。
max: Standardが62.7%で26,098ドル。Provider Adapterが98.6%で17,332ドル
xhigh: Standardが59.3%で37,317ドル。Provider Adapterが98.4%で18,147ドル
high: Standardが54.8%で40,705ドル。Provider Adapterが99.9%で18,817ドル
medium: Standardが38.6%で48,090ドル。Provider Adapterが98.4%で19,285ドル
low: Standardが17.5%で38,166ドル。Provider Adapterが98.0%で21,298ドル
none: Standardが35.2%で49,791ドル。Provider Adapterが96.7%で23,457ドル
2026年9月4日の対顧客電信売買相場仲値、1ドル155円68銭で換算します。出典は七十七銀行です。
Standard、最高点の62.7%: 26,098ドル、約406万円
Provider Adapter、最高点の99.9%: 18,817ドル、約293万円
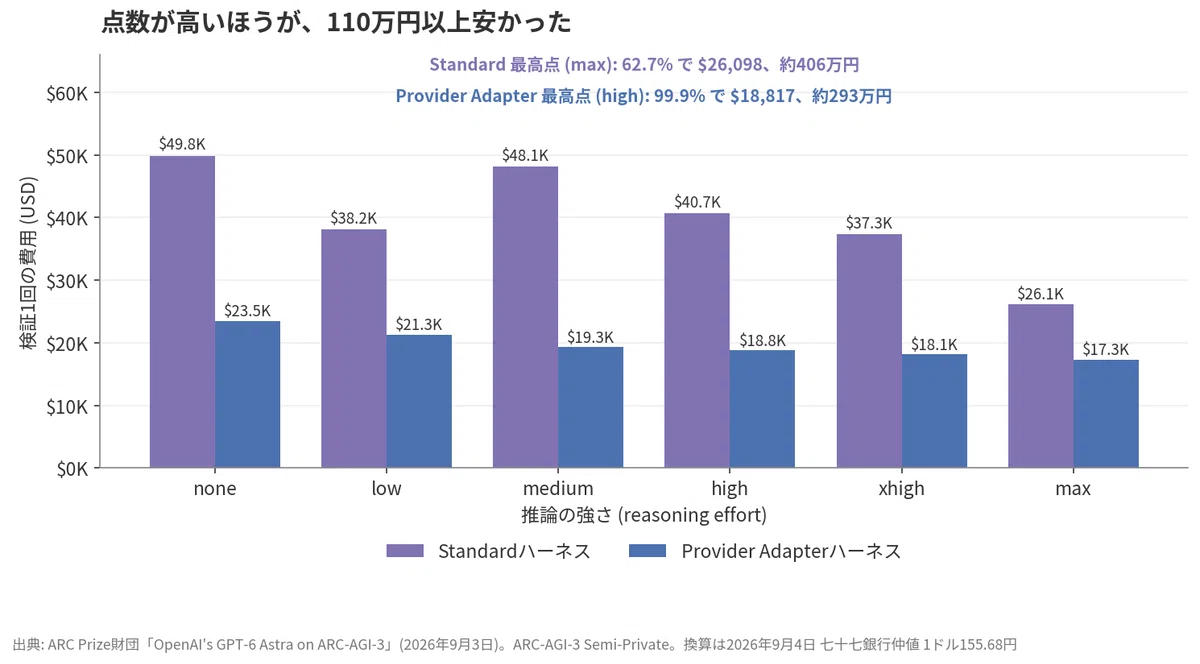
点数が37ポイント高いほうが、110万円以上安い。普通の直感と逆です。
ハーネスというのは、モデルの外側にある「作業台」のことだと思ってください。モデルがゲームを1手進めるたびにAPIを呼ぶわけですが、その呼び出しの間に何を覚えておけるかを決めるのがハーネスです。
Standardハーネス: ARC Prizeが用意した、全社共通の作業台。モデルは自分で「次に持ち越すメモ」を書き、それだけを次の手に持っていける。中の思考は毎回リセットされる
Provider Adapterハーネス: OpenAIが自社モデル用に設計した作業台。表に出ない推論の状態をリクエストをまたいで保持し、会話が長くなったら圧縮する。前回の思考を、そのまま次に使える
つまりStandardは「メモだけ持ち込み可」、Provider Adapterは「頭の中を持ち込み可」です。
ARC Prizeの集計では、両方のハーネスで解けた167組を比べると、Provider Adapterのほうが所要時間で約3.66倍速く、トークン総量で49%少なかった。だから安い。だから点も高い。
そしてARC Prizeはこう整理しています。Standardハーネスは「同じ最小限の共通インターフェースで、各社のモデルを比べたらどうか」という問い。Provider Adapterは「各社が自分のモデル用に設計した文脈管理を使わせたらどうか」という問い。2つのハーネスは、2つの違う質問に答えている。
彼らは今後、リーダーボードにこの2条件を明示的に分けて載せると宣言しました。ベンチマークの運営側が「モデル単体の点数」と「モデル+作業台の点数」を分けて扱い始めた。これはAstraの点数より大きなニュースだと僕は思っています。
手数では、人間に勝っています
ここは素直に驚いたところなので、ちゃんと書きます。
ARC Prizeは公開前、行動効率こそが人間とAIを分け続ける線だと予想していました。AIがいずれパズルを解けるようになっても、人間よりずっと多くの試行錯誤が要るだろう、と。
外れました。
Provider Adapterハーネスでのmax設定で、Astraは96.0%のレベルで人間の中央値より少ない手数でクリアし、平均で51.7%少ない手数だった。ARC Prizeはこれを「行動効率の指標において、人間と並び、上回った」と書いています。
しかも、その過程で面白いことをしている。Astraはゲームごとに、自分専用の記法を発明していました。ARC Prizeが公開したリプレイから、実際のメモを引きます。
L8: hub q2 (8↓). Lengths: 14=1
extend8 to3; retract10 to2; shorten8 to1
Turn 5: P=(24,20), empty, facing west
レベル、回転の向き、装置の長さ、手順、座標、向き。誰にも教わっていない省略記法で、ゲームの世界をコード風の記号モデルに圧縮している。ARC Prizeは他のモデルでも似た行動を見ているが、Astraの精度と情報密度は際立っていた、と評価しています。
さらに、コード実行環境を与えたPRO-LONGという別条件では、迷路ゲームのためにmaze_solver.py、戦闘ルールのためにcombat_solver.py、巡回する敵のためにpatrol_solver.pyを自分で書いて、予測と観測を突き合わせるsync_state.pyまで作っていた。ゲーム専用の小さなライブラリを、遊びながら作っている。
ただしARC Prizeは、ここにも注釈をつけています。人間の被験者にはコード実行環境もメモ帳もなかった。だからPRO-LONGの結果は「モデルと道具の合算」として読むべきだ、と。
人間の値段、AIの値段
ARC Prizeは費用も公開しています。ここは経営層に見せると効きます。
人間の被験者には、90分のセッションで115ドル、クリア1ゲームあたり5ドルのボーナス。1セッションで約9ゲーム挑戦するので、1ゲームあたり約12.78ドル、約1,990円です。
ただし、と彼らは続けます。この報酬の大半は、被験者の時間と、テストを受けてくれる意思に対する対価であって、脳が使ったエネルギーの対価ではない。脳の代謝を20ワットと置いて電気代で換算すると、1セッション0.6セント、1ゲーム0.067セント、約0.1円。
つまり人間側の価格は、見方によって1,990円にも0.1円にもなる。
AI側は、Provider Adapterのhigh設定で、セミプライベート問題集の全体を99.9%解いて18,817ドル。ゲーム数が非公開なので1ゲーム単価は出せませんが、桁で言えば人間の時給換算に近く、脳の電気代とは4桁ほど離れています。
この比較で僕が言いたいのは、AIが高いとか安いとかではありません。人間の作業の値段を、時間で払うか、エネルギーで払うかで、4桁変わる。AIと比べるとき、どっちと比べているのかを決めないと、比較は成立しない。ハーネスの話と、構造は同じです。
じゃあ、AGIなのか
3つの立場を、もう一度並べます。
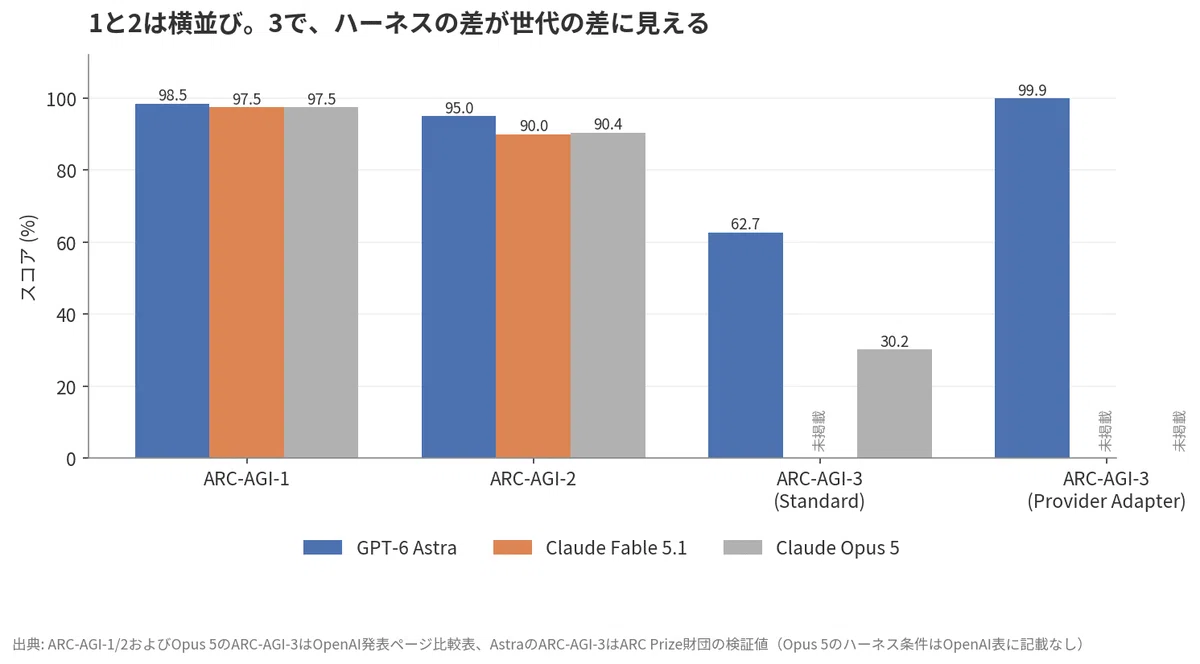
OpenAI: 飽和させた。AGI時代にいると感じることは不合理ではない
ARC Prize: 意味のある前進で、段階的な変化。ただしAGIだとは主張しない。ARC-AGI-3は範囲が限定され、環境は決定論的で閉じている。現実世界の複雑さと開放性は表していない
僕: 稟議書には書かない
ARC Prizeは公開時から、このベンチマークを飽和させることはAGIの証明にはならない、と論文で明言していました。彼らの次の関心は、再帰的な自己改善と、開放的なイノベーションをどう測るか、に移っています。
ここで、先日の記事に書いたことをもう一度置きます。AGIという言葉は、この2年で技術用語から資金調達用語に変わりました。だから稟議書には書かない。書くなら、来年また測れる数字を書く。
そして今週、その「測れる数字」に、もうひとつ条件が増えました。どのハーネスで測ったかです。
これは御社の話でもあります。同じモデルを契約しても、御社が組む作業台で点数が変わる。Standardの62.7%とProvider Adapterの99.9%の差は、モデルの差ではなく、文脈をどう持ち越すかという設計の差でした。それは御社のエンジニアが決める部分です。
明日、あなたがやる3つのこと
予算も稟議もいりません。今週できます。
1. AGIという言葉を、数字2つに置き換える
役員から「AGIらしいじゃないか」と言われたら、こう返してください。
「同条件で62.7%、OpenAI専用条件で99.9%です。差はモデルではなく作業台です」
数字2つと、差の理由を1文。ここまで言えると、次の質問が「じゃあうちの作業台は」に変わります。会話が、評論から設計に移ります。
2. ARC-AGI-3を、自分で1ゲーム遊ぶ
ARC Prizeのサイトで、誰でも遊べます。
5分でいいので、1ゲームだけ触ってみてください。説明書がない、ゴールがわからない、触って初めてルールがわかる。この感覚を持ってから99.9%という数字を見ると、見え方が変わります。そして自分が何手で解けたかを数えておくと、「人間の中央値より51.7%少ない」の重みがわかります。
3. 御社のエージェントの「持ち越し」を確認する
いま社内で動いているAIエージェントやRAGの仕組みについて、担当者に1問だけ聞いてください。
「呼び出しをまたいで、何を持ち越していますか」
会話履歴だけか。要約か。ツールの出力か。推論の途中経過か。ここの設計次第で、同じモデルの点数が62.7にも99.9にもなる、というのが今週わかったことです。答えが「特に何も」なら、そこが御社の伸びしろです。
社内でこの手の設計判断を誰がするのか、そもそも決める場がない、という段階で詰まっている方は、このあたりを先にまとめてあります。
「持ち越し」の正体
ここまで読んで、なぜ推論の状態を持ち越すだけで37ポイントも変わるんだ、と思った方へ。
僕も最初は魔法に見えました。で、いちばん効いた解決策が、恥ずかしいくらい原始的だったんです。
1回、自分の手で小さい言語モデルを作ってみることでした。
作ってみると、わかります。言語モデルには、呼び出しの外側に記憶がありません。1回の返答が終わると、頭の中は白紙に戻る。次の呼び出しで渡された文章だけが、そのとき知っていることの全部です。
Standardハーネスは、その白紙の状態に「前回のメモ」だけを渡す。Provider Adapterは、前回の思考の途中経過ごと渡す。人間で言えば、朝起きるたびに記憶を失う人に、昨日の日記だけ渡すか、昨日の脳をそのまま渡すか、の違いです。そりゃ後者のほうが速い。
これが腹落ちすると、先日のキャッシュの話と今回のハーネスの話が、同じ地図の上に乗ります。どちらも「呼び出しの間に、何をどう残すか」の話です。単価を下げるか、量を減らすか、思考を残すか。
手順は全部まとめてあります。数学は出てきません。
そもそも何から勉強すればいいかわからない、という人は、資格から入るのが結局いちばん速いです。私が実際に取ったものと勉強法を置いてあります。
最後に
この記事を書きながら、いちばん長く考えていたのは、ARC Prizeの費用の表でした。
推論を強くするほど、点が上がって、値段が下がる。max設定がいちばん賢くて、いちばん安い。
普通、賢さは高くつきます。長く考えさせれば、その分トークンを食う。ところがARC-AGI-3では逆でした。よく考えるモデルは、無駄な手を打たない。手数が減れば、呼び出しが減る。呼び出しが減れば、トークンが減る。
考える時間を惜しむと、行動でその分を払う。人間の仕事でも、だいたいそうですよね。
だから僕は、今週の結論をこう置きます。Astraは、AGIかどうかはわからない。でも、考えてから動く、という当たり前のことを、人間の中央値より上手にやる機械が、18,817ドルで数十本のゲームを解き切るようになった。
そしてその機械の点数は、御社が用意する作業台で37ポイント動く。
来週の会議、この一行から始めてみてください。
うちのエージェント、呼び出しの間に何を持ち越してますか。
たぶん、誰も答えられません。そこがスタートラインです。
やっていきましょう。
参考にした一次情報
ARC Prize財団「OpenAI's GPT-6 Astra on ARC-AGI-3」Greg Kamradt(2026年9月3日)
ARC Prize財団 GPT-6 Astra 検証結果の詳細ページ
OpenAI「GPT-6 Astra: A new generation of intelligence」(2026年9月3日)
https://openai.com/index/gpt-6-astra/
The New Stack「OpenAI launches GPT-6 Astra and says welcome to the AGI era」(Brockman氏の記者会見発言)
ARC Prize財団 ARC-AGI-3 人間テストに関する論文(arXiv 2603.24621)
https://arxiv.org/pdf/2603.24621
七十七銀行 米ドル対円相場(仲値)一覧表 2026年
おすすめマガジン
AIの勉強、ここからはじめて!
合格者が語るおすすめAI資格と合格法直伝マガジン!
AI導入には乗り越えなければならない壁がある!
社内導入に必要なあれこれを総まとめ!
チャットAIを自分で0からつくってみよう!
Mac編
Windows編
仕事道具、そろえておきませんか
作業効率が変わるガジェットをまとめています
筆者X
AI最新情報(ポエム多め)を発信中!
Qiita
Zenn
いいなと思ったら応援しよう!
この記事は noteマネー にピックアップされました

