AIに書かせたコードをAIで検査しよう

アプリ開発講座③技術的負債を、AI自身にあぶり出させる
AIにコードベース全体を健康診断させる仕組みと、その指摘の6〜8割が誤検知だった実測、そして直す前に1件ずつ仕分ける4ステップをまとめました。
この記事を読むと得られるもの
・どんなプロジェクトにも一から導入できる、負債あぶり出しの仕組み(分析コマンド1本+skill 2本)を作らせる導入プロンプト全文 ・指摘を🔴🟡🟢に分類させるための判定基準と、レポートの読み方 ・誤検知を見抜く4ステップの検証手順と、5段階の仕分け表 ・「なぜ直さなかったか」まで後から追える、検証結果の出力フォーマット ・運用に乗ったあと、一言で全工程を回すための場面別プロンプト4本
こんな人におすすめ
・AIに書かせたコードが増えてきて、全体の健全性を把握できなくなっている人 ・AIのレビュー指摘をそのまま直して、動いていたコードを壊した経験がある人 ・CLAUDE.mdが肥大化してきて、運用ルールの置き場所に悩んでいる人
読む前に、先に済ませておいてほしいこと
・ターミナル(パソコンに文字でコマンドを打つ画面のことです)をまだ一度も開いたことがない人。先に①要件定義編で、Claude Codeを動かすところまで済ませてください。そのうえで、この記事に戻ってきてもらえれば大丈夫です ・Windowsを使っていて、WSL(Windowsの中でLinuxを動かす仕組み)をまだ入れていない人は、先にWSLを入れてください。この記事の実装例は、bashが使える環境を前提にしています。ここだけは、買ってからでは埋められない前提です
この記事は、①②で作ったアプリを手元に置きながら読む回です。コマンドはすべて、Claude Codeにそのまま貼れる形で載せています。ターミナルを自分で開く必要はありません。
そのうえで、次に当てはまる方には向きません。
・すでに「指摘を検証してから直す」運用が回っている人。仕組みではなく実測値だけを見たいなら、実測値と計測条件は無料部分にすべて載せています
・コピペすればそのまま動く完成スクリプトが欲しい人(この記事が渡すのはAIにその仕組みを作らせるための導入プロンプトです。ファイル構成・設定値・コマンドオプションは載せていますが、シェルスクリプトやAST lint〔コードの構造を機械的に検査する自作ルール〕の本文そのものは付いていません)
・ソースコードを外部のモデルに送信できない環境の人(この仕組みは、対象ファイルの中身をAIに渡すことが前提です)
このシリーズの5記事について
Claude Codeでアプリを作り、育てていくまでを5本に分けて書いています。
① 要件定義編 ── 何を作るかを、Claude Codeに伝わる形で言葉にする
② 計画→実装→テスト・なぜなぜ分析編 ── 仕様書からアプリを組み上げ、不具合を根本から直す
③ 技術的負債を、AI自身にあぶり出させる ── まだ表面化していない問題を、先回りで洗い出させる (この記事)
④ AIのなぜなぜ分析が浅くなる理由と、2軸の横並びチェック ── 見つけた1件を、二度と再発しない形で直しきる
⑤ セキュリティ監査編 ── 人に使ってもらう前に、危ない箇所を洗い出す
番号は公開順です。読む順ではありません。はじめてアプリを作るなら①②、人に使ってもらう前に⑤、アプリが育ってきたら③④、の順が自然です。どの記事から読んでも単体で完結します。
5本とも、コードを書いたことがない方が読める形にしてあります。③④はコマンドの結果を読む場面が出てきますが、打つのはClaude Codeなので、読んで判断できれば足ります。
5本を通して一貫しているのは、AIの出力をそのまま信じないという姿勢です。要件定義書も、実装も、AIが出したバグや脆弱性の指摘も、要所で人間が確かめる。その確かめ方を各記事で具体的に扱っています。
5本を個別に買うと4,020円ですが、マガジンなら1,500円です。3本以上読む予定なら、そちらのほうが安くなります。今後追加する回も、追加料金なしで読めます。
この記事についてだけ、範囲を先に断っておきます。この記事だけでも、負債をあぶり出して仕分けるところまでは動きます。見つけた1件を根本から直しきる部分は、④で深掘り。
レポートに🔴が6件並んでいました。上から順に直していけば、コードベースは健全になるはずでした。
ところが1件ずつ実際のコードと突き合わせたら、直す価値があったのは1件だけでした。残りの5件は、過去に一度バグを直した結果として今の形になっている箇所か、そもそも今のコードパスでは踏めない箇所だったのです。
わたしのプロジェクト(Pythonで書いた株価チャート分析ツール)で3回計測して、誤検知率は**83%/82%/60%**でした(うち1回はセキュリティ監査の指摘です)。3回とも、指摘の6割から8割が空振りでした。
この記事では、AIにコードベース全体を健康診断させる仕組みをゼロから導入する手順と、その指摘を鵜呑みにせず仕分けるための検証手順を扱います。結論から言うと、効いたのは分析の精度を上げることではなく、分析と修正のあいだに検証を1工程はさむことでした。
先に、言葉とシリーズの位置づけ
(見慣れている方は次の章まで飛ばして構いません)
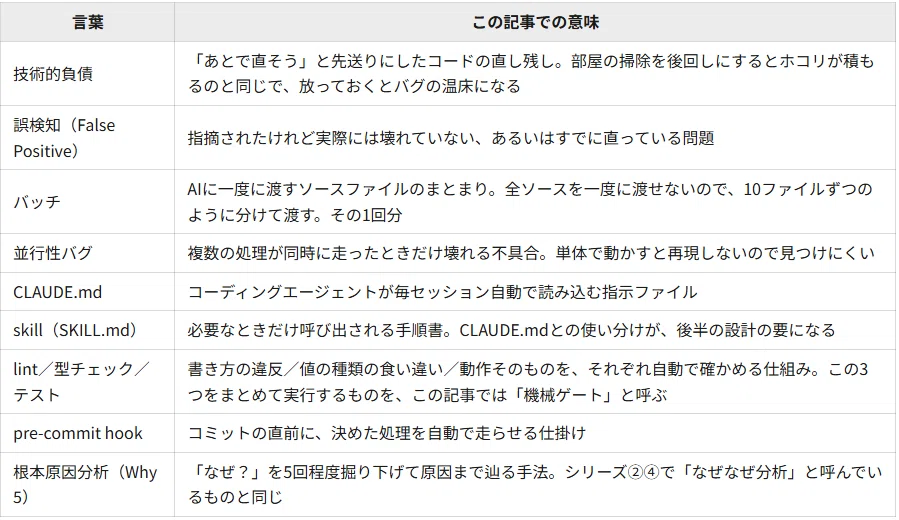
この記事では「直す価値がなかった指摘」をまとめて、広い意味で誤検知と呼びます。後半に出てくる仕分け表の⚪印は、そのうち最も狭い意味(実は壊れていなかったもの)を指します。
なぜ、AIコーディングでは負債のあぶり出しが必要なのか
人間だけで開発していた頃に比べ、AIコーディングでは技術的負債が速く・見えにくく・繰り返し溜まります。しかもそれは、開発者の怠慢ではなくAIの特性そのものから来ています。
理由は5つあります。
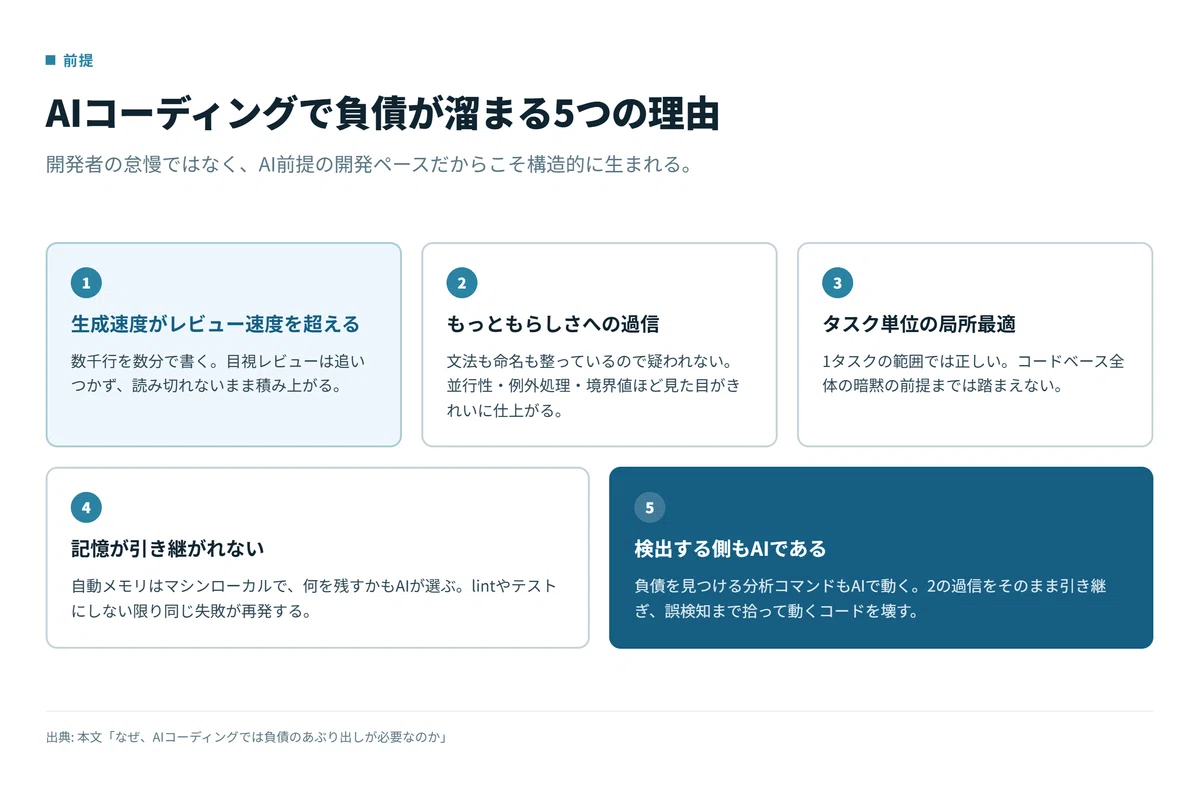
1. 生成速度がレビュー速度を超える
AIは数千行のコードを数分で書きます。人間の目視レビューは追いつきません。
「読み切れないまま積み上がる」状態が常態化しやすく、定期的にコードベース全体を健康診断させる仕組みがないと、負債は気づかれないまま増え続けます。
2. もっともらしさへの過信(automation bias)
AIが書くコードは文法も命名もコメントも整っていて、説明も流暢です。だから人間のレビュアーは「大丈夫だろう」と過信しやすくなります。
やっかいなのは、むしろ壊れやすい箇所ほど見た目がきれいに仕上がることです。並行性、例外処理、境界値、タイムゾーンといった、本来もっとも疑うべき部分がそうなります。
3. タスク単位の局所最適
AIは与えられた1タスクの範囲では正しく動くコードを書きます。しかし、コードベース全体の暗黙の前提までは踏まえません。
たとえば「この値は、DBに入る前に必ず正規化されている」という前提があるとします。新しく足した経路だけがその正規化を通っていなくても、その機能単体では動いてしまう。こうした食い違いは、機能ごとに見ているかぎり見えません。
4. 記憶が引き継がれない
人間のエンジニアは「前にこれで痛い目にあった」を覚えています。AIにも記憶の仕組みはあります。CLAUDE.mdは毎セッション読み込まれますし、Claude Codeには自動メモリ(Claude自身が学びを書き溜める仕組み。既定でオン)もあります。
ただし自動メモリはマシンローカルで、しかも何を残すかをAI自身が選びます。「必ず守られる」保証はありません。別のマシン、別のエージェント、CIの中では、その学びは効きません。
lintやテストとしてルール化しない限り、同じ失敗パターンが形を変えて何度でも再発します。
5. 検出する側もAIであるという問題
そして5つ目が、この記事の核心につながります。負債を見つける分析コマンド自体もAIで動くため、2つ目に挙げた「もっともらしさへの過信」をそのまま引き継ぐのです。
指摘を鵜呑みにして直すと、誤検知まで拾ってしまい、動いていたコードを逆に壊しかねません。
この5つはどれも、人間が普通にレビューしていれば防げた類の問題ではありません。AI前提の開発ペースだからこそ構造的に生まれる問題です。
全体像:2系統の検出と、1本の確認フィルタ
そこで、負債を見つける仕組みを2段構えにします。
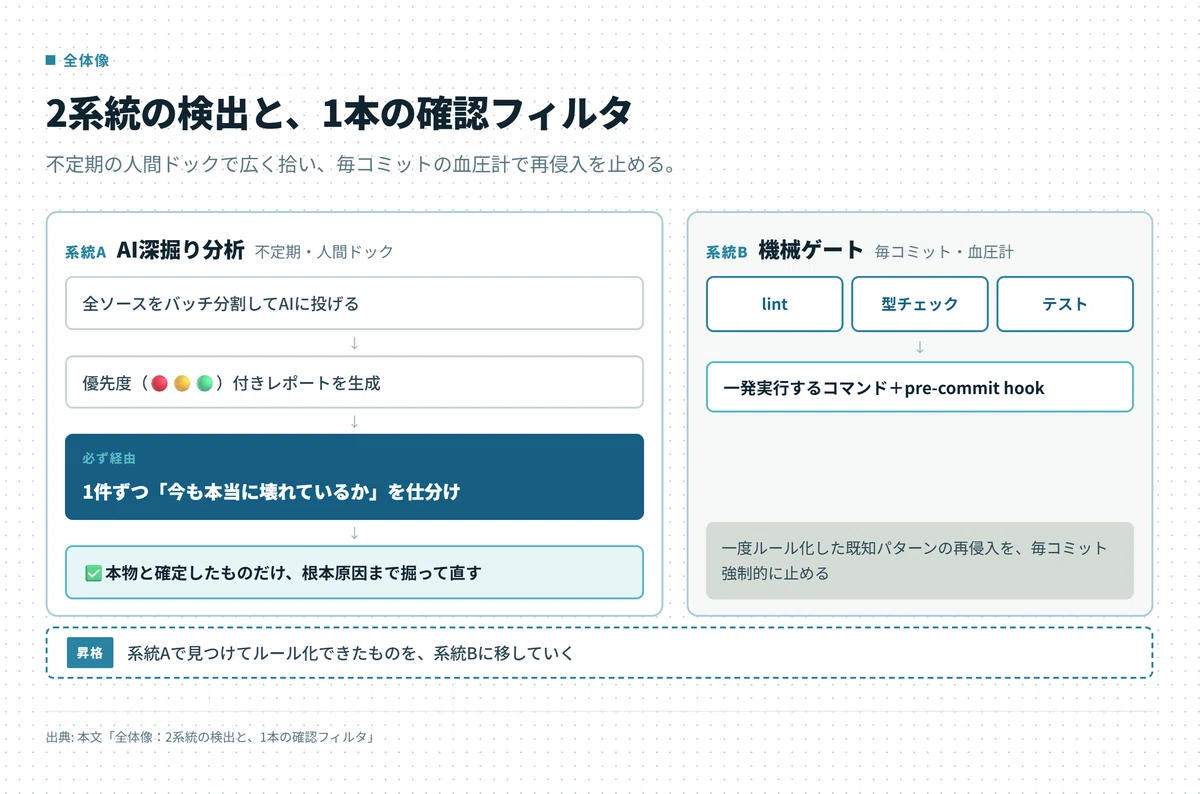
系統A: AI深掘り分析(不定期・人間ドック)
  分析コマンドを実行
    → プロジェクトの全ソースをバッチ分割しAIに投げる
    → 優先度(🔴🟡🟢)付きレポートを生成
    → 【必ず経由】1件ずつ「今も本当に壊れているか」を仕分け
    → ✅本物と確定したものだけ、根本原因まで掘って直す

系統B: 機械ゲート(血圧計)
  lint+型チェック+テストを一発実行するコマンド
    → 一度ルール化した既知パターンの再侵入を止める
    → pre-commit hook に載せて「毎コミット強制」にする
系統Aは人間ドックにあたります。まだ症状が出ていない病気の芽を、経験豊富な医師(AI)の目でざっと見つけてもらうイメージです。まだルール化されていない未知の負債を、広く拾うのが役目です。
系統Bは血圧計や体温計です。決まった項目だけを、毎回機械的に測ります。一度特定してルール化した既知パターンの再侵入を防ぐのが役目です。
この記事の主役は系統Aですが、系統Bが無いと系統Aで見つけたものが積み上がるだけになります。有料エリアには、両方をまとめて作らせるための環境構築プロンプトも入れてあります。
そして、この2つの間にもう1本だけ、絶対に外せないものがあります。
この記事の核心:AIの指摘は、6〜8割が誤検知だった
人間ドックには「疑わしきは全部報告する」性質があります。実は健康なのに「要精密検査」と言われることが多いのと同じで、AIの分析も誤検知を大量に含みます。
これは感覚の話ではありません。わたしのプロジェクトで実際に計測した数字がこれです。
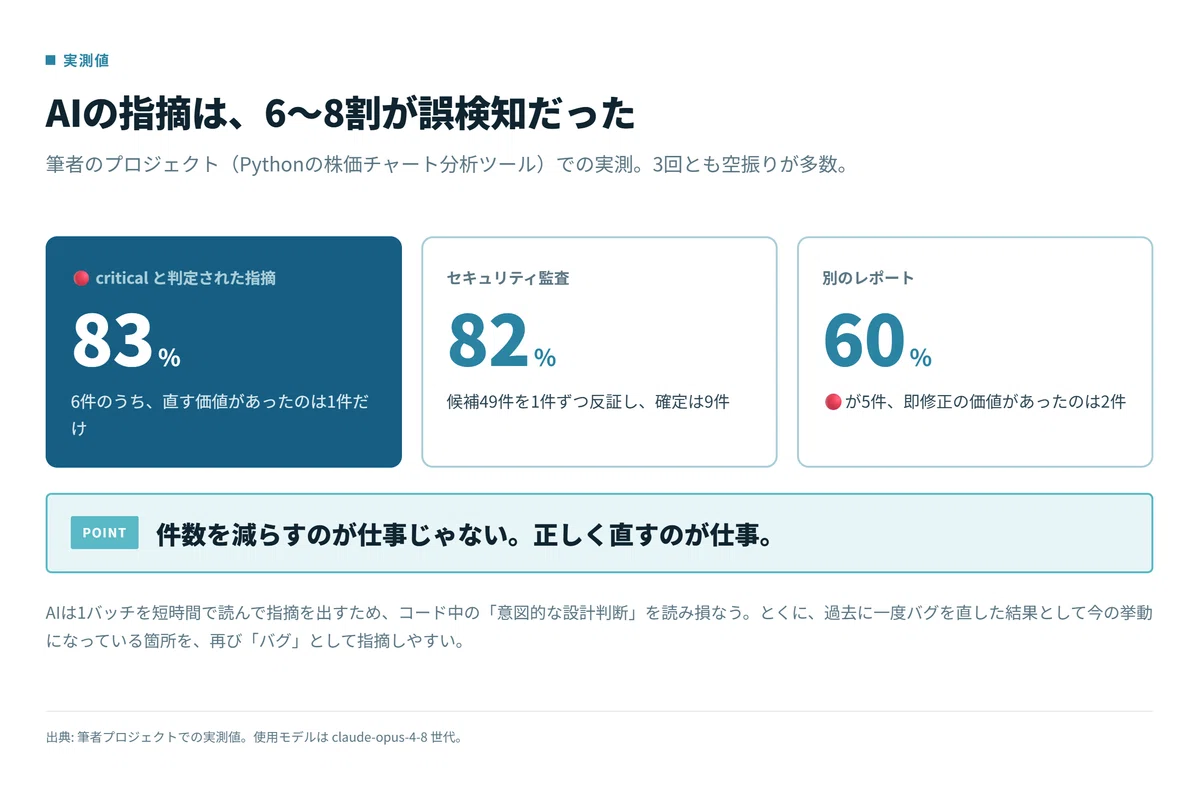
・🔴 critical と判定された指摘6件のうち、実際に直す価値があったのは1件だけ(誤検知率83%)
・セキュリティ監査:候補49件 → 1件ずつ反証を試みる形で検証し、確定したのは9件(誤検知率82%)
・別のレポート:🔴が5件 → 即修正の価値があったのは2件(誤検知率60%)
数字の読み方だけ先に断っておきます。3つとも同じPythonプロジェクト1本での計測で、母数は6件・49件・5件とばらつきがあります。2つ目は技術的負債ではなくセキュリティ監査で、しかも「候補」49件からの絞り込みなので、1つ目・3つ目(🔴と確定判定された指摘)とは性質がやや違います。母数が1桁のものは、1件の判定が変わるだけで割合が16〜20ポイント動きます。
もうひとつ、計測に使ったモデルはclaude-opus-4-8です。分析に使うモデルを変えれば、この割合も当然変わります。
なので「83%」という数値の精度は当てにしないでください。持ち帰ってほしいのは「空振りが多数派になる」という規模感のほうです。何割かは分からないが、半分以上は外れている前提で運用を組む。それだけで十分に設計が変わります。
2つ目に挙げたセキュリティ監査については、実際の監査のかけ方(観点を指定するプロンプト、指摘を反証させる手順、実施タイミング)を⑤のセキュリティ監査編にまとめてあります。なお「反証」とは、指摘を支持する根拠ではなく指摘と食い違う事実を探しにいくことで、この記事でいう検証の中身そのものです。以降は「検証」で統一します。
この記事は技術的負債、⑤はセキュリティと対象が違いますが、指摘を鵜呑みにせず確かめてから直すという手順の骨格は共通です。
なぜAIは、こんなに誤検知を出すのか
理由ははっきりしています。分析に渡しているのが、コードベースの一部だけだからです。
全ソースを一度にAIへ渡すことはできないので、10ファイルずつのようなバッチに分けて渡します。するとAIから見えているのは、そのバッチに入ったコードだけです。呼び出し元がどこで値を作っているか、その挙動を守るテストがあるか、過去にどんな修正が入ったか、なぜこの順序になっているかを書いたコメント──判断に必要な材料のほとんどが、視界の外にあります。
だからAIは、目の前のコードだけを見て「これは壊れている」と書きます。特に多いのが、「過去に一度バグを直した結果として今の挙動になっている」箇所を、再びバグとして指摘するパターンです。
つまり、丁寧に直してきたプロジェクトほど誤指摘を呼び込みやすい構造になっています。指摘をそのまま直しにいくと、動いていたコードをわざわざ元に戻す作業になりかねません。
だから、直す前に検証する
ここから導かれる運用が verify-then-fix(検証してから直す) です。指摘を受け取ったら、すぐ直しにかからず、1件ずつ「今も本当に壊れているか」を確かめる工程を必ず挟みます。
やることは単純で、AIに見えていなかった4つを、人間が見にいくだけです。
実コードを開いて読む ── レポートの説明文ではなく、現物と、その値がどこから来ているかを見る
既存テストを動かす、または小さく再現する ── その挙動を守っているテストがないかを見る
git履歴を引く ── 過去に同じ問題を直していないかを見る
日付つきコメント・docstringを読む ── 意図的にそうしている理由が書かれていないかを見る
4つとも、バッチを読んだだけのAIには手が届かない情報です。だから人間が確認する価値がある。
この4つを通したうえで、5段階(✅本物/🟡降格/🟠意図的に対応しない/⚪誤検知/🔁解決済み)に仕分け、✅だけを修正に回します。
この5つは検証の結果を表すもので、レポート側の優先度(🔴🟡🟢)とは別軸です。同じ🟡が両方に出てきますが、指しているものが違います。優先度の🟡は「中くらいの重要度」、仕分けの🟡は「主張が過大だったので格下げ」です。
各ステップで具体的に何を見るか、どのコマンドを叩くか、仕分け結果をどう書き残すかは有料エリアで扱います。
合言葉はこうです。
件数を減らすのが仕事じゃない。正しく直すのが仕事。
火災報知器が湯気で鳴っても、まず自分の目で火事か確かめますよね。報知器を無視はしないけれど、鳴った全部に消防車は出さない。それと同じ考え方です。
ここまでで持ち帰れること:🔴の定義を書き換える
無料部分の最後に、今日そのまま使えるものを置いておきます。
書き換えるのは、AIにコードレビューを頼むときのプロンプトのうち、優先度の付け方を指示している箇所です。すでにAIレビューを回している人なら、その指示文の該当箇所を差し替えるだけで効きます。
🔴(高優先度)の定義に「現在のコードパスで再現可能なもの」という条件を入れてください。
AIに優先度を付けさせると、放っておけば「理論上は起こりうる」ものまで🔴に入ります。結果、🔴が20件並んで優先順位が意味をなさなくなる。わたしの手元で🔴が6件や5件に収まっていたのは、この線引きを先にプロンプトへ書いておいたからです。
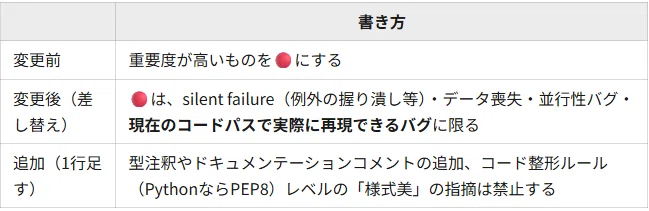
1行を差し替えて、1行を足す。これだけで、レポートから「理論上のリスク」と「様式美(=動作に影響しない書式レベルの指摘)」がまとめて消えます。件数は減りますが、読む価値は上がります。
まだAIレビューを回していない人は、貼り先がないので次の依頼文をそのまま使ってください。仕組みを作る前に、レポートがどんなものかを1回見られます。
このプロジェクトの <ディレクトリ、例: src/> 配下を、シニアレビュアーとして
レビューし、技術的負債を Markdown で指摘してください。
各指摘には 場所(file:行番号) / 現象 / 根本原因 / 修正方針 / 検証方法 を付けてください。
優先度は🔴🟡🟢の3段階とし、🔴は silent failure・データ喪失・並行性バグ・
「現在のコードパスで実際に再現できるバグ」に限ってください。
型注釈やドキュメンテーションコメントの追加、コード整形ルール(PEP8等)
レベルの指摘は書かないでください。
ただし、これは指摘の量を絞る話であって、残った指摘が正しいかどうかはまだ何も確かめていません。AIが誤検知を出す割合そのものは、この2行では変わりません。誤検知を修正作業まで持ち込ませないのは、この先の検証工程の仕事です。
ここまでが、この仕組みの設計思想です。
ここから先で手に入るもの
・導入プロンプト全文(読者が埋めるのは5か所だけ。対象プロジェクトの中身をAIが知らなくても、分析コマンド1本とskill 2本を一度に構築できます)と、その設計意図3か所
・誤検知を見抜く4ステップの検証手順(各ステップの具体的な確認内容とgitコマンド、どこまでAIに任せてどこから自分で判断するかの線引き)、5段階の仕分け表、「なぜ直さなかったか」まで残る出力フォーマットのひな形
・CLAUDE.mdを薄いまま保つskill分割の設計(何をCLAUDE.mdに書き、何をSKILL.mdへ出すか。トリガー文とdescriptionの実例つき)
・運用に乗ったあと一言で全工程を回す場面別プロンプト4本(普段づかい/PDCA環境構築=系統Bのゲートとpre-commitごと作らせる/仕分けだけ/生成物が仕様どおりでないときの再指示)
・導入時の受け入れチェックリスト(5項目)、非対話実行で落ちないための具体的なコマンド指定、初回でつまずく8パターンのトラブルシューティング表、実際に動いている実装例(ファイル構成・バッチ設定・skillの置き方・コマンドオプション7種)
ここから先は
AIコーディングの開発手法
コードを書かずに、Claude Codeでアプリを作るための講座です。 要件定義・計画・コード検査・なぜなぜ分析・セキュリティ監査の5工…
この記事が気に入ったらチップで応援してみませんか?
