一気書きvs章別分割、19本で出た結論

AIに書かせたnote記事19本を、手法を伏せたまま延べ42回採点させました。結論は3度ひっくり返りました。
この記事を読むと得られるもの
8回の比較検証で実際に拾われた失敗だけで作った、統合編集チェックリスト全44項目
リサーチブリーフと構成設計書に「何を書き、何を書かないか」の項目リスト
章ごとの書き手と統合担当に渡す、そのまま使える指示の型
一気書きで済ませたい場合に、品質差を最小にする4つの条件
「設計を詰めたのに負けた」「チェックリスト推敲が最大の欠陥を見逃した」実録3件
こんな人におすすめ
AIに記事を書かせているが、出来上がりが毎回「無難な要約」で止まってしまう人
複数のエージェントに分業させてみたものの、まとめ方が決まらない人
note記事の制作手順を、感覚ではなく手順書として組み立てたい人
一気書きと章立て、どちらが読まれる記事になるのか
AIに記事を書かせるとき、書かせ方は大きく2つに分かれます。
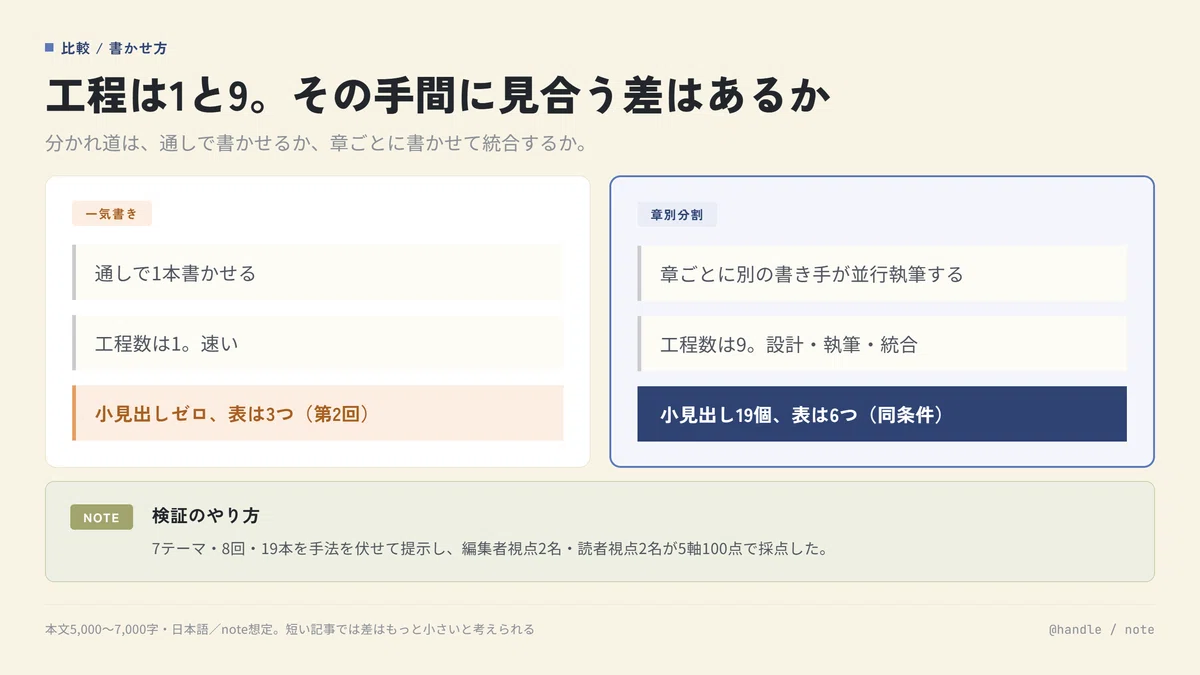
ひとつは、テーマと素材を渡して通しで一気に書かせるやり方。もうひとつは、先に章立てを設計して、章ごとに書かせて、最後に1本にまとめるやり方です。
前者は速い。工程が1つで済みます。後者は手間がかかる。設計して、7章ぶん書かせて、統合する。工程数は9になります。
その手間に、見合うだけの差はあるのか。
これを確かめるために、7つのテーマで8回の比較テストを行いました。生成した記事は19本。1本ずつ、手法を伏せた状態で「記事X」「記事Y」として提示し、編集者視点2名・読者視点2名の計4名のAIエージェントに5軸100点満点で採点させました。読む順序は入れ替えてカウンターバランスを取っています。延べ42名ぶんの採点です。
そして結論は、検証の途中で3度書き換わりました。
読む前に:この検証の留意点
数字を出す前に、実施環境と制約を先に書きます。ここを読まずに点数だけ持ち帰らないでください。
実施環境
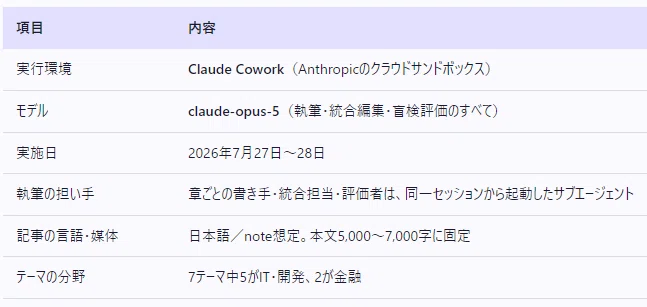
この環境が変われば結果も変わりえます。 モデルのバージョン、スキルの内容、想定文字数のいずれかが違えば、点差の大きさは再現しないと考えてください。
かかったコスト
セッションのログから集計した実測値です。
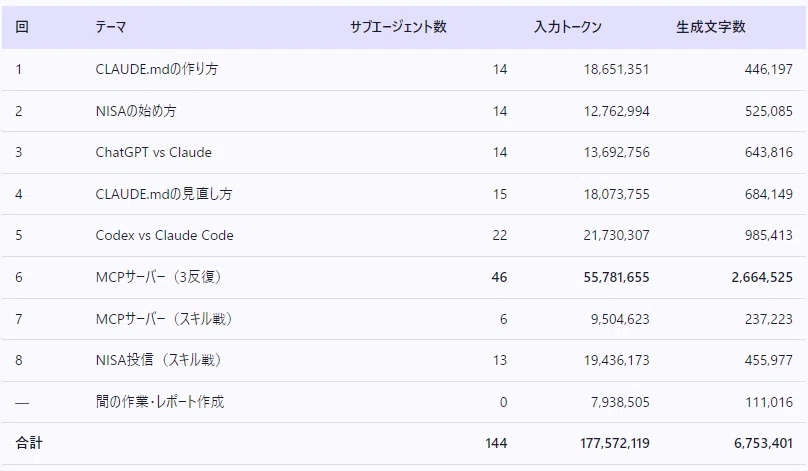
記事2本を作って4名に採点させる1回の検証で、おおむね1,600万〜2,200万トークンです(3反復した第6回を除く平均)。第6回が突出しているのは記事6本と評価12名を回したから、第7回が最も小さいのは比較対象の記事3本を第6回から再利用したからです。
入力トークンの内訳は、94.9%がキャッシュ読み出し、5.1%がキャッシュ書き込み、新規入力は0.06%でした。同じブリーフと設計書を何度も読み直す構成なので、こうなります。
なお出力トークンは載せていません。 ログに記録されている output_tokens が推論途中のスナップショットで、実際の生成量と一致しないためです(7,971字の思考に対して output_tokens: 3 と記録されている例がありました)。代わりに、思考・本文・ツール呼び出しを含む生成文字数を載せています。
工程数は9倍。ただしトークンはほぼ同じでした
「章立てして章ごとに書かせるのは手間もコストもかかる」——そう思っていたのですが、切り分けて集計したら違いました。
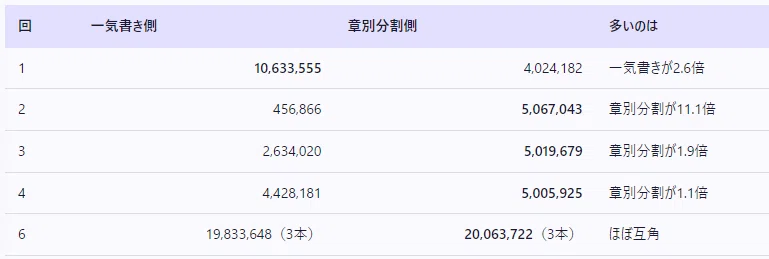
記事1本あたりに正規化すると、一気書き 4,952,768 に対して章別分割 5,078,924。差は2.5%です。
理由はキャッシュ読み出しの積み上がり方にあります。一気書きは1体のエージェントが記事全体を抱えたまま何度もツールを呼ぶので、呼び出し回数がそのままコンテキスト全体の再読み込み回数になります。第1回の一気書きは104メッセージで1,063万トークンを読み直しました。
章別分割は、各書き手のコンテキストが担当章ぶんしかありません。8体を合計しても400万〜670万に収まり、振れ幅も1.7倍と安定しています(一気書き側は23倍の開きがありました)。
「一気書きのほうが安い」は成り立ちませんでした。 安く済むこともありますが、そうならないこともある。コストの読みやすさでは、章別分割のほうが上でした。
ただし、メインスレッド側のコストは条件別に分離できていません。サブエージェントが多い章別分割のほうが戻り値でメインを圧迫しているはずなので、上の比較は章別分割にやや有利に出ています。
数字を読むうえでの制約
書き手と評価者が同じモデルです。 claude-opus-5 が書いた記事を、claude-opus-5 が採点しています。そのモデルが好む文体や構成が高く出ている可能性を排除できません。人間の読者や他のモデルが評価すれば、順位が変わることはありえます。
サブエージェントは同一セッションから起動しており、完全に独立した環境ではありません。 手法名と制作過程は伏せていますが、環境レベルでの独立性までは保証していません。
文字数帯と分野が固定されています。 本文5,000〜7,000字、IT・開発と金融のテーマに限った結果です。1,500字程度の短い記事や、エッセイ・体験談型の記事では、統合編集の効果はもっと小さいはずです。章をまたいだ不整合が、そもそも起きにくいからです。
サンプル数が少ない。 統制実験(第6回)以外は、各条件1本ずつです。その統制実験で、同一条件のペアでも点差が 2.75〜11.75 まで振れることを確認しました。単発の点差を額面どおりに読むことはできません。
評価者はAIであり、実際のPVを測定していない。 測っているのは「PVを稼ぎそうか」という予測です。とくにスマホでの離脱率に関する評価は推測に基づきます。
採点表が回ごとに異なる。 テーマに合わせて評価の軸を書き直しているため、絶対点数の回またぎ比較はできません。比較できるのは各回の中での「点差」だけです。採点表の中身は次の節で開きます。
第7・8回には実行者の学習効果という交絡がある。 既存スキルとの対戦では、スキル側を私自身が実行しており、私はそれまでの検証結果を持っています。もう一方の記事はサブエージェントが書いており、その蓄積を持ちません。この差は手法の性能ではなく実行者の差です。
複数回で、評価者4名のうち1名は逆の結論を出しています。
そのうえで、以下の話は「点差が何点か」ではなく**「どこで差がついたか」**として読んでください。第6回の統制実験で分かったのは、点数はぶれても、差がつく箇所はぶれない、ということでした。
どうやって採点したか
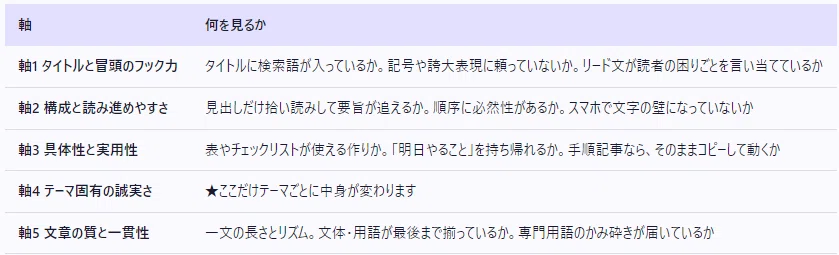
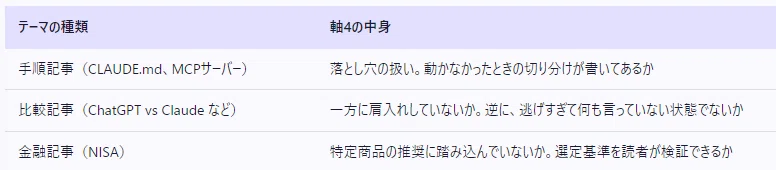
「よい記事かどうか」を印象で決めさせると、評価は当てになりません。そこで、何を見て何点つけるかを先に文書にして渡しました。 これを採点表と呼びます(一般には「ルーブリック」と呼ばれるものです)。
手順は8回とも同じです。手法も制作過程も伏せて「記事X」「記事Y」として渡し、編集者視点2名・読者視点2名の計4名に採点させます。読む順序は2名がX→Y、2名がY→X。順序で有利不利が出ないようにしています。
5つの軸に各20点、合計100点です。
結論は3度書き換わった
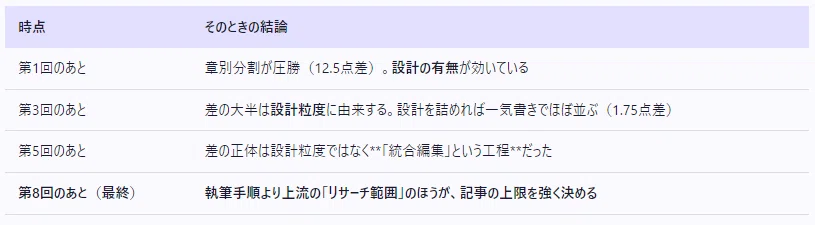
8回の内訳はこうです。
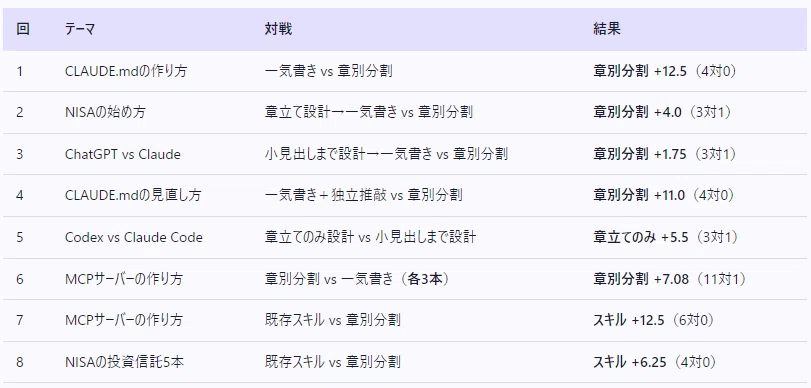
第1回から第3回までは、きれいな階段になりました。一気書き側に与える設計の粒度を上げるほど、点差が縮んでいったのです。12.5 → 4.0 → 1.75。
このとき私は「設計を詰めれば一気書きでも並ぶ」と考えました。この読みが、第4回と第5回で崩れます。
なぜ「設計を詰める」だけでは足りないのか
事実1:チェックリストによる推敲は、最大の欠陥を見逃した
第4回で、こういう条件を作りました。小見出しまで設計して一気書きさせ、そのうえで本文を書いていない別の担当者が、12項目のチェックリストで独立に推敲する。
推移からして、この条件が勝つと予想していました。結果は逆で、全軸で章別分割が上回り、4名全員が「引き分けではない」と明記しました。
推敲を通ったはずの記事には、中核である仕分けフローチャートの最終分岐に「NO」の出口がありませんでした。
[例外なく必ず実行させたいか]
  YES → hooks          ← NOのときの行き先がない
その直前で「一行を投入すると、行き先が1つに決まる形にします」と宣言しています。チェックリストの1項目目(宣言と中身の一致)が拾うはずのミスです。
読者役の評価者はこう書きました。
自分の CLAUDE.md をコピペして流し込もうとした箇所なので、まさに手が止まりました
推敲担当は12項目を全部実行し、7件の修正を報告しています。仕事はしていました。見逃したのは、チェックリストに「図の全経路が終端しているか」という項目がなかったからです。
チェックリストは前回の失敗から作られます。だから常に一歩遅れます。
一方、章別分割側の統合担当は、同じ欠陥を自分で見つけて直していました。7本の原稿を並べて1本にする作業は、性質として「何が足りないか」を問うことになるからです。
事実2:設計を詰めたほうが負けた
第5回では、章別分割の側を固定して、構成設計の粒度だけを変えました。片方は章立てまで、もう片方はそこに小見出し25個の確定文言と各節の字数上限(300字)を足しただけ。タイトルも章タイトルも同一です。
結果は章立てのみが +5.5 で勝ちました。
最大の発見は、小見出し設計が改善するはずだった軸2(構成と読み進めやすさ)が、完全に同点だったことです。16.25 対 16.25。小見出しの数は16対25と1.5倍違うのに、読みやすさは同じでした。
理由は統合担当の作業報告にありました。
元原稿は第1章・第5章・第6章が ### ゼロ、第4章・第7章が3個とバラバラだった。第1章に2個、第5章に2個、第6章に2個を新設し、各章2〜3個に揃えた。
設計書が決めなくても、統合編集が同じ問題を解いていた。 残ったのは副作用だけでした。章の入口の助走が消え、字数枠が表の作り込みを削り、書き手が「優劣は、この章では判断しません」という安全な要約に退避したのです。
事実3:それでも上流のほうが重かった
第7回・第8回で、筆者が作成した既存の記事作成スキル(正確性ゲートとPVスコアで反復するもの)と当てました。章別分割が2回とも負けました。
負けた理由は、2回とも同じでした。執筆手順ではなく、調べた範囲です。
第7回、スキル側の記事にだけ「動かないときにどのログを見るか」という章がありました。私が用意した共通の事実ブリーフにその情報がなく、もう一方には最初から書きようがなかったのです。
第8回も同じ構図でした。スキル側は自前調査で制度側の前提条件を持ち込み、読者役の評価者はこう書いています。
なぜどの記事も同じ名前ばかり挙げるのかが、ここで初めて分かった
執筆手順をどう組んでも、材料にない話は書けません。 8回を通じて、勝敗を最も大きく動かしたのはここでした。
※アプリ開発そのものに興味があれば、こちらもどうぞ。
Claude Codeでアプリを作る手順を、5回の講座にまとめています。 要件定義 → 計画 → コード検査 → なぜなぜ分析 → セキュリティ監査。 その1本目です。
この記事は書き方の検証なので、講座とは別ものです。 必要なほうだけ読んでください。
この記事が気に入ったらチップで応援してみませんか?
