Qwen-Image-Editは代替できているのか? PixAI / SDXL / DiT環境との決定的な違い

最近、Qwen-Image-Edit という画像編集モデルが話題になっています。
「既存の画像を、言葉で少しだけ直せる」という触れ込みを見ると、
今使っている PixAI や ComfyUI の構成で代替できるのでは?
と感じる人も多いと思います。
私自身も同じ疑問を持ち、整理してみました。
結論から言うと、代替にはなっていません。
ただし、代替を必要としない別ルートに入っている可能性はあります。
Qwen-Image-Editがやっていることの本質
Qwen-Image-Editは、単なる画像生成モデルではありません。
画像を一度「意味的に理解」し
人物・服・表情・背景といった要素を分解し
「ここだけを変える」という編集を行います
重要なのは、
ピクセルを直接いじっているのではなく、
画像を意味構造として扱ってから再構成している
という点です。
そのため、
表情だけ変える
服の色だけ変える
背景は維持したまま人物を修正する
といった操作が成立します。
PixAI / SDXL / DiTは何をしているのか
一方、PixAI・SDXL・DiT(Lumina系)で行っているのは、
新しい画像を生成する
あるいは参照付きで再生成する
という処理です。
I2I や Reference を使っても、
元画像を「理解」しているわけではない
毎回「それっぽい結果を生成し直している」
という構造は変わりません。
つまり、
編集ではなく、再生成
です。
なぜ代替にならないのか
違いを整理すると、次のようになります。
Qwen-Image-Edit
対象:既存画像
単位:意味(semantic)
変更範囲:局所
同一性:保たれやすい
SDXL / DiT / PixAI
対象:生成プロセス
単位:ノイズ・条件
変更範囲:全体に波及しやすい
同一性:壊れやすい
このため、
「この完成画像を少しだけ直したい」
という用途では、構造的に別物です。
では、今の環境は劣っているのか?
そういう話でもありません。
PixAI / SDXL / DiT 環境には、別の強みがあります。
大量生成・試行錯誤ができる
LoRA や構造参照による再現性確保
オフライン運用やコスト制御が可能
ゲーム立ち絵など量産用途と相性が良い
一方、Qwen-Image-Editは、
1枚の完成画像を壊さず修正する
商用ツール的な即戦力
「編集」が前提のワークフロー
に強いです。
「代替になっている」と言える条件
次のような運用をしている場合、
実質的に Qwen-Image-Edit を必要としていない、とは言えます。
既存画像を微修正する工程がない
毎回生成し直す前提で問題ない
同一性は LoRA や設計で担保する
1枚の完成度より、再生成可能性を重視する
ゲーム立ち絵や量産用途では、こちらのほうが合理的です。
まとめ
PixAI / SDXL / DiT 環境は
Qwen-Image-Editの代替にはなっていません。
しかし、
「画像を編集する」という発想自体を捨てているなら、
代替を探す必要のない別設計に到達している
とも言えます。
完成画像を丁寧に直したい → Qwen-Image-Edit系
再生成前提で安定した結果を出したい → PixAI / SDXL / DiT系
どちらが正しい、という話ではありません。
用途と設計思想の違いです。
ここまでで、
Qwen-Image-Edit が「編集」
PixAI / SDXL / DiT が「再生成」
という、設計思想の違いは整理できたと思います。
そして、
「再生成前提の設計でも、
ゲーム素材として“壊れない”運用はできるのか?」
という疑問に対して、
私は「できる」と判断し、実際にワークフローを組みました。
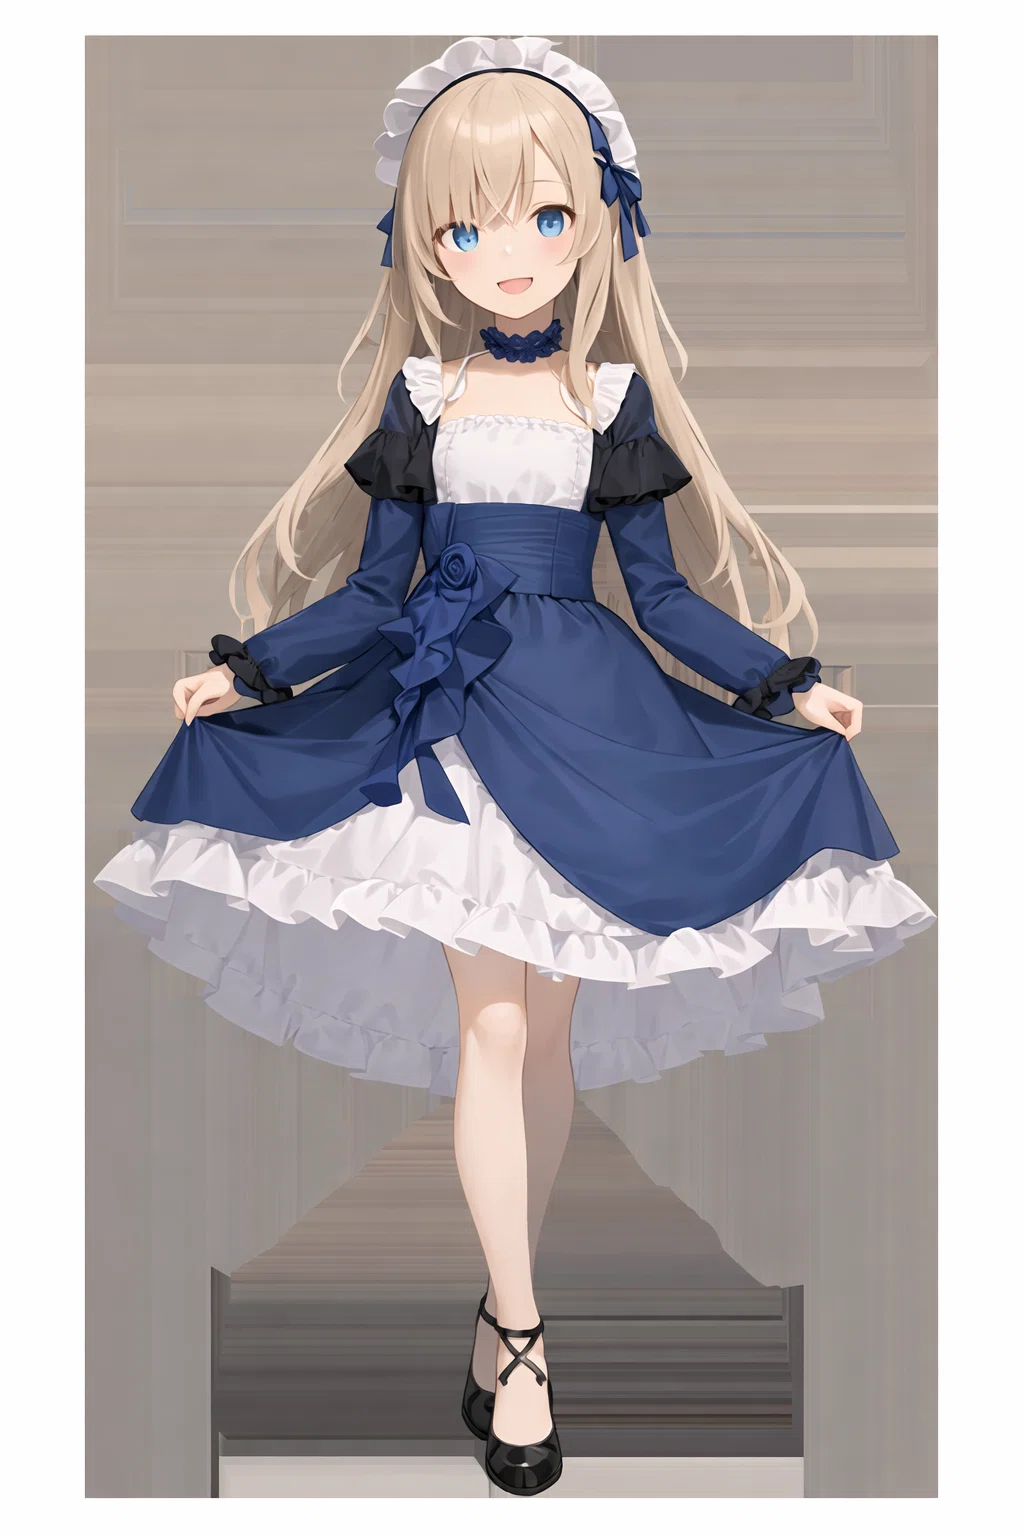
その結果が、次に出てくる4枚の画像です。
同一キャラ
同一衣装
表情差分
ポーズ差分
を、再生成ベースで安定させています。
「PixAI / SDXL / DiT 環境で、
“編集できない”ことを前提に、
どうやって“壊れない再生成”を実務化するか」
を、理論ではなく運用設計として解説します。
扱うテーマ
なぜ「再生成前提」でも同一性が保てるのか
ベース生成で何を決め切るべきか
I2Iを“修正”ではなく“品質固定”として使う考え方
Referenceを「似せる」ためでなく「壊さない」ために使う方法
表情差分・ポーズ差分を安定させる設計ルール
失敗しやすい設定パターンと回避法
扱わないこと
モデルの網羅的紹介
ただの操作マニュアル
「誰でも同じ結果になる」という幻想
この内容は、
「画像を1枚きれいに作りたい人」
ではなく、
「ゲーム・素材・キャラ運用として
“同一キャラを壊さずに量産したい人”」
向けに書いています。
どんな人に向いているか
向いている人:
ゲーム用立ち絵・カード素材・差分前提素材を作りたい
生成はできるが「同一キャラが保てない」
編集ツールより、再生成パイプラインを安定させたい
商用・実務レベルでAI画像を使いたい
向いていない人:
1枚のイラストを職人的に直したい
編集前提のワークフローが好き
絵としての完成度だけを追いたい
ここから先で分かること
「なぜこの4枚が同一キャラに見えるのか」
「どこで“似なくなる地雷”を踏みやすいのか」
「Qwen-Image-Editとは別ルートで、どう実務を成立させているか」
が、
再現可能な設計として理解できるようになります。
次に出てくる画像について
この後に載せる4枚は、
1枚の奇跡的成功例
ではなく、再生成前提でも
「このレベルまでは安定させられる」
という、運用の到達点です。
「編集できない環境で、
どこまで“編集に近いこと”ができるのか」
それを見たうえで、
「この作り方を知りたいかどうか」を
判断してもらえればと思います。
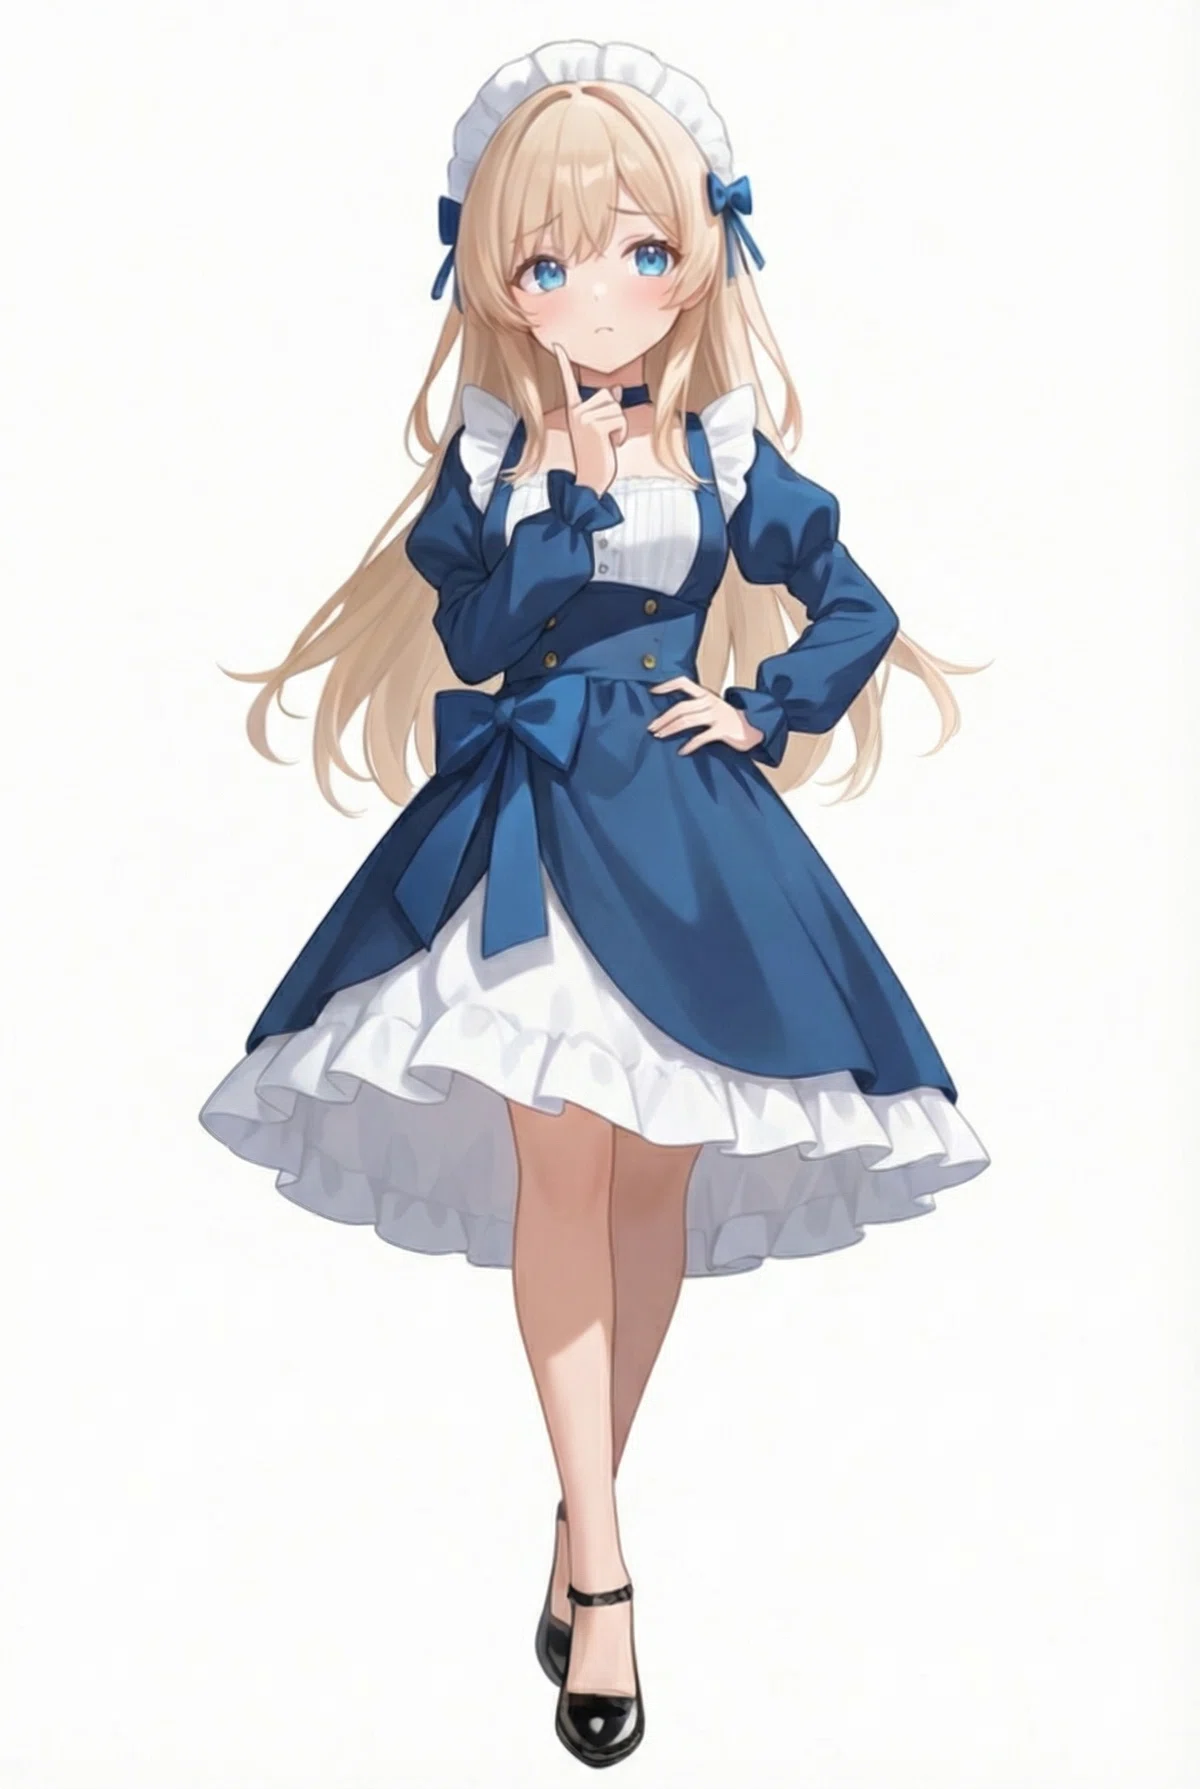
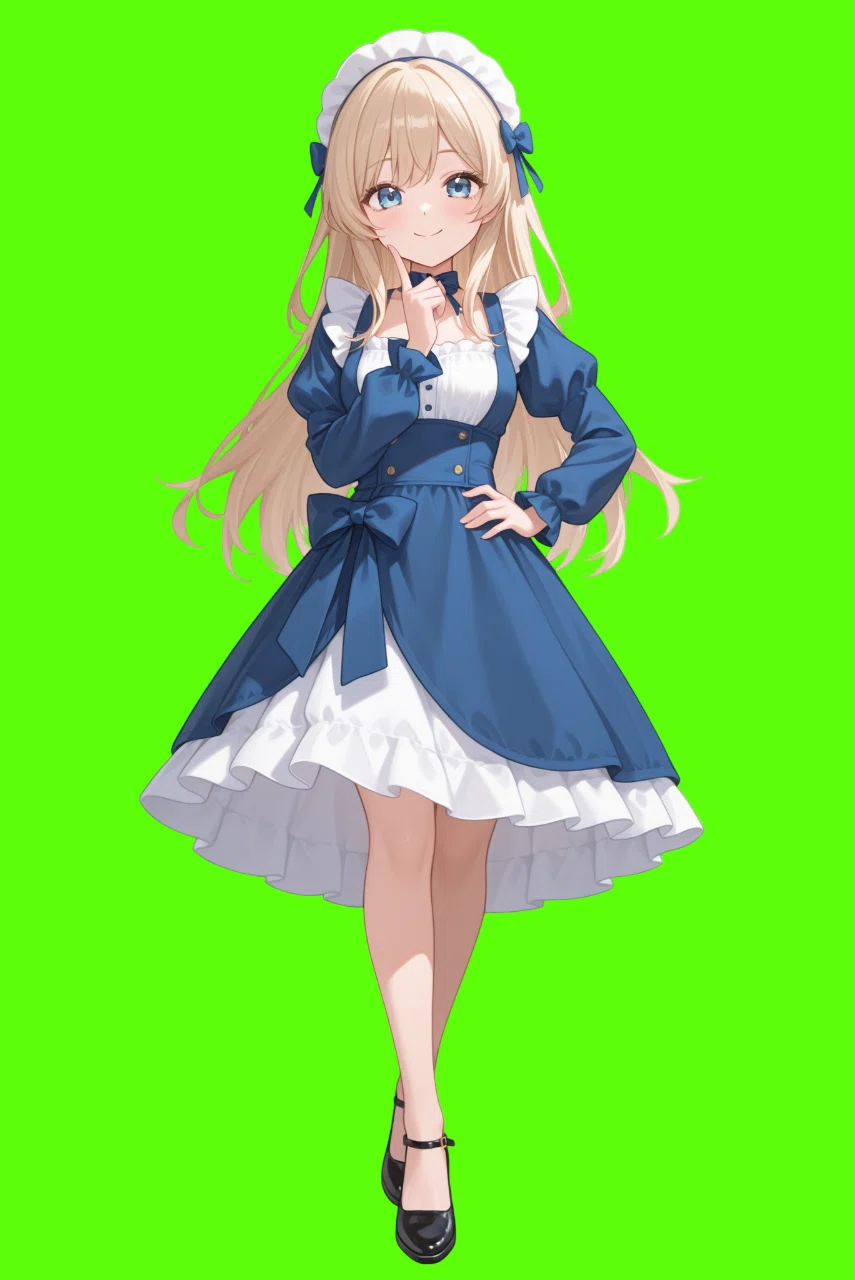
SDXLとDiTは学習データが異なるため互換性を持たせる必要がある
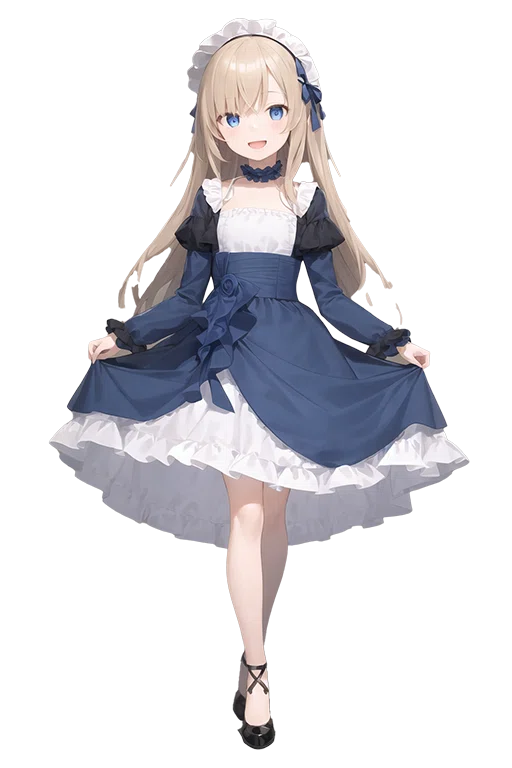
生成者:くろくま様
(1)は DALL·E 3 の I2I に用いられます。
つまり、「採用結果に近いイメージ」であれば、
内容は必ずしも厳密である必要はありません。
ただし、
生成に用いられるモデルの性質上、SDXL と DiT は異なる特性を持つため、
両者のあいだに一定の互換性を持たせる工夫が必要になります。
そこで出てくるのが DALL·E 3 です。
ここまでのワークフローを整理してみましょう。
T2I または I2I によって元の画像を用意する(1)
 ↓
元の画像が SDXL で生成されている場合であっても、
品質を統一するために DALL·E 3 で T2I / I2I を行う
 ↓
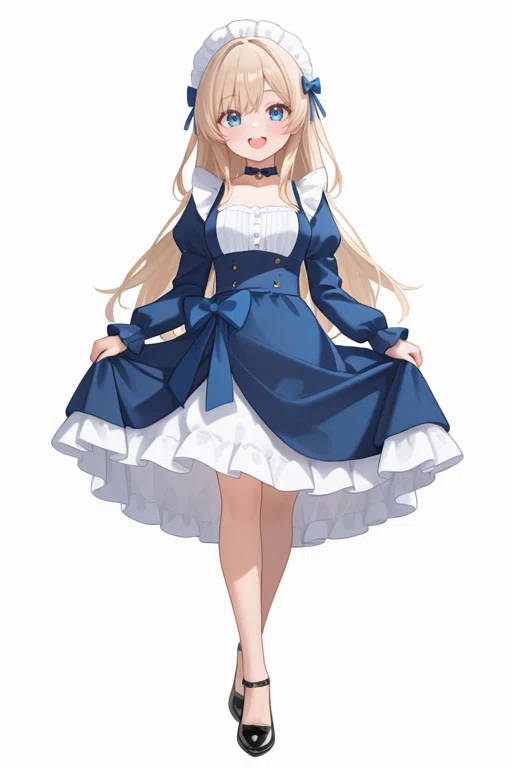
DiT に対応できる「均一化された元の画像」(2)
I2I(PixAI)
画像からプロンプトを抽出します。
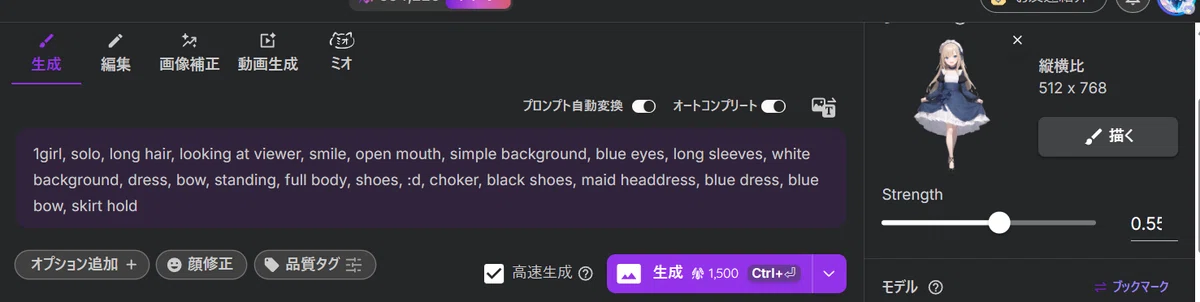
生成結果を反映し、調整したものが画面の文字列です。
1girl, solo, long hair, looking at viewer, smile, open mouth, simple background, blue eyes, long sleeves, white background, dress, bow, standing, full body, shoes, :d, choker, black shoes, maid headdress, blue dress, blue bow, skirt hold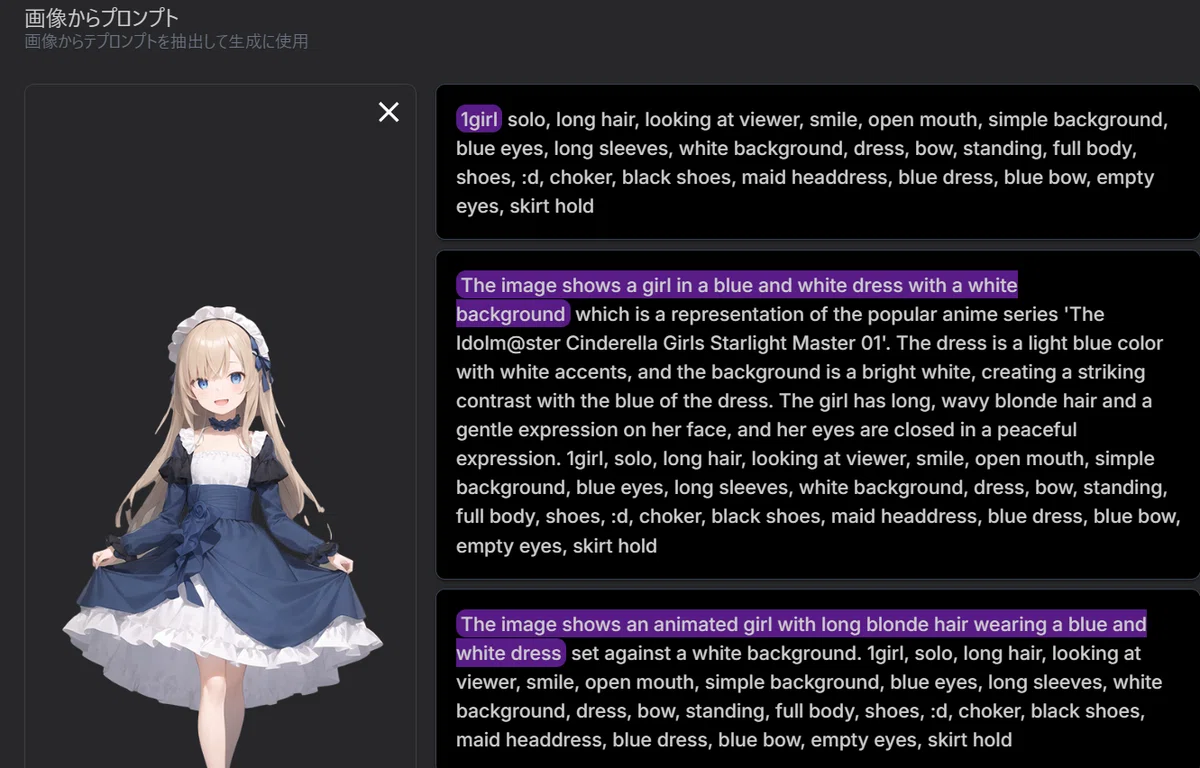
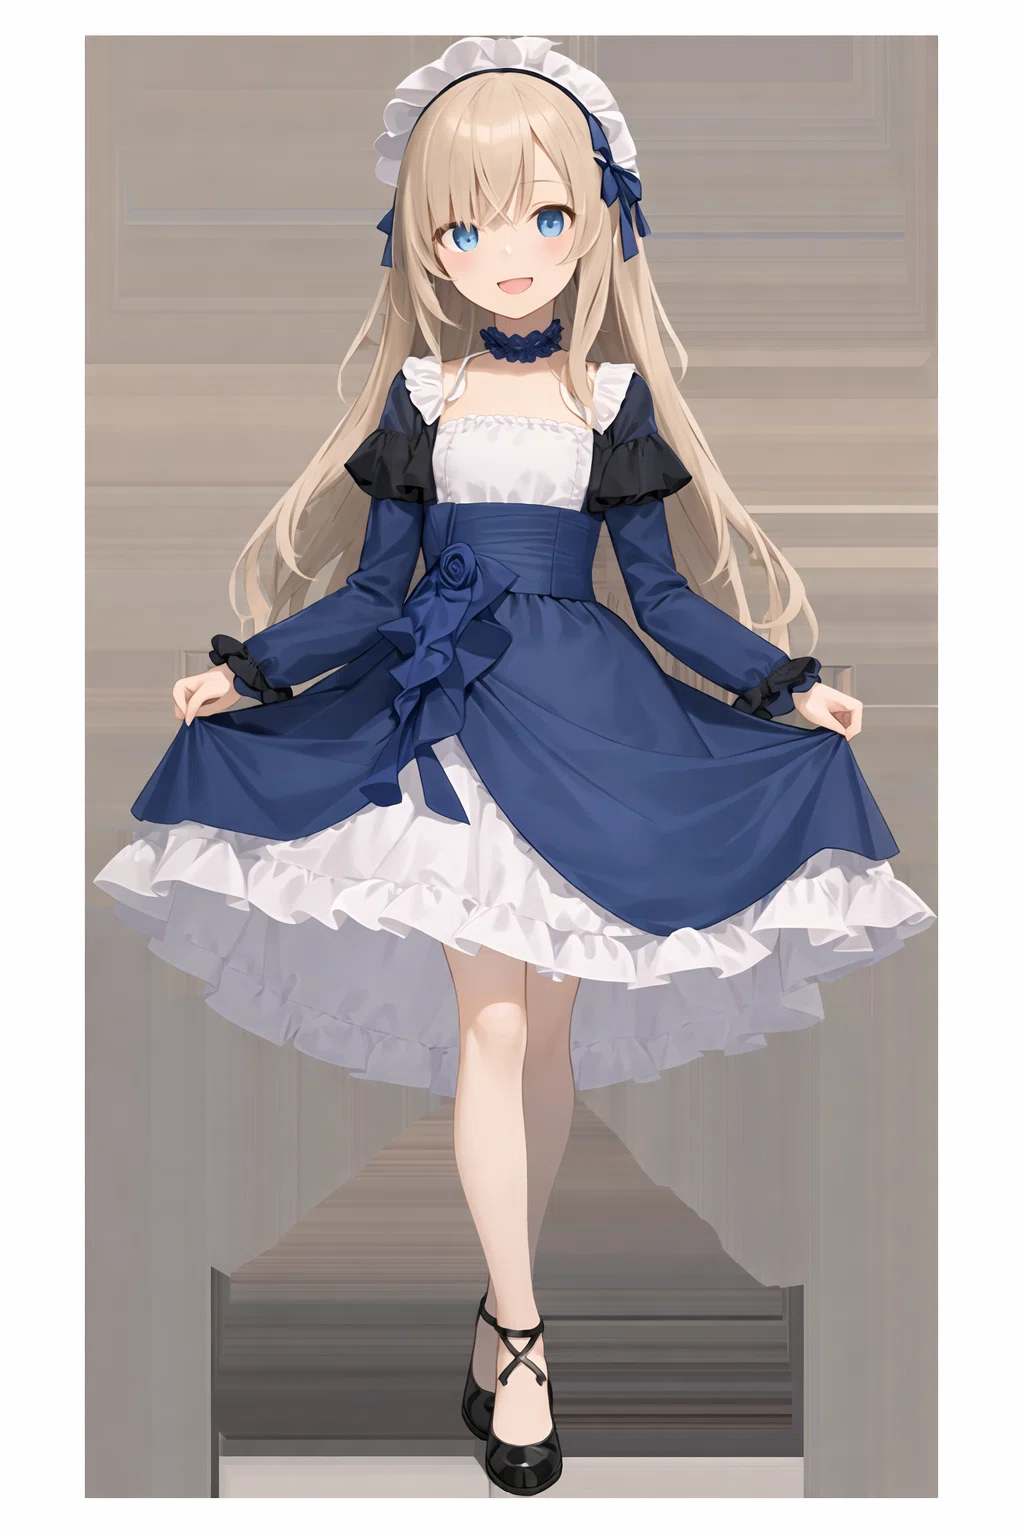
生成結果
(3)再生成した画像(採用するベース画像)
生成時には、(2)を Reference として設定します。
今回は重みを 5.5 に設定し、抽出・調整したプロンプトを適用して(3)を生成しました。
この(3)が、最終的に採用するベース画像になります。
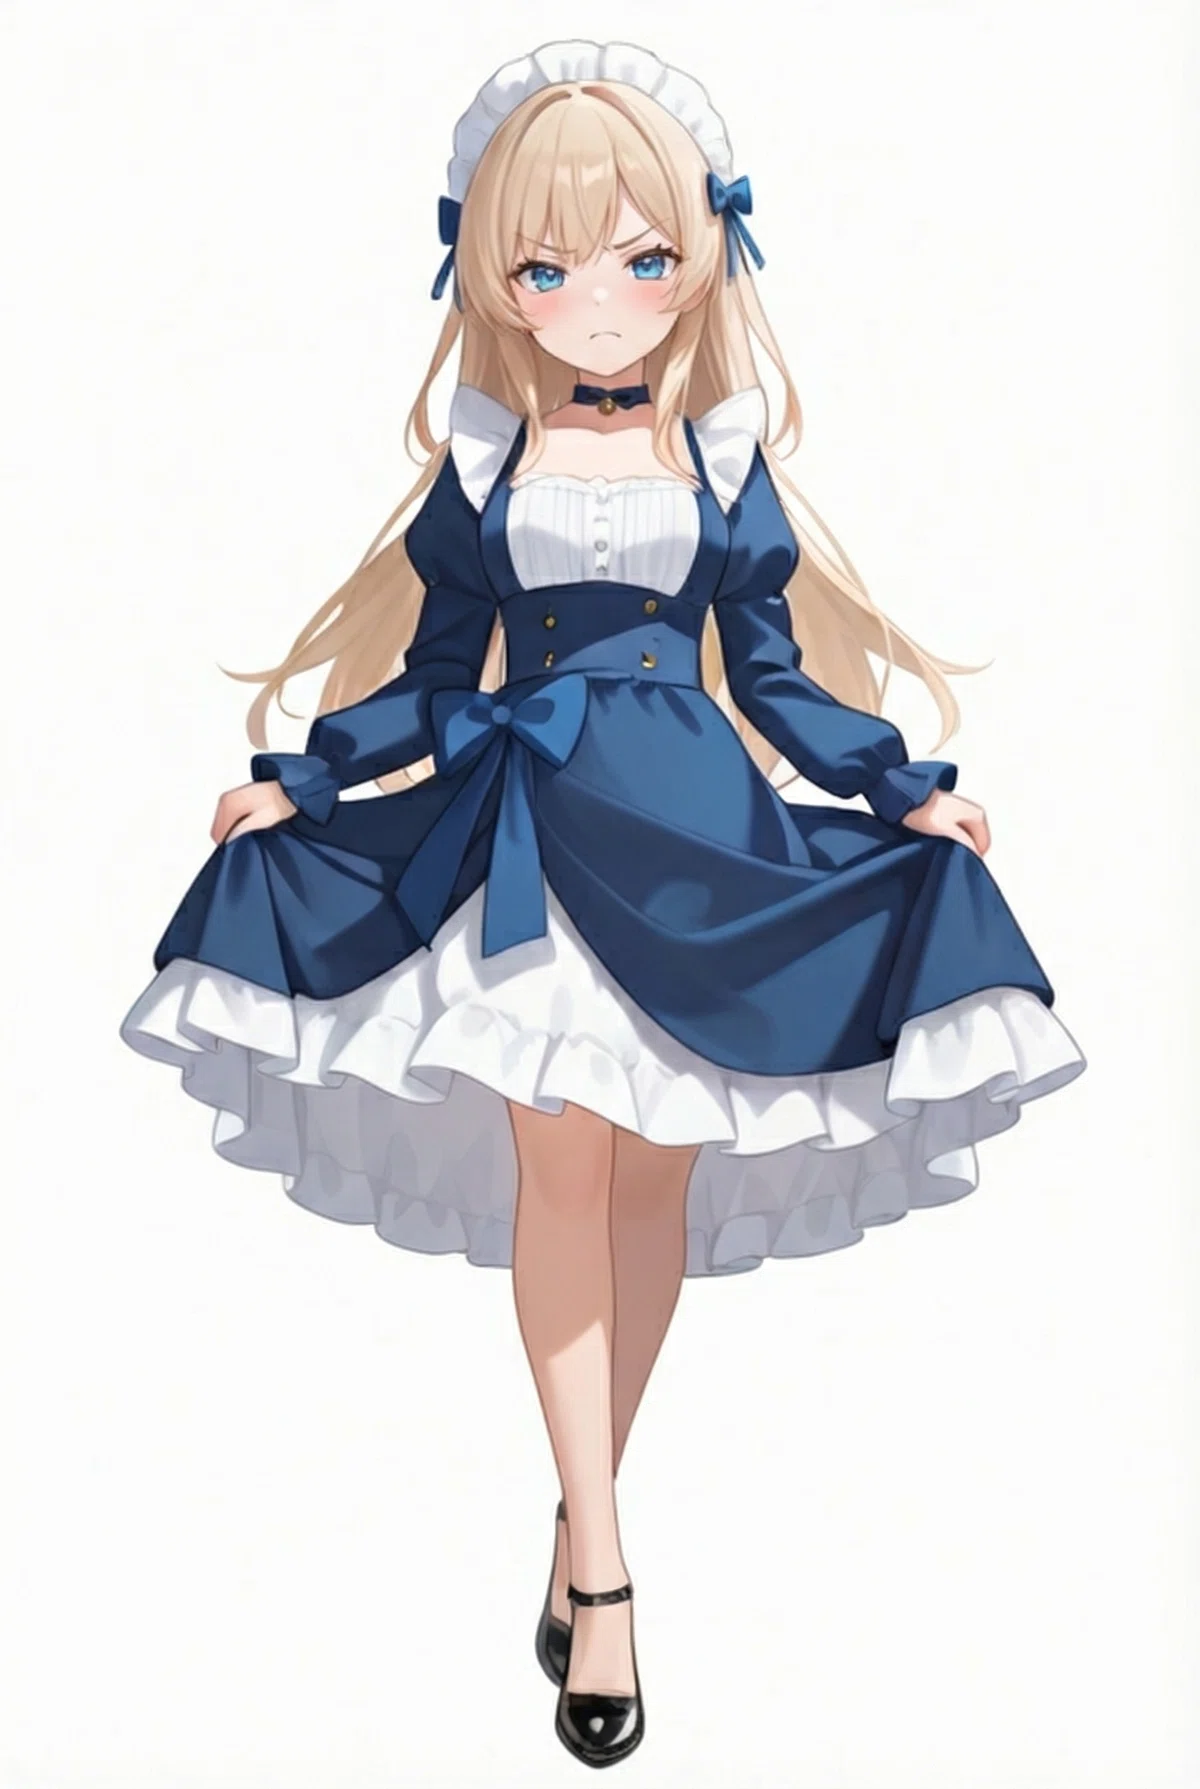
表情差分の作成
このとき、Reference には先に作成した(3)の画像を設定します。
プロンプトは、
「表情を怒った表情にしてください。そのほかは保持してください」
としました。
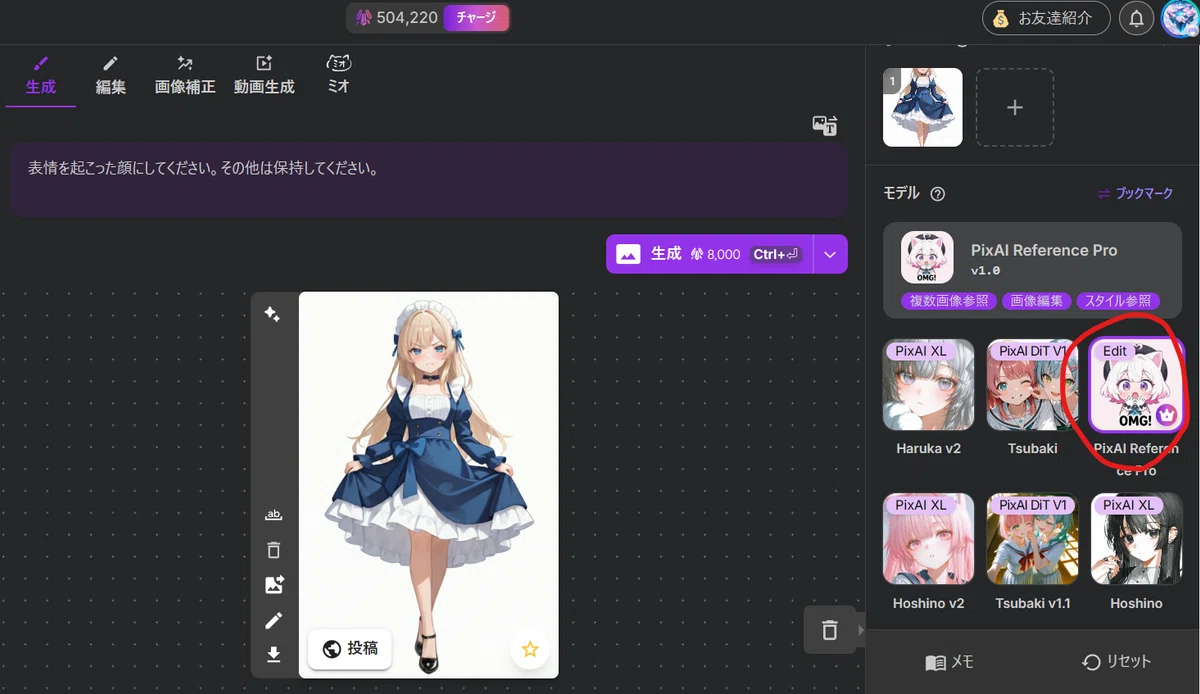
ここで重要なのは、
Reference として指定している画像は SDXL の出力(3)ですが、
その(3)はDALL·E 3 を経由して生成された画像である、という点です。
また、PixAI Reference Pro はブラックボックスであり、
内部でどのような処理が行われているのかは公開されていません。
その対策として互換性を持たせるため、
DALL·E 3 を経由した画像を Reference として使用する、
という構成を取っています。
では、内部で行われている処理は何か。
処理結果の挙動から推測すると、
DiT 系のアプローチである可能性が高いと考えられます。
ポーズ差分
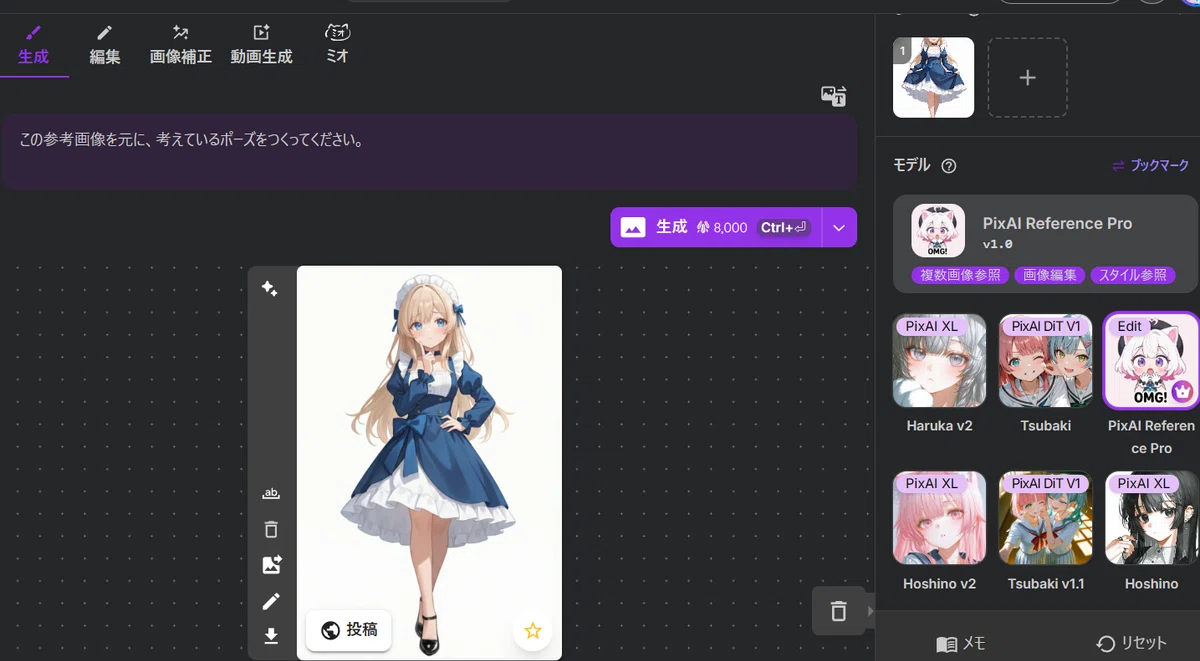
Hires.fix
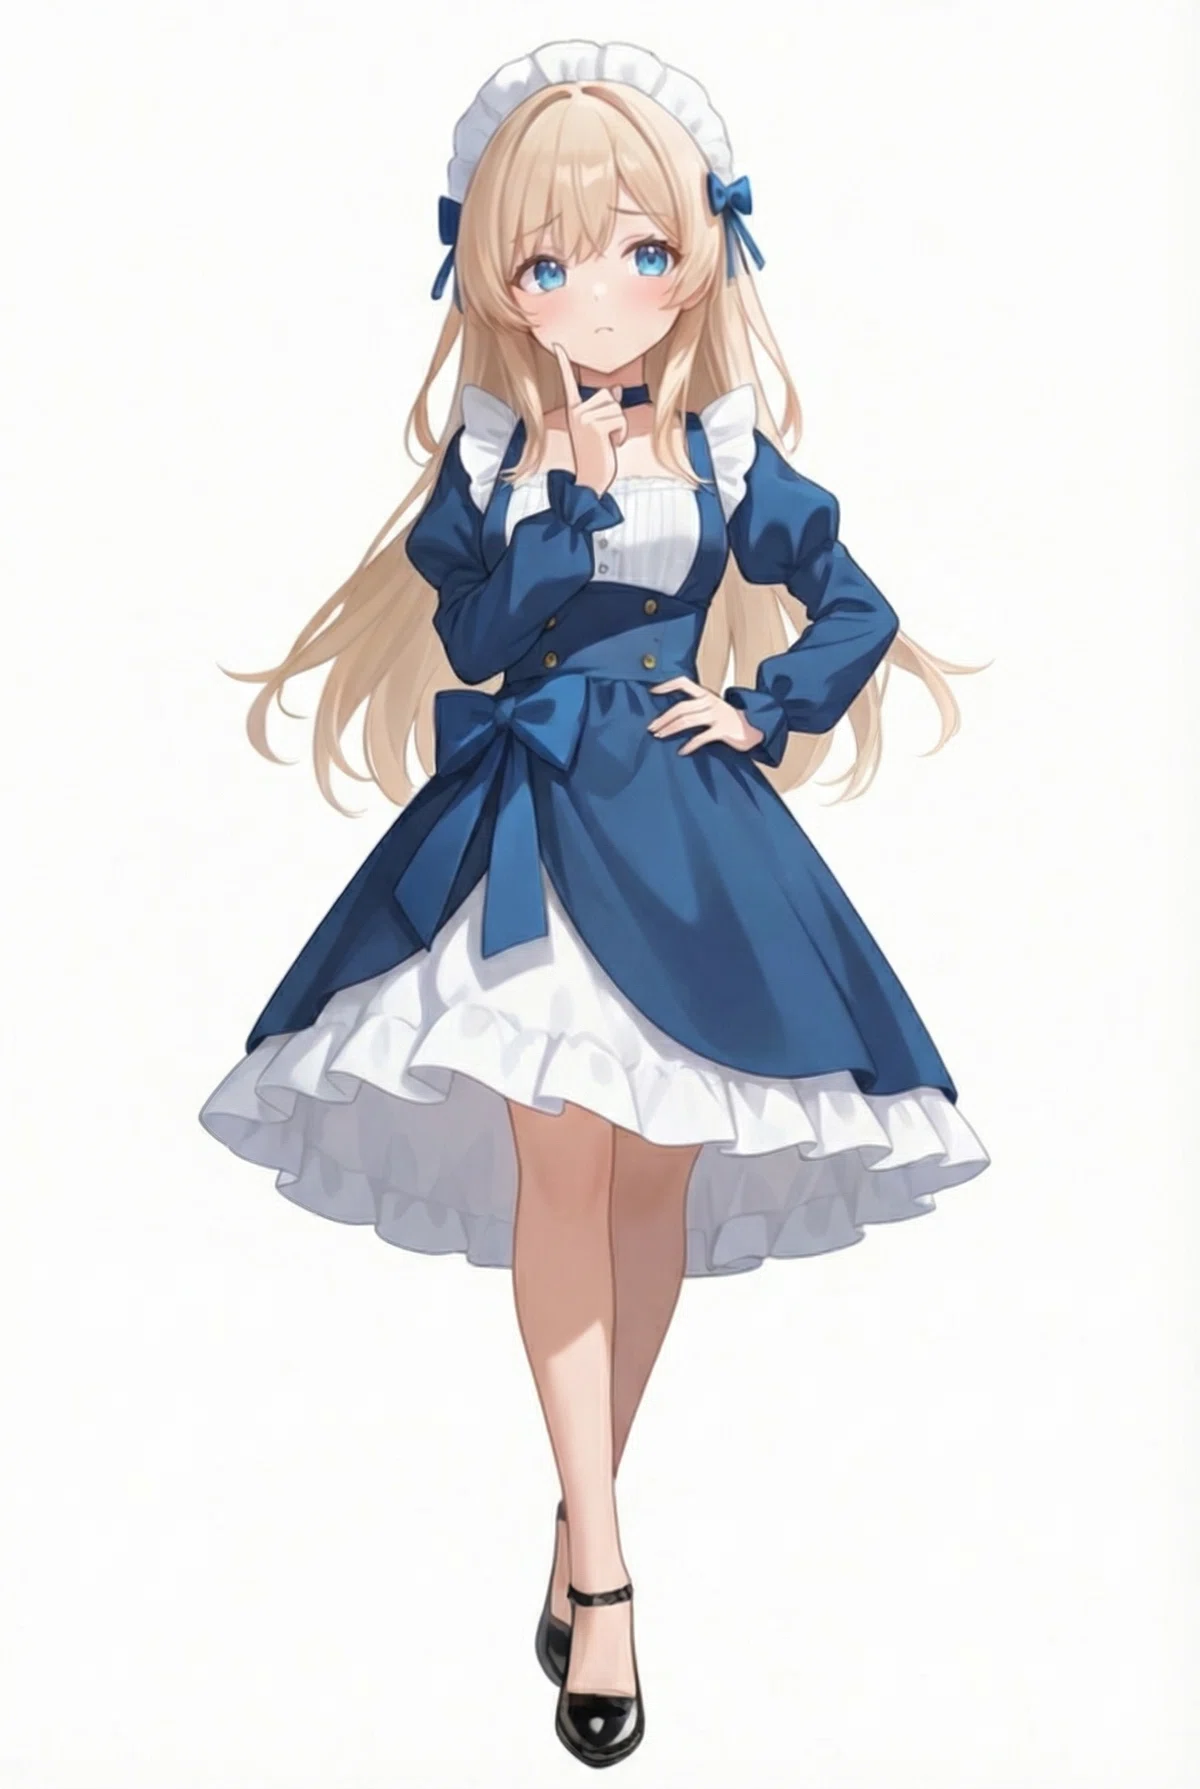
(5)からプロンプトを抽出します
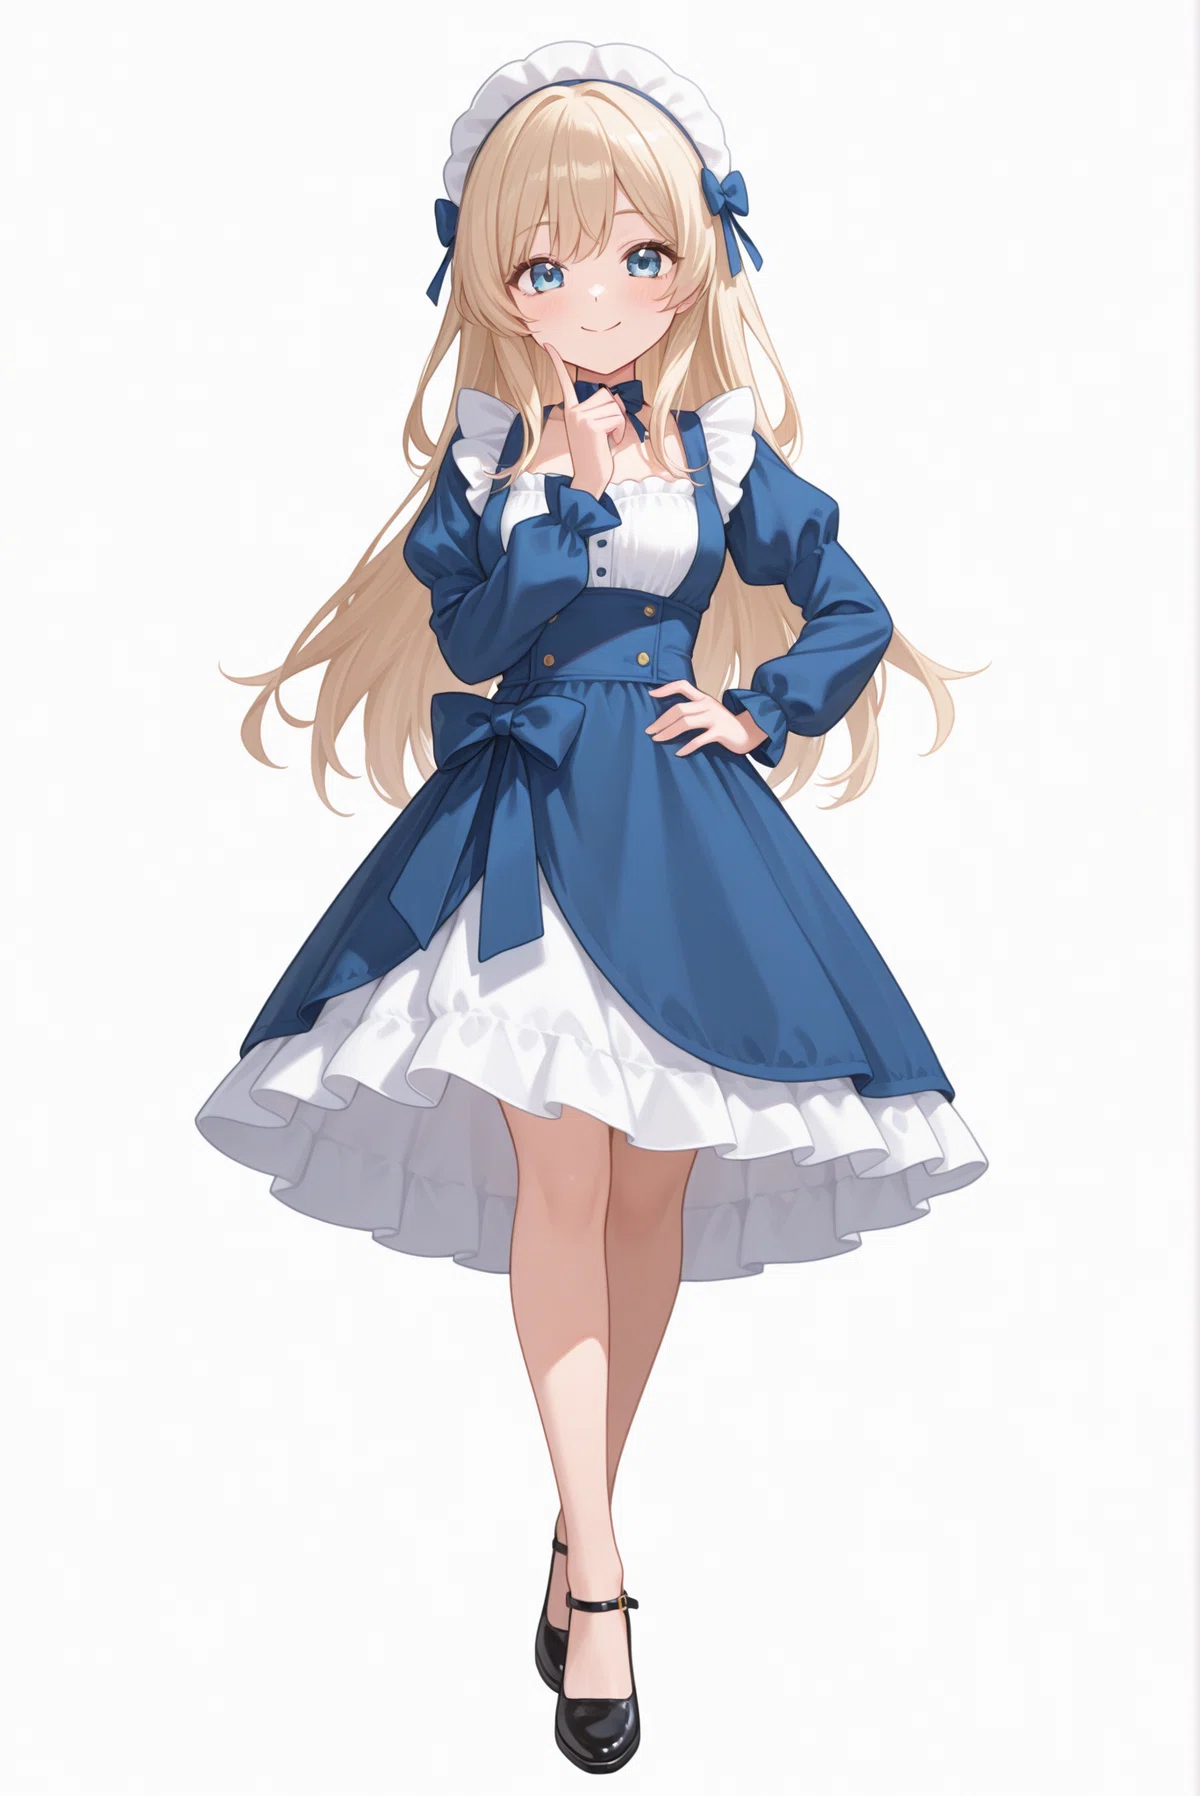
いわゆる「Hires.fix」です。
下記プロンプトが適用され、先程のReferenceを設定し実行します。
これがPixAIにおけるHires.fixにあたります。
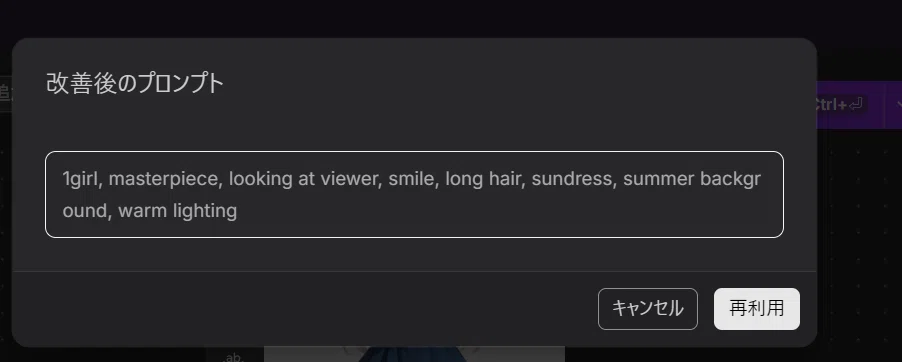
1girl, masterpiece, looking at viewer, smile, long hair, sundress, summer background, warm lighting仕上げ
最後に背景透過処理を行い、完成です。
AAAタイトルには及ばないものの、インディータイトルであれば十分に運用に耐えうる品質の誤差に収まったと考えています。
また、インディー開発では開発費の圧縮が重要になりますが、Qwen-Image-Editの運用コストは、体力的にも精神的にも負担が大きくなりがちです。
その代替手段として、この手法はローカル環境への依存が少なく、難しい操作も必要としないため、現実的で有効な選択肢だと言えるでしょう。
