
LoRAは誰のための技術か ──kohya_ssと個人制作の現実

現在でも、LoRA といえば kohya_ss が事実上のスタンダードです。
ただし、これは「誰にとってのスタンダードか」を分けて考える必要があります。
結論から言えば、kohya_ss は個人向けのツールではありません。
本来は 3〜5人規模の開発・研究チームで運用されることを前提としたフレームワークです。
環境構築、依存関係の管理、GPU・CUDA の整合などを分担できる体制があって、はじめて安定運用が成立します。
これを個人が RunPod などのクラウド GPU 環境で行おうとすると、
環境調整や試行錯誤に多くの時間とコストがかかり、
現実的な選択肢とは言いにくくなります。
そこで登場したのが、LoRA Training SaaS(学習工程を外部に委ねるサービス)です。
ブラウザ操作だけで LoRA を作成・取得できる点は非常に便利ですが、
一方で 利用規約や権利関係が曖昧な場合も多く、
使用にあたっては十分な注意が必要です。
今回の記事は「実際のLoRA作成における過程メモ」です。
これをすれば正解はありません。
1,プロンプト編集&生成(6h)
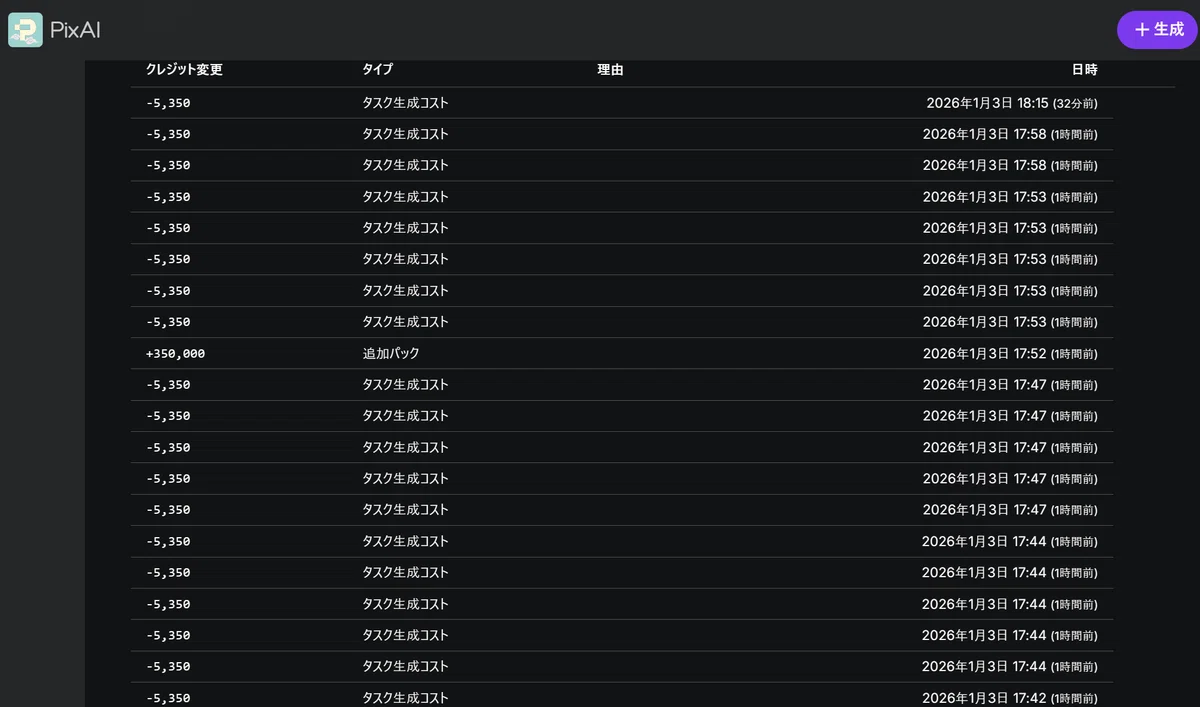
1枚10円ぐらいになるはずなので、生成費用は2000円ほど。
ローカルは1枚0.3円ぐらいのはずなので生成費用は60円になると仮定。
LoRAのデータセット作成において差額1940円は重たい。
データセット
データセットは視認で200枚ほど検品。
4枚はnude。
ほかは揺らぎを持たせながら同一ポーズで固定。
ControlNetを使ったり、使わなかったりして作成
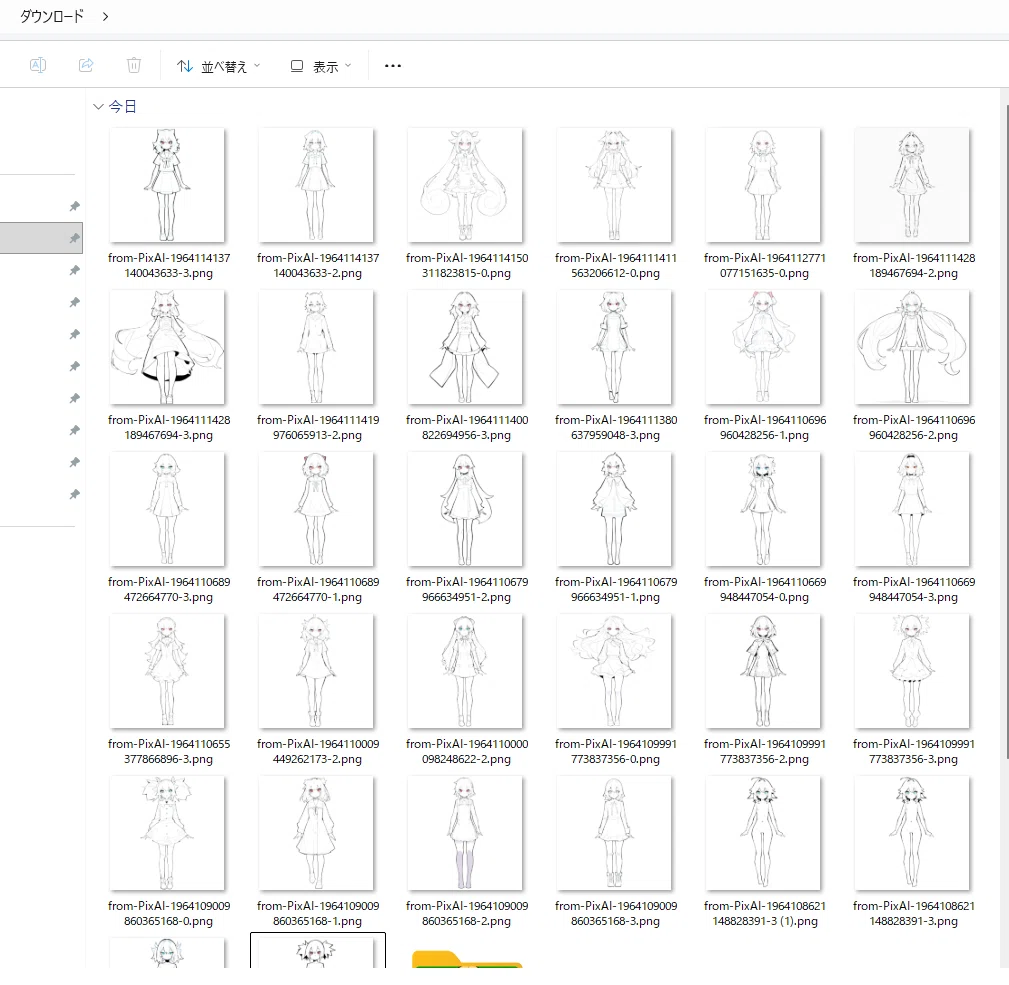
(見切れていますが4枚ほどnudeを採用)


2,SDXL(B)をモデルにしてLoRAを作成(30min)
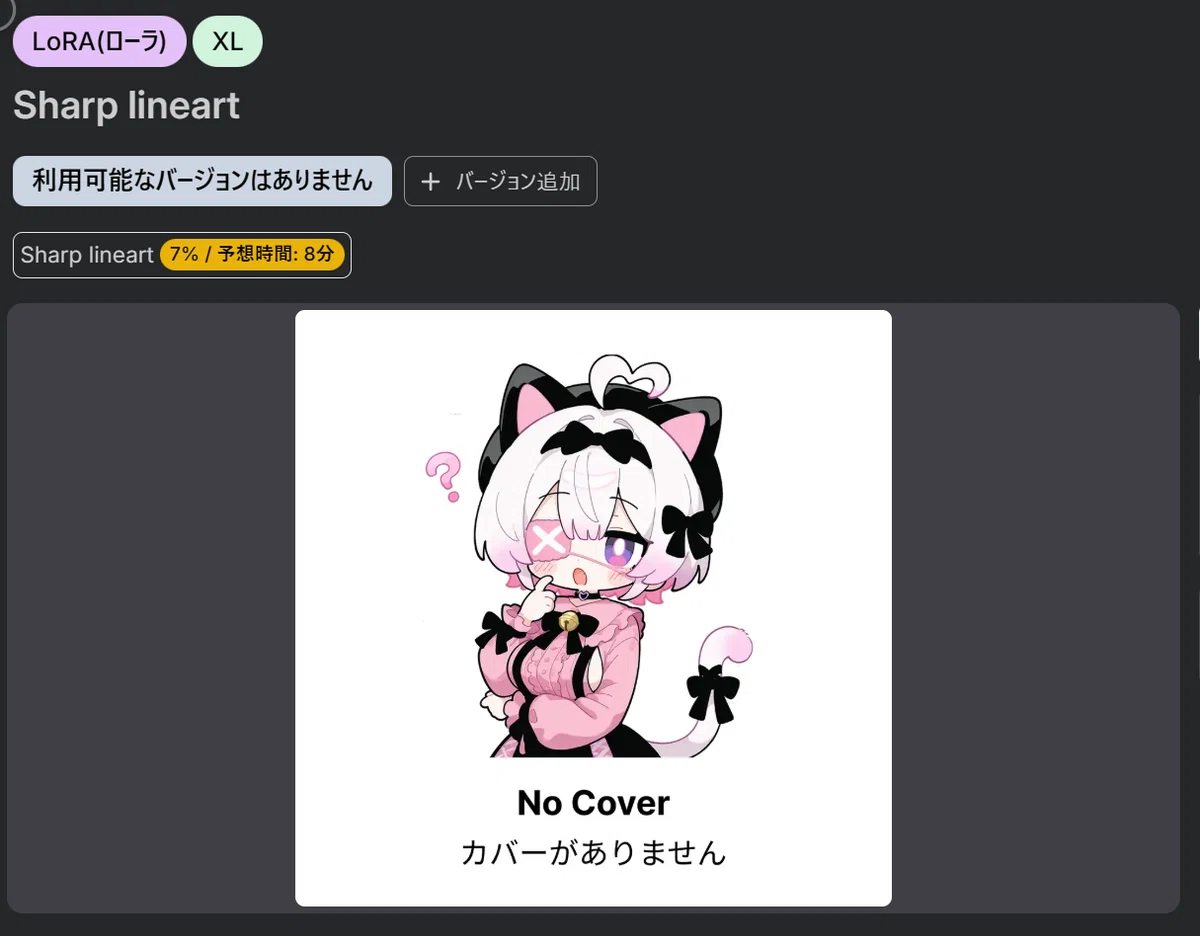
ローカルだとRunpodで300円ほどになるはず。
設定の手間を考えると手軽だが細かい設定を作れないのは△
3,SDXL(B)+作ったLoRAからSDXL(C)のためにLoRA用のデータセットを作成する(予定)
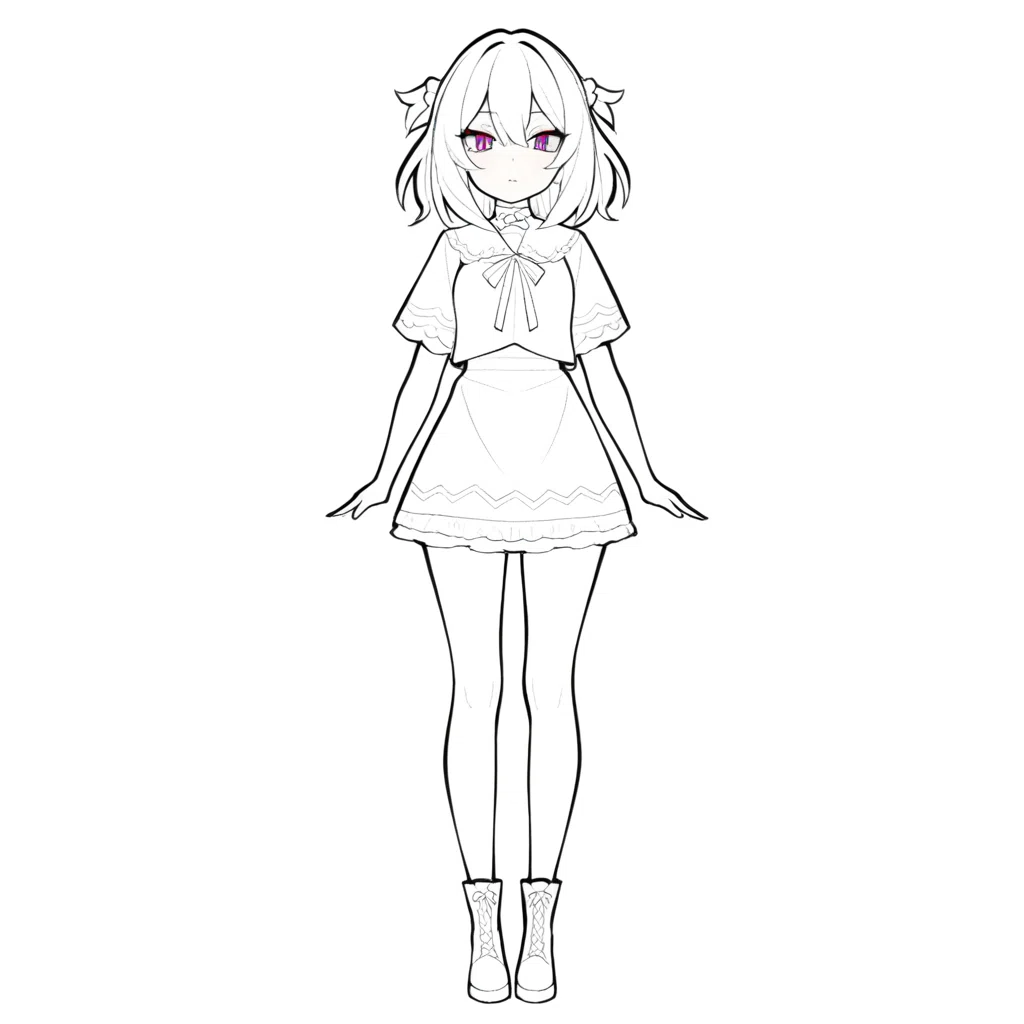
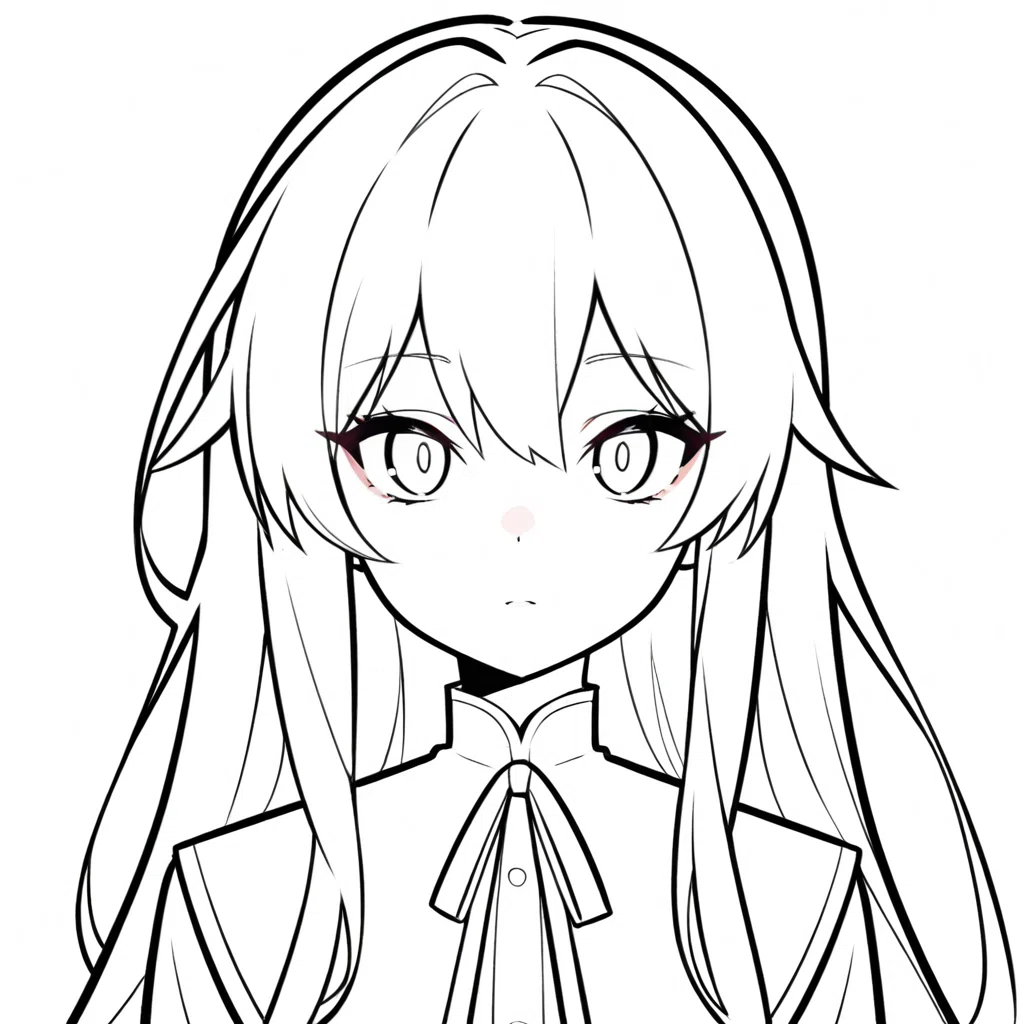
//予定でしたが全没
Illustrious v2.0 用データセット 30枚
├─ 15枚:あなたが今回選別した LoRA出力
├─ 10枚:LoRAを使わない / 弱めた出力
└─ 5枚:意図的に少し崩した構図(頭身は維持)
//予定でしたが全没
full body
standing
front view
centered composition
game character sprite学習設定の目安(SDXL / Illustrious)※全没
安全設定(立ち絵向け)※全没
LR:低め(Illustriousを壊さない)Epoch:少なめ(過学習防止)Resolution:立ち絵実寸に近づけるかも? 1024x1024px固定
次回はIllustrious v2.0 用データセット 30枚を用意してRunpodで仮LoRAを試してみる。ただ使うのはIllustrious v2.0が予定なので不安しかない。
DiTも訓練候補だったのですが、今回はゲームの立ち絵を作る用のモデルを作りたいと思ったためSDXLを採用することにしました。
凍結判断(2026-01-04)
Runpodにて実施を試みましたが、回線が途切れたり、アップロードが遅すぎたり、Pythonの構築が上手く行かなかったりと散々でした。
理由
精神的負荷が過大
改善・再試行に長時間を要し、他作業を阻害するため
残高は自作ゲームのCPU試行やAPIに流用予定
→合計で1万円+12時間をロスト
PixAIにてデータセットの作成
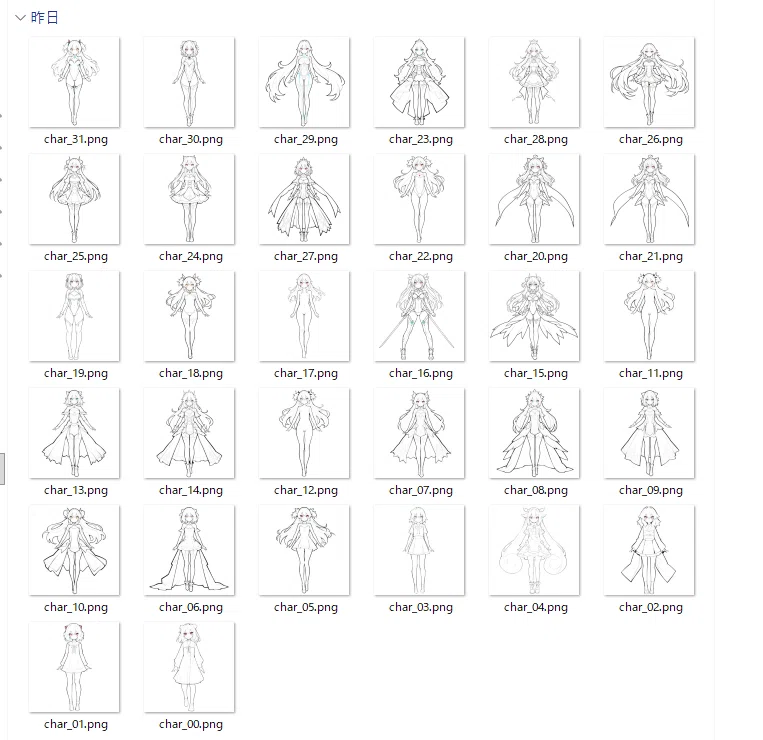
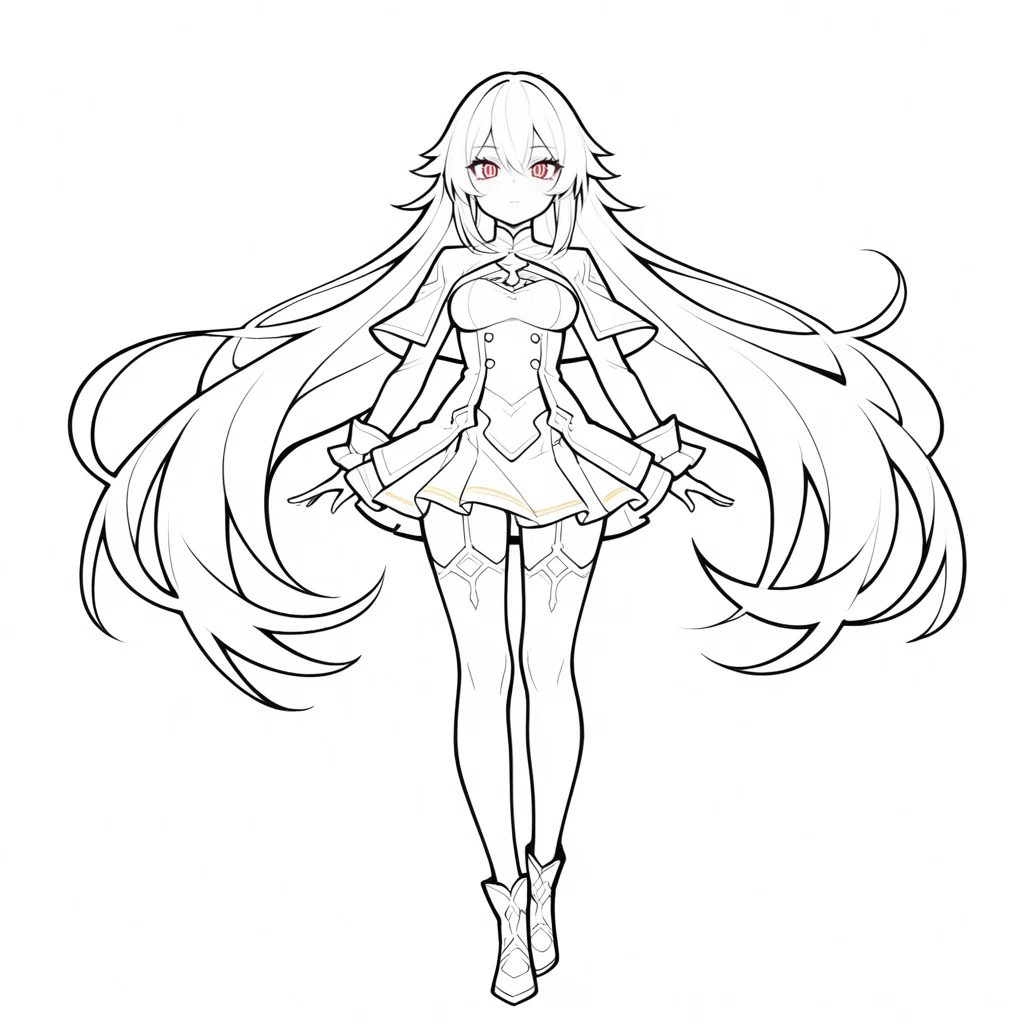
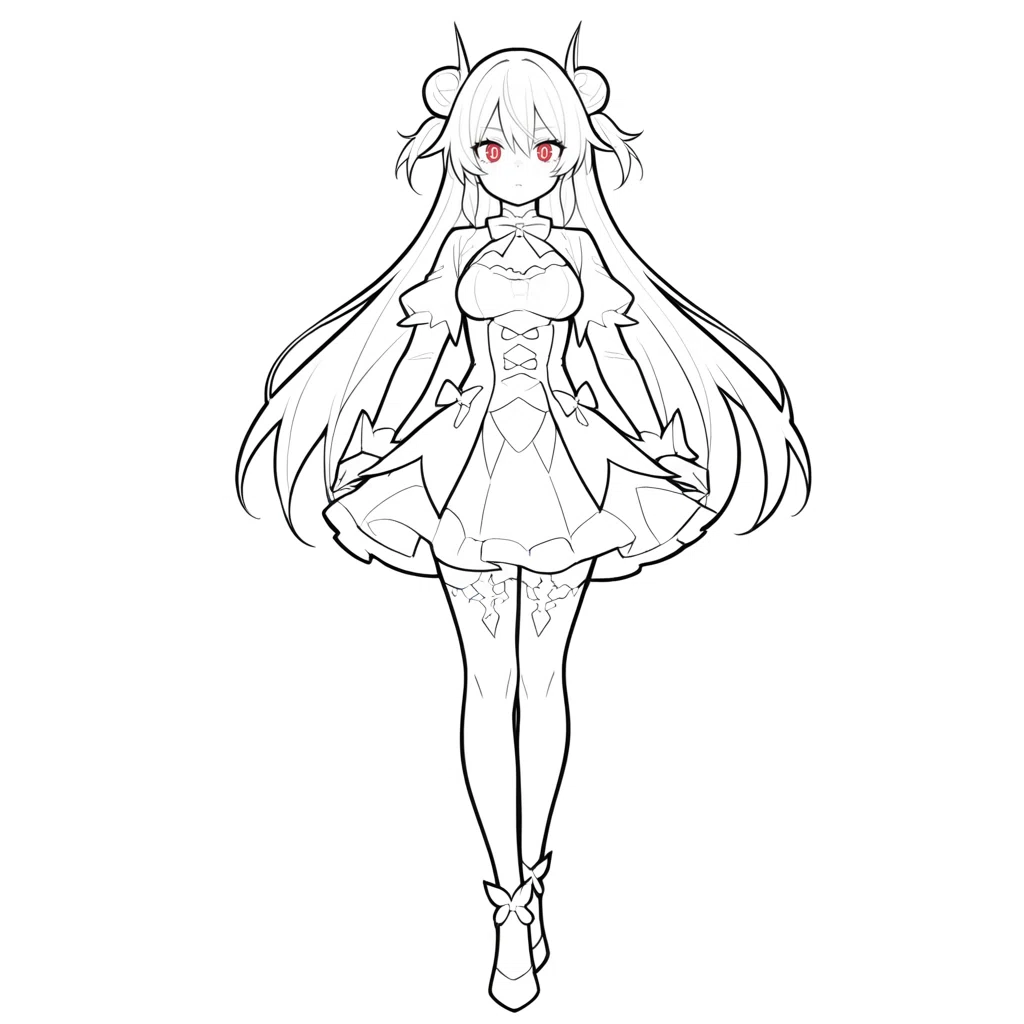

SaaSで再学習開始(専門用語→段階的 LoRA 再学習)
この工程は、モデルの能力そのものを蒸留する手法ではありません。
モデルの出力傾向を一度「現実(Dataset)」として切り出し、それを再び学習に用いることで、モデルの「振る舞い」を固定するための方法です。
一般に蒸留とは、教師モデルと生徒モデルを用意し、生徒モデルが教師モデルと同じ振る舞いをするように方向付ける学習手法を指します。本工程はそれとは異なり、教師モデルの内部挙動を直接学習するものではありません。
この手法を採用する理由は、LoRA Training SaaS では内部処理がブラックボックスであるためです。学習過程や損失の詳細を確認できない以上、成果物において「狙った方向性が視認できるかどうか」が重要になります。
たとえば今回の LoRA では、「アウトラインがくっきり出る」という特徴が明確な指標になります。このように、方向性が視覚的に確認できる状態であれば、LoRA 学習は意図したとおりに機能している(可能性が高い)と判断できます。
SD1.5を模索(半日費やした検証)
学習するためのスペックはローカルで賄える→◯
許容トークン数があまりにも少ない→✗
精度が甘すぎて使えない→✗
今回はここまでにします。
実作業時間としては、合計で およそ18時間(2日間) ほど格闘していました。
机上では成立しそうに見えるものでも、実際には OOM が発生したり、
思うように進まない場面も多く、
LoRA 周りの運用は相変わらず大変だと改めて実感しました。
