
BPaaS AI Agent開発 「Agentic Workflow」「AI Workflow プラットフォーム」

kubellにて、AIエージェントを用いたBPaaSサービスの開発に取り組んでいる藤井です。現在は経理領域をメインにBPaaS化に取り組んでいます。
TL;DR
結論:
・BPaaSの量産フェーズでは、完全自律より Agentic Workflow(枠組み固定 + 中で自律) が安定運用しやすい
理由:
・入力を制限できないBPaaSでは、Input/Routing/Validationの設計が品質を左右する
本記事で得られるもの:
・量産可能なAIワークフローの4要素分解と、5段階の進化ステップ
【本記事の想定読者】
AI機能をプロダクトに組み込み、単発の実装から「量産フェーズ」へ移行しようとしているPdM・エンジニア。
「1つの万能エージェントを作ろうとして精度や保守に苦戦している」
「似たようなワークフローが増えてきて管理が限界」
「Agentic Workflowという言葉を聞くが、実務でどう使うべきか知りたい」
こうした課題に対し、「確実性を担保しながら自律性を取り入れる」ための具体的な設計と進化のプロセスを共有します。
本記事は、「BPaaS時代に必要な新職種『AIオペレーションマネージャー』とは」の解像度が段階的に高まっていく具体的な流れを解説したものです。
本記事で解説するアーキテクチャの全体像
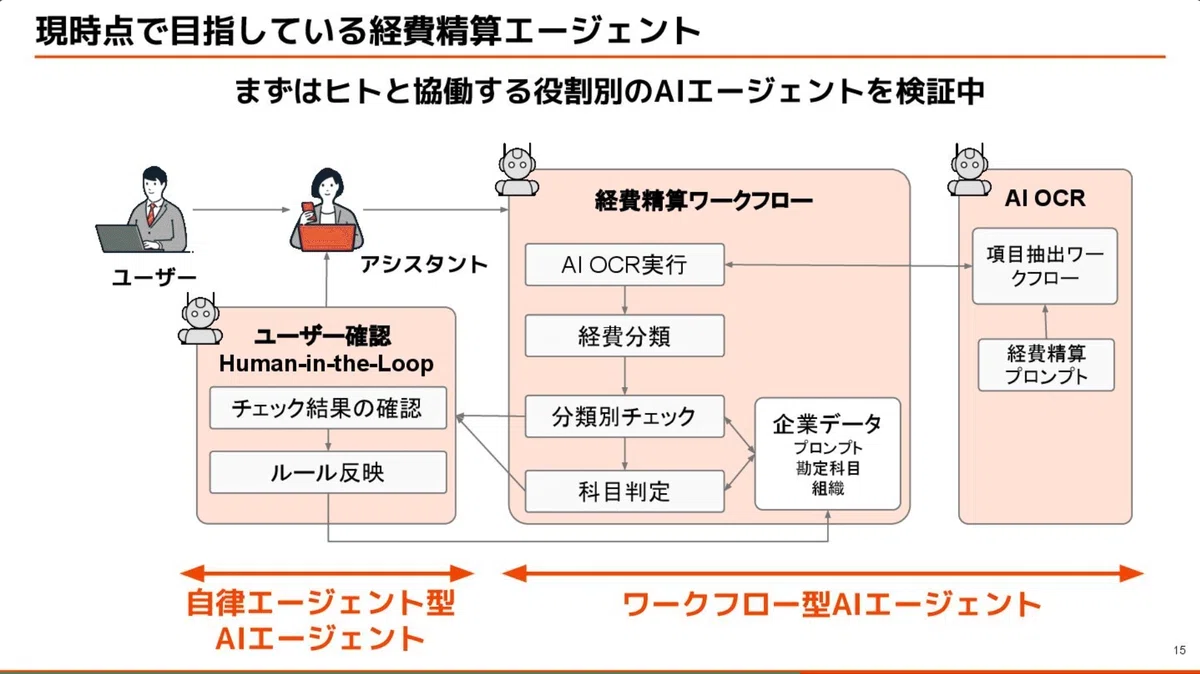
上図は、現在取り組んでいるアーキテクチャです。ユーザーと対話するアシスタントを前提に、ワークフロー型AIエージェントと自律型AIエージェントが協働する構成になっています。本記事では、この全体像に至るまでの設計思想と進化プロセスを解説します。
【本記事での用語定義】
本記事では、Anthropicの分類を参考に、実務上の使い分けを明確にするため3つのレベルに分けて定義します。
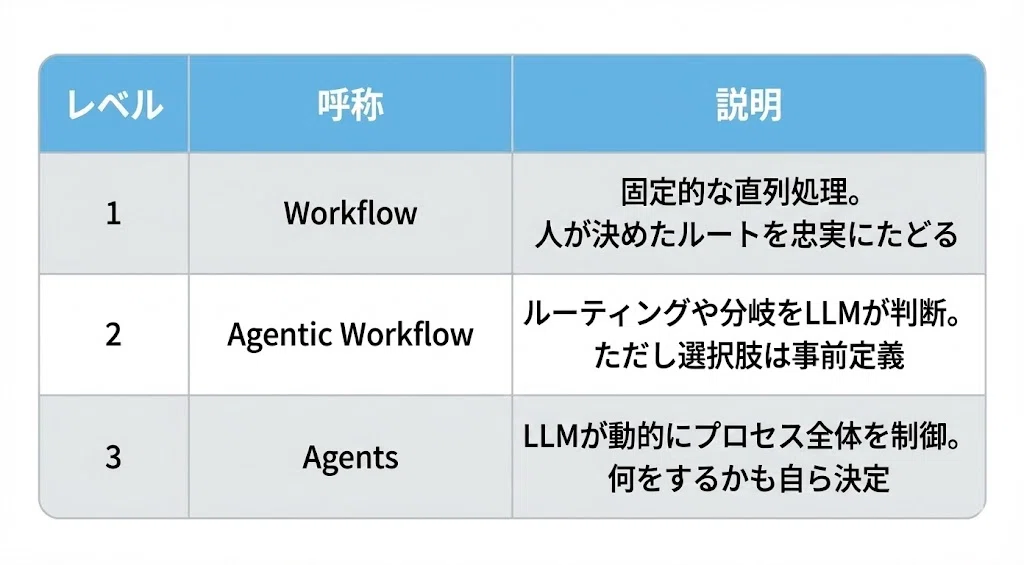
本記事で主に扱うのは「Agentic Workflow」です。Agentsのように何でもできるわけではなく、事前定義された枠組みの中でLLMが自律的に判断を行うという特徴を持ちます。
BPaaSの泥臭さと、量産フェーズの現実
最初の1本を作るのは難しくありません。「まず動かす」でいいなら、請求書を読み取って、LLMで仕訳を生成して、確認画面を出すだけです。
しかし、BPaaSとして事業を拡大しようとすると、すぐに「量産の壁」に直面します。
経理業務と一口に言っても、扱うインプットは請求書、領収書、通帳、給与明細と多岐にわたり、さらに顧客ごとに処理パターンが異なるといった固有ルールが無数に存在するからです。
通常のAIエージェント開発では、1つずつ個別に作り込むことも多いでしょう。
しかし、確実性が求められるバックオフィス業務において、類似したドメインを扱う場合、「似たWorkflowのレーンを量産し、枝葉の差異だけをコンテキストで吸収する」というアプローチが必要になります。
これらに対応するためにAI Workflowを2本目、3本目と作ろうとしたとき、以下のような課題が見えてきます。
「前処理のコード、また似たようなのを書いている」
「プロンプトのバージョン管理が複雑になりそう」
「例外分岐が増えすぎて、保守できる気がしない」
なぜ、量産が必要になってしまうのか。
それは、BPaaSが「入力を制限できない(例外にできない)」という特性を持っているため、一つひとつのワークフローが重厚になりがちだからです。
SaaSであれば、入力フォーマットを限定して「対応していない形式です」と例外扱いにもできます。
しかし、BPaaSは違います。顧客の業務を「まるごと引き受ける」以上、汚いスキャンデータも、手書きのメモも、例外的なフォーマットも、すべて飲み込む覚悟が必要です。これが開発難易度を跳ね上げます。
その結果、「Input(前処理)」や「Validation(検査)」のロジックが必然的に肥大化します。これをワークフローごとに都度実装していては、開発コストも保守コストも指数関数的に増えてしまいます。
つまり、「多様な入力に耐えうる堅牢さ」と「多品種展開できる生産性」を両立させるアーキテクチャが必要不可欠になるのです。
私が取り組んできたのは、まさにこの課題に対する試行錯誤と段階的な進化のプロセスです。最初から完成形が見えていたわけではありません。すべてを一つの万能LLMに任せるのではなく、直面する課題に合わせてシステムを拡張・進化させてきました。
本記事では、その具体的な設計と進化のプロセスを整理します。
業務実行AIワークフローの4つの構成要素
量産しているAIワークフローは、大きく4つのブロックで構成されています。
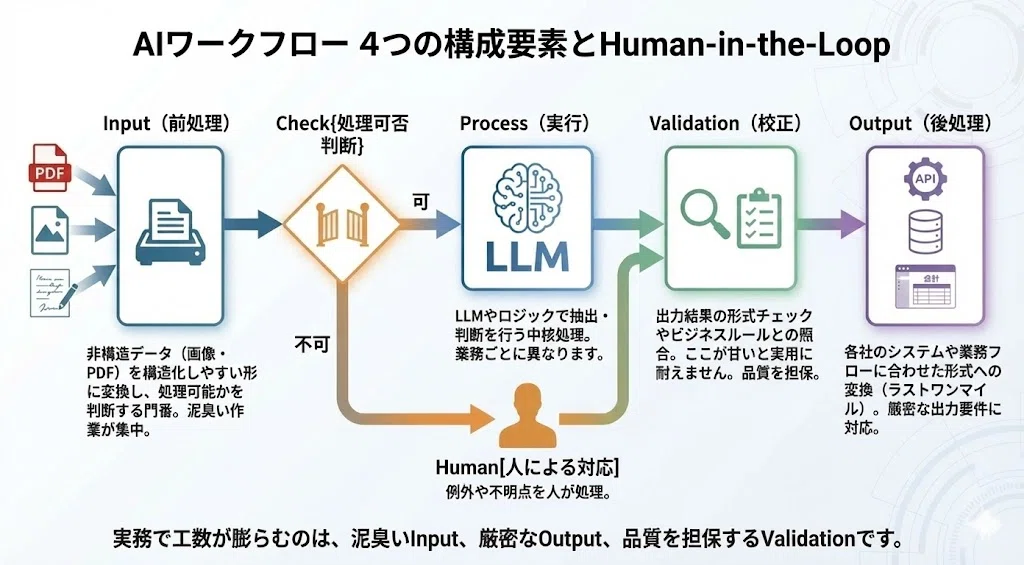
多くのフレームワークは「Process」の共通化に注力していますが、実務で工数が膨らむのは、多様な「Input」処理と厳密な「Output」、そして品質を担保する「Validation」です。
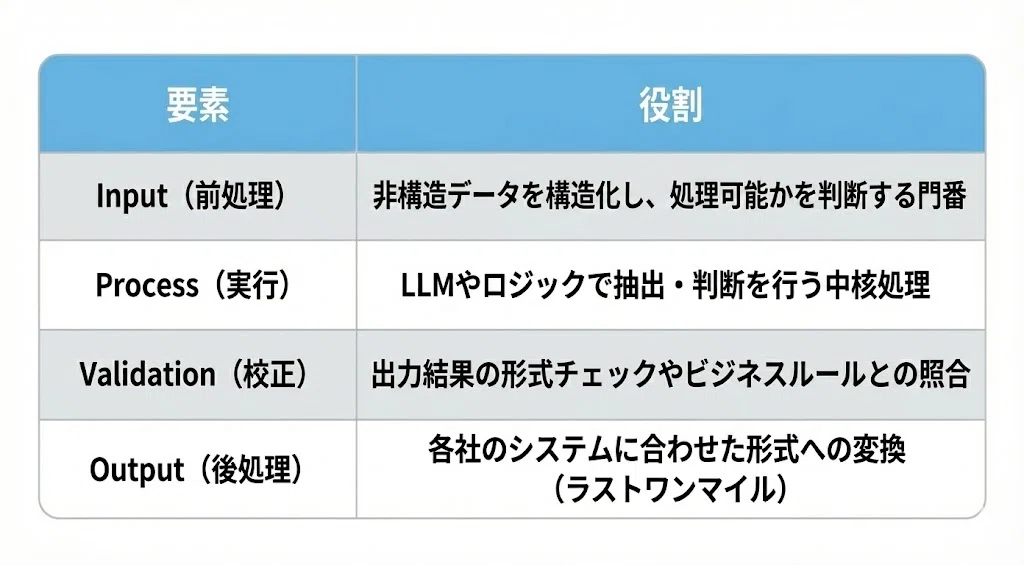
この4要素を最初から完璧に作り込むのは不可能です。実際にどうやってこの構造を育ててきたか見ていきます。
AIワークフローシステムの進化プロセス
<Step 1>
Single Task ─ 「まず1本」を正しく作る
最初はシンプルに、Input→Process→Outputで構築しました。ただし、この段階で手を抜いかなかった設計が2つあります。
トレーサビリティの確保
どの入力に対して、どんな出力が生成されたか。検証・改善用と、運用監視用のログを意識して設計します。
Gitによるプロンプト管理
ここではS3ではなくGit管理を採用しています。バックオフィス業務においてプロンプトの変更はシステム変更と同義だからです。「誰がいつ変えたか」をコードと一体でレビュー(PR)できる環境が、品質担保の命綱になります。
もちろん、今後はエンジニア以外がプロンプト変更を行う必要性が出てくることは避けられません。特に顧客カスタム的な要素は、毎回デプロイしていると運用が回りません。一部をS3管理などに移行する時も来るだろうと考えています。
<Step 2>
段階処理(Sequential Chain) ─ 精度を高める直列実行
単一のプロンプトで精度が出ない場合、処理を分割します(抽出→検証など)。ここで「共通基盤(Base)」の必要性が生まれます。
ここでは、Workflow全体のリトライ制御や、個別のLLM呼び出しエラー処理を基盤クラスにまとめ、エンジニアがビジネスロジックに集中できる環境を作ります。特に、一時的なAPIエラーやネットワークの問題に対する自動リトライ機能は、本番運用における堅牢性を確保する上で不可欠な要素です。
Step 2で処理が複雑化するにつれ、システム全体を支える「共通基盤」の設計方針が重要になってきます。ここで直面するのが「AI開発フレームワーク(LangChainなど)を使うべきか?」という技術選定の分岐点です。
ー なぜフレームワークに頼らず自作するのか ー
結論から言うと、「量産フェーズでは慎重になるべき」というスタンスを取っています。LLMの呼び出しなどシンプルな機能のみを利用し、依存性を下げた実装を行っています。
もちろん、単一のAIエージェントやワークフロー開発、使い捨てのスクリプトならフレームワークは優秀です。高速で作れるし、新しい論文の実装も試しやすい側面があります。
しかし長期的に運用し、量産するフェーズに入ると負担になるリスクがあります。
LLMの進化は速く、フレームワークの破壊的な仕様変更も頻発します。また、フレームワークの抽象化層が、最新モデルのAPI仕様変更や新機能への追従においてボトルネックになることもあります。独自構文は、チームによっては認知負荷や学習コストを高める要因になります。標準的なPythonの書き方であれば、ライブラリを知らないメンバーでも読み解きやすくなります。
「自分たちで作ると大変では?」と思うかもしれません。確かに初期構築コストはかかります。しかし、長期運用の観点では負債の解消コストが圧倒的に低いというメリットがあります。標準的なPythonで書かれているからこそ、新しいメンバーでも読める。これはチームのスケーラビリティに直結します。
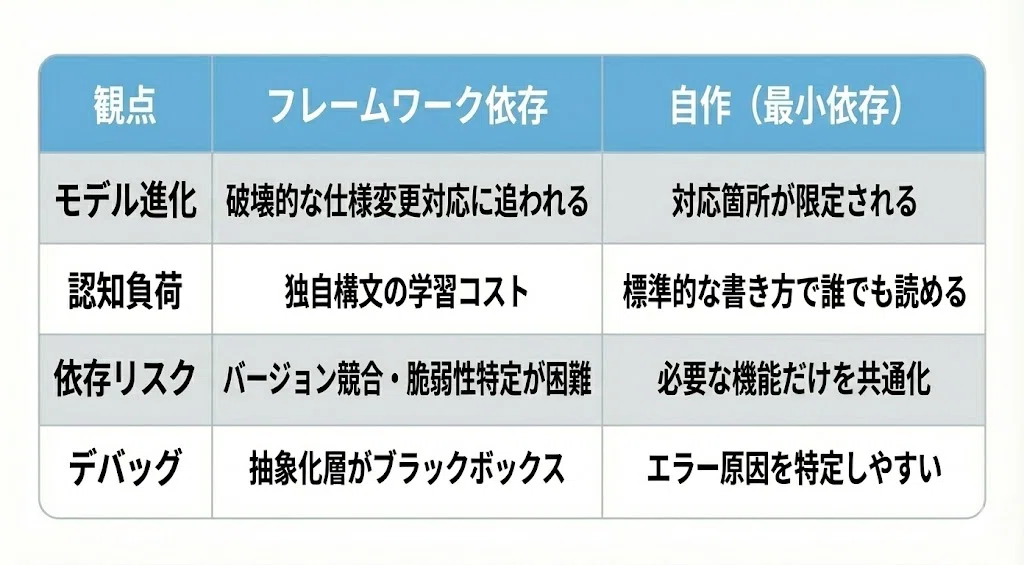
「汎用的な正解」ではなく「自分たちにとっての最適解」を共通基盤に落とし込む。これが長く安定したシステムを作るための原則です。
ー 非同期大量実行の実装と責務の分離 ー
BPaaSでは100件などを一括処理することが頻繁にあります。WebのRequest-Responseモデルではなく、バッチ/ジョブキューモデルが基本です。
ここで最も重要な設計判断は、「システム的な責務(共通基盤)」と「ビジネスロジック(ワークフロー)」を完全に切り離すことです。
共通基盤(Platform)の責務:
ワークフローの外側にある「面倒なこと」をすべて引き受けます。
ワークフロー(Workflow)の責務:
純粋な「処理ロジック」に徹します。
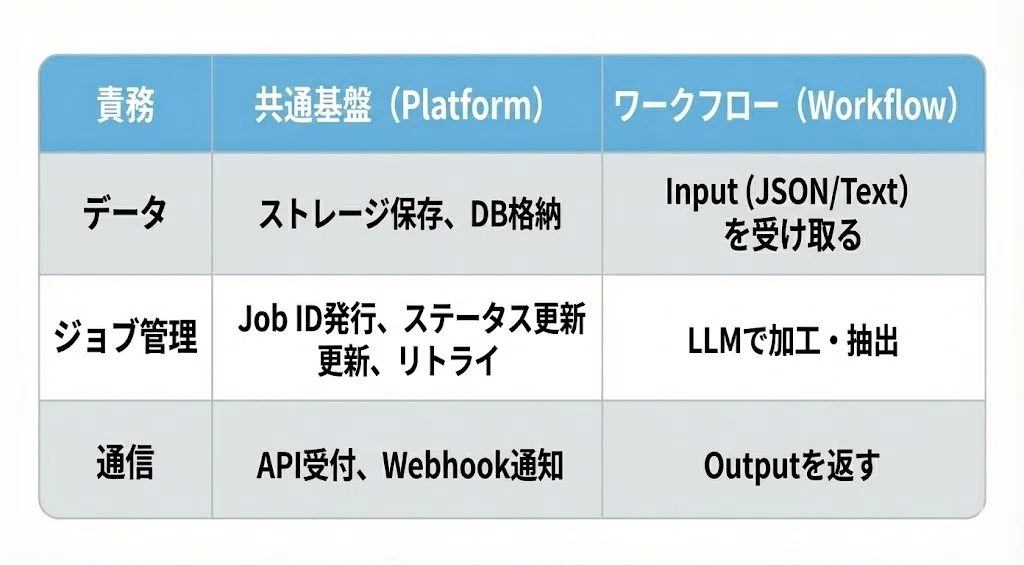
この分離により、ワークフロー開発者はDBやジョブキューを意識せず、「入力→期待する出力」のテストだけに集中できます。
<Step 3>
Agentic Workflow ─ 入力を「捌く」判断をLLMに任せる
ワークフローが増えてくると、Inputの多様性や処理の分岐を捌くために、LLMによる判断が必要になります。
例えば経理部では、「請求書」「領収書」の分類なら簡単そうに感じますが、実務はもっと複雑です。
ここでAgentic Workflowの出番です。Anthropicの記事では「Routing classifies an input and directs it to a specialized followup task(ルーティングは入力を分類し、専門化された後続タスクに振り分ける)」と説明されているパターンがこれに該当します。
Agentic WorkflowはWorkflowsの一種です。Agentsのように「何でもできる」わけではなく、「決められた選択肢の中から最適な経路を選ぶ」という制約があります。この制約があるからこそ、運用時のトラブルシューティングが容易になります。
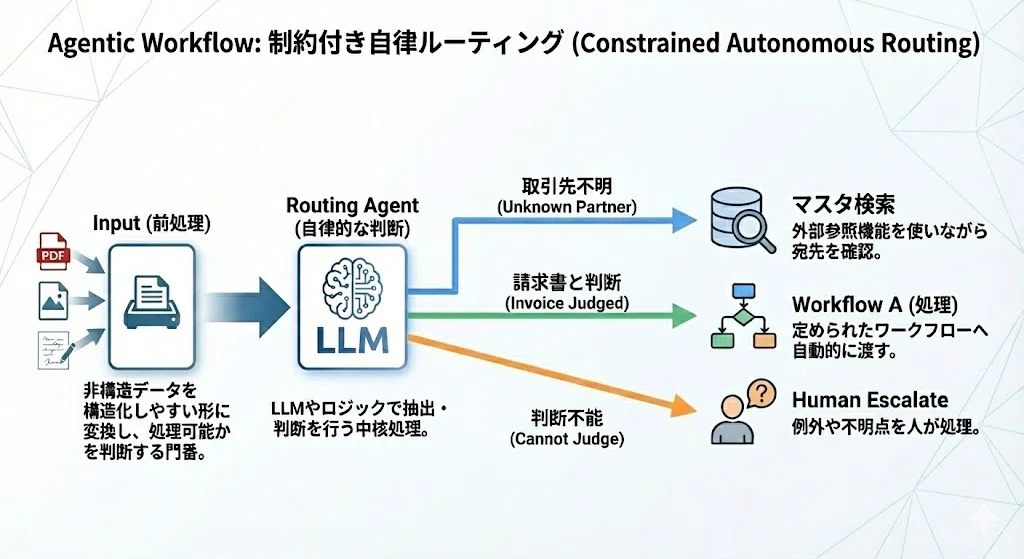
Agentは入力画像を見て、必要に応じてマスタ検索などの外部参照機能を使いながら、最終的にどのワークフローに渡すかを自律的に判断します。
例えば、1つのPDFの中に「請求書」「また別の請求書」「ただの広告チラシ」が混ざっているケース。
SaaSなら「形式が正しくありません」とエラーで返せますが、BPaaSではこれらをすべて受け入れなければなりません。AIがページ単位で分割し、広告を除外し、請求書だけをそれぞれ適切なワークフローに振り分ける。この判断こそがRoutingの仕事です。
これは人が郵便物を仕分ける作業に似ています。封筒を見て宛先がなければ調べる、中身が違えば別の担当に回す、という判断をAIが代行します。
ー 複雑なInputを「捌く」ための自律性 ー
前述の通り、BPaaSは入力を拒絶できません。では、実際にどんな入力が来るのか。
「じゃあ1ページずつ処理すれば?」と思うかもしれませんが、そう単純ではありません。
請求書の明細が複数ページにまたがっている
広告チラシが混ざっている
空白ページが存在する
さらに厳密には「請求書」ではないが、電気代やインターネット回線料など、口座振替の通知など経費精算として処理が必要なものもあります。
SaaSならフォーマット違反でエラーにできますが、BPaaSではこれらをすべて受け入れて処理しなければなりません。Workflowが期待する粒度(1請求書1ファイル)に分割する前処理が必要です。
つまり、経理担当者が日々柔軟に処理しているものを、AIが引き受けるなら、Inputの前処理で対象を正しく認識し必要なWorkflowにRoutingすることが必須になります。
この地道な前処理こそがBPaaSの競争力の源泉であり、単純な固定ルールではなくLLMが判断を行うAgentic Workflowが必要になる理由です。
この段階でやるべき共通化:共通ステップのライブラリ化
ここで重要なのは、「Workflow内で繰り返し利用される「共通ステップ(処理ブロック)」のライブラリ化」です。
メインで構築しているのはWorkflowです。そのため、共通化の対象は主に以下のような処理ブロックになります。
共通ステップ(Workflow用):
OCR、特定フォーマットの正規化、ビジネスルールチェックなど、定型フローの中で必ず通る処理。
これらをライブラリとして共通化し、各Workflowがパーツとして組み込みます。Agentが自律判断を行う場合も、基本的にはこの共通化された機能ブロックを利用することで、保守性と再利用性を高めています。
<Step 4>
Human-in-the-Loop ─ 人という最強のセンサー
どれだけ自動化しても、判断に迷うケースは残ります。ここで重要なのは、人の介入を「例外」と捉えず、「システムの一部」として設計することです。
ー Workflowか自律エージェントか ー
Agentかworkflowかの判断。
— 藤井謙太郎 / kubell AI Bizdev (@kentaro_fujii_) October 3, 2025
ポイントは、抽象化した思考やプロセスにステップ毎の分岐があるかです。あるなら明確にworkflowとして分割するべき。具体的には、前提が揺らぐと後続のステップに大きく影響することです。また、判断に必要な材料が不足しているなら、判断不可能なのでHuman In the…
よく議論になるテーマですが、ここでは以下のように整理しています。
Workflow / Agentic Workflow:
・処理手順が明確に定義できる
・繰り返し業務、入力パターンと処理経路が固定
自律エージェント:
・処理手順そのものを探索する必要がある
・人が指示する場合、出力パターンが千差万別
バックオフィス業務は手順が決まっているのでWorkflow一択かと思いきや、手順外の「例外」を定義しきれない問題があります。どう対応すればよいか分からないことは、人に聞くしかありません。
ー 人の修正をデータとして蓄積する ー
Human-in-the-Loopは、単なる修正作業ではありません。未来のエージェントを育てるための学習ループの起点です。
ただし、ここで別の問題が見えてきます。「判断」は人がやるとしても、その後の機械的な「転記・整形作業」まで人がやり続けるべきなのか? という点です。
人が対応している作業をよく見ると、その多くは「判断」ではなく「単純作業」です。
・ワークフローの出力を別のフォーマットに転記する
・特定の顧客向けに項目を調整する
・会計システムが受け入れる形式に手動で変換する
判断が必要な作業は人がやるべきです。しかし、機械的な作業まで人が担うのは、BPaaSとして最適ではありません。ここに次のステップへの布石があります。
<Step 5>
ラストワンマイル ─ 狭いドメインでの安全な自律
ワークフローなのか自律エージェントなのか。よく議論になりますけど、繰り返し業務などインプットやルートが決まっていればワークフローだし、インプットを人がするなど入力が固定でなければ対話設計を厳密にしなければ自律エージェントになるのは自明ではなかろうか。他にもこういう時とかいろいろあ…
— 藤井謙太郎 / kubell AI Bizdev (@kentaro_fujii_) November 24, 2025
ここで、「この取引先だけCSVの列を変えたい」といったOutputの個別要望(ラストワンマイル)の問題が出てきます。これをルールベースで書くと際限がありません。
そこで、Output調整に特化した自律エージェントを配置します。Workflowでドメインを絞り込んだ上で、最後の調整だけをエージェントに任せる。これこそが、予測可能性を保ちながら個別最適を実現する「安全な自律性(Safe Autonomy)」のアプローチです。
量産、そしてその先へ
ここまでシステムが進化すると、全体がパターン化されてきます。
・新しいワークフローは「どの共通ステップを使うか」と「どこを人/エージェントに渡すか」を決めるだけになる
・共通基盤と共通ステップが整備されていれば、新しい業務への展開は「ワークフロー定義とプロンプト」だけで済む
パターンが固まれば、テンプレ流用で量産できます。量産できるということは、将来的には仕様を投げてワークフローを半自動生成する未来も見えてきます。
ー エンジニアとAIオペレーションマネージャーの二人三脚 ー
この段階で、役割分担がより明確になります。
Dev(エンジニア):
・共通基盤の拡張、新規Workflowの骨格作成
・機能拡張(0→1、1→10)
Ops(AIオペレーションマネージャー):
・プロンプト調整、顧客固有設定、運用データ分析
・品質と個別最適(10→100)
次のチャレンジ:「個社ごとの知識」をどう扱うか
会社ごとに異なる判断基準、過去の修正履歴、業務の癖。これらをAIが参照できる形で残し、必要なときに適切に取り出せる仕組みを地道に作っています。
すでにプロンプトは人がほとんど書いていません。新規に軽く作るのは2-3時間もかからないようになっています。この「プロンプトすら自動化する開発体制」については、DSPyとLangfuseを使った事例も出てきていますが、取り組んでいきたいテーマです。
この延長線上に、個社ごとの知識を共通基盤の上でシンプルに扱い、ワークフローを自動生成する未来があると考えています。
目指している全体アーキテクチャ
これまでのStep 1〜5を統合し、現在構築を進めている全体像がこちらです。まだ道半ばですが、この形を目指して開発を続けています。
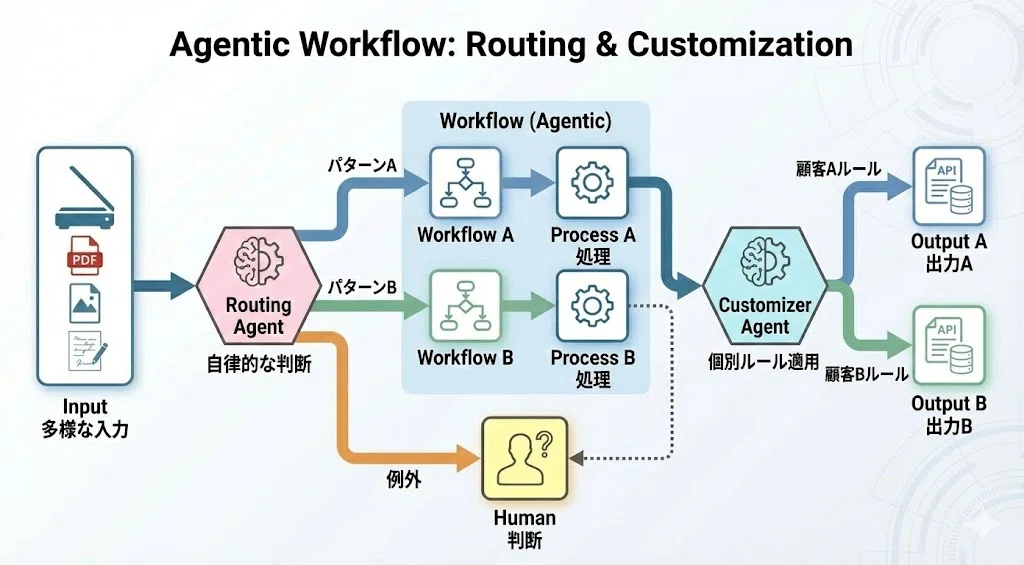
「入り口(Routing)」と「出口(Customizer)」をAgentが担い、中核の処理はWorkflowが確実に実行する。そして例外はHumanが拾う。これが、現時点で私が考える「量産」のための最適解です。
実装パターン:実際の「経費精算エージェント」の処理フロー
最後に、このアーキテクチャが具体的にどう動くのか、A社から「5ページの雑多なPDF」が届いたケースで見てみましょう。
Input(入力)
・A社からPDFが届く。「請求書2枚、チラシ1枚、白紙1枚、手書きメモ1枚」が混在している状態
Routing Agent(仕分け)
・チラシ・白紙 → 「対象外」として破棄
・手書きメモ → 「判断不能」としてHumanへエスカレーション
・請求書2枚 → 「請求書Workflow」へルーティング
Process & Validation(実行・検証)
・請求書WorkflowがOCRで情報を抽出
・インボイス番号の形式チェックや、金額の整合性を検証
・仕訳を生成(詳細は秘密)
Customizer Agent(個別調整)
・最後に、A社固有のルール(「通信費」は「雑費」に変換してCSV出力する)を適用し、指定の形式で出力完了
このように、「迷う部分」だけをAgentに任せ、処理自体は堅牢なWorkflowで回すことで、実務に耐えうる安定稼働を実現しています。
なぜ世界的なトレンドも「Workflow」回帰なのか
ここまで実践を通じて辿り着いたアーキテクチャですが、実は世界的なトレンドとも一致しています。私たちの試行錯誤は間違っていなかった、という答え合わせです。
冒頭で定義した通り、本記事ではWorkflow / Agentic Workflow / Agentsの3つのレベルに分けています。この分類はAnthropicの「Building effective agents」を参考にしています。
なぜ「Agentic Workflow」をメインにするのか
Andrew Ngは2024年に「AI agentic Workflows will drive massive AI progress this year」と述べ、Reflection、Tool use、Planning、Multi-agent collaborationの4つのデザインパターンを提唱しました。
AgentsではなくAgentic Workflowをメインにする理由は、バックオフィス業務に求められる「確実性」にあります。両者を比較すると、その違いが明確になります。
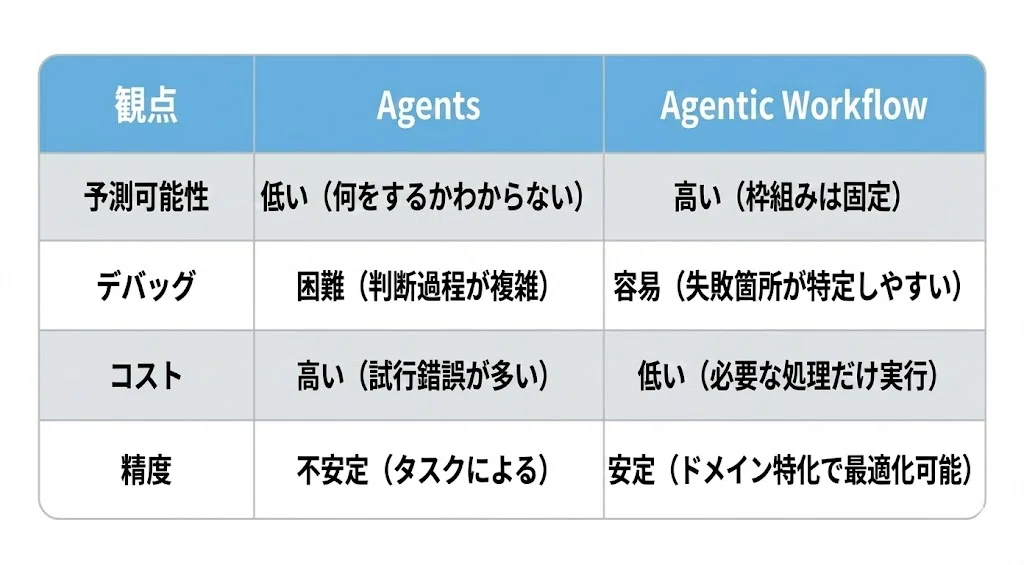
請求書を処理して仕訳を生成する。この手順自体は決まっています。ただし、入力の多様性や例外パターンに対応するために、ワークフローの「中で」LLMに判断を任せる。これがAgentic Workflowの本質です。
Agentsは万能に見えますが、「何ができるか」の制約がないことが逆にリスクになります。本記事で提案するアプローチは、Agentic Workflowで「できること」の範囲を限定し、その中でだけLLMに判断を任せる「安全な自律性(Safe Autonomy)」です。
単一エージェント vs Workflow量産:なぜ後者を選ぶのか
「なぜ1つの賢いエージェントにすべてを任せないのか?」
この問いに対する答えが、本記事の核心です。
単一エージェントアプローチ
ユーザー → 万能Agent → (何でもできる)→ 結果
理想的に見えますが、バックオフィス業務では問題が発生します。経理業務だけでも、入出金処理、経費精算、仕訳生成、消込処理など、それぞれ異なる入力形式・ルール・出力先を持ちます。これらを1つのエージェントに詰め込むと、プロンプトは膨れ上がり、「ある処理の改善が別の処理に悪影響」といった副作用が起きやすくなります。
Workflow量産アプローチ
ユーザー → Routing → 適切なWorkflow
→ Workflow A(請求書処理)
Workflow B(経費精算)
Workflow C(仕訳生成) ...
Workflowを量産するアプローチでは、各業務に特化した小さなWorkflowを独立して開発・テスト・改善できます。共通部分は共通基盤として切り出し、業務固有の部分だけを各Workflowに実装する。これが「量産」を可能にする設計です。
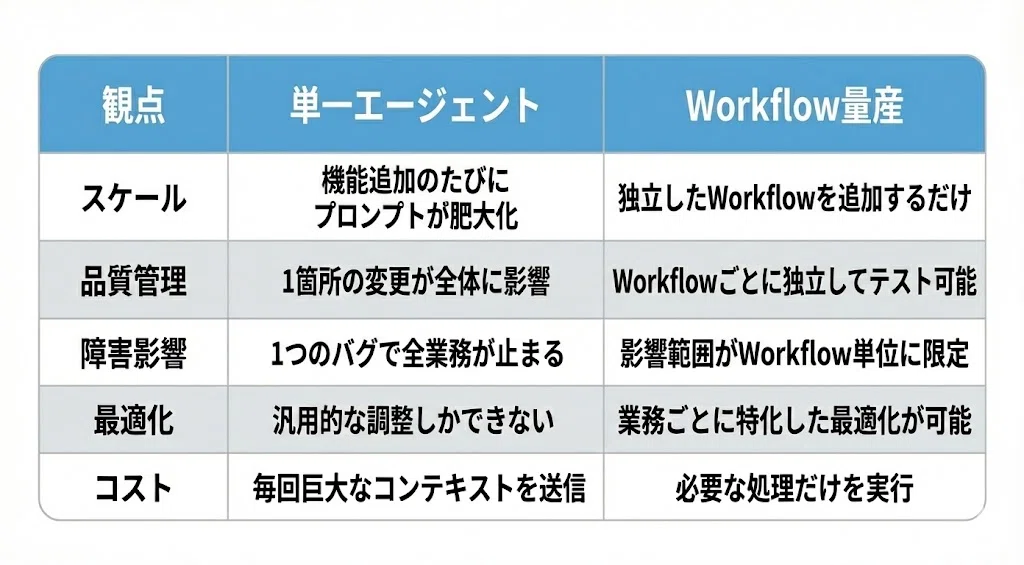
自律エージェントが量産に不向きな理由
Agentsは「何をするかを自ら決める」ため、以下の特性があります。
・再現性が低い:同じ入力でも異なる経路をたどる可能性がある
・テストが難しい:どの経路を通るか事前に予測できない
・コストが読めない:試行錯誤の回数によってトークン消費が変動
・責任分界点が曖昧:問題発生時にどこを直せばいいかわからない
バックオフィス業務では「毎回同じ品質で処理される」ことが求められます。Agentsの柔軟性は、この要件と相性が悪いのです。
だからこそ、Agentic Workflow(枠組みの中で自律させる)を量産するというアプローチを取ります。
まとめ
AIエージェントの世界では「完全自律」が注目されがちですが、実務で求められるのは「安全な自律性(Safe Autonomy)」です。本記事で紹介したアーキテクチャは、以下の3つの設計思想に基づいています。
枠組みで制約し、中で自律させる
・Agentic Workflowで「できること」を限定し、その中でLLMが判断
Agentsは狭いドメインに限定(Safe Autonomy)
・ラストワンマイルなど、失敗しても影響が小さい領域でのみ許可
人は判断に集中
・単純作業はAIに任せ、本当に判断が必要な部分だけを担当
すべてをAgentsに任せるのは運用上のリスクが大きく、すべてを固定ルールで書くと保守が破綻する。Agentic Workflowは、その中間にある現実的な解です。
手作りの苦労から抜け出し、進化する工場を作る。BPaaSの開発は、そこが一番面白いところです。
We are hiring!
開発と運用の境界を一緒に作り上げていく仲間を探しています。興味がある方、ぜひ話しましょう。
