第30話 NotebookLM活用研究①成果物評価の実験と見えてきた課題

1 要点
前回は、Gemを作成して提出物をAIに評価をしてもらったが、今回は話題の生成AIであるNotebookLMに、生徒の成果物を評価をさせてみた。
4段階の評価と理由の出力には成功したが、未提出の誤判定や評価のブレという大きな課題があった。
結論として、最終的に判断するのは人間であるので教師によるチェックは今後も行うが、現状はAIが成績をつけるということにはまだまだ課題が多い。
2 きっかけと目的
レポートや生徒の発表スライドを評価するというのは本当に難しい。今回、探究学習の発表会を行ったので、成果物であるスライドやそれらの元になった調査データをルーブリックをもとにして評価してみた。
理科の実験レポートもそうだが、生徒が作ったGoogleドキュメントやスライドを一枚ずつルーブリックに照らし合わせる作業は、正直言って教員にとっては一苦労。そこで、新しい実験器具を試すようなワクワクした気持ち半分、業務効率化への淡い期待半分で、話題のAIを使って評価の自動化に挑んでみた。
3 本文:検証内容
以前、「ルーブリックをもとにしたポートフォリオ評価をAIに任せることで生徒のやる気アップや教師に余裕が生まれて他の支援にまわれる」という話をした(第25話参照)。
今回はその続きである。
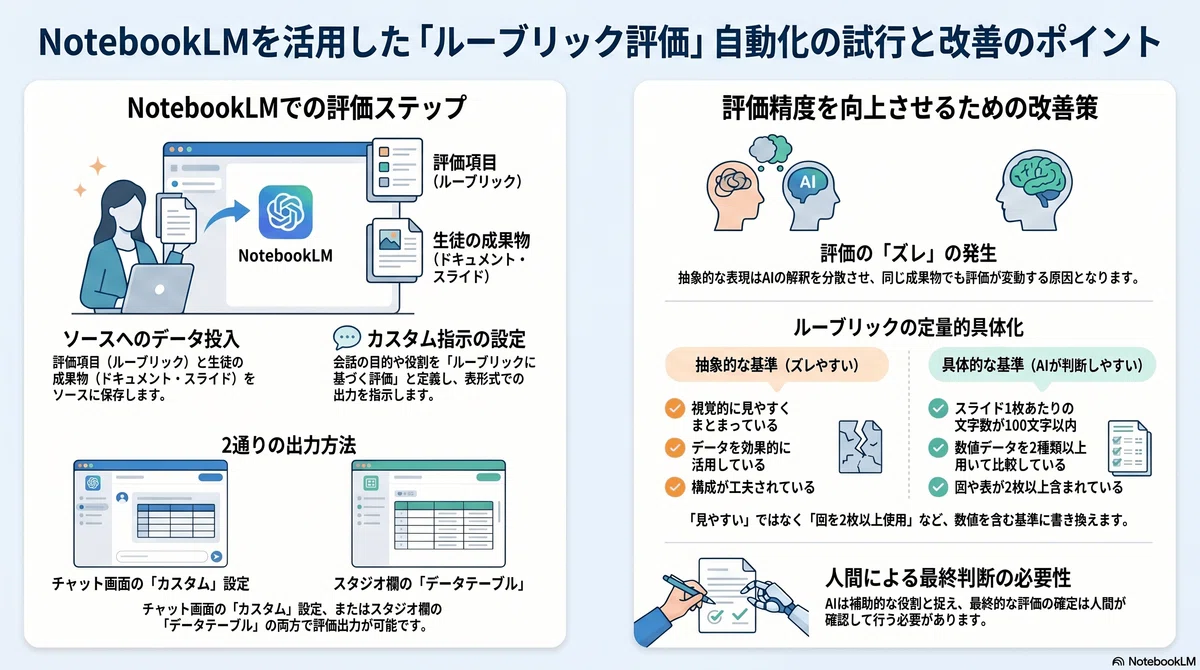
実験の手順としては、まず4段階の評価項目(全6項目)を定めたルーブリックと、個人情報を隠した生徒の成果物データをAIに読み込ませた。今回は、チャットのカスタム設定を使う方法と、データテーブルという機能を使う方法の2種類を試してみた。
結果としては、どちらの方法でも表形式での4段階評価と、その理由をしっかり出力してくれた。ここまでは、おお、これは使えるかもしれないと理科室で一人、興奮したのだが、じっくり見ていくと2つの大きな壁にぶつかった。
【課題1:未提出の判定ミス】
中身が空っぽの配布用フォーマットをそのまま出してきた生徒に対して、AIの判定が分かれた。
評価1と厳しくつけるケースと、正しく未提出と見抜くケースが混在してしまった。
どうやらAIにとっては、白紙の紙が最低評価なのか、出していないだけなのかの区別が難しいようだ。
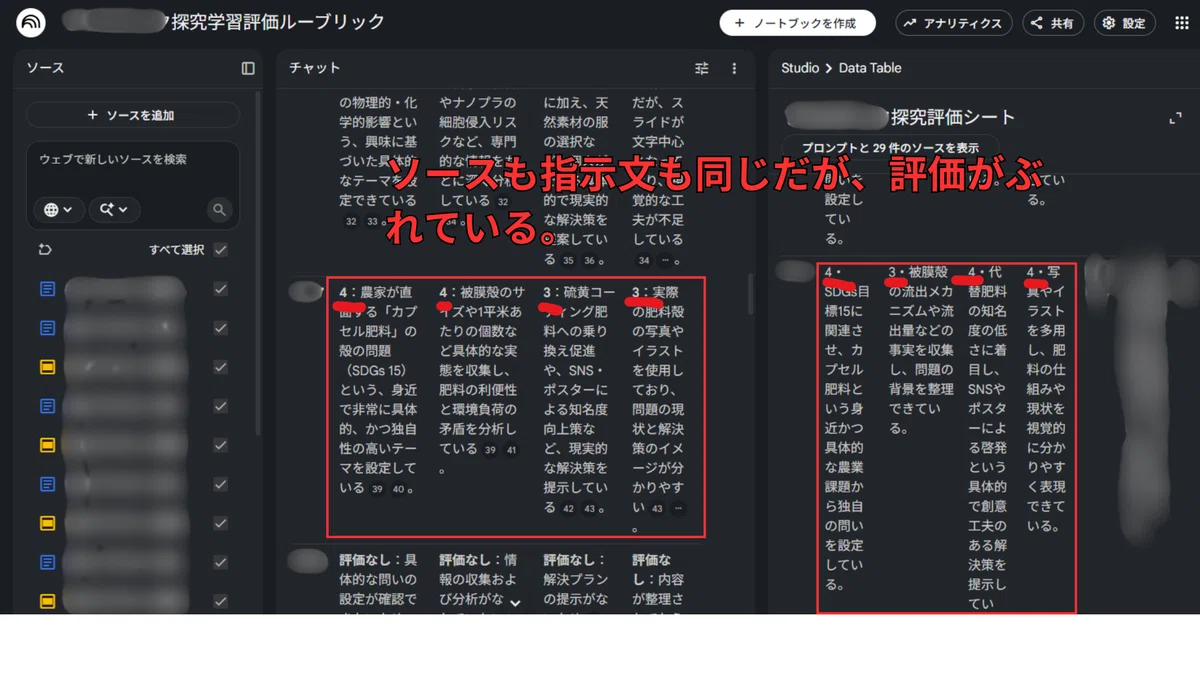
【課題2:評価のブレと基準の曖昧さ】
同じ生徒の同じ項目を評価させているのに、出力方法の違いによって評価が2になったり評価が4になったりする現象が起きた。
これはルーブリックの表現が曖昧だったことが原因のようだ。
人間でも解釈に迷うような表現だと、AIも迷ってしまい、判定が大きくブレてしまう。
【AI評価を実運用する上での考察】
この解釈のブレを防ぐには、ルーブリックを徹底的に数値化・定量化する必要がある。
・図や表が2枚以上入っていること
・スライド1枚あたり100文字以内であること
しかし、実際の教育現場でそこまで細かい数値目標をすべての項目で作るのは、現実的でない。
さらに、文章の評価は得意なAIだが、スライドの見やすさのような、色使いやレイアウトといった主観的で複合的なデザイン要素の判断は、まだまだ苦手のようだ。
4 まとめ
今回の実験で分かったのは、AIはとても優秀な助手にはなるが、成績をつけたりするのは得意ではないようだ。
たたき台としては非常に優秀なので、AIに一次評価をさせてから、最終的には我々教員が人間の目で再確認して調整する形が、ベストな運用のようであるが、もう少し研究を続けてみたい。
デジタルに関しては新米教師のような気持ちですので、もし詳しい先生がいらっしゃいましたら、ぜひアドバイスをお願いします。
また、スキや応援のコメントもいただけると、クマのように喜びます。
