改訂 画像生成プロンプトは「絵柄」ではなく「見ること」を設計する――「何を描くか」ではなく、「何を見せるか」を設計するプロンプトへ

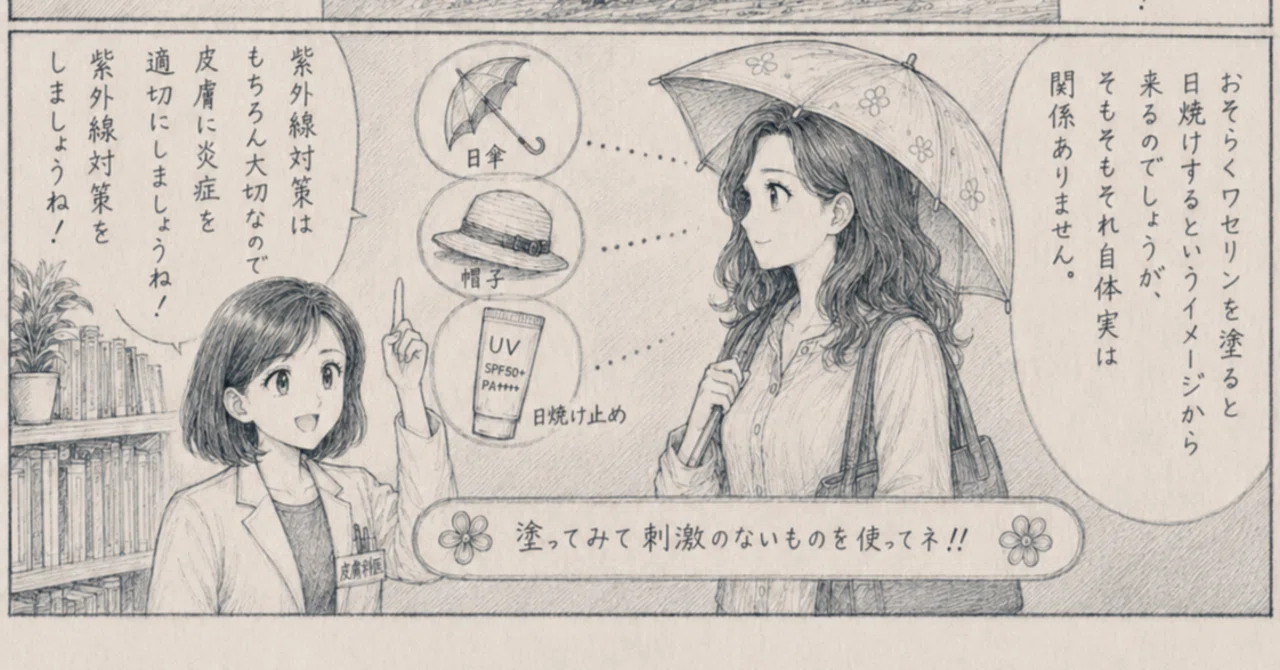
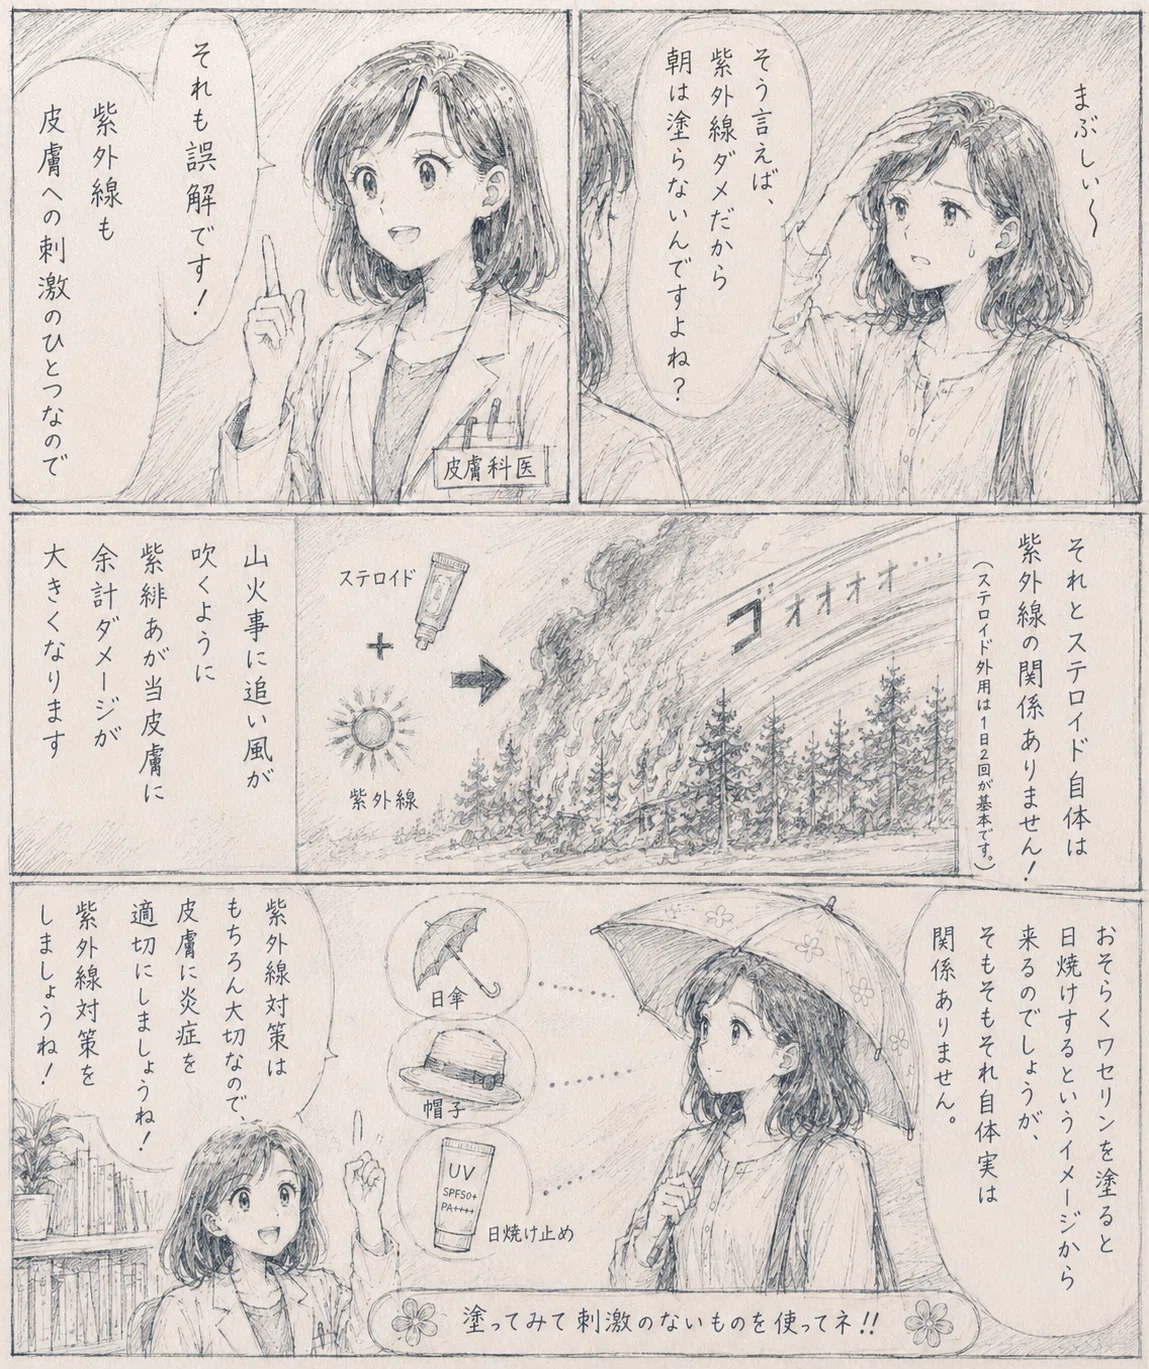
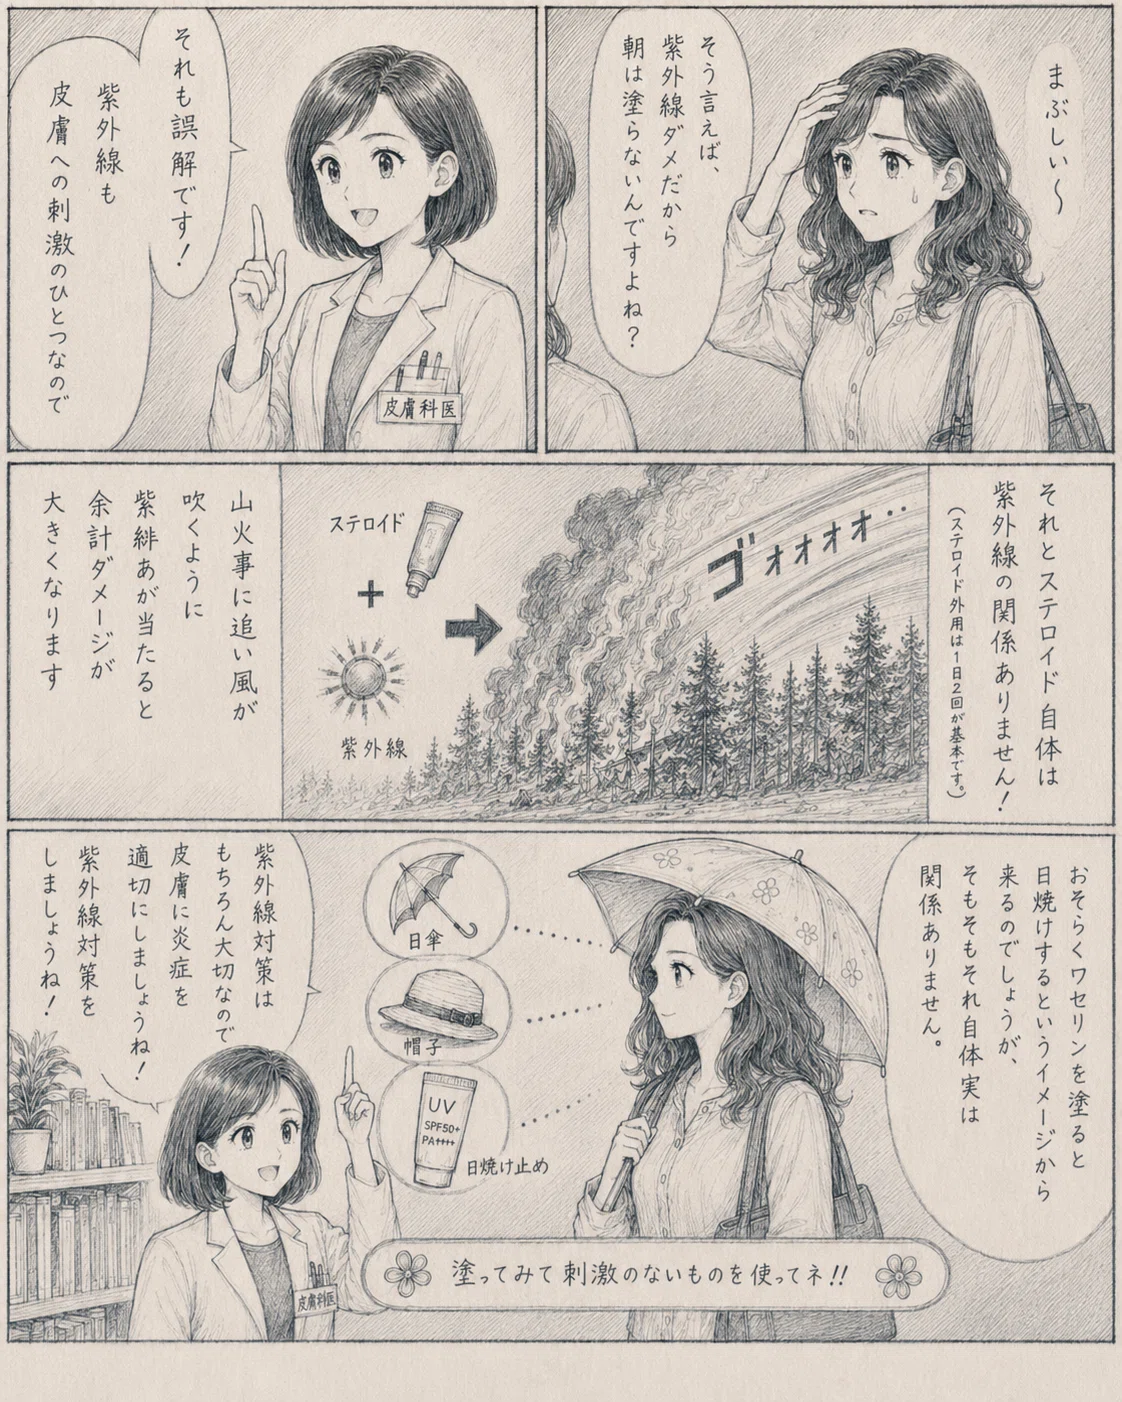
AIに構成から作画まで任せた資料や漫画って、作画は本当に綺麗なんだけど……なぜか読む気をなくすのは、私だけ?
— 肉球せんせい🐾皮膚科専門医/イラストレーター/MD,PhD (@29Qsensei) August 19, 2026
左は自作の漫画、右は同じ内容をChatGPTに投げたもの。自作の方が圧倒的に絵は下手だし、ゴチャついて綺麗じゃない。… pic.twitter.com/CAiYK2b2O0
AI画像は、なぜ「上手いのに見づらい」のか
――「何を描くか」ではなく、「何を見せるか」を設計するプロンプトへ
最近、AIに画像を作らせていて、何度も同じ違和感にぶつかった。
たしかに上手い。
細かい。
破綻も少ない。
なのに、なぜか見づらい。
どこを見ればよいのか分からない。
全部ちゃんと描いてあるのに、全部が同じ熱量で押し寄せてくる。
主役も背景も、重要なものもどうでもいいものも、同じ強さで並んでいる。
これはAIが「下手」だから起きるのではない。
むしろ逆で、上手すぎるから起きる。
もっと正確に言えば、「高品質化」が、そのまま「見やすさ」や「伝わりやすさ」になるわけではないということである。
きれいに描くことと、伝わることは別である
AI画像のプロンプトでは、ついこう書いてしまう。
beautiful, detailed, highly detailed, masterpiece, cinematic lighting …
だが、こうした指定はたいてい、画面全体の情報量を均一に増やす方向に働く。
結果として出てくるのは、
顔も背景も同じくらい描き込まれている
画面の周辺にも細部が詰まっている
輪郭も質感も全部が確定している
どこに注目してほしいのか分からない
という画像である。
人間が絵を描くときは、そんなふうにはならない。
本当に見せたいところには手数をかける。
逆に、そうでないところは省略する。
輪郭を弱くしたり、描き込みを減らしたり、場合によってはほとんど描かなかったりする。
つまり人間は、
「世界にあるものを全部描く」のではなく、見る側に何を受け取らせたいかに応じて、情報の配分を変えている。
ここで効いてくるのは、「何を描くか」だけではない。
**「何を見せるか」**である。
人間の描画研究は、このことを示唆している
Judith Fanらの研究は、人間の描き手が、相手の課題や文脈に応じて描き方を変えることを示している。
遠くの相手に対象を区別してもらうときと、近い文脈で手がかりが共有されているときでは、描き込む量や描き方が変わる。
重要なのは、描画量が対象の「客観的な複雑さ」によってだけ決まっているのではなく、
相手に何を識別させたいかによって変わることである。
もちろん、ここからただちに、
だからAIのプロンプトに同じことを書けば、そのまま同じ効果が出る
とは言えない。
ここは強調しておきたい。
人間の描画研究は、AIプロンプトの効果を直接証明するものではない。
ただし、画像生成を考えるうえで、
「何を描くか」より先に「何を伝えるか」「何を見せるか」を立てるべきだ、
という発想の支えにはなる。
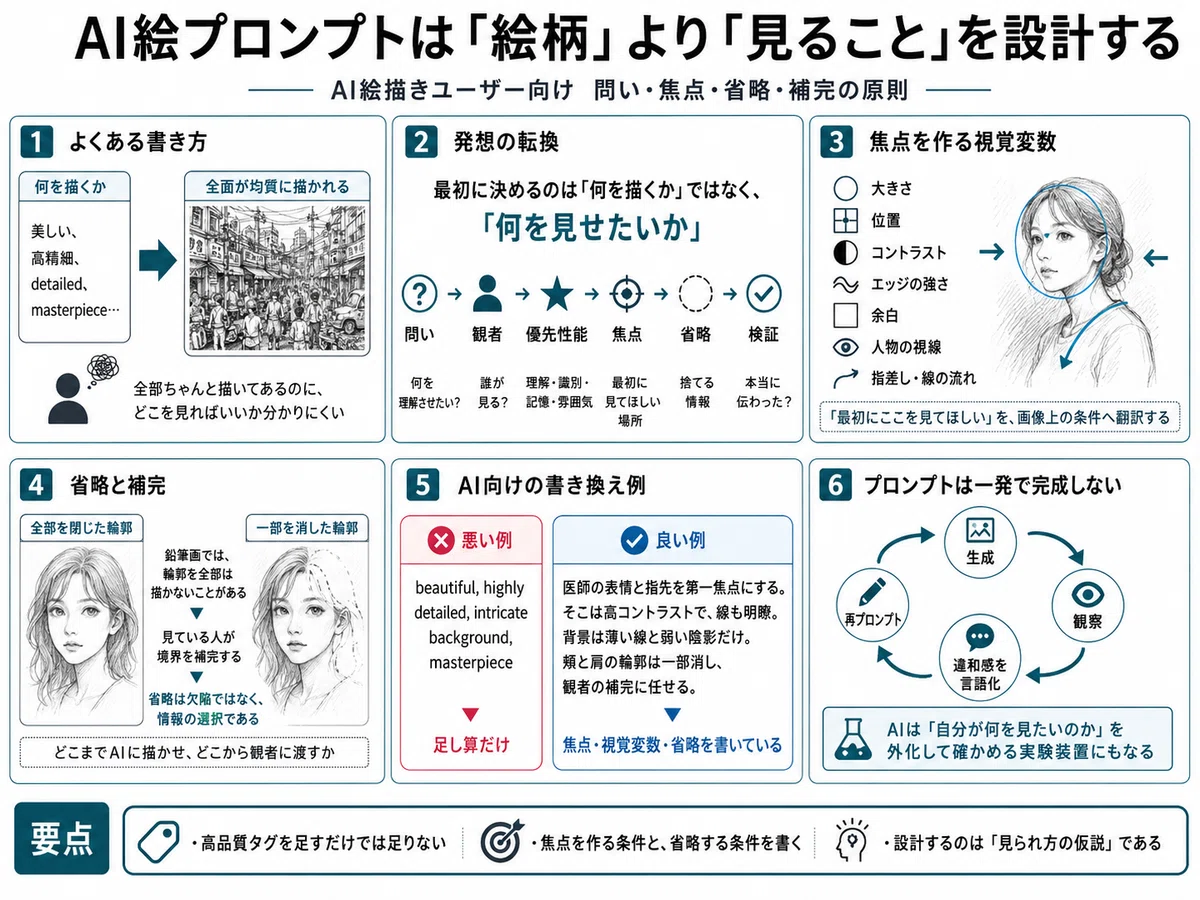
プロンプトは「対象の説明」ではなく「見ることの設計」である
したがって、画像生成プロンプトを考えるときの順序も変わる。
従来のやり方はこうである。
何を描くか列挙する
スタイルタグを足す
品質タグを足す
ネガティブプロンプトで破綻を避ける
だが、これでは「対象記述+品質加算」に留まりやすい。
それに対して私が提案したいのは、次の順序である。
問いを決める
この画像で、見る人に何を分からせたいのか
観者を想定する
誰が、どれくらいの時間で、どんな文脈で見るのか
視線階層を決める
最初にどこを見てほしいか
次に何へ目が移るべきか
情報密度の勾配を作る
主役は高密度、周辺は低密度
輪郭の確定度を場所ごとに変える
どこをはっきり閉じ、どこを曖昧に残すか
省略を設計する
描かないもの、弱く描くものを明示する
最後にスタイルを与える
ここで重要なのは、
プロンプトを「対象のスペック表」から、視覚的な注意配分の設計書へ変えることだ。
「輪郭」は、全部閉じればよいわけではない
鉛筆画やデッサンが好きな人がしばしば惹かれるのは、
輪郭が全部きっちり確定していないからでもある。
顔の輪郭が一本で閉じず、何本かの線の重なりとして置かれている。
髪の端が背景に溶ける。
服の裾は簡略で、目だけが異様に強い。
こういう絵では、見る側が不足部分を補完する。
そしてその補完の余地が、「生きている感じ」「見てしまう感じ」につながることがある。
ただし、ここも慎重でなければならない。
輪郭が弱ければ必ず魅力が増す、という一般法則があるわけではない。
科学図版や商品画像のように、むしろ輪郭の明確さが重要な場合もある。
ここで言いたいのは、
輪郭は「ある/ない」ではなく、
どこを確定し、どこを観者の補完へ委ねるかという設計変数だということだ。
ネガティブプロンプトは「破綻防止」だけではない
ネガティブプロンプトは、しばしば
bad hands
extra fingers
blurry
low quality
のような「事故防止」の呪文として使われる。
もちろんそれも必要だが、本来もっと重要なのは、
省略の設計として使うことである。
つまり、
背景を過剰に描き込まない
全域を同じ密度にしない
輪郭を全部閉じすぎない
顔をシールのように均質にしない
といった方向で、
「画面全体を均質化する力」を抑えるために使う。
ネガティブプロンプトは、「失敗を防ぐ」だけでなく、
描かないものを決める装置でもある。
ただし、ここには限界もある
ここで一つ、過剰な期待を避けておく。
私は以前、この考え方をかなり強く書きすぎた。
しかし実際には、
人間の描画研究
視覚認知研究
AI画像生成の実装可能性
は別の層にある。
人間の描画研究は、
「人間はどう描き分けるか」を示している。
それがそのまま、
「現行の画像生成モデルが、自然言語だけで場所ごとの密度勾配や輪郭の差を正確に実行できる」
ことの証拠にはならない。
つまりこの稿の提案は、
実証済みの万能プロンプト理論
ではなく、
人間の描画と知覚の研究をヒントに、AI画像の指示を再編するための設計仮説
である。
ここを曖昧にしてはいけない。
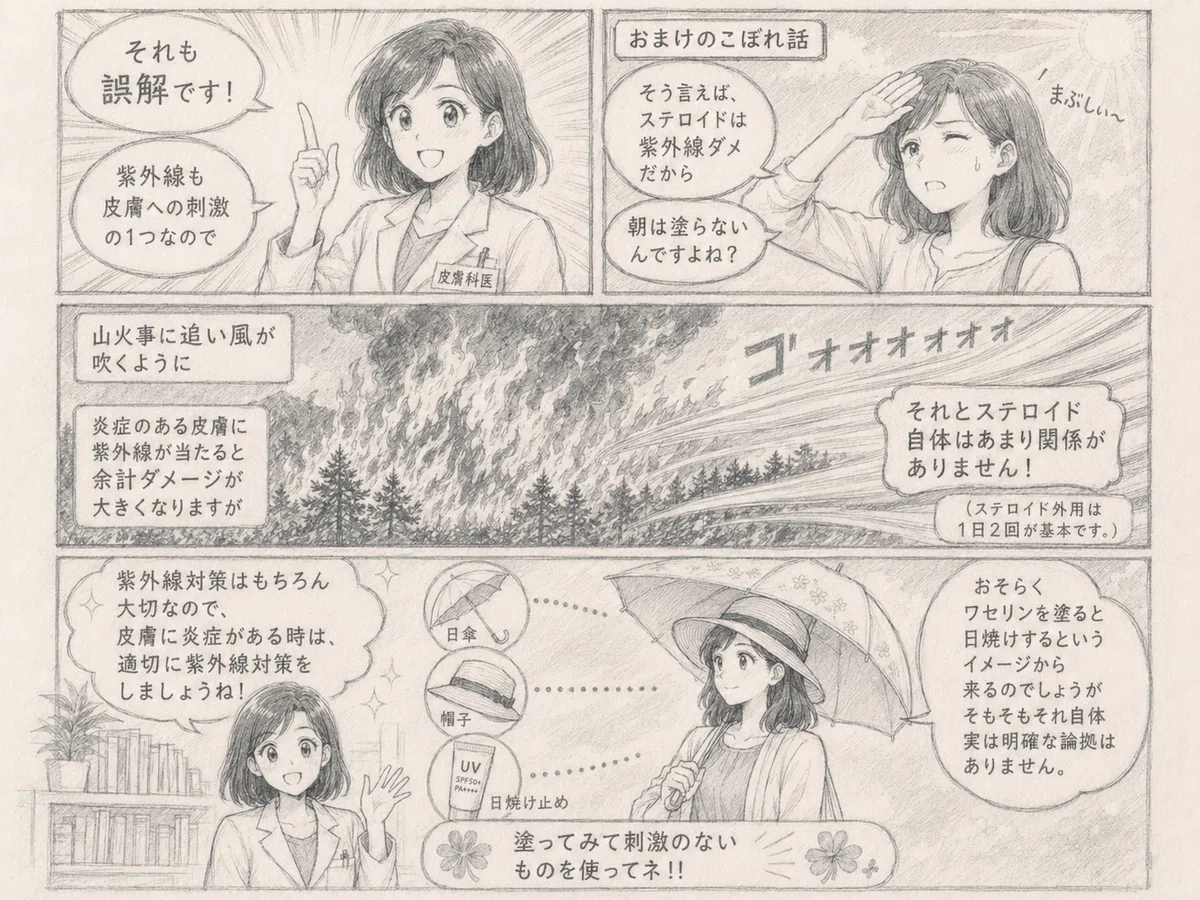
訂正注:本文で以前用いた皮膚科漫画画像について
ここで、以前この議論の例として用いた皮膚科漫画の生成画像について、明確に訂正しておく必要がある。
あの画像は、もともとの説明漫画の画風を変える試行として生成したものだった。
しかし結果として、医学説明としては不正確な図が混入した。
具体的には、本来の説明は、
炎症のある皮膚に紫外線が当たると、山火事に追い風が吹くように悪化しうる
という比喩だった。
ところが生成画像では、
ステロイドのチューブ + 紫外線 → 燃える森林
という図式が入り、
ステロイドと紫外線の組み合わせ自体が強い悪影響を起こすかのようにも読める表現になってしまった。
さらに、「炎症のある皮膚に」という条件も落ち、
ワセリンに関する説明も断定が強すぎる表現に変わっていた。
したがって、あの画像は、
画風試作の途中で生成されたものであり、医学説明としては誤りを含む
ものである。
ここでの論点はあくまで描画様式と情報配分の問題であり、
医学情報の正確な伝達例として扱ってはならない。
これは、今回の議論にとってむしろ重要な反省でもある。
見せ方を変えるだけのつもりでも、説明内容そのものが変質しうる。
AI画像生成では、スタイル変更と意味保持を同一視してはならない。
プロンプトは「完成した呪文」ではなく、観察と修正の往復である
ここまで述べてきたことを、最後に一つだけ実践的に言い換える。
プロンプトは、一発で完成する呪文ではない。
画像を出す。
見る。
違和感を言語化する。
どこが均質すぎたか、どこに焦点がないか、何が描かれすぎたかを外化する。
それをもとに指示を書き換える。
この往復が必要である。
重要なのは、
「もっと上手く描け」
ではなく、
「どこを上手くし、どこを描きすぎないでほしいか」
を言語化することだ。
AI画像に必要なのは、
「何を描くか」の追加だけではない。
「何を見せるか」の設計である。
上手い画像を作るだけなら、もうかなりできる。
しかし、見ることを設計する画像は、まだ十分には作れていない。
だからこそ、プロンプト論も
「対象記述+品質タグ」から一段深く入らなければならないのである。
参考文献(代表)
Fan, J. E., Hawkins, R. X. D., Wu, M., & Goodman, N. D. (2020). Pragmatic inference and visual abstraction enable contextual flexibility during visual communication.
Fan, J. E. et al. (2023). Drawing as communication.
Huey, H., Lu, H., Walker, N., & Fan, J. E. (2023). Visual explanations prioritize functional properties at the expense of visual fidelity.
Fernando, P., Weiler, J., & Kuznetsov, S. (2019). A Rough Sketch of the Freehand Drawing Process: Blending the Line between Action and Artifact.
Matsumoto, K., & Okada, T. (2021). Viewers Recognize the Process of Creating Artworks With Admiration.
Matsumoto, K., & Okada, T. (2021). Imagining How Lines Were Drawn.
クレヨン風AIイラスト
AIイラストってAIってすぐわかるよな(ドヤ
— ルミたん (@lumitan0) August 23, 2026
みたいな人が多いけど、そりゃ君がAIだって思ったやつしかジャッジが入ってないからでしょ?
というわけでAI感のないAIイラストがこちらになります。
皆AIだってわかりますか?
ボクは先入観なしでは見抜けないです。 pic.twitter.com/t6uk11SmEK
追記――AIは「下手な一枚絵」は描ける。でも「下手な漫画」は難しかった
この記事を書いたあと、もう少し実験してみた。
きっかけは、Xで見かけた一枚の絵だった。
紙に鉛筆で線を引き、色鉛筆かクレヨンで塗ったようなアニメ絵である。
線は揃っていない。
色もきれいに塗り切られていない。
髪の黄色には濃いところと薄いところがあり、輪郭から少し外れている。
人体も、商業イラストのように完全には整っていない。
一見すると、誰かが紙に描いた絵に見える。
ところが投稿者は、これをAI生成だという。
本当にAI生成なのかは、その画像だけからは確認できない。
ならば、こちらでも似たことができるか試してみることにした。
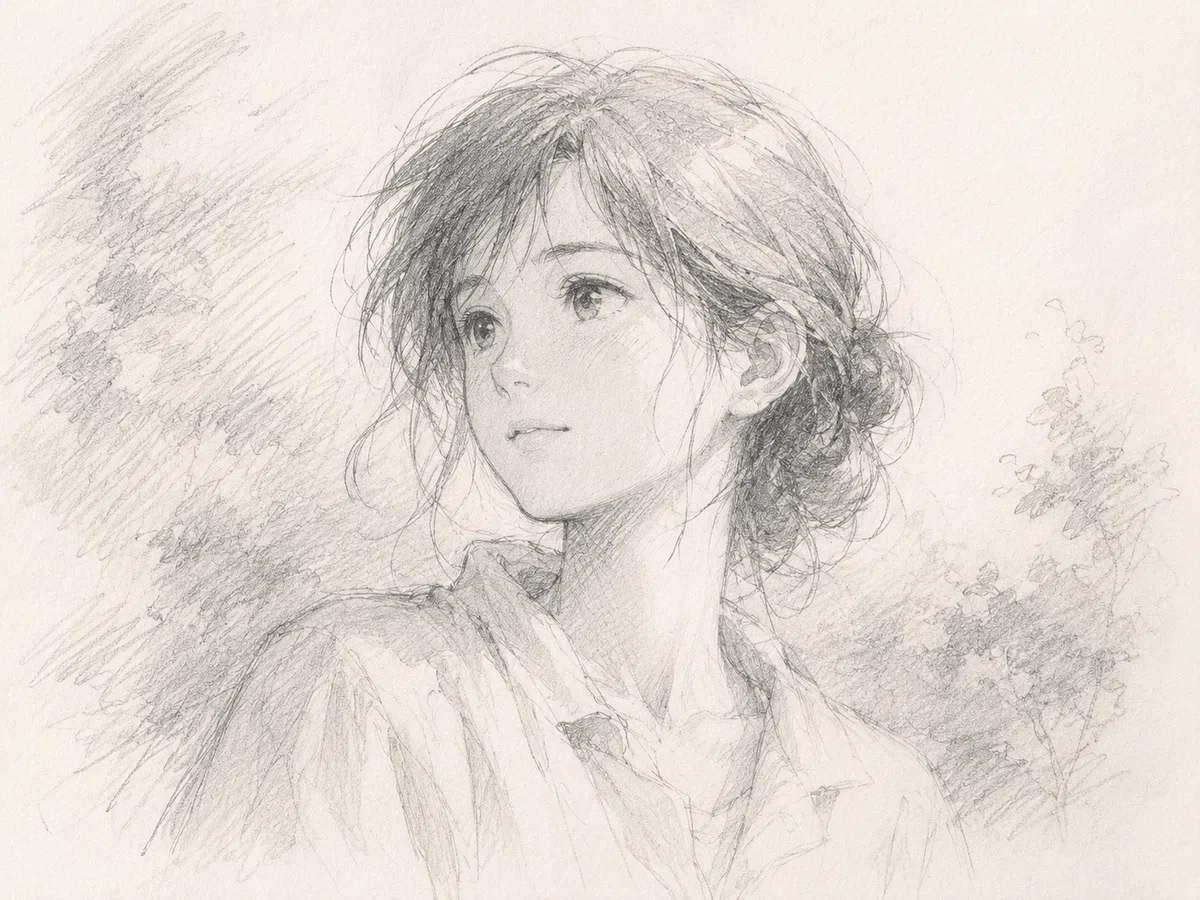
最初は、すでに作ってあった精密な鉛筆画をクレヨン風へ変えてみた。
うまくいかなかった。
クレヨン画になるというより、
きれいな鉛筆画に色が付いた
だけになってしまう。
そこで発想を変えた。
完成した鉛筆画をクレヨン化するのではなく、最初から、
「素人が紙に鉛筆と色鉛筆で描いたアニメ絵」
として生成してみた。
すると、これはできた。
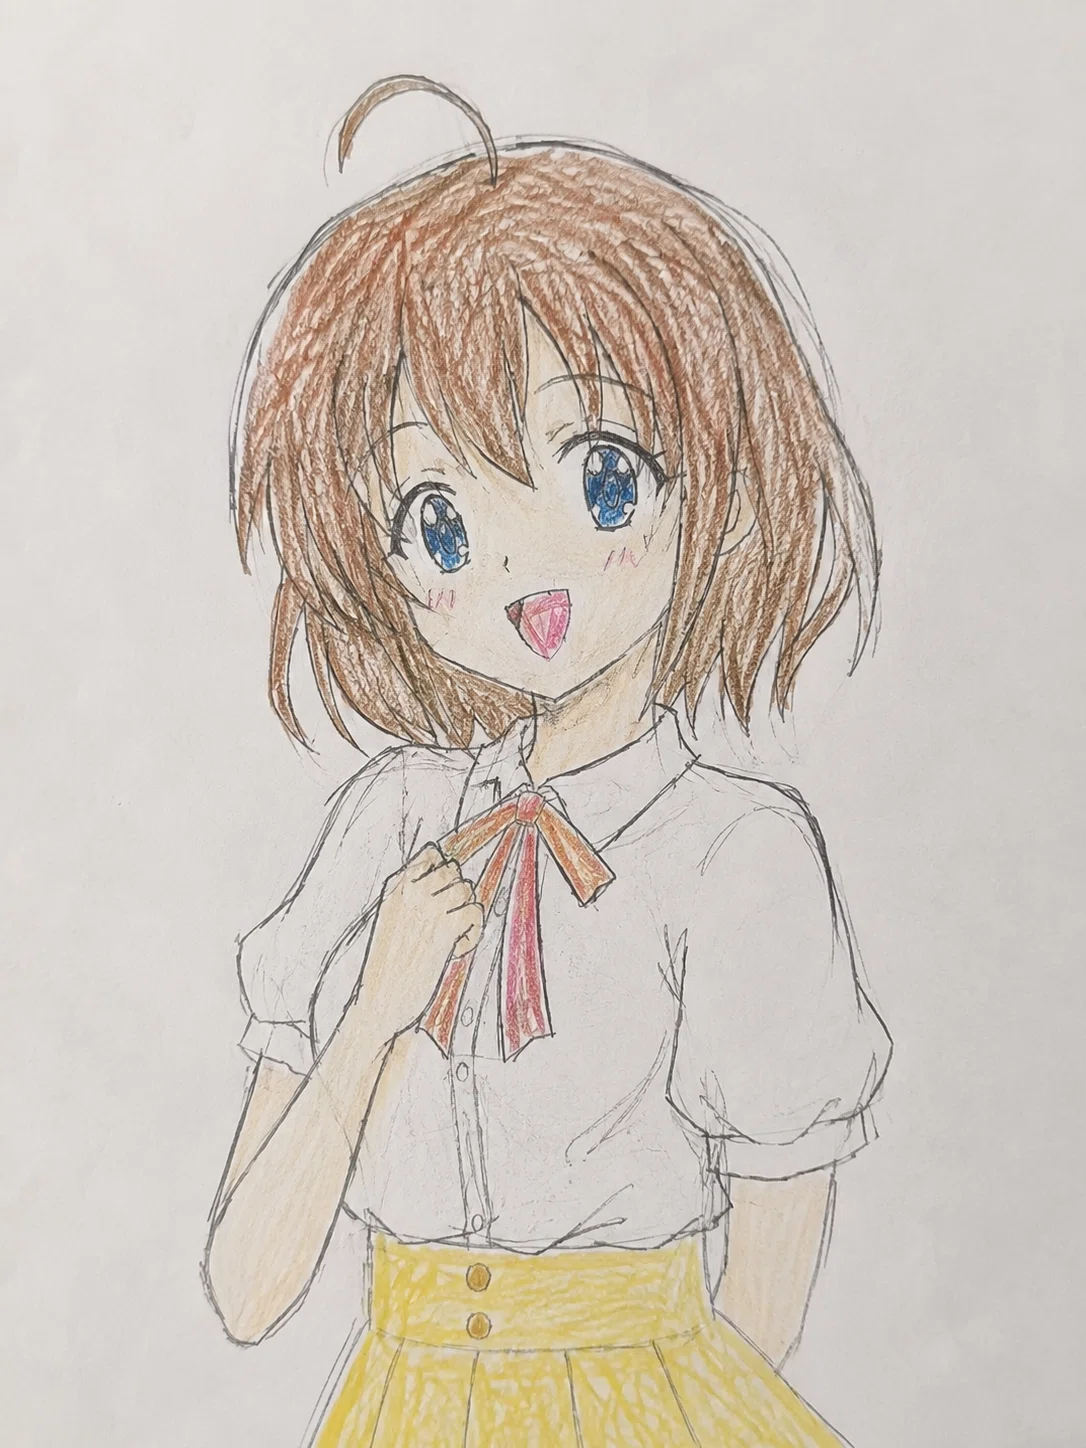
線が少し揺れる。
塗りが均一でない。
紙の白が残る。
顔や身体も、商業イラストほどきれいには整わない。
「ああ、できるじゃないか」となった。
ここで一つ分かった。
「手描き風を作る」という仕事は一種類ではない
すでに出来上がった精密画像を、
精密な構造を維持したまま、別の画材で描いたように変換する
仕事と、
最初から、そういう手描きの結果になる画像を生成する
仕事は違う。
前者では、
元画像の構造を守る
という制約と、
線を崩す、塗りをむらにする、細部を捨てる
という要求が衝突する。
後者では、最初から「少し崩れた絵」を完成状態として作ればよい。
だから、
精密画 → 素人手描き風
は難しくても、
最初から素人手描き風
なら生成できる。
少なくとも今回使った画像生成AIでは、そうなった。
ところが、ここでさらに実験した。
以前作った皮膚科の解説漫画を、今度はその「素人の鉛筆+色鉛筆」の描き方で、最初から作り直してみたのである。
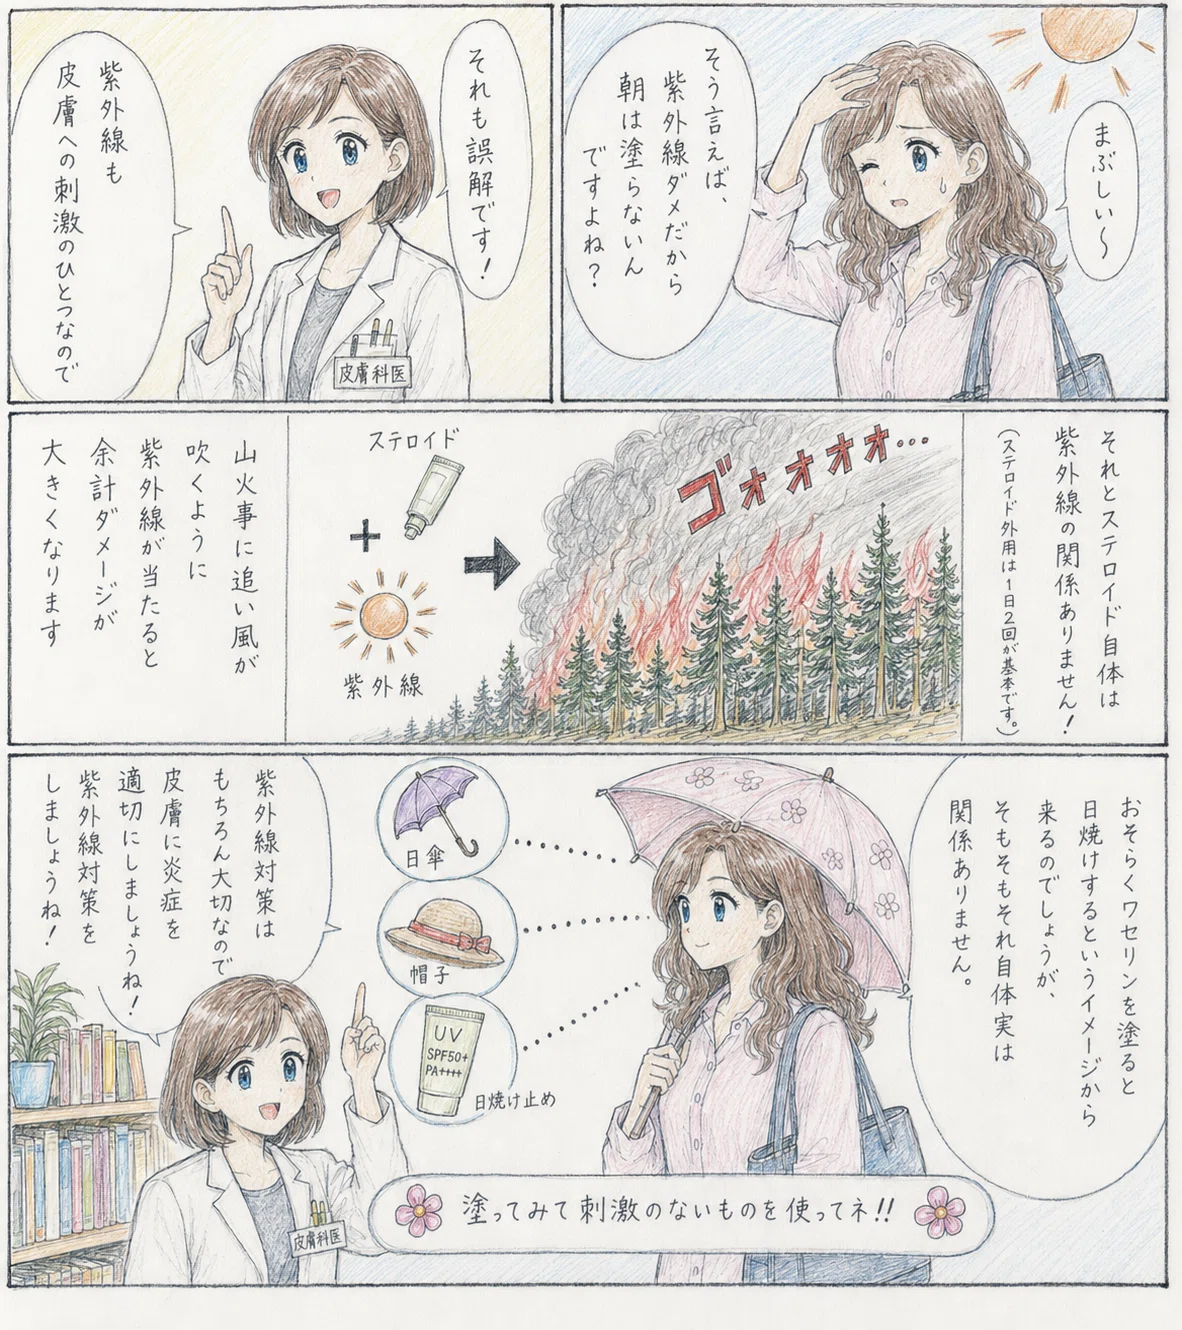
結果は、また妙だった。
ほとんど元の整ったAI漫画へ戻ってしまった。
色鉛筆にはなっている。
紙の感じもある。
しかし、人物はきれいだ。
線もかなり整っている。
コマ全体の完成度も高い。
一枚絵では出せたはずの、
塗り残し、線の迷い、形の崩れ、場所による手数の差
が、漫画になると弱くなった。
なぜだろう。
ここから先は、今回の試行から作った仮説である。
漫画ではAIに要求している仕事が急に増える。
人物を描く。
別の人物と描き分ける。
同じ人物を別コマでも維持する。
表情を変える。
ポーズを変える。
コマを割る。
吹き出しを置く。
日本語を書く。
読む順序を保つ。
山火事という比喩を成立させる。
薬、日傘、帽子、日焼け止めを配置する。
そして医学説明として意味を壊さない。
そのうえで、
「でも、素人が色鉛筆で描いたように、線は少し迷わせ、塗りにはむらを残し、場所によって手数を変え、人体も少し崩してください」
と要求する。
これは一枚絵とは仕事が違う。
AIは一つの画像の中で、多数の条件を同時に満たさなければならない。
すると今回の生成では、
「漫画として破綻しない」
という条件が強く残り、
「意味のある不均一さを残す」
という条件が後ろへ押しやられたように見えた。
ここが面白い。
AIは「下手」を描けないわけではなかった
最初は、
AIは上手すぎるから、人間の下手な絵を描けないのではないか
とも考えた。
これは違った。
一枚絵なら、かなりそれらしい「下手さ」を生成できる。
だから、
AIには疲労がないから、塗りむらは作れない
とも言えない。
人間が疲れて塗り残したという原因がなくても、
塗り残されたように見える結果
をAIは生成できる。
人間が線を迷った経験をしなくても、
迷った線のように見える画像
は作れる。
ここでは、
制作原因と、画像上の痕跡は同じではない
ということになる。
これはAI画像を「見れば分かる」と判断するときにも注意がいる。
塗りむらがある。
線が歪んでいる。
紙に描いたように見える。
だから人間が描いた。
とは、もう簡単には言えない。
AIは、そういう結果を作ることができるからである。
だが、「意味のある下手さ」は別だった
一方、今回の漫画実験では別の問題が見えた。
人間が漫画を描いているときの崩れは、画面全体に均一には起こらない。
顔は頑張って描く。
背景は面倒だから数本の線で済ませる。
重要な手は描き直す。
どうでもいい棚は適当に処理する。
時間がなくなって最後のコマだけ粗くなることもある。
好きなキャラクターだけ妙に描き込むこともある。
つまり人間の「下手さ」や「雑さ」は、
単なるノイズではない。
制作の途中で行われた、
選択
の痕跡である。
何を重要だと思ったか。
何を諦めたか。
どこまでなら伝わると思ったか。
何に時間を使ったか。
それが場所ごとに違う。
だから画面に不均一さができる。
これをAIで再現しようとすると、
全体を「手描き風」にする
だけでは足りない。
それでは単に、画面全体へ同じ種類の手描きテクスチャを載せることになる。
必要なのは、
ここでは崩す。
ここでは崩さない。
ここは描き込む。
ここは途中でやめる。
という、場所ごとに違う判断なのである。
以前この文章で、
ランダムな不完全さを足すな。
目的と制約から生じる不完全さを作れ。
と書いた。
今回、実際にAIへやらせてみて、この意味が少し具体的になった。
「上手い/下手」ではなく、制約の重なりを見る
だから今回の結果を、
AIは素人絵を描ける
AIは漫画だと素人絵を描けない
と一般化するつもりはない。
モデルが変われば結果も変わる。
プロンプトや工程を変えれば、できるかもしれない。
人物、文字、背景を別々に作り、あとから組み合わせれば結果も変わるだろう。
今回分かったのは、もっと限定されたことだ。
単純な一枚絵では再現できた表現が、多数の条件を同時に満たす漫画では維持できなかった。
これは「画風」という言葉だけでは説明しにくい。
画像生成AIには、
「素人の色鉛筆画」
という一つのスタイルを当てれば済む問題と、
「物語、人物同一性、文字、説明内容、構図を保ちながら、場所ごとに異なる省略と崩れを入れる」
問題がある。
後者の方が、少なくとも今回の生成では難しかった。
つまり、
スタイルの再現能力と、複数の意味制約の中でスタイルの不均一性を維持する能力は、同じではない。
ということになる。
そして、これは最初の話へ戻る。
AI画像に感じる違和感を、
「AIには魂がない」
で説明する必要はない。
「AIは絵が上手すぎる」
だけでも足りない。
今回の実験で見えたのは、
AIは「崩れた結果」を生成できる。
しかし、複雑な課題の中で、なぜそこだけ崩れ、なぜここだけ描き込まれたのかという不均一な選択の構造を維持するのは、別の難しさを持つ。
ということだった。
一枚絵を見て、
「ほら、人間の手描きと区別できない」
と言うこともできる。
反対に、
「こんな複雑な漫画ならAIには無理だ」
と言うこともできる。
だが、その二つを同じ問いにしてはいけない。
何を一つ描かせるのか。
いくつの条件を同時に維持させるのか。
どの条件同士が競合しているのか。
ここまで分けてみないと、
「AIに描ける/描けない」は分からない。
そして今回も結局、画像生成AIは答えをくれたというより、
こちらが何を「手描きらしい」と呼んでいたのかを、失敗によって分解してくれた
ことになる。
成功した画像だけでなく、失敗した画像もまた、見るための材料なのである。
AIに絵を頼むときは、「変える・残す・あとで」を分けよう
「この漫画をクレヨン風にして」と頼んだのに、絵柄だけでなく、人物やセリフまで変わってしまう。
そんなときに必要なのは、長い呪文ではありません。何を変えたいのか、何を残したいのかを分けること。そして、出てきた絵を確認することです。
① 最初に「何に使う絵か」を伝える
「SNSに載せる4コマ漫画」「人物のアイコン」「雰囲気を楽しむ一枚絵」など、用途を短く伝えます。
まだ好みが決まっていなければ、**「まず違う描き方を3案見たい」**でも構いません。最初から完成形を決める必要はありません。
② お願いを、三つに分ける
たとえば、漫画をクレヨン風に描き直すなら、こう整理します。
お願い書き方の例変えるところ線を太めに。塗り残しを入れる。背景の細部を減らす。残すところ人物の描き分け、セリフ、説明の意味、コマの順番。あとで決めるところ服の色は仮でよい。背景の色は、あとで案を比べたい。
「ラフに描く」と「まだ決めない」は別です。
きれいに描かれた服でも、「この色はまだ仮」として扱えます。逆に、ラフな線でも「この表情は採用。変えないで」と指定できます。
見本が二枚あるときも、役割を分けます。
1枚目は内容の見本。人物とセリフを残す。
2枚目は描き方の見本。線と塗り方だけ参考にする。
「これみたいに」だけでなく、どこをまねてほしいかを添えるわけです。
③ 「いい感じ」を、目で分かる言葉にする
「手描き風」「生き生きした絵」だけでは、希望する見た目がまだ広すぎます。
たとえば、こう言い換えます。
「クレヨン風」
→ 太めの線。塗りに濃いところと薄いところを作る。紙の白を少し残す。
「背景がうるさい」
→ 背景の小物を減らす。人物の周りに白い余白を取る。
「輪郭がきっちりしすぎ」
→ 頬や肩の線を、途中で薄くしたり途切れさせたりする。
これは、望む見た目を伝えるための例です。線を粗くすれば必ず魅力が増す、という決まりではありません。
言葉にしにくければ、見本の気になる場所を指して、**「ここの線の薄さ」「この塗り残し」**と伝える方法もあります。
④ 出た絵は、「内容」と「好み」を別々に見る
きれいになったかどうかだけで、合格にしない。 ここが大事です。
まず、説明漫画なら、セリフの誤字、人物の取り違え、矢印の向き、説明の意味を確認します。そのあとで、線や塗りが好みに近いかを見ます。
今回の皮膚科漫画でも、画風だけを変えるつもりが、説明を誤らせる図まで追加されました。 画風の試作として見られても、正しい医学説明の画像としては扱えません。
「好きな絵になった」と「内容が正しい」は、別の判定です。
文字が正確にならない場合は、絵だけ生成し、文字は別に入れる方法もあります。
直すときは、まず一か所から
たとえば、
「2コマ目の医師の服だけ白衣にしてください。ほかは変えないでください」
と、修正場所を絞ります。
ただし、「ほかは変えないで」と書いても、守られる保証はありません。直した場所だけでなく、変えるつもりのなかった場所も見直します。 気に入った前の画像は保存しておきます。
そのまま使える、短い頼み方
SNS用の4コマ漫画を描き直してください。
1枚目は内容の見本、2枚目は描き方の見本です。
変える: 太めの線と、塗り残しのあるクレヨン風にする。背景の細部は減らす。
残す: 人物の描き分け、セリフ、説明の意味、コマの順番。
あとで決める: 服や背景の色は仮案にする。
描き方と内容の両方を守るのが難しい場合は、説明の意味と文字の正確さを優先してください。
頼む → 絵を見る → 違うところを一つ直す → もう一度見る。
プロンプトは、合格するための作文試験ではありません。うまくいかなかったとき、依頼者の書き方が悪いとは限りません。伝えたことをAIが実行できていない場合もあるので、指示と結果を見比べる。 そこまで含めて、画像を作る作業です。
石部統久・ChatGPT6Pro
査読:ChatGPT5.6・Claude Opus5・Grok・Gemini3.7(Parcae Protocol)
