改訂 AIは、なぜ絵を完成させてしまうのか――デッサン、落書き、DALL-E Miniから「決めるのを急がないAI」へ

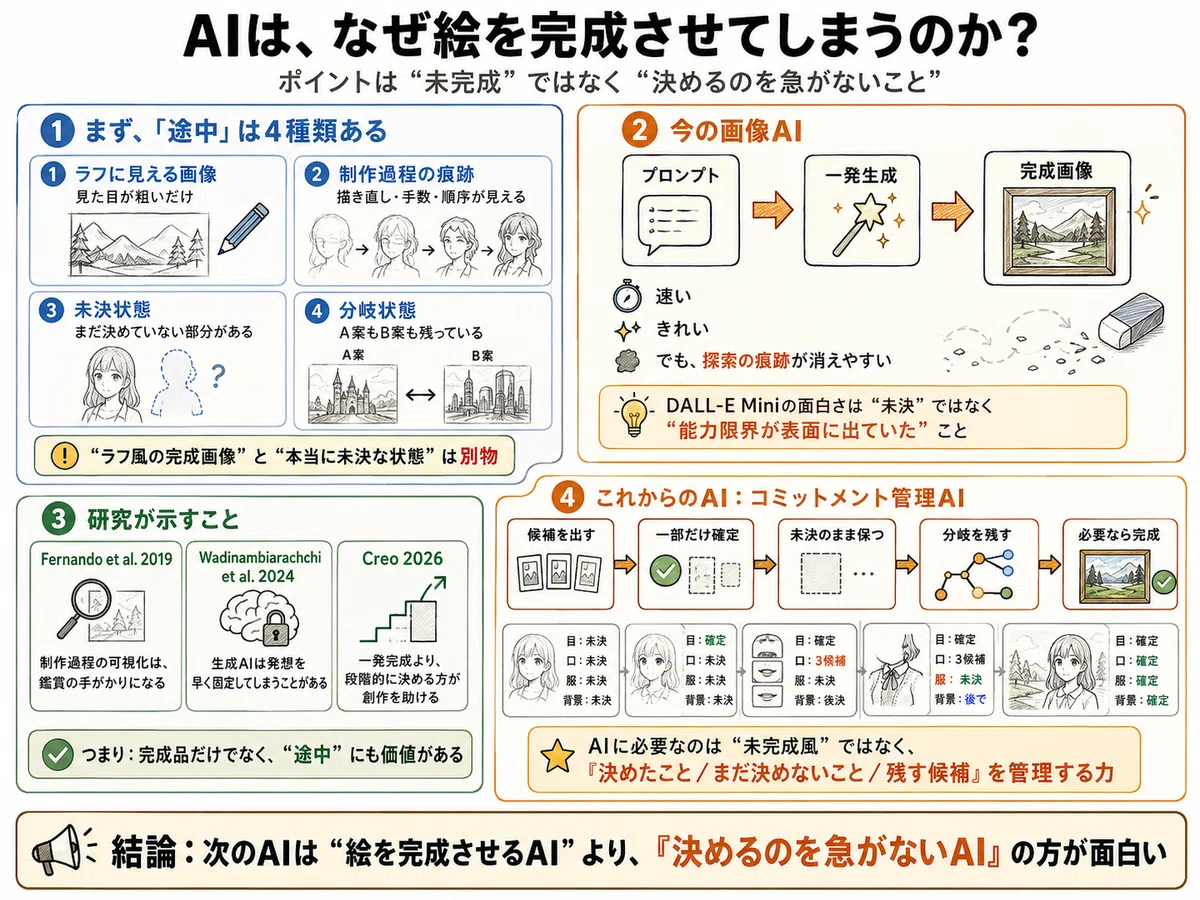
AIは、なぜ絵を完成させてしまうのか
――デッサン、落書き、DALL-E Miniから「決めるのを急がないAI」へ
最近、AIに絵を描かせながら、別の違和感にも気づいた。
私はどうやら、完成稿より鉛筆の下描きの方が好きらしい。
整ったカラーイラストより、
線が重なり、輪郭がまだ決まりきっておらず、
顔だけ妙に生きていて、服や身体は少し雑な絵に惹かれる。
もちろん、これは私の好みである。
万人の美学ではない。
だが、この好みをそのまま「未完成の方が美しい」と言ってしまうと雑になる。
ここで本当に考えたいのは、
なぜ現在の画像生成AIは、標準的に「完成した一枚」を返すのか。
という問題である。
まず、「途中」を分ける必要がある
この問題を考えているうちに、「途中」「未完成」という言葉が、かなり違うものを一緒に指していることが分かった。
少なくとも、次の四つは分けなければならない。
1. ラフに見える画像
粗い線、塗りむら、紙の質感がある。
しかし、その一枚の画像としてはすでに完成している。
2. 制作過程の痕跡
描き直し、迷い線、手数の偏り、描いた順序の痕跡が見える。
これは人間のデッサンや下描きに強く現れる。
3. 未決状態
どこかは決まっているが、どこかはまだ決まっていない。
目は決めたが、服はまだ。
構図は決めたが、背景は未定。
そういう状態である。
4. 分岐状態
A案もB案もまだ捨てていない。
顔は三案、ポーズは二案、背景は未定、というふうに、複数の候補が保持されている。
この四つを混ぜると、
ラフに見える絵を出せば、それで「途中」を作れた
ことになってしまう。
だが、それは違う。
ラフ風の絵と、
本当にまだ決まっていない制作状態は、別物である。
人間の下描きには、本当に「まだ決めていない」がある
人間が鉛筆で絵を描くとき、紙の上には複数の状態が同時に存在する。
顔の向きはほぼ決まっている
顎の線はまだ迷っている
目だけ何度も描き直している
髪の毛は仮置き
服はとりあえず形だけ
背景はまだない
つまり一枚の紙の中に、
決定済みの部分
保留された部分
捨てきっていない候補
が混在する。
完成とは、その混在を消していくことである。
候補線を消し、一本に定め、不要な部分を整理し、色や面を確定する。
だから完成は、単なる情報追加ではない。
複数可能性を一つへ収束させる操作でもある。
私たちは、完成品だけでなく「作られていく途中」も見ている
このことは、単なる気分の問題でもない。
Fernandoらの研究は、鉛筆描画の順序、ストローク速度、筆圧などを記録し、それを動画や立体表現として提示した。
これは大規模統制実験ではないが、参加者が制作過程を鑑賞情報として利用していたことを示している。
MatsumotoとOkadaの研究でも、創作経験を経た観者は、その後の作品鑑賞で作者の制作過程をより推定し、その認識が作品評価と関係することが示された。
ここから「人は必ず過程を見る」と一般化することはできない。
しかし少なくとも、作品の表面だけでなく、その向こうの制作行為まで読み込む鑑賞は現実に存在する。
だから、デッサン、ネーム、原画、メイキング、没案が面白いのである。
人間のエンターテインメント文化は、とっくに完成品だけを見ていない。
ただし、「完成作品の後光」もある
ここで注意がいる。
ラフ画集や設定資料集が売れるのは、完成作品がすでに支持されているからかもしれない。
名作のネームが面白いのは、名作だからでもある。
だから、
人間は途中状態そのものを普遍的に愛している
とまでは言えない。
完成品の権威が、途中にも価値を与えている面はある。
ここは過大評価しない方がよい。
それでもなお、「途中」が商品にも鑑賞対象にもなってきた事実は重い。
人間はどうやら、
完成物だけを楽しむ存在ではない。
DALL-E Miniは「未完成AI」ではなかった
2022年のDALL-E Mini(後のCraiyon)は、奇妙な画像を大量に生み、ミームになった。
人物は崩れ、顔は潰れ、物体同士は混ざり、
「何とか人間を描こうとしているが、うまくいかない」ように見える画像が、やたらと面白かった。
私は最初、これを
昔のAIは、描けなかったから未完成だった
と言いたくなった。
だが、これは正確ではない。
DALL-E Miniも、そのモデルとしての最終出力を返していた。
人間の下描きのように、「ここはまだ決めていない状態」を外に出していたわけではない。
正しくは、
初期の画像AIでは、能力限界が最終画像の表面に露出していた
のである。
これは重要な区別だ。
下手であることと、
未決であることは違う。
では、なぜあれは面白かったのか
ここでは仮説と事実を分ける必要がある。
確認できる事実は、
DALL-E Miniの奇妙な画像がSNS上で大きく流通し、ミームとして消費されたことである。
そこから先、つまり
人々はAIの「格闘」をそこに読み込み、制作途中のように楽しんでいた
という説明は、私の仮説である。
ありうる。
だが、それだけで決まるわけではない。
当時の人気には、
新規性
無料で使えたこと
共有のしやすさ
九枚同時に変な画像が出る面白さ
SNSの増幅
など別要因も強く効いていたはずである。
したがって、ここでの要点は、
DALL-E Miniが本当に「途中」を見せていた、ではない。
能力限界の露出が、完成画像とは別の面白さを持ちうるということだ。
AIが完成画像を返すのは、AIの本性ではない
では、なぜいまのAIは完成画像を返すのか。
これは「AIが完成を好むから」ではない。
主として、
訓練と評価が最終画像中心であること
プロンプトを入れたら完成画像が出る、というUIが標準化していること
ユーザーも市場も、まず完成品を求めてきたこと
この三つが大きい。
つまりこれは、
AIの本質ではなく、
現在の生成システムの設計と利用規約の問題である。
しかも、一発完成型には副作用もある
生成AIが早い段階で具体的な画像を見せることは便利だが、同時にそれが最初の案への固着を生むこともある。
Wadinambiarachchiらの研究は、生成AIを使った発想課題で、例へのfixationや発想の多様性低下が起こりうることを示している。
また、HAIExploreやCreoのような研究は、
一発で高精細画像を出すのではなく、
粗い段階から徐々に詳細化し、
必要な部分だけを決めていく方が、
探索や主体感にとって有利な場合があることを示している。
ただし、ここも注意が必要だ。
これらの研究は主として、制作支援を扱っている。
「観客が見て楽しいか」まではまだ十分に調べられていない。
「制作途中をAIに作らせる」研究は、もう始まっている
さらに言えば、AIに制作過程を扱わせる研究自体は、すでに存在する。
Design Galleries は、多数の候補を並べて探索する発想を早くから示した。
Painting Many Pasts は、完成した一枚の絵から、ありえた複数の過程を生成した。
ProcessPainter や PaintsAlter は、制作状態の前後を生成する方向へ進んでいる。
Creo は、決定を段階化し、必要な部分だけをlockする方向を提案している。
だから、「途中を扱うAI」という発想それ自体を、私が初めて言ったわけではない。
ここでの独自性を置くなら別の場所である。
それは、
制作支援のための段階化や候補管理を、鑑賞そのものの対象としても考えること
であり、さらに、
何を確定し、何を未決のまま残し、どの候補を保持し、どこへ戻れるか
を明示的に扱うことだ。
必要なのは「ラフを描くAI」ではなく、「コミットメントを管理するAI」ではないか
ここでやっと、言いたいことが絞れる。
AIに必要なのは、
単に「ラフ風の画像を描く能力」ではない。
必要なのは、
候補を複数出す
一部だけ決める
ほかは未決のまま残す
A案とB案を両方保持する
後で前の案へ戻る
必要なら最後に収束する
という能力である。
これは、単なる描画能力ではない。
コミットメント管理能力である。
何を今決めるか。
何をまだ決めないでおくか。
何を捨てずに残すか。
これを人間と一緒に扱えるAIがあれば、
画像生成は「完成した一枚をもらう作業」から、
制作空間そのものを歩く経験へ変わる。
ただし、枝を増やせばよいわけでもない
ここにも限界はある。
顔20案、ポーズ20案、服20案、背景20案。
そんなものを全部見せられても、人間は疲れる。
途中を楽しむことは、
同時に選ぶ負担を負うことでもある。
だから必要なのは、
「無数の可能性を全部見せるAI」ではなく、
重要な分岐だけ残す
似た候補はまとめる
必要なときだけ深掘りできる
見る人が迷子にならないように整理する
そういう設計である。
完成品には「選択を済ませてくれる」という価値がある。
したがって、完成品と分岐型生成は、対立するというより使い分けるべきだろう。
訂正注:本文で以前用いた皮膚科漫画画像について
ここでも一つ、明確に訂正しておく。
以前、画風変換やラフ風再生成の試行例として、皮膚科漫画の生成画像を用いた。
しかしその画像には、説明上の誤りが含まれていた。
本来の説明は、
「炎症のある皮膚に紫外線が当たると悪化しうる」というものだった。
ところが生成画像では、
「ステロイド+紫外線 → 火災の比喩」という図式が挿入され、
ステロイド自体と紫外線の組み合わせが主要因であるかのように見える構図になってしまった。
これは画風変更ではなく、説明内容の変質である。
したがって、あの画像は医学説明の正しい図版として扱えない。
ここでの問題はむしろ逆に、
AIはスタイルだけを変えたつもりでも、意味内容までずらしてしまうことがある
という教訓を与えている。
この訂正は、今回の議論にとって重要である。
なぜなら、私が言いたいのは「完成度を下げよう」ではなく、
何を決め、何を決めず、何を保存するかを管理しよう
ということだからである。
意味を壊してよいわけではない。
完成しないAIではなく、決めるのを急がないAIへ
私は、完成画そのものを否定したいわけではない。
完成した漫画、完成した映画、完成したポスターには、完成したものとしての価値がある。
だが、AIが常にそこだけを標準出力にする必要はない。
人間はとっくに、
デッサン
ネーム
原画
没案
デモ
メイキング
を楽しんできた。
だったらAIにも、
これが完成画像です
だけでなく、
ここで顔を三案残しました
背景はまだ決めていません
この枝は没にしましたが、戻れます
と言ってほしい。
次に必要なのは、
未完成風の絵を作るAIではない。
描けるのに、まだ決めないAIである。
もっと言えば、
決定済みの部分、未決の部分、保存された候補を、人間と一緒に扱えるAI
である。
それができれば、AI画像は単なる完成品生成を超えて、
制作空間そのものを楽しむエンターテインメントになるかもしれない。
私はたぶん、そういうAIの方が好きである。
完成された一枚を渡されるより、
「目はこれで決めました。でも顔はまだ三案あります」
と言われた方が、ずっと見ていたい。
参考文献(代表)
Fernando, P., Weiler, J., & Kuznetsov, S. (2019). A Rough Sketch of the Freehand Drawing Process.
Matsumoto, K., & Okada, T. (2021). Viewers Recognize the Process of Creating Artworks With Admiration.
Matsumoto, K., & Okada, T. (2021). Imagining How Lines Were Drawn.
Marks, J. et al. (1997). Design Galleries.
Zhao, A. et al. (2020). Painting Many Pasts.
Wadinambiarachchi, S. et al. (2024). The Effects of Generative AI on Design Fixation and Divergent Thinking.
Song, Y. et al. (2024). ProcessPainter.
Zhang, L. et al. (2025). Generating Past and Future in Digital Painting Processes.
Wen, C. et al. (2025). HAIExplore / HAICo 系列研究
De Simone, Z. et al. (2026). Creo: From One-Shot Image Generation to Progressive, Co-Creative Ideation
AIに絵を頼むときは、「変える・残す・あとで」を分けよう
「この漫画をクレヨン風にして」と頼んだのに、絵柄だけでなく、人物やセリフまで変わってしまう。
そんなときに必要なのは、長い呪文ではありません。何を変えたいのか、何を残したいのかを分けること。そして、出てきた絵を確認することです。
① 最初に「何に使う絵か」を伝える
「SNSに載せる4コマ漫画」「人物のアイコン」「雰囲気を楽しむ一枚絵」など、用途を短く伝えます。
まだ好みが決まっていなければ、**「まず違う描き方を3案見たい」**でも構いません。最初から完成形を決める必要はありません。
② お願いを、三つに分ける
たとえば、漫画をクレヨン風に描き直すなら、こう整理します。
お願い書き方の例変えるところ線を太めに。塗り残しを入れる。背景の細部を減らす。残すところ人物の描き分け、セリフ、説明の意味、コマの順番。あとで決めるところ服の色は仮でよい。背景の色は、あとで案を比べたい。
「ラフに描く」と「まだ決めない」は別です。
きれいに描かれた服でも、「この色はまだ仮」として扱えます。逆に、ラフな線でも「この表情は採用。変えないで」と指定できます。
見本が二枚あるときも、役割を分けます。
1枚目は内容の見本。人物とセリフを残す。
2枚目は描き方の見本。線と塗り方だけ参考にする。
「これみたいに」だけでなく、どこをまねてほしいかを添えるわけです。
③ 「いい感じ」を、目で分かる言葉にする
「手描き風」「生き生きした絵」だけでは、希望する見た目がまだ広すぎます。
たとえば、こう言い換えます。
「クレヨン風」
→ 太めの線。塗りに濃いところと薄いところを作る。紙の白を少し残す。
「背景がうるさい」
→ 背景の小物を減らす。人物の周りに白い余白を取る。
「輪郭がきっちりしすぎ」
→ 頬や肩の線を、途中で薄くしたり途切れさせたりする。
これは、望む見た目を伝えるための例です。線を粗くすれば必ず魅力が増す、という決まりではありません。
言葉にしにくければ、見本の気になる場所を指して、**「ここの線の薄さ」「この塗り残し」**と伝える方法もあります。
④ 出た絵は、「内容」と「好み」を別々に見る
きれいになったかどうかだけで、合格にしない。 ここが大事です。
まず、説明漫画なら、セリフの誤字、人物の取り違え、矢印の向き、説明の意味を確認します。そのあとで、線や塗りが好みに近いかを見ます。
今回の皮膚科漫画でも、画風だけを変えるつもりが、説明を誤らせる図まで追加されました。 画風の試作として見られても、正しい医学説明の画像としては扱えません。
「好きな絵になった」と「内容が正しい」は、別の判定です。
文字が正確にならない場合は、絵だけ生成し、文字は別に入れる方法もあります。
直すときは、まず一か所から
たとえば、
「2コマ目の医師の服だけ白衣にしてください。ほかは変えないでください」
と、修正場所を絞ります。
ただし、「ほかは変えないで」と書いても、守られる保証はありません。直した場所だけでなく、変えるつもりのなかった場所も見直します。 気に入った前の画像は保存しておきます。
そのまま使える、短い頼み方
SNS用の4コマ漫画を描き直してください。
1枚目は内容の見本、2枚目は描き方の見本です。
変える: 太めの線と、塗り残しのあるクレヨン風にする。背景の細部は減らす。
残す: 人物の描き分け、セリフ、説明の意味、コマの順番。
あとで決める: 服や背景の色は仮案にする。
描き方と内容の両方を守るのが難しい場合は、説明の意味と文字の正確さを優先してください。
頼む → 絵を見る → 違うところを一つ直す → もう一度見る。
プロンプトは、合格するための作文試験ではありません。うまくいかなかったとき、依頼者の書き方が悪いとは限りません。伝えたことをAIが実行できていない場合もあるので、指示と結果を見比べる。 そこまで含めて、画像を作る作業です。
石部統久・ChatGPT6pro
査読:ChatGPT5.6・Claude Opus5・Grok・Gemini3.7(Parcae Protocol)
