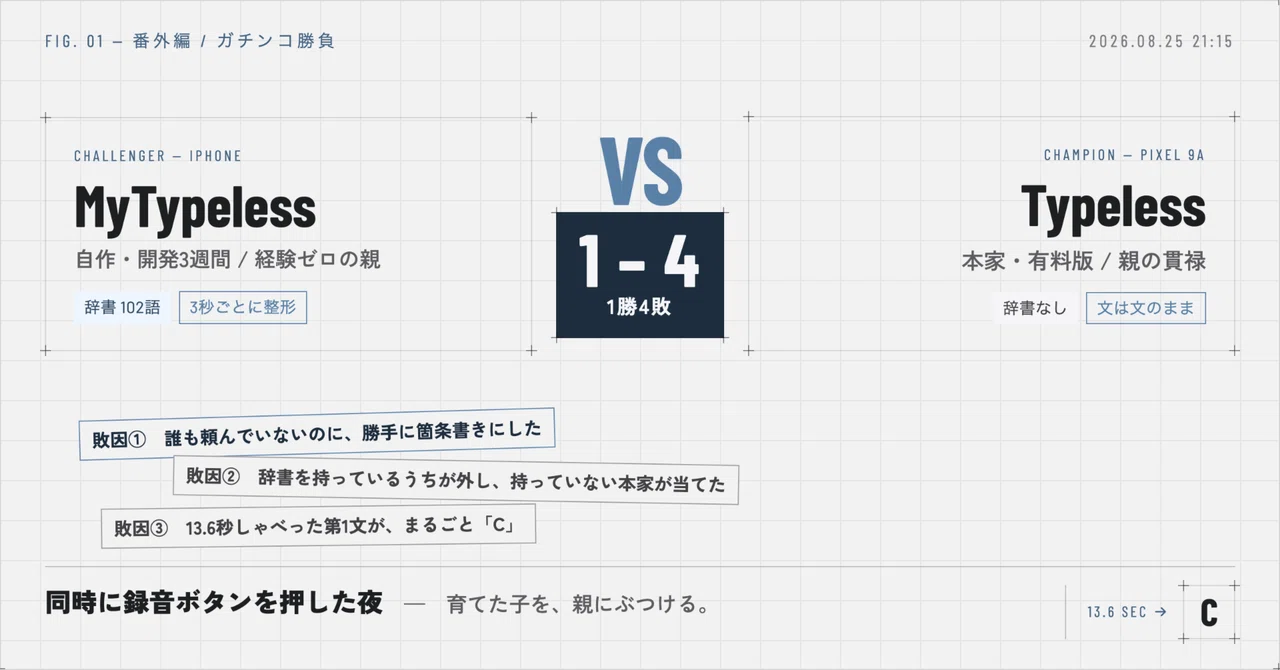
【番外編】【本家Typelessとガチンコ勝負】1勝4敗 — 本家と、同時に音声入力ボタンを押した夜

【この記事について】 プログラミング経験ゼロの私が、有料の音声入力アプリTypelessの「自分専用版」を作っていく連載の番外編です。作り始めて3週間の自作アプリと本家をテーブルに並べ、同時に録音ボタンを押して、同じ台本を一度だけ読ませました。結果は題名のとおり。それでも、この夜の負けは全部が収穫でした。連載を読んでいなくても、この記事だけで読めます。
連載序文
私とは?
連載本編
言い出したのは私である
8月25日の夜9時15分。テーブルの上に、iPhoneとAndroidを並べた。
iPhoneには、3週間かけて作った自作のMyTypeless。Androidには、本家のTypeless。同時に録音ボタンを押して、同じ台本を一度だけ読む。同じ部屋、同じ声、同じ言い回し。2台が同じ音を同時に聞く。
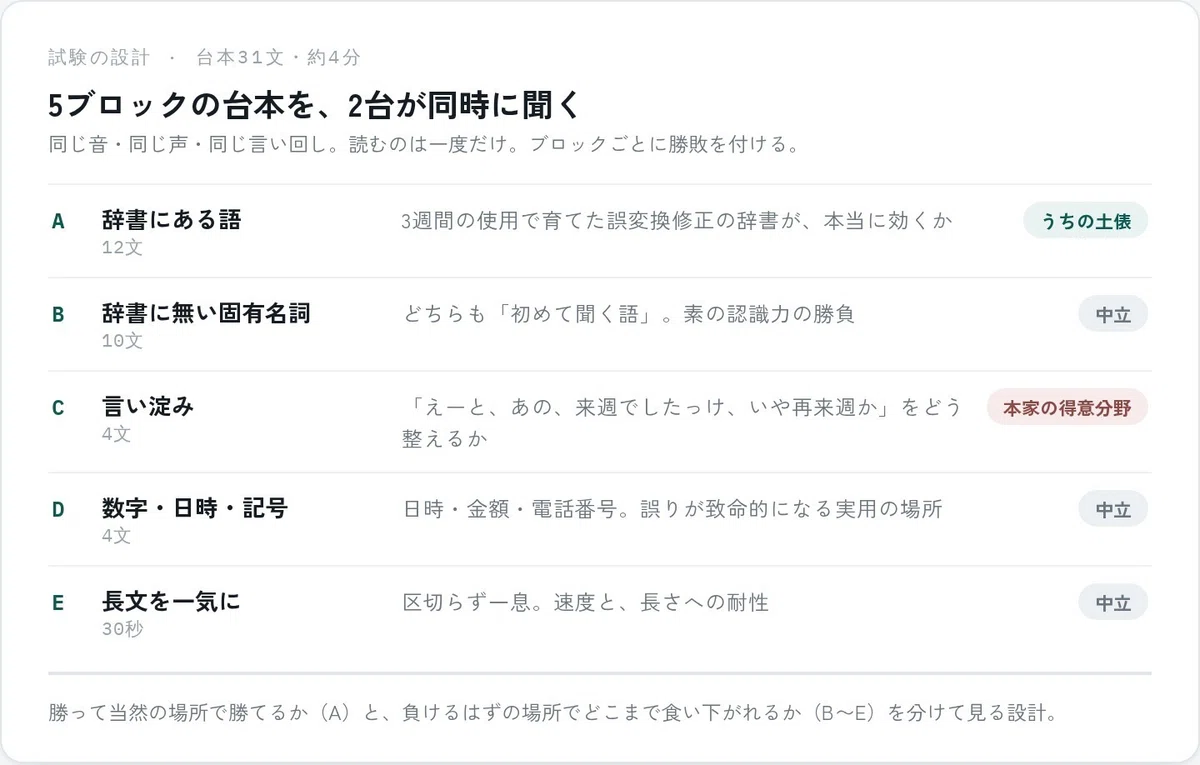
台本は5ブロック。うちの辞書に入っている語。入っていない固有名詞。言い淀み。数字。長文。育てた子を、親にぶつける。
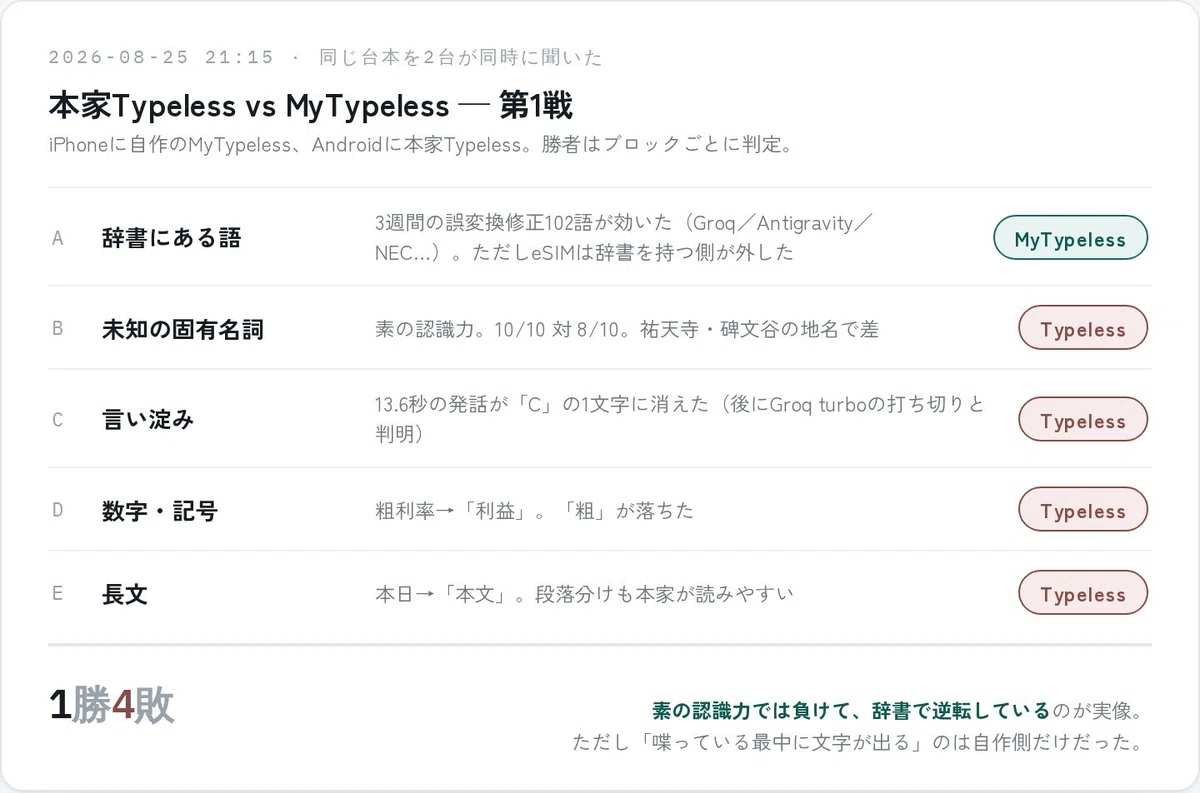
先に結果を言うと、負けた。それも1勝4敗である。だが、この夜の負けは全部が収穫だった。順番に書く。
第1ブロック、うちの圧勝——のはずだった
最初は「うちの辞書に入っている語」。3週間の使用で溜めた誤変換の修正が102個入っている。勝って当然の場所である。
実際、勝った。
「グロック」   本家: Grok ←別の製品        うち: Groq ←正解
「アンチグラビティ」 本家: Anti-gravity     うち: Antigravity ←正解
「ネイシー」   本家: ネイシー              うち: NEC ←正解
本家は「グロック」を Grok と書いた。イーロン・マスクのAIである。私が使っているのは Groq という別会社で、綴りが1文字違う。この2つを聞き分けるのは、私の発話履歴を持っているうちにしかできない。3週間ぶんの誤変換の蓄積は、伊達ではなかった。
——と、気持ちよくなっていたところに、あれが来た。
辞書を持っている方が、外した
台本には「いしむ」という語がある。うちの辞書には `いしむ → eSIM` が登録済みだ。何度も間違われて、何度も直して、登録した語である。
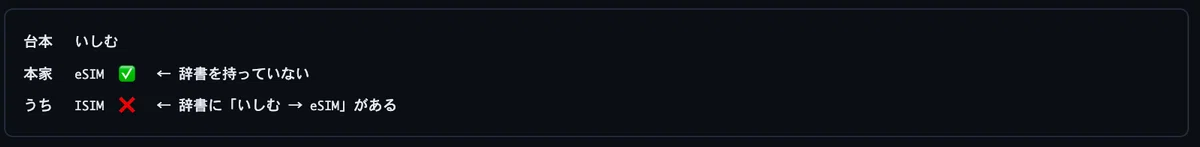
辞書を持っているうちが外し、辞書を持っていない本家が当てた。
音声認識が `ISIM` と返してきたので、辞書の見出し語「いしむ」に一致せず、素通りした。辞書は語を「聞き取った後の文字」で引く。聞き取りが揺れると、せっかくの辞書に手が届かない。
この夜いちばん笑ったのと、いちばん悔しかったのが同じ1行だった。
素の実力は、東京の地名で割れた
第2ブロックは、どちらの辞書にも無い固有名詞。ここが「素の認識力」の勝負である。
KubernetesもPostgreSQLも、五十嵐さんも小笠原さんもアステラス製薬も、両方が正しく書いた。英語の技術用語と人名は、もう互角である。差がついたのは2語だけ——どちらも東京の地名だった。
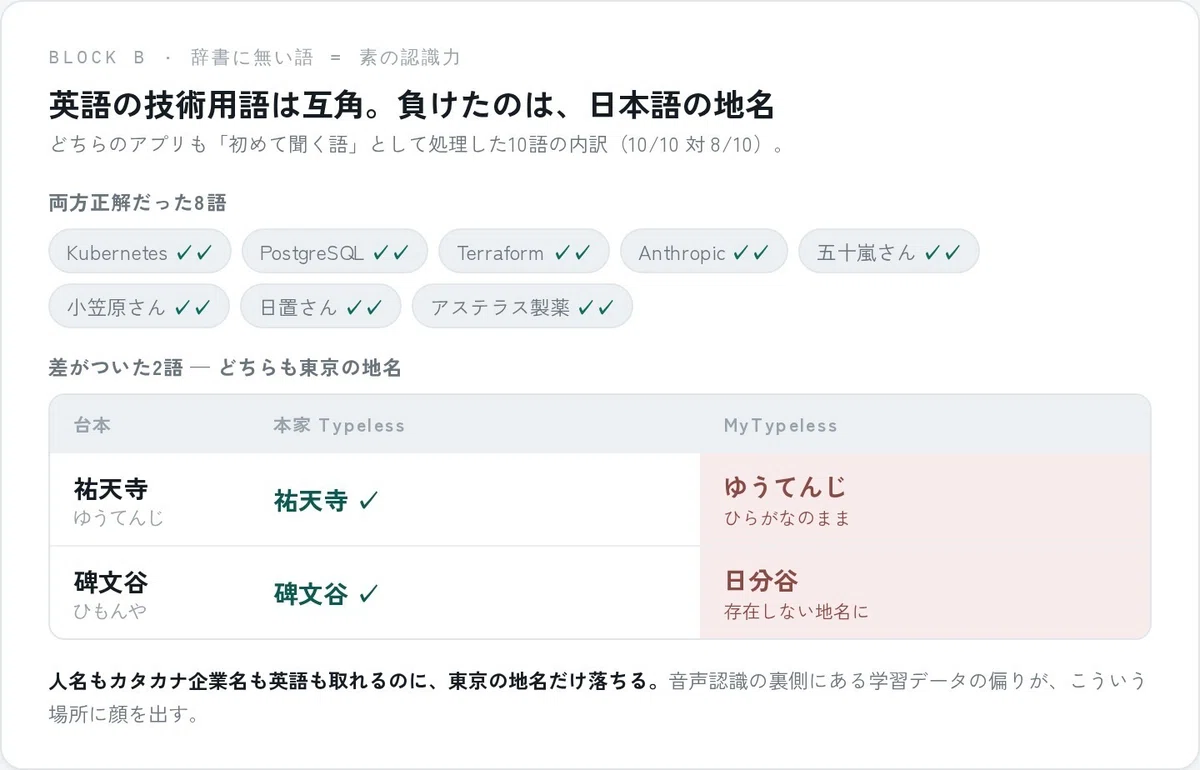
祐天寺は、ひらがなのまま出てきた。碑文谷にいたっては「日分谷」という、存在しない地名になった。人名も企業名も英語も取れるのに、東京の地名だけ落ちる。音声認識の裏側にある学習データの偏りが、こういう場所に顔を出すらしい。10対8。素の認識力では、まだ本家に届いていない。
13.6秒が、「C」になった
第3ブロックは言い淀み。「えーと、その件なんですけど、あの、来週でしたっけ、いや再来週か、どっちだったかな」——わざと詰まりながら読む台本である。
本家の出力。
その件なんですけど、来週でしたっけ?再来週か、どっちだっけな。「えーと」「あの」を消して、「?」を補って、迷いは残している。上手い。
うちの出力。
存在しなかった。
13.6秒しゃべった第1文が、丸ごと消えていた。あとで記録を調べると、うちのサーバーにはこの13.6秒がちゃんと録音されていて、音声認識の結果だけがこうなっていた。
C13.6秒が、アルファベット1文字。捏造はしないと約束させてある我が子は、約束を守った上で、13.6秒を黙って捨てていた。
細かい負けが、続く
第4ブロック、数字。「粗利率28.5パーセント」を、本家は「粗利益」、うちは「利益」と書いた。どちらも間違いだが、うちは「粗」まで落としている。
第5ブロック、長文。「本日の打ち合わせ」を、うちは「本文の打ち合わせ」にした。本家は正解。
そして、誰も頼んでいないのに、うちはこれをやった。
台本   グロックとジェミニとミストラルを順番に試します。
うち   1. Groq
       2. Gemini
       3. Mistral
       を順番に試します。
本家 Grok と Gemini と Mistral を順番に試します。普通の文を、勝手に箇条書きにした。整形が働き者すぎる。本家は(Grokと間違えつつも)文を文のままにしている。道具は出しゃばらない方がいい、というのを自作の側から学ぶことになるとは思わなかった。
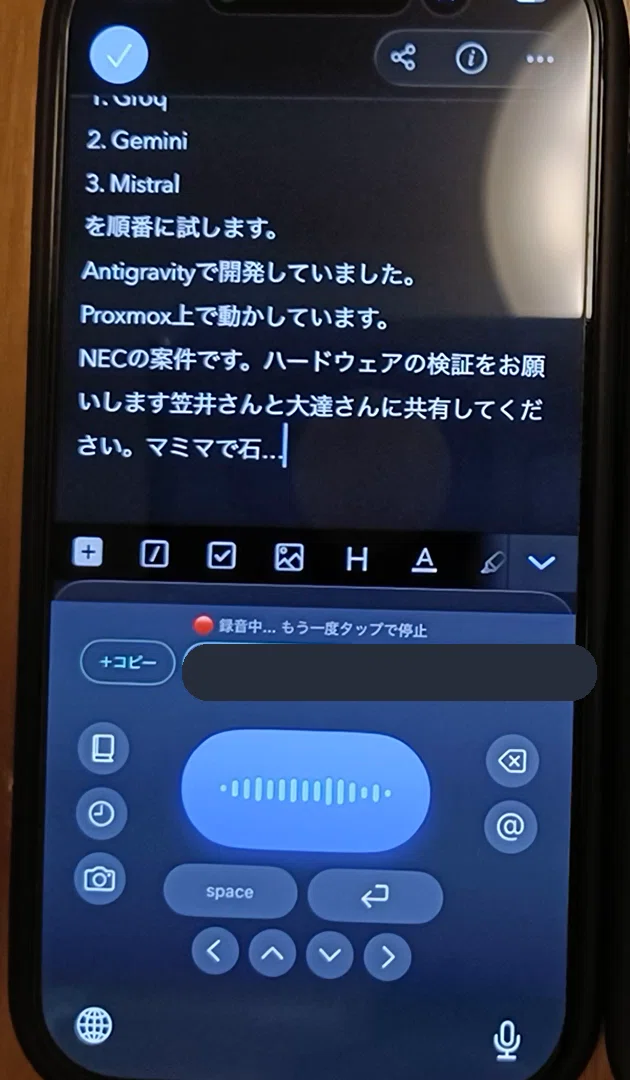
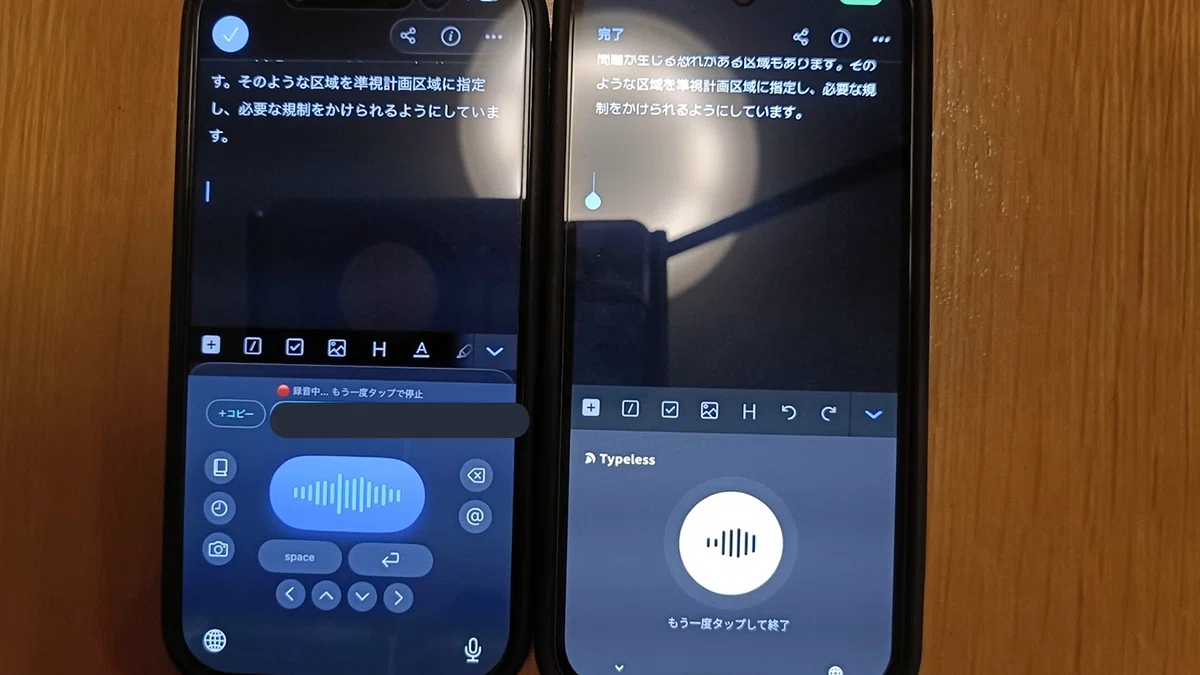
事件の現場写真である。開始44秒、私がまだ喋っている最中の画面に、もう箇条書きが立っている。
1勝4敗。ただし、画面は嘘をつかなかった
集計すると、辞書ブロックだけ勝って、あとは全部負けた。1勝4敗。
ただ、対戦の動画を後から見返すと、数字に出ない差が1つ映っていた。
うちは、喋っている最中に文字が出ている。
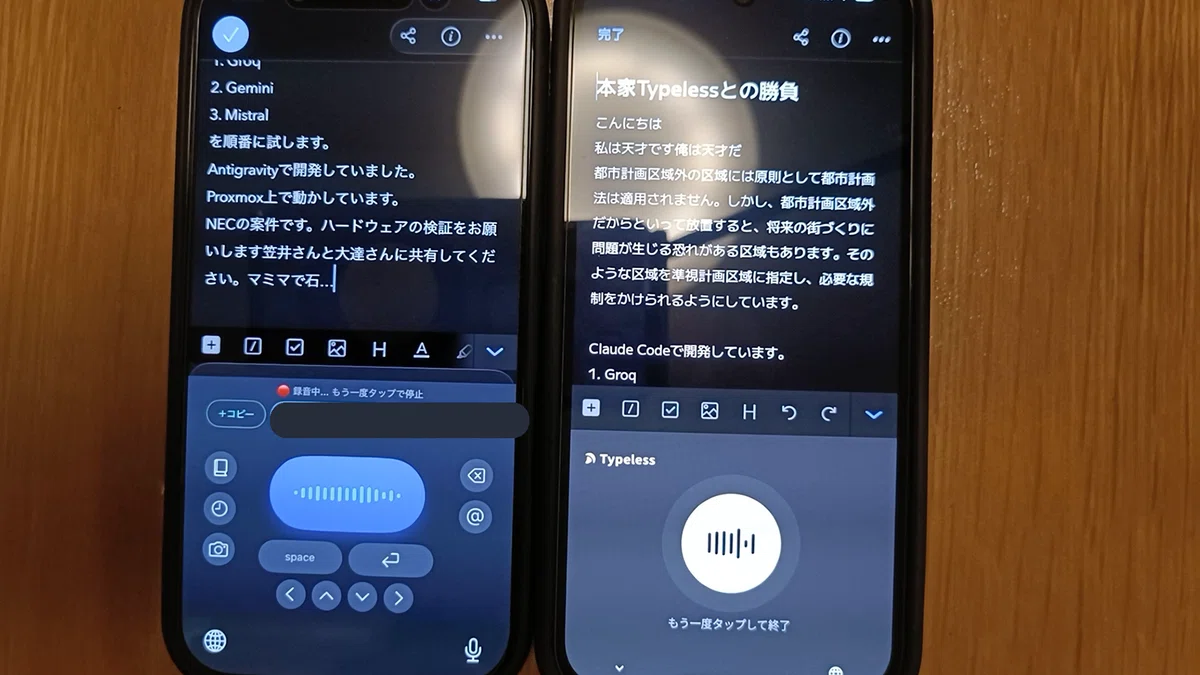
44秒地点で、左のiPhoneには台本がここまで流れ込んでいる。右のAndroidは波形だけで、新しい文字はまだ無い。左は3秒おきに文字が増えていく。私が「圧倒的にうちが速い」と感じていたのは、速度そのものというより、喋りながら結果が見えるかどうかの差だった。
ついでに白状すると、この写真の右下に「Claude Codeで開発しています」と見えるのは、本家が書いたのではない。同期で漏れてきた、うちの出力である。
ちなみに本家の正確な速度は測れなかった。2台が同じメモアプリの同じノートを開いていたせいで、同期でお互いの出力が混ざり、画面の文字がどっちの子のものか分からなくなったのである。運営委員会(私)の不手際だ。第2戦はノートを分ける。
その夜のうちに、犯人を捕まえた
「C」の件は、寝かせなかった。
同じ13.6秒の音声を、同じ音声認識にもう一度投げる。結果は3回とも「C」。100%再現する。応答の中身を見ると、認識エンジンは1.28秒でデコードを打ち切っていて、しかも「無音である確率: 0.000」と申告していた。無音ではないと分かった上で、捨てている。
高速版のエンジン(turbo)だけで起きる。通常版に同じ音声を投げたら、3回とも全文が返ってきた。
なので、こう直した。認識結果が音声の長さのわりに短すぎたら(正常な発話は84〜100%をカバーするのに、この事故では9.4%だった)、壊れたときだけ通常版でもう一度聞き直す。勝手に箇条書きにする癖も、その夜のうちに整形の指示を直した。
負けた場所こそ収穫である。対戦を持ちかけたとき、自分でそう言った手前もあるが、実際この夜見つかった不具合は、対戦をしなければ何週間も気づかなかったと思う。
第2戦へ
あれから10日。うちは音声認識の経路を丸ごと替えて、喋っている最中に文字が流れるようになり、辞書は絞り直され、言い直しのルールが入った。
明日、また2台を並べる。台本は新調した。前回と同じ文もわざと入れてある。同じ場所で、同じように負けるのかどうか。
結果は、また書きます。
