最新モデルのGPT-Image2.0の進化とは【GPT-Image 2.0】

どうも!のばぺんです
2026年4月にアップデートされた「GPT-image 2.0」について解説していきます!
今回のアップデートは、特に性能面で大きな変化が起こりました↓↓↓
Exciting news - GPT-Image-2 by @OpenAI has claimed the #1 spot across all Image Arena leaderboards!
— Arena.ai (@arena) April 21, 2026
A clean sweep with a record-breaking +242 point lead in Text-to-Image - the largest gap we’ve seen to date.
- #1 Text-to-Image (1512), +242 over #2 (Nano-banana-2 with web-search… https://t.co/YYKjhgjhsn pic.twitter.com/IBN9a1RIJ4
「Nano Bananaを超えたのでは?」という声も出ていましたが、Arena.aiの検証を見る限り、本当に性能面で上回っていることは確認できました
ちなみに、OpenAIもこのArena.aiの投稿をリポストしています
少し前まで、画像生成といえば「Nano Bananaが強いよね」という空気があったんですけど、GPT-image 2.0がちゃんと性能で一気に上回った形になります
あと、GPT-image 2.0には画像生成時に検索機能が動く仕組みもありますが
これは、例えば歴史解説をインフォグラフィックスとして表現したい場合、単にユーザーの指示文だけを見て画像を作るのではなく、ネット上から関連情報を探して、内容を踏まえたうえで画像を生成できるようになりました
Nano Banana 2にも、これに近い機能はありましたが、今後の画像生成では、ユーザーの指示をそのまま受け取って描くだけではなく、必要に応じて自分で情報を集めてから生成する流れが当たり前になっていきそうです
というか、もう画像生成というより「調べて、整理して、絵にする」まで含めた機能になってきていますね
GPT Images 2.0の凄さは、「絵が上手くなった」ことではない
あらためて、2026年4月にOpenAIは「ChatGPT Images 2.0」を公開しました
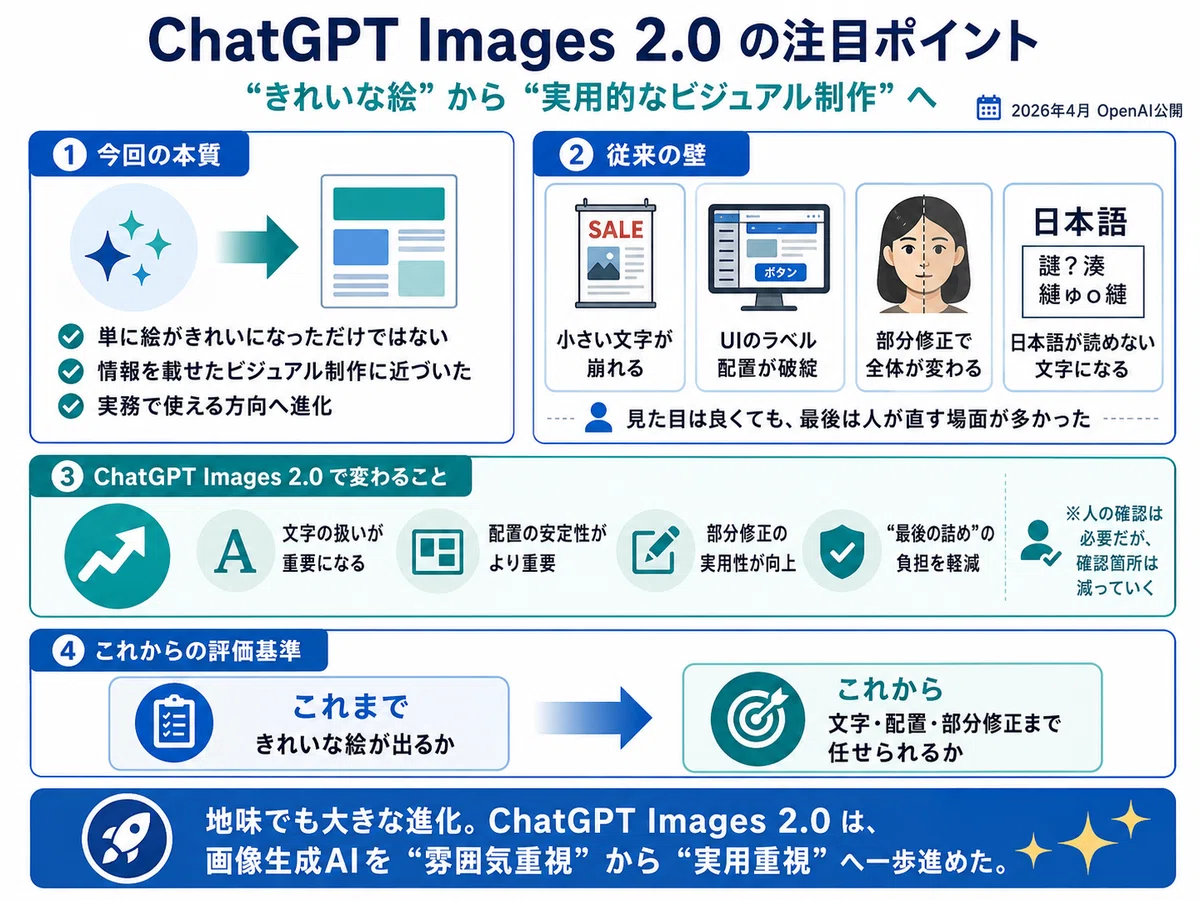
今回のアップデートは、「前のverよりも、きれいな絵が出せるようになりました」という話ではありません
なんというか、見た目の派手さで殴る段階から、一段進んだ感じがあります
派手な絵が作れるのはもちろん大事なんですけど、それだけでは済まなくなってきたというか
個人的には、画像生成AIが「雰囲気の良い絵を作る道具」から、「情報をちゃんと載せたビジュアルを組み立てる道具」に近づき始めたアップデートだと思っています
例えば従来の画像生成AI、Nano Bananaとかも含めて、インパクトのある画像を作る力は、それなりにありました
以前のverでも遠目に見ると普通にきれいですし、SNSで流れてきたら目を引くような画像も作れます
そういう意味では、GPT-image 2.0以前の画像生成AIも、十分強力だった
ただ、実際に仕事で使おうとすると、通用しない場面が出てきます
ポスターの小さい文字が崩れる
写真の一部だけ直したいのに、顔や光の当たり方まで別物になる
日本語を入れた瞬間、それっぽいけど読めない文字の塊になる
このあたりは、実際に画像生成AIを使ったことがある人ほど「あるある」となる部分だと思います
見た目はすごい
でも、最後に実用レベルまで持っていくところで、結局人間がかなり直すことになる
多くの人が感じていた壁は、「すごいんだけど、最後の詰めは人間がやるしかないよね」という感想
ところが、GPT Images 2.0ではその壁にちゃんと向き合ってきました
もちろん、これで人間が何もしなくてよくなったという話ではありませんが、画像生成AIを見るときの基準は少し変わってきそうです
これからの画像生成は「きれいな絵が出るか」ではなく、「文字や配置や部分修正まで、どこまで任せられるか」を見る必要があると思います
「画像の中の文字」が実用に近づいた
まず、画像の中に入る文字表現がかなり良くなりました
文字の表現って、画像生成AIにとっては長いあいだ難所だったんですよね
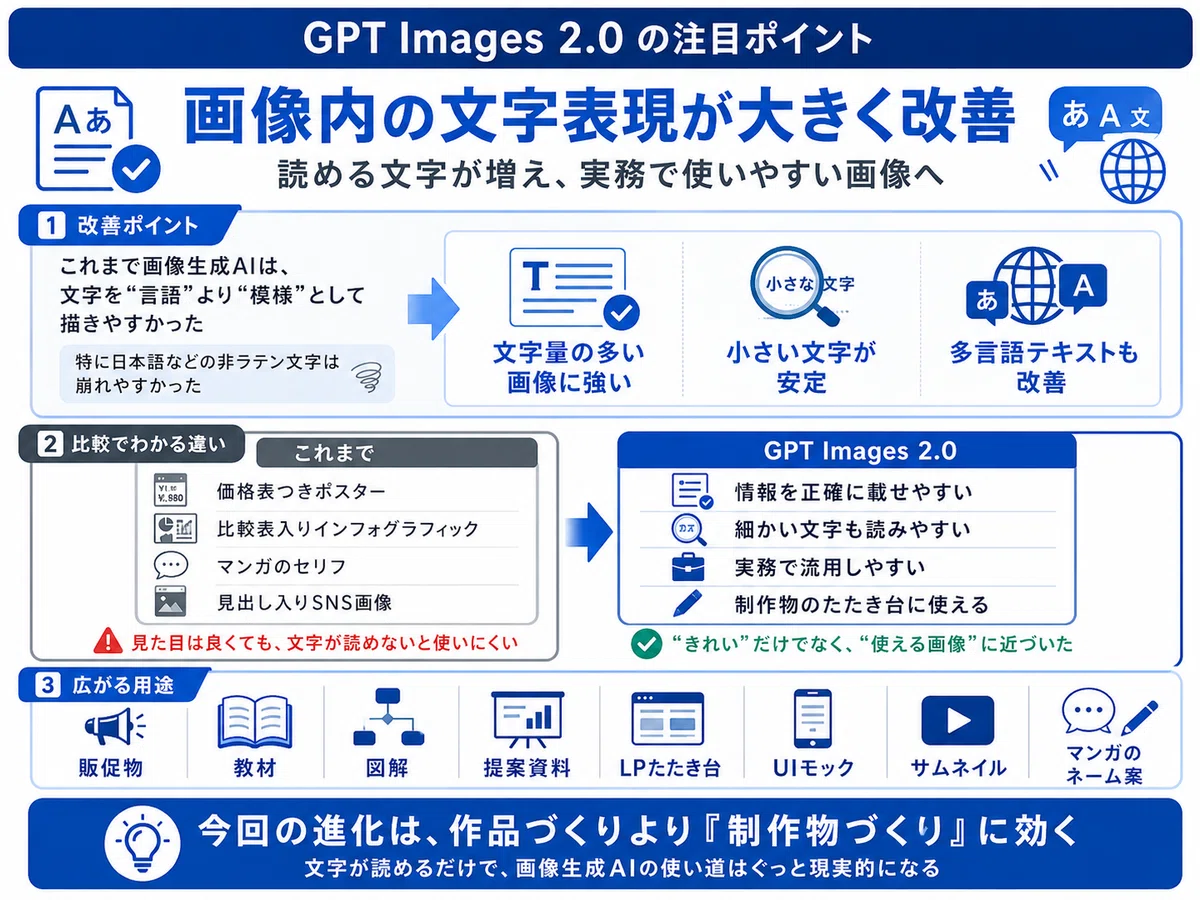
というのも、画像モデルは文字を「言語として正確に組み立てる」よりも、「文字っぽい形の模様として描く」ほうが得意でした
なので、日本語みたいな非ラテン文字は特に崩れやすい傾向にありましたね
まあ、今までも雰囲気だけなら出せるんですけど、ちゃんと読める文字として出すのは別問題という感じ
でも、GPT Images 2.0では、この弱点にかなり本気で手が入っているように見えます
文字量の多い画像、小さい文字、多言語テキストみたいな、これまでだいぶ厳しかったところで改善が見られました
これ、ぱっと聞いただけだと地味に感じるかもしれません
でも、見た目の派手さ以上に、けっこう重要
画像の価値って、「きれいかどうか」だけで決まるものではないんですよね
実務で使うなら、「そこに情報をちゃんと載せられるかどうか」がかなり大事になります
たとえば、これまでの画像生成AIでも、「おしゃれなカフェの広告風」みたいな画像はわりと得意でした
一方で、細かい文字を含む表現はずっと苦手でした
価格表つきの店頭ポスター
比較表が入ったインフォグラフィック
漫画の複数コマをまたいで読めるセリフ
見出しの入ったSNS用の縦長クリエイティブ
こういうものは、見た目だけそれっぽくても、文字が読めないと結局使いにくいんですよね
惜しいけど実務には出せない、でも文字が安定して入るようになると、用途が一気に変わります
ただ遊びで画像を作るだけではなく、販促物、教材、図解、提案資料、LPのたたき台、UIモック、サムネイル、マンガのネーム案あたりまで視野に入ってきます
つまり今回の進化は、「作品づくり」よりも「制作物づくり」にメリットがあります
こういう改善は大々的ではないですが、実際に作業で使う側からするとかなり大きい部分
文字が読めるだけで、画像生成AIの使い道はだいぶ現実寄りになります
「部分修正」しても壊れにくくなった
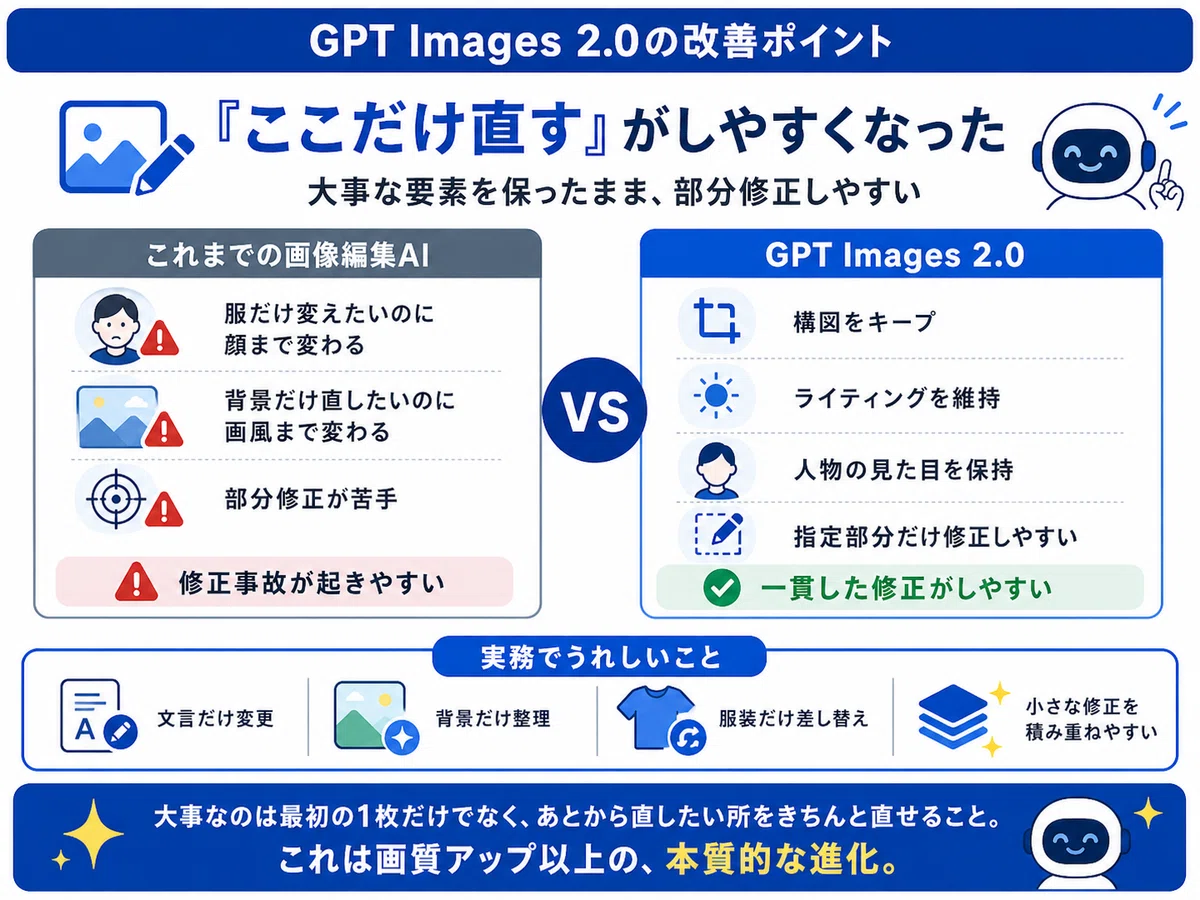
次に大きいなと思ったのが、編集するときに元画像の大事な要素を残しやすくなったところで
これまでの画像編集AIって、服だけ変えたいのに顔まで変わるとか、背景だけ直したいのに全体の画風まで編集されてしまうみたいな事故がわりとありました
GPT Images 2.0では、構図、ライティング、人物の見た目、全体の雰囲気あたりを保ったまま、指定した部分だけを修正しやすくなっている印象です
これは実務だと、かなりありがたいです
というのも、制作現場って別に一発勝負じゃないんですよね
むしろ、細かい修正を何回も積み重ねていくほうが普通
たとえば、この文言だけ変える
背景だけ少し整理する
人物はそのままで、服装だけ差し替える
こういう小さい調整を重ねながら、最終的な見た目に近づけていきます
なので、画像AIが本当に道具として使えるかどうかって、最初の一枚がどれだけ綺麗かだけでは決まらないと思っています
もちろん、最初の出力が良いに越したことはないですが、それ以上に大事なのは、あとから直したいところをちゃんと直せるかどうか
一貫した修正にどれだけ強いかが改善されているなら、単なる画質アップではなく大きな進化です
「考えてから描く」方向に進み始めた
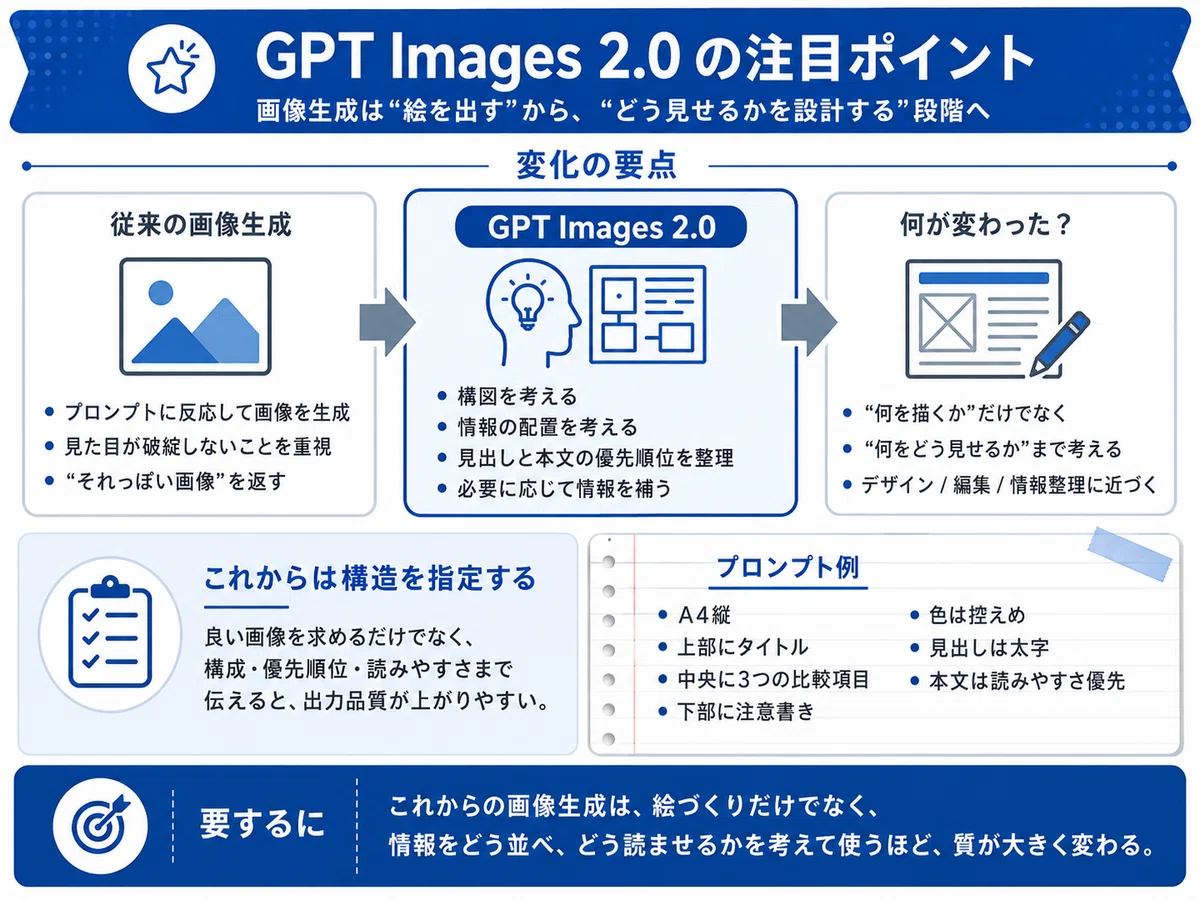
もうひとつ大事だなと思ったのが、画像生成に「思考」、いわゆるThinkingっぽい工程が入り始めているところ
従来の画像生成って、かなり雑に言うと「プロンプトに反応して、それっぽく見える画像を出す」みたいな動きに近かったと思います
それだけでも十分すごいんですが、基本的には入力された言葉に対して、見た目として破綻しないものを返すという感じ
でも、今回の方向性はちょっと違います
どういう構図にするか
どの情報を、画面のどこに置くか
見出しと本文の優先順位をどうするか
足りない情報をWeb検索で補うか
こういう、画像を作る前の設計に近い工程が入ってきているように感じます
つまり、ただ絵を出すというより、「何を、どう見せるか」まで考える方向に寄ってきている、つまり画像生成というより半分くらい編集作業に足を突っ込んできたなという印象です
たぶん今後、うまく使いこなす人は「いい感じの画像を作って」とはあまり言わなくなると思います
代わりに、こんな感じで構造を指定するようになるはず
A4縦。
上部にタイトル。
中央に3つの比較項目。
下部に注意書き。
色は抑えめ。
見出しは太字。
本文は読みやすさ優先。
こうやって、どこに何を置くか、何を目立たせるか、どう読ませるかまで指定するわけですね
GPT Images 2.0のすごいところは、こういう構造化された要求に、以前よりかなり応えられるようになっている点だと思います
ここはもう、単なるアート生成ではないですね
かなりはっきり、デザイン、編集、情報整理の領域に近づいています
なので、これから画像生成を使うなら、「どんな絵にするか」だけではなく、「どういう情報を、どう並べて、どう読ませるか」まで考えて投げたほうがよさそう
でも、そのぶん返ってくる画像の質はかなり変わってきそうだなと思いました
ユーザーに評価されているポイント
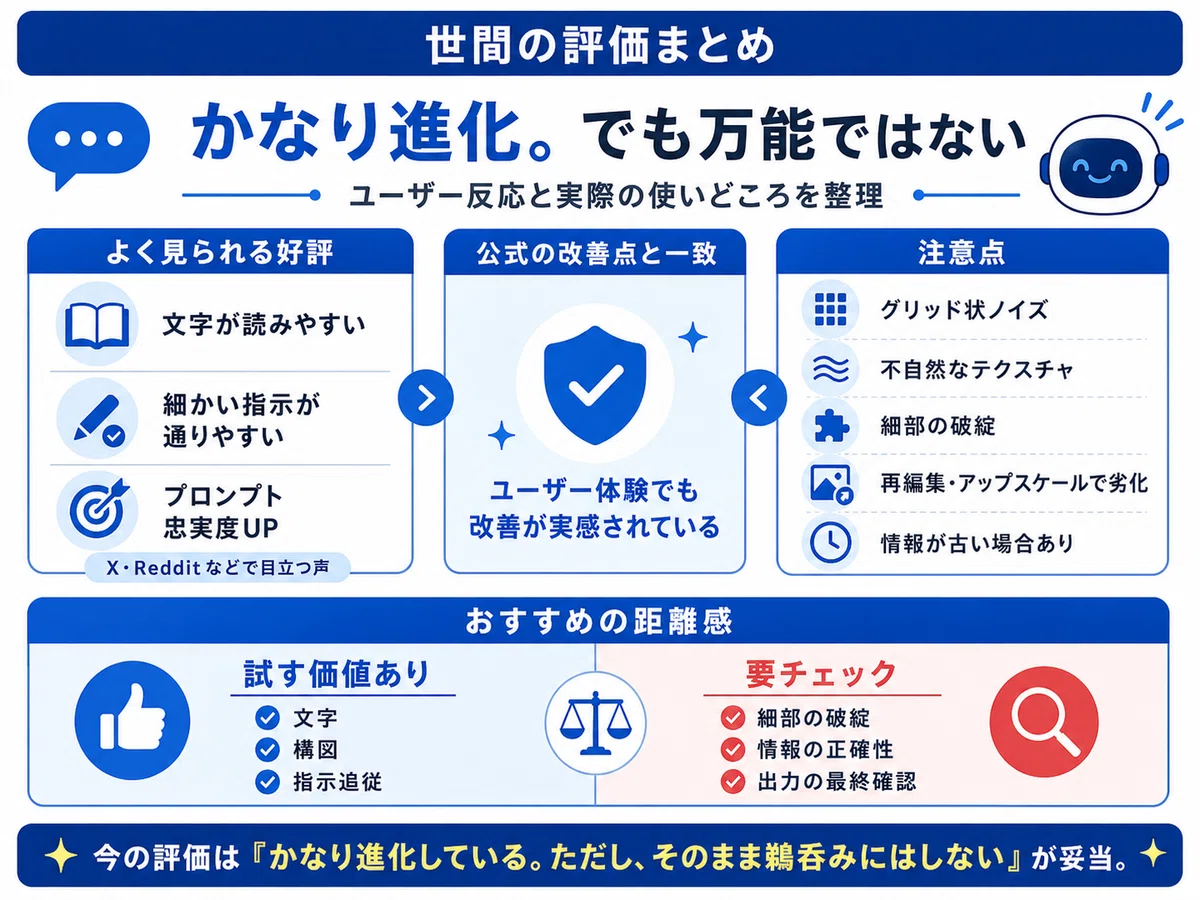
ここまでは、あくまで自分の体感ベースの話ですが、XやRedditあたりのユーザー反応を眺めていると、わりと多いのがこのへん↓↓↓
「文字がかなり読めるようになった」
「細かい指示が通りやすくなった」
「プロンプトへの忠実度が上がった」
だいたいこんな感じの声が目立ちます
で、これが面白いのは、公式が推している改善点ともだいたい一致しているところです
つまり、OpenAIが「ここを改善しました」と、実際のユーザー体験としてもちゃんと理解されているのはかなり凄いことで、大抵は企業とユーザーの使用感でズレがでることがほとんどなんですよ
とはいえ、反応が全部きれいな絶賛だけかというと、もちろんそんなことはないです
一部では、グリッド状のノイズが出るとか、テクスチャがちょっと不自然になるとか、細部が破綻するみたいな指摘もありました
あと、再編集やアップスケールを何回か重ねると、画質がだんだん崩れていくという話も出ています
まあ、これはNano Bananaでも起きる問題ではあるんですけどね….
さらに、「リアルタイム情報を使うはずなのに、古い内容が出た」という報告もあります
なので、情報の正確性については、まだ少し慎重に見たほうがよさそうです
まとめると、世間の評価はだいたい「かなり進化している。ただし万能ではない」くらいに落ち着きそうですね
個人的にも、この見方がいちばん妥当かなと思います
文字や構図、指示の通りやすさはちゃんと試す価値があります
ただ、細部の破綻や情報の古さについては、出力をそのまま信じずに確認する
今のところは、それくらいの距離感で触るのがちょうどよさそうです
*SNSで散らばった様々なユーザーのプロンプトを集めた、GPT-image-2.0のプロンプト集がGithubにあります↓↓↓
プロンプト例
1.モーション(シーケンシャル)
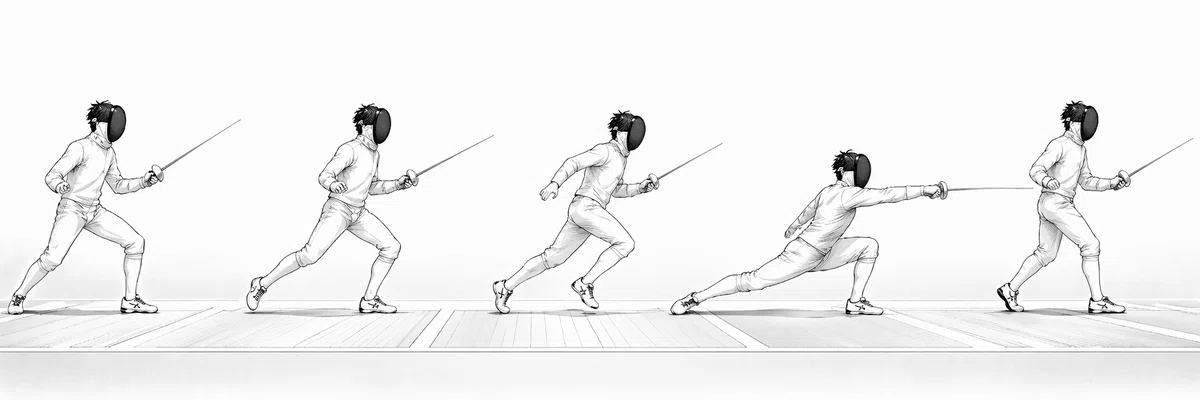
このプロンプトは分かりやすく言えば、サイドからみた動作の流れを可視化するプロンプトですね
上記は一例としてフェンシングを採用しましたが、剣道でも柔道でもなんでもOK
特定の動きをスローモーションで観察するようなイメージをもつと分かりやすいと思います
あるいはストロボ的なイメージでもいいでしょう
サンプル
フェンシング:
  目的: >
    若い男性フェンシング選手1人の一撃動作を、横長の1枚絵の中で
    time-lapseのように連続表示する。
    左から右へ、アン・ガルド、前進、間合いを詰める動き、
    深いランジによる決定的な突き、短いリカバリーまでを、
    同一人物約5体で明確に見せる。
    文字なしで、視覚だけで動きと流れが伝わる構成にする。
  ジャンル:
    - スポーツアクション
    - モーションスタディ
    - マンガ風シーケンシャルイラスト
  被写体: >
    若い男性フェンシング選手1人。同一人物を約5回配置。
  行動_ポーズ: >
    アン・ガルド → 前進ステップ → 間合いを詰める動き →
    深いランジの突き → 短いリカバリー。
    各ポーズ差を明確にする。
  感情_表情:
    - 集中
    - 決意
    - 鋭さ
    - 緊張感
  服装: >
    フェンシング用マスク、ジャケット、グローブ、ブリーチズ、
    ハイソックス、シューズ、細身の競技剣。
  背景: >
    明るい白または淡いグレー。背景は最小限、ピストの床ラインのみ。
    対戦相手なし。
  アスペクト比: "3:1ウルトラワイド"
  画風: >
    モノクロ漫画。
  技法:
    - デジタルインク風線画
    - モノクロトーン
    - 控えめな動線
    - 斜めのパネル風構成
  構図: >
    横長パノラマ。人物を左から右へ段階配置し、
    右側の深いランジを主役にする。間隔はやや広め。
  色とコントラスト: >
    白・黒・グレーのモノクロ。背景は明るく、
    人物と剣は高コントラスト。
  テキスト要素: >
    文字なし。
  禁止事項:
    - 暗い背景
    - 写実写真風
    - 別人に見える表現
    - 縦長構図
    - コミカルすぎるデフォルメ
    - 文字入り
    - 人数を増やしすぎる表現
    - 明確な対戦相手
    - 衝撃波
    - 爆発
    - 火花
    - 過剰なスピード線
    - 漫符的エフェクト
  出力指示:
    - モノクロ
    - 明るい背景
    - スポーツマンガ風
    - 選手約5体
    - 各ポーズ差が明確
    - テキストなし
    - 余計なエフェクトなし
Prompt
動作シーケンス_テンプレート:
  目的: >
    <被写体>1人の一連の動作を、横長の1枚絵の中で
    time-lapseのように連続表示する。
    左から右へ、<動作段階1>、<動作段階2>、<動作段階3>、
    <決定的な動作>、<終端動作>までを、
    同一人物約<出現数>体で明確に見せる。
    文字なしで、視覚だけで動きと流れが伝わる構成にする。
  ジャンル:
    - <ジャンル1>
    - <ジャンル2>
    - <ジャンル3>
  被写体: >
    <年齢層・性別・属性>の<被写体>1人。
    同一人物を約<出現数>回配置する。
  行動_ポーズ: >
    <動作段階1> → <動作段階2> → <動作段階3> →
    <決定的な動作> → <終端動作>。
    各ポーズ差を明確にする。
  感情_表情:
    - <感情1>
    - <感情2>
    - <感情3>
    - <感情4>
  服装: >
    <服装・装備・道具>。
  背景: >
    <背景色や空間>。背景は最小限に抑え、
    <最低限の環境要素>のみを入れる。
    <不要な要素>は描かない。
  アスペクト比: "<横長比率>"
  画風: >
    <画風>。<印象1>、<印象2>、<印象3>を強く表現する。
  技法:
    - <技法1>
    - <技法2>
    - <技法3>
    - <技法4>
  構図: >
    横長パノラマ構図。人物を左から右へ段階配置し、
    <最も重要な瞬間>を主役にする。
    各ポーズの間隔はやや広めに取り、
    動作の違いがひと目で分かるようにする。
  色とコントラスト: >
    <色調設計>。背景は<背景トーン>、
    被写体と主要な道具は<コントラスト方針>で見せる。
  テキスト要素: >
    文字なし。
  禁止事項:
    - <禁止要素1>
    - <禁止要素2>
    - <禁止要素3>
    - <禁止要素4>
    - <禁止要素5>
    - <禁止要素6>
  出力指示:
    - <色の指定>
    - <背景の指定>
    - <画風の指定>
    - <構図の指定>
    - <被写体数の指定>
    - <物語性の指定>
    - テキストなし
    - 余計なエフェクトなし
2.日本語の手書き文字
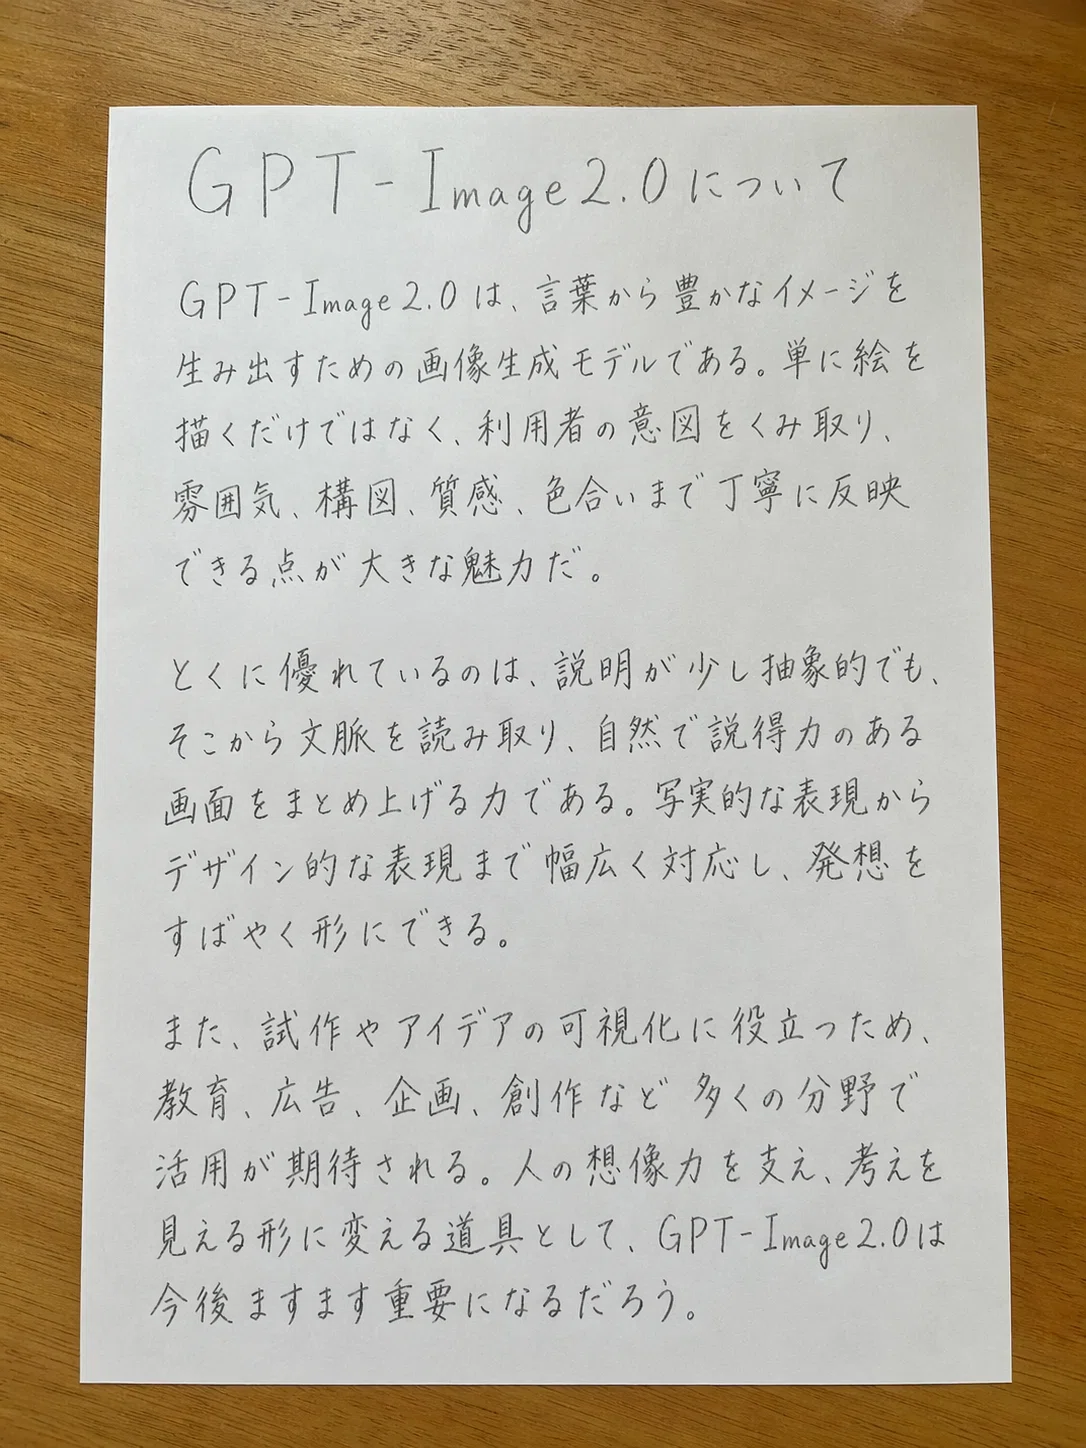
英語のスペルとかなら、今までのモデルでも十分に生成可能でしたが、GPT-Image2.0になってからは、日本語の柔らかい筆跡も正確に表現できるようになりました
もう少し頑張れば、文字のアンバランスも指示だけで再現できそうです
サンプル
手書きエッセイ写真:
  目的: >
    白い紙1枚に、日本語の手書きエッセイが鉛筆で書かれている様子を、
    机の上でスマホ撮影したようなフォトリアルな写真として表現する。
    紙上部にタイトル、その下に複数段落の本文を配置し、
    太めで上品だが少し乱雑な鉛筆筆跡にする。
    デジタル文字ではなく、人が実際に書いた自然な手書きに見せる。
  ジャンル:
    - フォトリアル
    - ドキュメント写真
    - 手書きノート写真
    - スチルライフ
  被写体: >
    木目の机の上に置かれた白い紙1枚。
    紙全面に鉛筆の日本語手書きエッセイ。
    人物や小物なし。
  行動_ポーズ: >
    書き終えた原稿を、やや斜め上からスマホで自然に撮影した構図。
    真上スキャンにはしない。
  背景: >
    暖かい明るいブラウン系の木製机のみ。
    紙の四辺が見え、周囲に少し机面が見える。
    余計な物は置かない。
  シチュエーション: >
    室内の柔らかな自然光または室内光。
    昼〜夕方の穏やかな雰囲気。
    生活空間で何気なく撮ったようなリアルさ。
  記載テキスト:
    タイトル: "GPT-Image2.0について"
    本文: |
      GPT-Image2.0は、言葉から豊かなイメージを生み出すための画像生成モデルである。単に絵を描くだけではなく、利用者の意図をくみ取り、雰囲気、構図、質感、色合いまで丁寧に反映できる点が大きな魅力だ。

      とくに優れているのは、説明が少し抽象的でも、そこから文脈を読み取り、自然で説得力のある画面をまとめ上げる力である。写実的な表現からデザイン的な表現まで幅広く対応し、発想をすばやく形にできる。

      また、試作やアイデアの可視化に役立つため、教育、広告、企画、創作など多くの分野で活用が期待される。人の想像力を支え、考えを見える形に変える道具として、GPT-Image2.0は今後ますます重要になるだろう。
  画風: >
    写実的なスマホ写真風。紙、鉛筆、木目の質感が見える自然な描写。
  技法:
    - フォトリアル描写
    - スマホ写真風
    - 鉛筆のグラファイト質感
    - 紙の表面テクスチャ
    - 自然光風ライティング
    - 手書きの揺らぎ表現
  画質: >
    高解像度。文字が読める鮮明さ。
    過度なHDRや不自然なシャープネスは避ける。
  構図: >
    3:4縦構図。紙を中央付近に大きく配置し、少し傾ける。
    やや斜め上から撮影し、軽いパースを入れる。
  色とコントラスト: >
    白い紙、灰色の鉛筆、暖色の木の机。
    自然で控えめなコントラスト。
  重要な筆跡指定: >
    太めで上品だが少し乱雑。不均一な濃さ、太さ、間隔、傾き、字形。
    軽いかすれや筆圧差を感じる自然な鉛筆文字。
  テキスト要素: >
    紙上の手書き日本語のみ。UI、字幕、透かし、キャプションなし。
  禁止事項:
    - 印刷フォント風
    - デジタル文字
    - 完全真上スキャン
    - 小物追加
    - 手や人物
    - 派手な照明
    - 過度なHDR
    - 強すぎる影
    - 過剰な彩度
    - インク風
    - 机以外の背景
    - 折れた紙
    - ノイズ過多
    - 漫画風
    - イラスト風
    - 文字化け
    - 透かし
    - UI表示
  出力指示:
    - フォトリアル
    - スマホ撮影風
    - 白い紙1枚
    - 鉛筆の手書き日本語
    - 木の机
    - 柔らかな室内光
    - 紙の四辺が見える
    - 余計な小物なし
    - 高解像度
    - 文字は読める
Prompt
手書きドキュメント写真_テンプレート:
  目的: >
    <紙媒体>1枚に、<言語>の<文書種類>が<筆記具>で書かれている様子を、
    <撮影機器>で自然に撮影したようなフォトリアルな写真として表現する。
    上部に<見出し要素>、その下に<本文構成>を配置し、
    <筆跡の特徴>を持つ自然な手書きに見せる。
    デジタル文字ではなく、人が実際に書いたような質感を重視する。
  ジャンル:
    - フォトリアル
    - ドキュメント写真
    - 手書きノート写真
    - スチルライフ
  被写体: >
    <机や床などの設置面>の上に置かれた<紙媒体>1枚。
    その上に<筆記具>で書かれた<言語>の<文書種類>を配置する。
    <不要物>は入れない。
  行動_ポーズ: >
    <書き終えた状態・使用シーン>を、
    <撮影角度>から自然に撮影した構図。
    完全なスキャンや真上視点にはしない。
  背景: >
    背景は<背景素材>のみ。
    紙の四辺が見え、周囲に少し<背景素材>が見える構成にする。
    余計な物は置かない。
  シチュエーション: >
    <場所>で撮影された日常的なワンシーン。
    <光の条件>で、<雰囲気>を感じる自然な写真にする。
  記載テキスト:
    タイトル: "<タイトル>"
    本文: |
      <本文>
  画風: >
    写実的な<撮影機器>写真風。
    <紙媒体>、<筆記具>、<背景素材>の質感が見える自然な描写。
  技法:
    - フォトリアル描写
    - <撮影機器>写真風
    - <筆記具>の質感表現
    - 紙の表面テクスチャ表現
    - 自然光または室内光のライティング
    - 手書きの揺らぎ表現
  画質: >
    高解像度。文字が読める鮮明さ。
    過度なHDRや不自然なシャープネスは避ける。
  構図: >
    <縦横比>構図。紙を中央付近に大きく配置し、
    少し傾ける。<撮影角度>から撮影し、
    わずかな遠近感を持たせる。
  色とコントラスト: >
    <紙の色>、<筆記具の色>、<背景素材の色>を中心にした
    控えめで自然な色設計。
  重要な筆跡指定: >
    <筆跡の特徴>。
    濃さ、太さ、間隔、傾き、字形に人間らしいばらつきを持たせる。
    <かすれや筆圧差の指定>を感じられる自然な筆跡にする。
  テキスト要素: >
    紙上の手書きテキストのみ。
    UI、字幕、透かし、キャプションは入れない。
  禁止事項:
    - 印刷フォント風の文字
    - デジタル文字
    - 完全真上スキャン
    - <余計な小物>
    - 手や人物の写り込み
    - 派手な照明
    - 過度なHDR
    - 強すぎる影
    - 過剰な彩度
    - 文字化け
    - 透かし
    - UI表示
  出力指示:
    - フォトリアル
    - <撮影機器>撮影風
    - <紙媒体>1枚
    - <筆記具>の手書き<言語>テキスト
    - <背景素材>
    - 柔らかな光
    - 紙の四辺が見える
    - 余計な小物なし
    - 高解像度
    - 文字は読める
それでも人間の監修は必要
もちろん、GPT-Image2.0にも限界はあります
文字が読めるようになったとはいえ、多言語対応も改善したとはいえ、常に完璧ではないです
複雑な事実関係を含む図版については、人間による内容確認は絶対に必よ
さらに、写真らしさが増すほど、フェイク画像の見分けが難しくなるという問題も強まります
だから、無条件に持ち上げるのではなく「どこまで任せて、どこから人が監修するのか」を見極める段階に入ったと考えるべきでしょう
まとめ
GPT-imageの1.5から2.0への進化は、かなり大きいです
「ああ、ここまで変わるんだ」という感じでした
以前からSora 2を見ていても思っていましたが、OpenAIには技術の伸び方が急に跳ねる瞬間があります
一時的に他のモデルに遅れを取っているように見えても、あとからまとめて巻き返してくるだけの地力があるんですよね
で、今回のGPT Images 2.0も、まさにそのタイプに見えます
これまで画像生成AIの評価って、ざっくり言えば「絵がうまいかどうか」に寄りがちでした
もちろん、それは大事です
見た目が弱いと、そもそも使いづらいので
ただ、GPT Images 2.0では、評価の軸が少し変わってきたように感じます
単に絵がきれいかどうかではなく、情報を壊さずに扱えるか。こちらの意図をちゃんと汲んでくれるか?
そして、同じような用途で繰り返し使えるか?
このあたりが、かなり重要になってきました
「うまい絵を一枚出せるか」から、「伝えたい内容を、ちゃんと使えるビジュアルにできるか」へ寄ってきた感じといえばいいでしょうか
この変化は、マーケターや編集者、教育者、プロダクトデザイナー、個人クリエイターにはかなり関係してきます
あと、デザインが専門ではないけど、何かを分かりやすく伝えないといけない人にも普通に刺さるはずです
というか、たぶん一番助かるのはその層かもしれません
頭の中では言いたいことがある
でも、それを図や画像にするのが面倒くさい
デザインツールを開くのも面倒
そういう場面って、かなりあります
GPT Images 2.0は、その「考えた内容を、そのまま伝わるビジュアルに落とす」という部分に一歩近づいた一例だと思いました
まだ万能という話ではないですし、毎回完璧に意図どおりになるわけでもないでしょうし、使う側の指示の出し方も大切
それでも、見るべきポイントが変わってきたのは間違いないです
これからは「絵がうまいか」だけではなく、「情報を崩さず、意図どおりに、何度も使えるか」を見たほうがよさそうですね
GPT Images 2.0は、その方向にかなり分かりやすく進んだアップデートだと思います
noteとXのフォローをお願いします!
・note
オススメ記事
いいなと思ったら応援しよう!
 気に入ってもらえたら、チップをぽいっと投げてもらえると、静かにガッツポーズします(`・ω・´)ゞ
