Jev のクイックスタート

「Jev」のクイックスタートをまとめました。
1. Jevとは
Jevは、文章生成ではなく、高速な「判断」の出力に特化したAIモデルです。
Jevの基本構造は、
State → Questions → Typed Decisions
です。
状態(state)と質問(questions)を渡すと、型付きの確率的な判断(Typed Decisions)を返します。また、複数の質問を並列に評価できる設計により、高速な判断を実現しています。
2. 3種類の判断
Jevでは、「Choice」「Score」「Noul」という3種類の型を使って質問を定義します。
2-1. Choice - どれ?
Choiceは、「どれを選ぶ?」という判断に使います。
たとえば、敵を見つけたときの行動を選ばせます。
Choice(
    instructions="次に取る行動は?",
    criteria={
        "attack": "敵を攻撃する",
        "escape": "敵から逃げる",
        "heal": "回復する",
    },
)
・出力例
{
  "choice": "attack",
  "probabilities": {
    "attack": 0.82,
    "escape": 0.13,
    "heal": 0.05
  },
  "confidence": 0.76
}この場合は、「攻撃する」に最も高い確率を割り当てています。
2-2. Score - どのくらい?
Scoreは、「どのくらい?」という程度の判断に使います。
たとえば、現在どれくらい危険な状況かを評価します。
Score(
    instructions="現在の危険度は?",
    criteria=[
        "安全",
        "少し危険",
        "かなり危険",
    ],
)
・出力例
{
  "score": 1.6,
  "confidence": 0.81
}
基準は、
0 = 安全
1 = 少し危険
2 = かなり危険
なので、`1.6`ならかなり危険寄りという意味です。
Score の criteria は2個以上の段階を指定します。たとえば5段階なら、レベル番号は 0〜4 になります。
2-3. Noul - Yes / No?
Noulは、「Yes / No?」という判断に使います。
たとえば、今すぐ回復が必要かを判断させます。
Noul(
    instructions="今すぐ回復する必要がある?",
)
・出力例
{
  "noul": 0.93
}`0.93`なら、93%の確率でYesという意味です。
3. Playgroundで試す
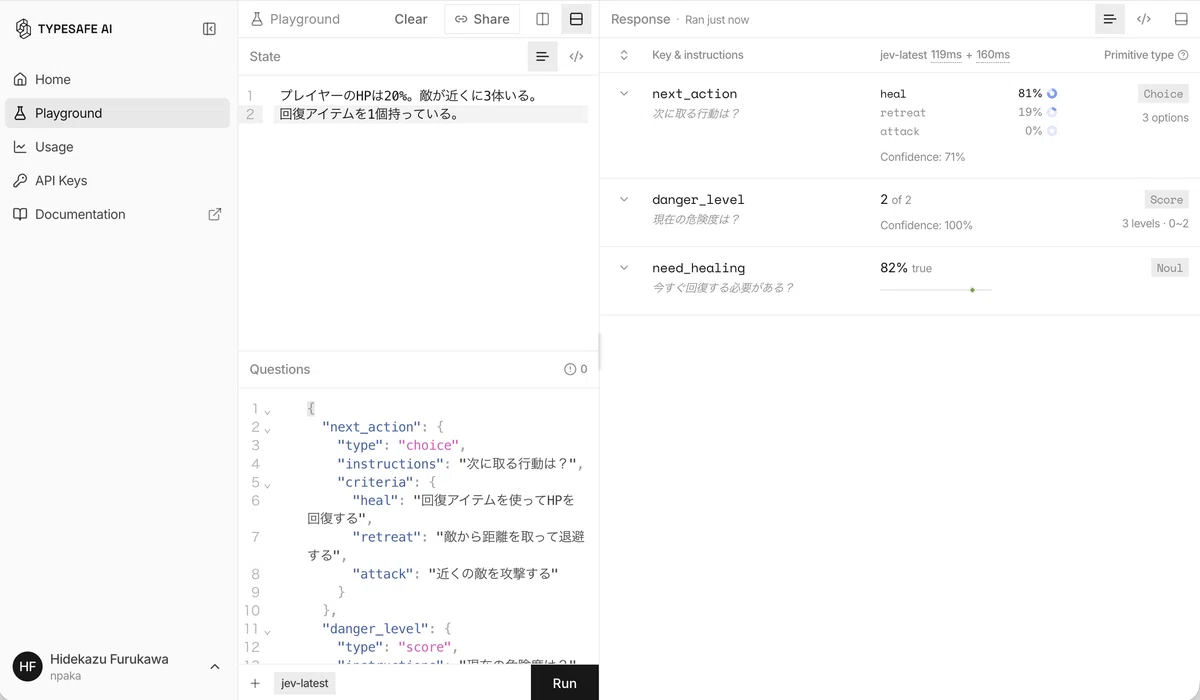
まずはTypeSafeのWeb Interfaceにある「Playground」でJevを試せます。
Playgroundでは、判断材料となる「State」と、判断してほしい「Questions」を入力してから「Run」をクリックします。
・State
プレイヤーのHPは20%。敵が近くに3体いる。
回復アイテムを1個持っている。
・Questions
{
  "next_action": {
    "type": "choice",
    "instructions": "次に取る行動は?",
    "criteria": {
      "heal": "回復アイテムを使ってHPを回復する",
      "retreat": "敵から距離を取って退避する",
      "attack": "近くの敵を攻撃する"
    }
  },
  "danger_level": {
    "type": "score",
    "instructions": "現在の危険度は?",
    "criteria": [
      "低:差し迫った脅威がなく、安全に行動できる",
      "中:脅威があり、注意して行動する必要がある",
      "高:倒される危険が高く、直ちに対処する必要がある"
    ]
  },
  "need_healing": {
    "type": "noul",
    "instructions": "今すぐ回復する必要がある?",
    "criteria": {
      "true": "今すぐ回復する必要がある",
      "false": "今すぐ回復する必要はない"
    }
  }
}実行すると、Jevがそれぞれの質問を評価し、選択結果、スコア、Yesの確率などを返します。
4. PythonからJevを使う
4-1. セットアップ
(1) SDKのインストール。
公式SDKはPython 3.10以上に対応しています。
pip install typesafe-sdkuvを使っている場合は、次のコマンドで追加します。
uv add typesafe-sdk(2) APIキーの設定。
TypeSafeのダッシュボードからAPIキーを取得し、環境変数TYPESAFE_API_KEYに設定します。
export TYPESAFE_API_KEY="取得したAPIキー"利用開始時点で、5ドル分のクレジットが付与されているようです。残高や利用額は、「Usage」画面下部の「See billing for more details.」から請求画面を開くと確認できます。
4-2. サンプルコードの実行
(1) サンプルコードの作成。
・jev_sample.py
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

state = (
    "プレイヤーのHPは20%。敵が近くに3体いる。\n"
    "回復アイテムを1個持っている。"
)

with TypeSafeClient(model="jev-latest") as client:
    response = client.system_one(
        state=state,
        questions={
            "next_action": Choice(
                instructions="次に取る行動は?",
                criteria={
                    "heal": "回復アイテムを使ってHPを回復する",
                    "retreat": "敵から距離を取って退避する",
                    "attack": "近くの敵を攻撃する",
                },
            ),
            "danger_level": Score(
                instructions="現在の危険度は?",
                criteria=[
                    "低:差し迫った脅威がなく、安全に行動できる",
                    "中:脅威があり、注意して行動する必要がある",
                    "高:倒される危険が高く、直ちに対処する必要がある",
                ],
            ),
            "need_healing": Noul(
                instructions="今すぐ回復する必要がある?",
                criteria={
                    "true": "今すぐ回復する必要がある",
                    "false": "今すぐ回復する必要はない",
                },
            ),
        },
    )

print("次に取る行動:", response.choices["next_action"].choice)
print("現在の危険度:", response.scores["danger_level"].score)
print("回復が必要な確率:", response.nouls["need_healing"].noul)(2) サンプルコードの実行。
python jev_sample.py 次に取る行動: heal
現在の危険度: 2.0
回復が必要な確率: 0.814-3. HTTP APIからの実行
SDKを使わず、HTTP APIを直接呼び出すこともできます。同じAPIキーを設定したターミナルで、次のコマンドを実行します。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": "プレイヤーのHPは20%。敵が近くに3体いる。\n回復アイテムを1個持っている。",
    "model": "jev-latest",
    "questions": {
      "next_action": {
        "type": "choice",
        "instructions": "次に取る行動は?",
        "criteria": {
          "heal": "回復アイテムを使ってHPを回復する",
          "retreat": "敵から距離を取って退避する",
          "attack": "近くの敵を攻撃する"
        }
      },
      "danger_level": {
        "type": "score",
        "instructions": "現在の危険度は?",
        "criteria": [
          "低:差し迫った脅威がなく、安全に行動できる",
          "中:脅威があり、注意して行動する必要がある",
          "高:倒される危険が高く、直ちに対処する必要がある"
        ]
      },
      "need_healing": {
        "type": "noul",
        "instructions": "今すぐ回復する必要がある?",
        "criteria": {
          "true": "今すぐ回復する必要がある",
          "false": "今すぐ回復する必要はない"
        }
      }
    }
  }'
{
"model": "jev-1.13.0",
"answers": {
"next_action": {
"type": "choice",
"choice": "heal",
"confidence": 0.71,
"probabilities": {
"attack": 0.0,
"retreat": 0.19,
"heal": 0.81
}
},
"danger_level": {
"type": "score",
"score": 2.0,
"confidence": 1.0,
"legend": {
"0": "低:差し迫った脅威がなく、安全に行動できる",
"1": "中:脅威があり、注意して行動する必要がある",
"2": "高:倒される危険が高く、直ちに対処する必要がある"
},
"probabilities": {
"0": 0.0,
"1": 0.0,
"2": 1.0
}
},
"need_healing": {
"type": "noul",
"noul": 0.81
}
},
"usage": {
"input_tokens": 558,
"output_tokens": 73
}
}5. Jevの設計パターン
TypeSafeでは、Jevをアプリケーションに組み込むための代表的なパターンを4つ紹介しています。
5-1. Speculative Fan-Out - 複数の判断をまとめて出す
Jevでは、同じStateに対する複数の質問を、1回のAPI呼び出しでまとめて送れます。
たとえばゲームなら、
・次に取る行動は?
・現在の危険度は?
・今すぐ回復する必要がある?
といった質問をまとめて送り、それぞれを並列に評価できます。
さらに、あとで必要になるかもしれない質問も先に送っておき、実際に必要になった結果だけ使う方法を、TypeSafeでは「Speculative Fan-Out」と呼んでいます。
5-2. Composite Scoring - 判断を分けて、あとで組み合わせる
複雑な判断を、1つの大きな質問にまとめるのではなく、複数の小さな評価に分ける方法です。
たとえば「現在どれくらい危険か」を、
・敵の数は多い?
・HPは少ない?
・逃げにくい状況?
のように分けて、それぞれをScoreで評価します。
最後に、プログラム側で結果を組み合わせます。
danger = (
    enemy_score * 0.4
    + hp_score * 0.4
    + escape_difficulty_score * 0.2
)TypeSafeでは、このように複数の評価を組み合わせる方法を「Composite Scoring」と呼んでいます。
5-3. Confidence-Gated Routing - 自信があるときだけ判断を使う
ChoiceとScoreには、判断結果とともにconfidenceが返ります。
たとえば、
・confidenceが高い → Jevの判断を使う
・confidenceが低い → あらかじめ決めたルールを使う
といった切り替えができます。
if answer.confidence >= 0.8:
    action = answer.choice
else:
action = default_actionこのように、confidenceを使って処理を切り替える方法を「Confidence-Gated Routing」と呼んでいます。
5-4. Intent Routing - 判断結果に応じて処理先を変える
Jevを、入力内容に応じて処理先を選ぶために使う方法です。
たとえば問い合わせなら、
・注文状況について → 通常のプログラムで処理
・商品についての質問 → LLMに渡す
・複雑なクレーム → 人間に確認してもらう
のように振り分けられます。
if intent == "order_status":
    handle_order()
elif intent == "product_question":
    ask_llm()
elif intent == "complaint":
escalate_to_human()TypeSafeでは、このように入力の意図を判断して処理先を切り替える方法を「Intent Routing」と呼んでいます。
6. Jevの活用例
TypeSafe公式ドキュメントでは、Jevの活用例を「用途のカテゴリ」「具体的なユースケース」「基本的な判断タスク」の3つのレベルで紹介しています。
6-1. おすすめ用途
TypeSafe公式ドキュメントでは、Jevの用途カテゴリとして、次の5つを紹介しています。
・AIオートメーション
人間が毎回確認していた意味的な判断を、ソフトウェアの処理フローに組み込む用途です。
・リアルタイムアプリケーション
ゲームやUIなど、高速な判断が必要な処理に組み込む用途です。
・大量データの処理
大規模なデータセットを検索・分類し、予測に使う特徴量を抽出する用途です。
・AIの検証
他のAIやLLMの入力、出力、推論過程、ツール呼び出しなどをチェックする用途です。
・AIハーネスの制御
モデル選択、コンテキスト取得、エラー検出、ガードレール、推論過程の分類など、AIハーネスの判断に使う用途です。
6-2. ユースケース
TypeSafe公式ドキュメントでは、Jevを利用できる具体的なユースケースとして、次のような例を紹介しています。
・検索 / RAG
・RAGでEmbeddingによる検索を補完・置き換える
・クエリと候補の関連度を評価する
・候補をペア比較して検索結果を再ランキングする
・クエリと候補をCross-Encoder方式で評価して精度を高める
・後続のAIに渡すコンテキストを選ぶ
・科学研究
・論文を採用・除外条件に沿って選別する
・インタビューやアンケートをテーマ別に分類する
・引用箇所が主張を裏付けているか確認する
・対照条件やデータセットの説明など、研究手法に必要な情報の不足を検出する
・論文からエンティティや関係を抽出する
・モデルルーティング
・入力ごとに使用するLLMを選ぶ
・用途に合わせてルーティングルールやしきい値を設定する
・質問の意図や分野を分類する
・難易度やリスクを評価する
・必要に応じて高性能なモデルへ切り替える
・LLMガードレール
・LLMの入力・出力・ツール呼び出しをチェックする
・Jailbreakやプロンプトインジェクションを検出する
・ポリシー違反や機密情報の露出を検出する
・ツール呼び出しや回答品質の問題をリアルタイムに検出する
・チェック結果と確率を構造化して記録し、AIシステムの問題を追跡する
・セマンティックコードLint
・コードや文章を意味的なルールでチェックする
・チーム独自のコーディング規約や文章ルールを確認する
・CIで自動チェックし、違反をレビュー対象にする
・予測モデル用の特徴量抽出
・文章から確率的な特徴量を抽出する
・構造化データと組み合わせて予測モデルに利用する
・特徴量候補を作り、予測性能を評価する
・採用
・履歴書や応募書類を評価する
・候補者の関連する経験を見つける
・必要な能力を裏付ける情報を評価する
・職種との適合度を評価する
・候補者を担当者へ振り分ける
・営業リードの獲得
・企業情報や問い合わせを理想顧客像と照合する
・業界や企業規模などの適合度を評価する
・購入意欲や課題を検出する
・見込み顧客に優先順位を付ける
・カスタマーサポート
・問い合わせ内容や目的を分類する
・通話記録から課題や対応事項を抽出する
・緊急度、不満度、解約リスクなどを検出する
・適切な担当チームや処理フローへ振り分ける
・回答がポリシーや顧客の要求に合っているか確認する
・保険請求
・事故報告や関連文書を分類する
・請求の複雑さや不足情報、不正の兆候を検出する
・自動処理または専門担当者による確認の優先順位を付ける
・不確実性やリスクの高い案件を人間へ引き継ぐ
・金融犯罪対策
・取引内容やKYC文書から不審な特徴を検出する
・表記が異なる人物や企業の同一性を判断する
・アラートをリスクや証拠の質で優先順位付けする
・判断が難しい案件を調査担当者へ振り分ける
・法務 / コンプライアンス
・契約書や規制文書を分類する
・不足している条項や禁止された表現を検出する
・法務・コンプライアンス上の要件を満たしているか確認する
・高リスクな案件を専門担当者へ引き継ぐ
・ECマーケットプレイス
・商品情報を分類・正規化する
・商品名や説明から属性を抽出する
・禁止商品、偽造品、不正レビューなどを検出する
・商品をランキングし、判断が難しいものを人間へ回す
・モデレーション / Trust & Safety
・サービス独自の基準でコンテンツを判定する
・投稿やAIとの会話をモデレーションする
・有害表現、嫌がらせ、スパム、不正などを検出する
・重大度や確信度に応じて、許可・警告・確認・ブロックを判断する
・広告
・広告クリエイティブやランディングページを評価する
・ブランドセーフティや対象ユーザーとの適合性を分類する
・規制違反や禁止表現をチェックする
・広告とランディングページの整合性を評価する
・ゲーム
・プレイヤー報告やゲーム内チャットを評価する
・暴言、不正行為、不審な行動を検出する
・プレイヤーの不満度やエンゲージメントを評価する
・離脱の兆候を検出し、サポートへ振り分ける
・リスク評価
・事故報告や取引情報などからリスク指標を作る
・リスクの種類を分類する
・不審な特徴を検出する
・重大度を評価して確認の優先順位を付ける
・リスク予測モデル用の特徴量を抽出する
・需要予測
・問い合わせ、営業メモ、レビューなどから需要の兆候を抽出する
・購入意欲、緊急度、商品への関心を抽出する
・供給上の懸念や競合圧力、新しい需要トレンドを検出する
・抽出した特徴を時系列データと組み合わせて需要予測に利用する
・グラフ / ナレッジグラフ
・ナレッジグラフを分類・検証する
・エンティティや関係の種類を分類する
・レコードや主張同士の矛盾を検出する
・確率的なグラフ探索や階層分類に利用する
6-3. タスク
Jevのユースケースは、さらに次のような基本的な判断タスクに分解できます。
・Classification(分類)
複数の候補から、最も当てはまるカテゴリを選びます。
【例】問い合わせ種別、トピック、担当部署、リスク種別、エンティティ種別
・Detection(検出)
特定の性質や問題が含まれている確率を判断します。
【例】スパム、不正、緊急性、Jailbreak、機密情報
・Scoring(スコアリング)
決められた基準に沿って、入力を段階的に評価します。
【例】重要度、関連度、品質、不満度、適合度
・Routing(ルーティング)
判断結果に応じて、次に実行する処理を選びます。
【例】ツール選択、エスカレーション、モデル選択、担当キューへの振り分け
・Search(検索)
自然言語の条件に合う項目を探します。
【例】セマンティック検索、文書検索、候補データの抽出
・Retrieval(取得)
後続の処理に必要な、関連性の高い情報やレコードを取り出します。
【例】RAG用コンテキスト、根拠となる文書、ナレッジ検索
・Ranking(ランキング)
複数の候補を、関連度や品質などの順に並べます。
【例】検索結果、レコメンド、採用候補者の優先順位付け
・Verification(検証)
入力や出力などの対象をチェックし、特定のエラーや問題がないか確認します。
【例】引用の正しさ、ポリシー違反、ツール呼び出しエラー、回答品質
・ML Feature Extraction(ML特徴量抽出)
文章から意味的な特徴を取り出し、別の機械学習モデルの入力として利用します。
【例】購入意欲、商品への関心、競合圧力、解約兆候
・Structured Data Extraction(構造化データ抽出)
文章などの非構造化データから、決められた項目を取り出します。
【例】候補者の属性、注文情報、文書ラベル
7. AIエージェントから使う
7-1. Agent Skillとは
TypeSafeでは、Claude CodeやCodexなどのAIエージェント向けに、公式の「TypeSafe Agent Skill」も提供しています。
Agent Skillを導入すると、コーディングエージェントがTypeSafeの、
・Choice / Score / Noulの使い分け
・Jevの設計パターン
・StateやQuestionsの設計方法
・確率やconfidenceの扱い方
・API / SDKを使った実装方法
などを参照しながら、Jevを使った設計やコードの提案・実装を行いやすくなります。
7-2. Agent Skillのインストール
・Claude Code
Claude Codeでは、次のコマンドでインストールできます。
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
インストール後は、プロンプトで、
TypeSafeスキルを使用してください。
と指定して利用できます。
Claude Codeでは、次のコマンドから直接Skillを呼び出すこともできます。
/typesafe:typesafe-ai・Codexなど
Codexなど、その他の対応エージェントでは次のコマンドを使います。
npx skills add typesafe-ai/skills --skill typesafe-ai実行すると利用するエージェントを選択できます。
デフォルトではプロジェクト単位でインストールされます。グローバルにインストールする場合は -g を付けます。
7-3. Agent Skillを使った開発
公式ドキュメントでは、まずプロジェクトを分析して、TypeSafeを利用できそうな場所を探させる方法が紹介されています。
TypeSafeスキルを活用してプロジェクトを調査し、複雑なパース処理やその他の壊れやすいコードの代わりに、インテリジェントな判断(intelligent judgement)を適用できる箇所を見つけてください。
たとえば既存のコードに、
・大量のif文による分類
・自然言語を無理にパースしている処理
・LLMに文章を生成させてからJSONとして解析している処理
などがあれば、Jevの型付き判断に置き換えられないかをエージェントに検討させることができます。
APIキーを TYPESAFE_API_KEY に設定しておけば、エージェントに実際のAPIを試させながら、利用方法を検討させることもできます。
TypeSafeスキルを使用し、`TYPESAFE_API_KEY`としてエクスポートしたTypeSafe APIキーを使っていくつかの実験を行ってください。その中で最も有望な結果に基づき、変更案を提案してください。
TypeSafeのCookbookを参照して、現在のコードに使える設計パターンを探させる使い方も紹介されています。
7-4. Agent Skill利用時のポイント
TypeSafe公式ドキュメントでは、Agent Skillを使った開発でも、エージェントにすべて任せるのではなく、人間がQuestionsやしきい値を確認することを推奨しています。
特に、
・Questionsとしきい値を1か所にまとめる
・エージェントが作ったQuestionsを人間も確認する
・エージェントの仮定をそのまま信用せず検証する
ことが重要とされています。
Jevでは、コードそのものだけでなく「何をどのような基準で判断させるか」が動作に大きく影響するため、Questionsやしきい値をレビューしやすい形にしておくのがポイントです。
