高速な判断に特化したAI - TypeSafe「Jev」 と System One Model

高速な判断に特化したAI「Jev」と「System One Model」についてまとめました。
1. はじめに
2026年9月15日、TypeSafe AIが新しいAIモデル「Jev」を発表しました。
Jevの特徴は、ChatGPTのように文章を生成するのではなく、
入力された状況から、型付きの判断とその確率を高速に返す
ことに特化している点です。
応答時間はTypeSafeの公表値で70〜500ms。DOOMを約10回/秒で操作するリアルタイムデモも公開されています。
Jev plays doom in realtime and it looks like an actual player.
— Ziwen (@ziwenxu_) September 16, 2026
their numbers: 20 to 200x faster, 40 to 400x cheaper, output tokens free.
Two things we might see now:
- the opponent we're up against in a game might be a realtime AI.
- a TA, or anything else we'd hire a real… https://t.co/7lGVwjdh3k
今回は、Jevとは何なのか、なぜ高速なのか、そしてLLMとはどのように使い分けるのかを見ていきます。
2. Jevとは
2-1. 文章ではなく「判断」を出力する
「Jev」は、TypeSafe AIが開発した「System One Model」と呼ばれる新しい種類のAIモデルです。
一般的なLLMは、
入力
↓
トークンを1つずつ生成
↓
文章 / JSON / コード
という処理を行います。
一方、Jevは文章ではなく、判断そのものを出力します。
State(現在の状況)
+
Questions(判断してほしいこと)
↓
Jev
↓
型付きの判断 + 確率
たとえば「商品が壊れていたので返金してほしい」という問い合わせに対して、
返金要求か?
どの部署へ送るか?
人間による確認が必要か?
と質問すると、
{
  "refund": {
    "type": "noul",
    "noul": 0.97
  },
  "department": {
    "type": "choice",
    "choice": "billing",
    "probabilities": {
      "billing": 0.82,
      "technical": 0.12,
      "other": 0.06
    },
    "confidence": 0.71
  },
  "human_review": {
    "type": "noul",
    "noul": 0.31
  }
}
のような判断を取得するイメージです。
TypeSafeはこれを「非構造化された状態を入力し、型付きの確率的な判断を出力する」(unstructured state in, typed probabilistic decisions out) と表現しています。自然言語などを含む状態を入力し、プログラムから直接利用できる型付きの確率的判断を出力します。
2-2. System One Model
「System One」という名前は、Daniel Kahnemanの『Thinking, Fast and Slow』で知られる「System 1 / System 2」の考え方に由来します。
System 1は高速で直感的な判断、System 2は時間をかけた熟考を表します。
Jevも長い推論や文章生成ではなく、
状態
↓
高速に判断
↓
プログラムが実行
という短いループを繰り返すことに重点を置いています。
2-3. ベンチマーク
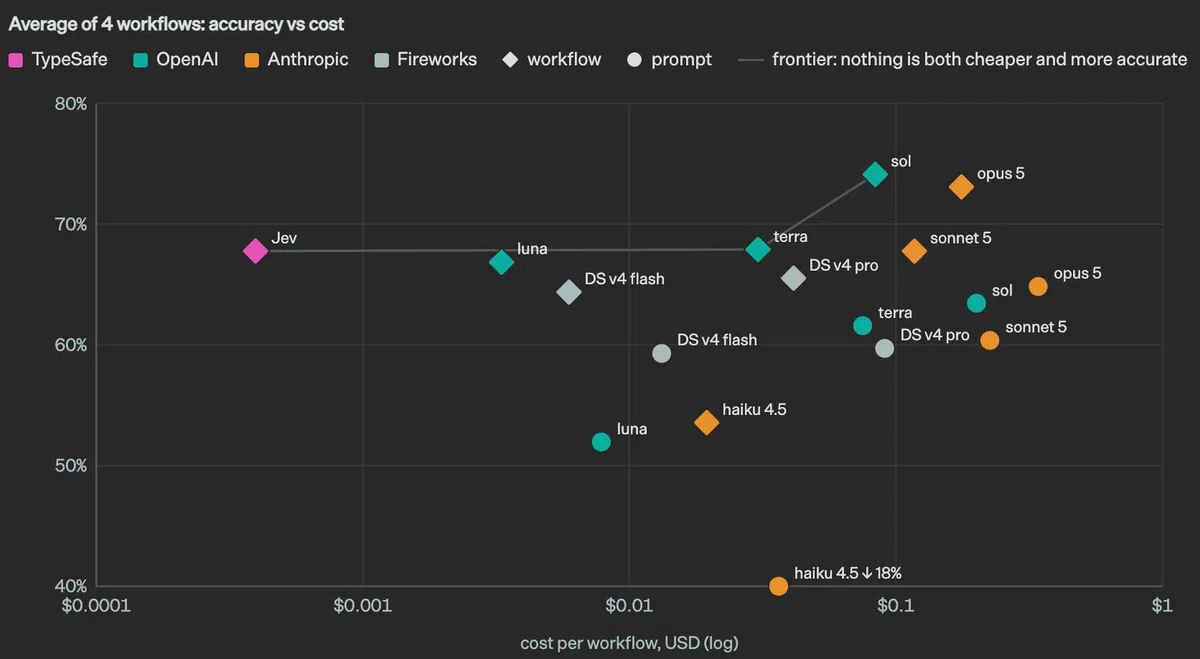
公式ベンチマークでは、判断タスクの一致率は Jev 67.8%、GPT-5.6 Terra 67.9% とほぼ同水準です。
3. なぜ高速なのか
3-1. 応答時間は70〜500ms
TypeSafeが公表しているJevのエンドツーエンドの応答時間は70〜500msです。System One型のクエリでは、同程度の知能レベルとして比較したLLMより40〜200倍高速になる場合があるとしています。
また、TypeSafeのWorkflow Evalsでは、特定のワークフローで最大193.6倍高速、444.6倍低コストという結果も報告されています。
ただし、これはJevが常にLLMより193.6倍高速という意味ではありません。TypeSafe自身も、実際のユースケースでは改善幅の上限に近い結果だろうと説明しています。
3-2. 複数の判断を並列に出力する
一般的なLLMは、基本的に出力トークンを順番に生成します。
入力
↓
トークン1
↓
トークン2
↓
トークン3
↓
...
一方、JevはTypeSafeが「parallel sampler」と呼ぶ仕組みを採用しています。
現在の状態
↓
・敵がいる? → 0.96
・攻撃する? → 0.84
・左へ行く? → 0.13
・右へ行く? → 0.81
複数の判断を文章として順番に生成するのではなく、並列に出力します。
文字列をトークン単位で順番に生成せず、複数の判断を並列に出力する設計が、Jevの高速性につながっています。TypeSafeは、この高速な判断出力を実現するため、新しいモデルアーキテクチャやRLCDと呼ばれる学習手法も採用しています。
4. DOOMをリアルタイム操作
4-1. 約10Hzで判断を出力する
Jevの特徴が分かりやすいのが、TypeSafeが公開している「DOOM」のデモです。
このデモでは、Jevへの問い合わせを1秒間に約10回(10 Hz)行っています。つまり、平均して約100msに1回のペースでJevへ問い合わせ、
ゲーム状態
↓
Jev
↓
判断
↓
ゲーム操作
↓
新しいゲーム状態
↓
...
というループを繰り返しています。
TypeSafeによると、このDOOMデモを毎秒10クエリで動かした場合のコストは約7ドル/時です。
ただし、JevがDOOMの画面を直接見ているわけではありません。現在のデモでは、ゲーム状態を構造化されたデータとテキストとしてJevへ渡しています。
4-2. リアルタイムAIへの応用
この速度なら、ゲーム以外にもリアルタイムに近いAI判断へ応用できます。
たとえばロボットなら、
掴む?      → 0.91
危険?      → 0.03
停止する?  → 0.02
対象A?     → 0.88
といった判断を繰り返す構成が考えられます。
100ms前後では、モーターを直接動かす高速なサーボ制御には向きません。一方、対象物の選択、行動の切り替え、異常検出、タスク判断など、数Hz〜10Hz程度の上位レベルの判断には利用できる可能性があります。
なお、70msという速度はTypeSafeのサービス拠点に近い米国西海岸などから測定した値です。日本からクラウドAPIを利用する場合はネットワーク遅延も加わります。
5. LLMとは何が違う?
5-1. 判断の出力に特化する
現在のLLMにも、JSON Schemaなどで出力形式を固定する「Structured Outputs」があります。
そのため、Jevの特徴は単に「JSONを壊さない」ことではありません。
LLMは、
文章・コードなどを生成
↓
必要なら出力形式を制約
するモデルです。
Jevは、
判断
↓
Choice / Score / Yes-Noなど
↓
確率付きでプログラムへ
という設計です。
LLMが構造化データをトークン列として生成するのに対し、Jevは最初からソフトウェアが利用する型付きの判断と確率を出力することに特化しています。
5-2. 「ハルシネーションしない」の意味
TypeSafeはJevについて「ハルシネーションしない」(can't hallucinate) とも説明しています。
ただし、「Jevは判断を間違えない」という意味ではありません。
TypeSafeは、自由な文字列を生成せず、事前に定義された型や選択肢以外を出力しないことを「ハルシネーションしない」と表現しています。
ただし、これは一般的な意味での事実誤認がなくなることを保証するものではありません。型や形式が正しくても、誤った選択肢を選ぶ可能性はあります。
つまり、「型が正しい」ことと「判断が正しい」ことは別です。
6. LLMと組み合わせる
JevはLLMを置き換えるというより、組み合わせる使い方が考えられます。
ユーザー
↓
Agent
→ Jev (高速な分類・判断)
→ LLM (推論・文章・コード生成)
たとえば「このメールは重要か」「次のツールを実行するべきか」「結果に問題がないか」といった小さな判断はJevに任せ、複雑な推論や文章生成が必要なときだけLLMを呼び出します。
TypeSafeはこうした用途を「スマートなif文」(smart if-statements) とも表現しています。JevをAI版のif文として、アプリケーションのさまざまな場所に配置するイメージです。
7. まとめ
Jevは、文章生成ではなく高速で型安全な確率的判断に特化したAIモデルです。70〜500msの応答時間と、DOOMを約10Hzで操作するデモは、AIをゲームやアプリケーションの処理ループに組み込む可能性を示しています。
現在はEarly Accessで、性能値の多くはTypeSafeによる評価ですが、
「高性能なAIを1回呼ぶ」のではなく、
「小さなAI判断を大量かつ高速に呼ぶ」
という考え方は、AIエージェントやゲーム、ロボットにおけるリアルタイムAIの新しいアプローチとして注目されます。
関連
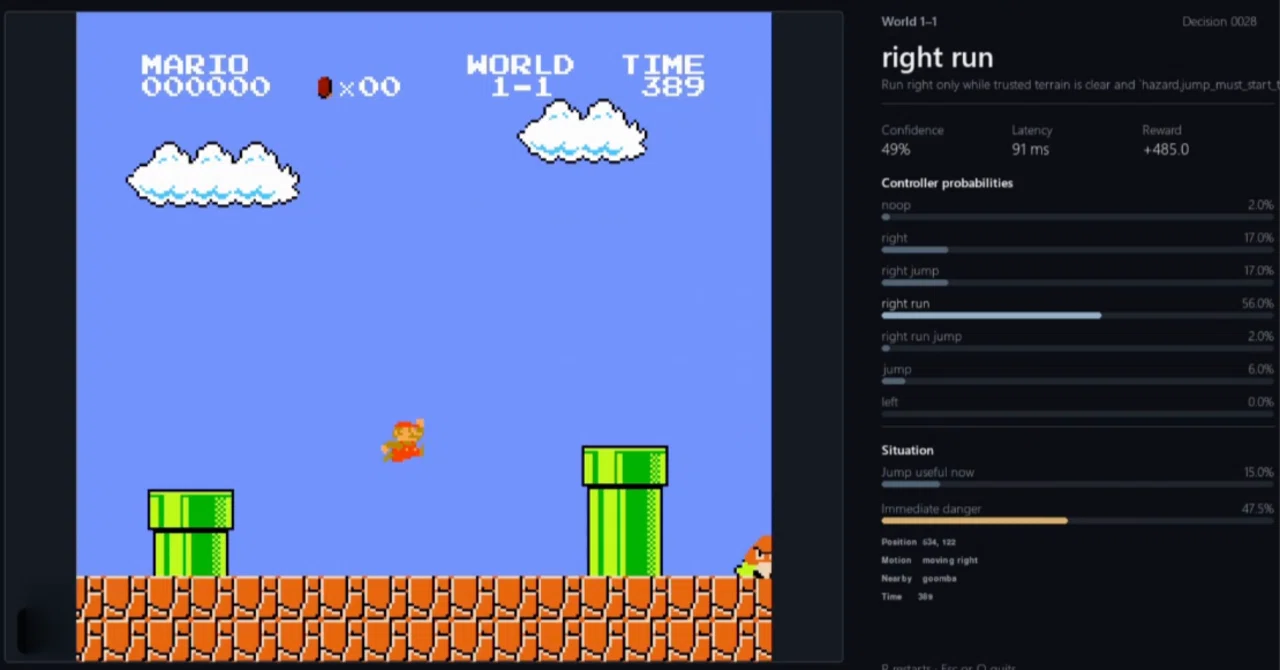
got @typesafeai’s new model Jev to play Super Mario Bros.
— Faadil Shaik (@faadilhshaik) September 16, 2026
fast inference + structured outputs makes it surprisingly good for real time use cases.
I'm excited to see what can be done with these new models! pic.twitter.com/wXXW2SsSXG
Typesafe AIのJev、選択をやるモデルってことで一旦オセロさせてみた(白: Jav、黒: ランダム)
— 𝑺𝒉𝒊𝒃𝒂 (@4ba_ba_baba) September 16, 2026
盤面の状態を与えて確率が一番高いマスに手を打っている
赤ヒートマップがJavの予想、青がαβ剪定付きネガマックス探索による予想 https://t.co/t5cPQC3Ngx pic.twitter.com/fr44PhOQZf
