NDAのある仕事でAIを使う①— 2026年、ローカルLLMが実務ラインに乗った日|Meta「Muse Glimmer」30Bを検証

こんにちは、STUDIO55技術統括の入江です。
この記事は、8月11日から執筆を始めています。
理由は、前日(8月10日)に Metaが、ローカル環境でのAI活用をさらに後押しする新しいAIモデル 「Muse Glimmer」 を公開したからです。
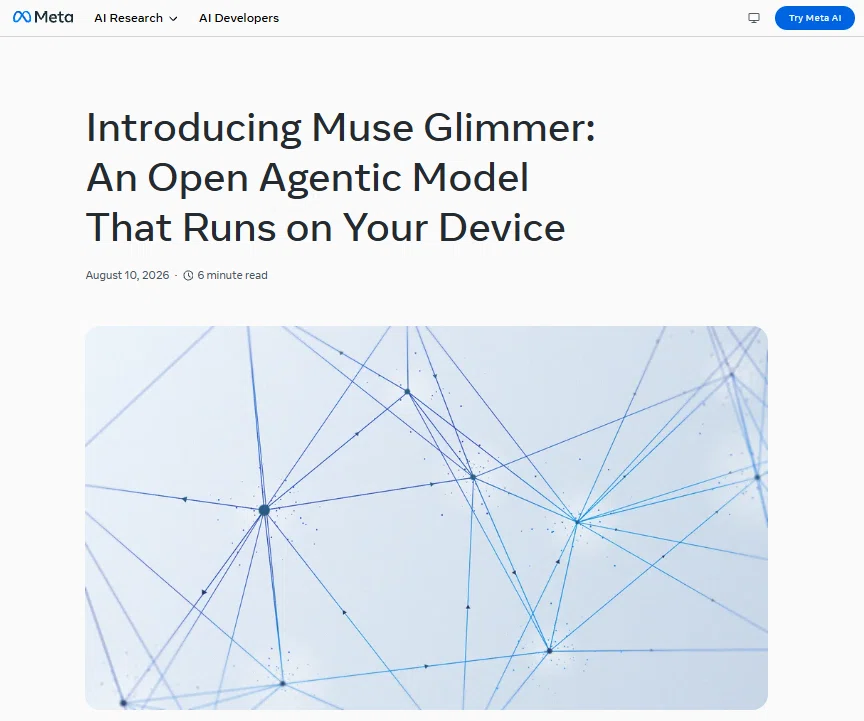
ロイター(Reuters)では、このモデルを
"designed to run agentic tasks on a Mac or PC with a single graphics card"
(直訳)
コンシューマ向けGPUを1枚搭載したMacやPCで、エージェントAIを動かすことを目的として設計されたモデル
──と紹介しています。
私はこれまで、NDA(秘密保持契約)のある案件を扱う立場から、ローカルLLMの進化を継続して追ってきました。
しかし、エージェント向けに設計された30Bクラスのモデルを、一般的なRTX搭載PCで動かせる時代が、ここまで早く来るとは思っていませんでした。
そこで今回は、公開された「Muse Glimmer」を実際に検証し、そのゲームチェンジャーとしての可能性を探ります。
その上で、なぜ今ローカルLLMが注目を集めているのか、そして企業がAIを安全に活用するためには何を押さえておくべきなのかを、全3回にわたって掘り下げていきます。
🤖AI は「できること」から「安全に使えるか」の時代へ
今年に入り、AI は「エージェント本格実用化の時代」(AI 2027) に入り、仕事に対する考え方や、実際の業務の進め方そのものを大きく変え始めています。
そして、この夏(2026年8月)には、その流れが個人のローカルPCにも及びました。
エージェントAI をダウンロードし、クラウドに依存せずローカル環境で実行できることが、現実的な選択肢 になったのです。
いま AIの進化をめぐる議論の中心は、単に「AI に何ができるのか」という段階から、「AI を仕事で使っても安全なのか」という問いへと移りつつあります。
ローカルAI時代がもたらす変化と、その背景
メーカーが AIモデルを無償で提供し、誰もがそれをダウンロードして自分のPCで利用できる──こうした状況は、もはや珍しいものではありません。
AI の普及によって、「商品」の提供のあり方そのものが大きく変わりました。
従来であれば、高性能なソフトウェアはライセンスを購入して利用するのが一般的でした。しかし現在では、高性能なAIモデルそのものが無償で公開されるケースが増え、それを自由に利用できる時代になりました。
ローカル環境で動作するAIモデルまで無償で提供されるようになったことも、これまでとはまったく異なる「商品」の考え方によるものです。
メーカーが AIモデルを無償で提供する目的の 1つは、市場シェアの獲得です。
特に、機密情報をクラウドへ送信できないため生成AI の利用を控えていた企業や組織に対し、ローカル環境という新たな選択肢を提供することで、これまで取り込めなかった潜在需要を獲得する狙いがあります。
しかし、その目的は市場シェアだけではありません。
例えば Meta は、AIモデル自体を直接の収益源としていません。同社の収益の柱は広告事業であり、高性能なAIモデルを無償で公開しても、直接的な売上を失うわけではありません。一方で、モデル販売やAPI利用料を主要な収益源としている OpenAIや Anthropicには価格競争というプレッシャーを与えることができます。
つまり、自社のビジネスを大きく傷つけることなく、競合の収益基盤に圧力をかけられるという戦略です。
NVIDIA が AIモデルや開発ツールを積極的に公開している背景にも、同様の構図があります。ローカル環境で AIを実行するユーザーが増えれば、高性能GPUの需要も拡大します。モデルを無償で提供することが、最終的にはGPU販売という本業の成長につながるからです。
このように、AIモデルの無償公開は単なる「無料サービス」ではなく、それぞれの企業が自社のビジネスモデルに基づいて展開する戦略の 1つと言えます。
また、実務的に押さえておきたいのは、「無償」と「オープンソース」は同義ではないという点です。
現在、多くのモデルは「オープンウェイト」という形で公開されています。
これは学習済みモデルの重み(Weights)は公開されているものの、学習データや学習コードまでは公開されていないという形態です。つまり、無償で利用できるからといって、すべてがオープンソースというわけではありません。
では、利用者にとってローカルAIにはどのようなメリットがあるのでしょうか。
代表的なメリットは次の 4つです。
オフラインでも利用できること
インターネット接続がない環境でも利用でき、クラウドサービスへの依存を減らせます。低レイテンシで高速に応答すること
ネットワークを介さずPC上で処理するため、応答速度が速く、快適な操作が可能になります。サービス終了や利用制限の影響を受けにくいこと
クラウドサービスの仕様変更やAPI料金の改定、サービス終了などに左右されにくく、継続的に利用できます。自由に制御・カスタマイズできること
モデルの選択や更新、エージェントの構成などを利用者自身が管理でき、自社の用途に合わせた柔軟な運用が可能になります。
特に企業においては、「機密情報をクラウドへ送信できない」という理由から生成AI の導入を見送っていたケースも少なくありません。ローカルAI の普及は、こうした課題を解決する有力な選択肢となりつつあります。
このように、メーカー側には市場拡大や競争戦略というメリットがあり、利用者側には安全性や利便性、継続性というメリットがあります。
両者の利害が一致したことで、ローカルAI は単なる技術的な進歩ではなく、新しい AI活用のスタンダードとして急速に普及し始めているのです。
AI を扱うセキュリティの観点について
無邪気にAI を使う時代はそろそろ終わりを迎えようとしています。
AIの影響力は、もはや一つのサービスや技術の範囲を超え、社会全体、さらには国家レベルにまで及んでいます。
だからこそ、これからは「AIは便利」という理由だけで、何も理解せずに使ってよいのか。その問いが、次の社会的な共通認識として求められるようになっていくでしょう。
AI におけるセキュリティは、一言で「安全」「危険」と判断できるものではありません。
「商用利用可と書かれているから安心」
「有料課金しているから大丈夫」
それだけで、安全性を判断することはできません。
だからこそ、AIを使う前に「何を確認すべきなのか」を知っておく必要があります。
私がこれまで調べてきた中でも、とくに気になったのが、次のようなポイントです。
データはどこへ送信されるのか
CDNなど、どのような経路を経由するのか
入力データは AIの学習に利用されるのか
人間がデータを見る可能性はあるのか
データやログは保存されるのか
ZDR(Zero Data Retention)に対応しているのか
データの削除を要求した場合、完全に削除されるのか
サブプロセッサ(再委託先)は開示されているのか
海外へデータが転送されるのか
どの国で処理・保存されるのか
どの法域を経由するのか
日本の個人情報保護法上、どのように扱われるのか
再委託先やクラウド事業者はどこなのか
DPA(Data Processing Agreement)や SCC(Standard Contractual Clauses)は整備されているのか
そして、そもそも「商用利用可能」と「企業が安全に利用できる」は同じ意味なのか
── 挙げればいくつもあります💦
そして、これらの問題の多くは、AI がクラウド上で動作していることと深く関係しています。
クラウド型AI では、入力したデータはインターネットを経由して外部サーバーで処理されます。そのため、機密情報や個人情報、未公開の設計データなどを扱う企業では、単に「便利だから使う」という判断だけでは済みません。
もちろん、クラウドAI が危険というわけではありません。多くのサービスでは暗号化や厳格なセキュリティ対策が講じられています。しかし、企業によっては「社外へデータを送信すること自体」がセキュリティポリシーや契約上の制約に抵触する場合があります。
そのため、AI を業務に導入する際には、データの保存先や利用目的、学習への利用有無など、さまざまな項目を確認する必要があります。
「学習に使われるか」だけでは足りない
では、法人プランを契約していれば安全なのかというと、話はそう単純ではありません。
2026年時点の各社ポリシーを整理すると、だいたいこうなります。
無料プラン・個人プランは、主要サービスのいずれも入力が学習に使われる可能性がある(オプトアウト設定は可能)
法人プランおよび API経由の利用では、入力データは学習に使われない
ただしデータの保持期間はサービスごとに異なる。機密性が高い場合は ZDR(Zero Data Retention)オプションの有無まで見る必要がある
ここで注意したいのは、個人プランのオプトアウトと、法人プランは、同じものの代わりにはならないという点です。
オプトアウトで得られるのは「学習に使わない」の一点だけです。
法人プランには、それに加えてDPA(データ処理契約)が付随します。データの扱いが個人の設定ではなく、組織の契約として担保される。
この差は実務で効きます。
オプトアウトはユーザーごとの設定です。そのため、新しいメンバーがアカウントを作成すれば初期設定に戻りますし、既存ユーザーが設定を変更しても組織として把握・管理することはできません。
クライアントから「どのような契約のもとでデータが処理されるのか」と尋ねられた際に、組織として説明責任を果たせるかどうかも、こうした管理体制の有無によって大きく変わります。
つまり、プランの価格帯ではなく、
どの規約が適用されるアカウントかが境界を決めている
ということです。
そのうえで、私はこう考えています。
リスクは「漏れる/漏れない」の二値ではない。
データの機密度 × 経路 のマトリクスで、置き場所を決める問題である。
「AI は危ないから禁止」も、「法人プランだから何を入れても安全」も、 どちらもリスクを単純化し過ぎています。
重要なのは、AI をどう安全に利用するかという「ガバナンス」です。
📢AIを取り巻くセキュリティ環境の変化
こうした背景から、世界各国でAIを取り巻くセキュリティへの取り組みや法整備も本格化しています。
これらの動向を把握しておくことは、AIを安全に業務へ取り入れていく上で、重要な判断材料となります。
ここでは、現在のAI を取り巻くセキュリティの動向についても、いくつか押さえておきたいと思います。
「10大脅威」に入ってきたAI
IPAが毎年発表している「情報セキュリティ10大脅威」があります。
その 2026年版(組織編)で、
「AIの利用をめぐるサイバーリスク」
が初めてランクインしました。
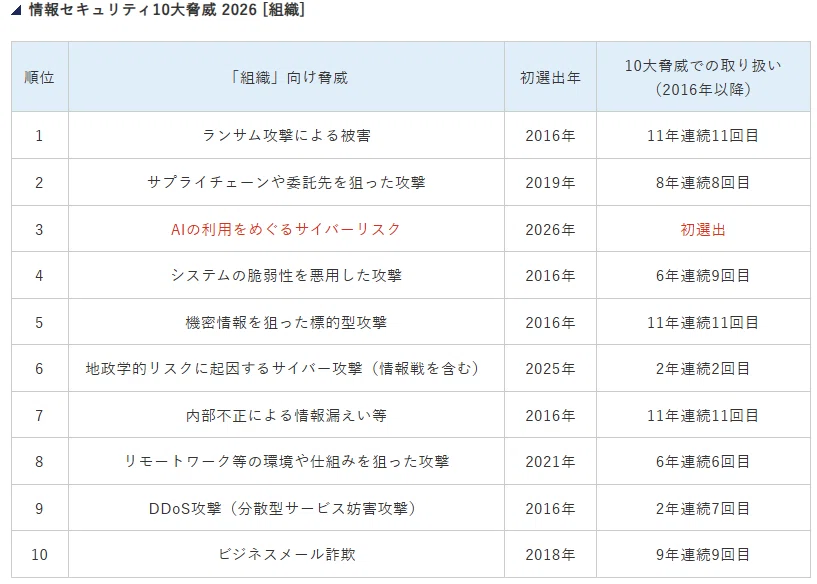
これまで専門家や有識者の間で議論されてきた AIに関するリスクが、いよいよ 企業が対策すべき具体的な情報セキュリティ上の脅威として位置づけられる段階に入ったことを示しています。
思い出されるのは 2023年のサムスン電子の件でしょう。
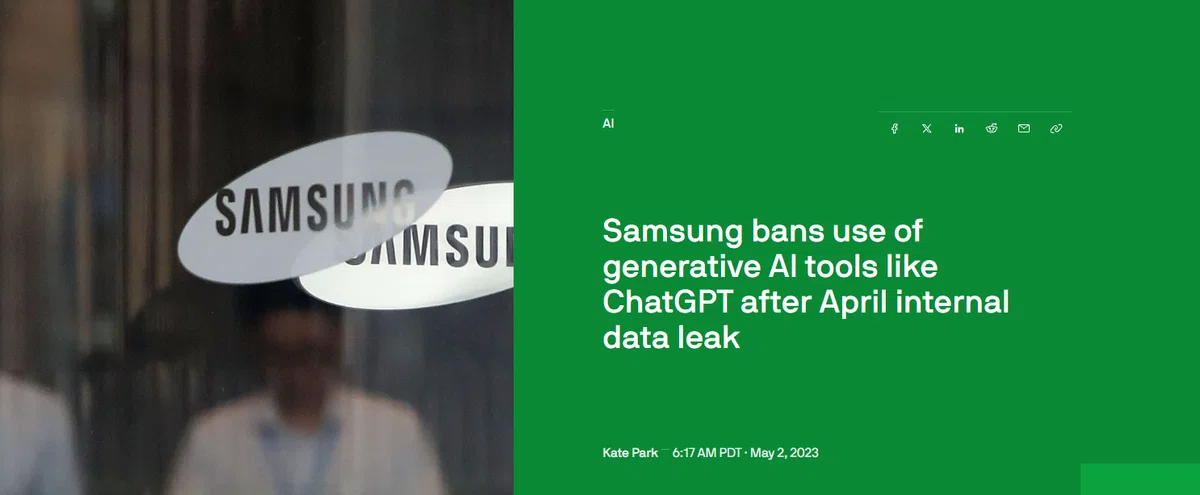
半導体部門のエンジニアが、バグ修正のために社内の機密ソースコードをChatGPTに貼り付けた。当時の利用規約では入力データが学習に使われる可能性があり、結果として社内利用が全面禁止されました。
この事例が象徴的なのは、悪意が一切登場しないことです。彼は仕事を早く終わらせようとしただけでした。
つまり、AI時代のセキュリティリスクは、悪意のある攻撃者だけが生み出すものではありません。善意の社員が「便利だから」という理由でAIを使った瞬間にも発生します。
そしてもうひとつ、開示の話
その考え方は、情報漏えい だけに留まりません。
AI を利用していることを利用者へどのように伝えるのか。AI が生成したコンテンツを、どのように識別できるようにするのか。こうした「透明性」も、これからの AI活用において企業やAI事業者に求められる重要な責任になりつつあります。
その象徴ともいえるのが、
2026年8月2日から適用が始まった「EU AI Act 第50条」です。
第50条 では、一定の AIシステムについて、AI と直接やり取りしていることを利用者に明示することや、AI によって生成・加工されたコンテンツを機械的に識別できるようにすることなどが求められています。ディープフェイクについても、AI によって生成・加工されたものであることを人が認識できる形で開示する必要があります。
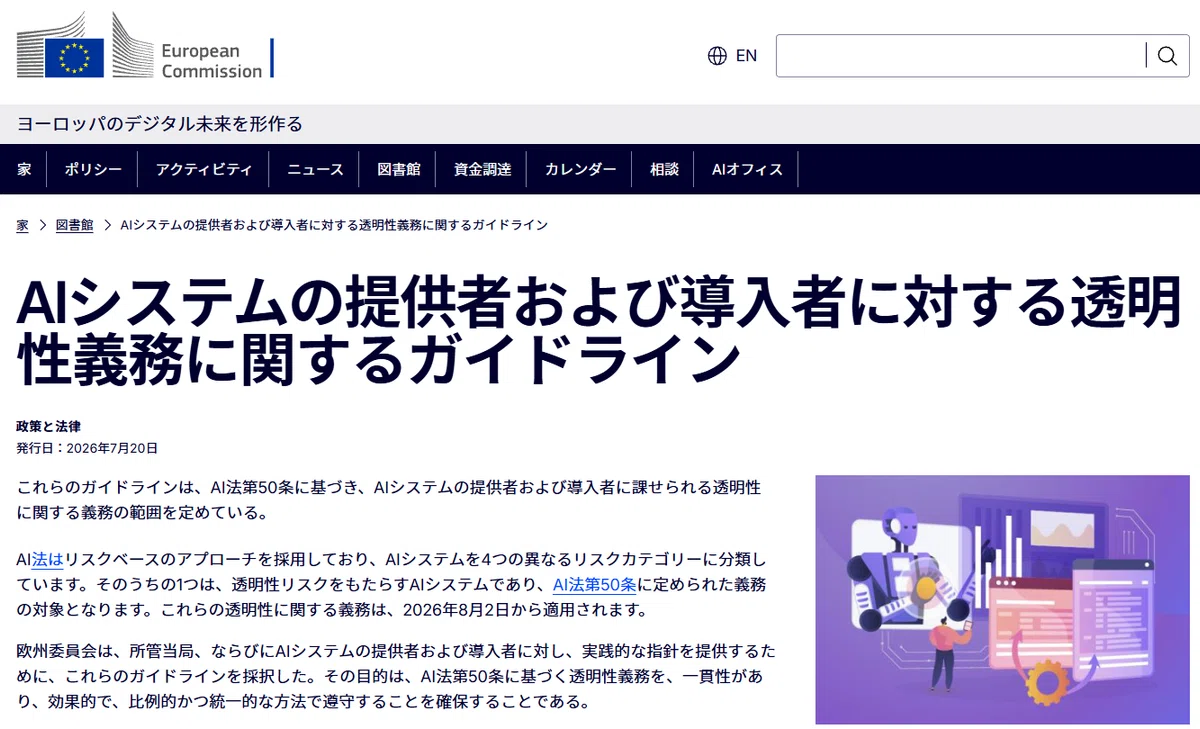
「Guidelines on transparency obligations for providers and deployers of AI systems」
海外案件や、海外企業と取引のある日本企業の案件では、これは「いつか考えること」ではなく、見積もりや納品仕様に盛り込むべき内容になりつつあります。
第50条で求められること(概要)
2026年8月2日から、AIを提供・利用する事業者には主に次のような透明性義務が課されます。
・AIと会話していることを利用者に明示する(チャットボットなど)
・AI生成コンテンツであることを識別できるようにする
・ディープフェイクなどはAI生成であることを明示する
・AI生成コンテンツに機械判読可能な識別情報(ウォーターマークやメタデータなど)を付与する
これは単なる「AIを使っています」という表示の話ではありません。
AI によって生成されたコンテンツそのものに、後から識別できる仕組みを組み込む── つまり、AI を使っている事実を人間に伝えるだけでなく、コンテンツが AIによって生成されたものであることを、機械的にも確認できるようにする方向へ進んでいるのです。
そして、こうした法規制は、すでに AIサービスそのものの仕様にも影響を与え始めています。
例えば Anthropicは、EU AI Actへの対応として、Claudeが生成するテキストに機械検出可能な不可視ウォーターマークを組み込む取り組みを発表しました。(2026年8月14日)
文章の意味や見た目を大きく変えることなく、生成時の単語選択に統計的なパターンを持たせることで、AIによって生成されたテキストであることを検出できるようにする仕組みです。画像についても、C2PA などを利用したデジタル来歴情報の付与が進められています。
重要なのは、こうしたルールや技術が現在進行形で変化していることです。
AI の性能だけを追いかけていると、気付いたときには「使えるかどうか」ではなく、「どのような条件で使うのか」を問われる時代になっているかもしれません。
では、こうしたセキュリティや透明性をめぐる環境の変化を踏まえたうえで、実際にローカルで動作するAIモデルはどこまで実用になるのでしょうか。
ここからは、Metaが公開したMuse Glimmerを実際の環境で動かし、その性能だけでなく、「どこで処理するのか」「どのように扱えるのか」という実務的な観点からも検証していきます。
🚀昨日、Metaが出したもの
2026年8月10日、
Meta が公開した「Muse Glimmer(ミューズ・グリマー)」は、
パラメータ数 30B
ライセンスは Apache 2.0
Meta Superintelligence Labs としては 初のオープンウェイトモデルです。
数字だけ見ると「また新しいモデルが出た」で終わる話です。
実際、この半年だけでも GLM-5.2、Kimi K3、Qwen3.6、Gemma 4と、オープンウェイトモデルのリリースは追いきれないペースで続いています。
※Qwen3.8 については、また別回でお知らせします。
ただ、今回の Glimmerは少し性格が違いました。
30Bのモデルをフル精度で動かそうとすると、通常は 55GB以上のメモリを要求します。Metaはこれを 4bit程度まで圧縮したうえで、ブロック単位の投機的デコードを組み合わせ、VRAM 24GBのコンシューマ向けGPU1枚、あるいは Mac1台で動くところまで落とし込んできました。
しかも画像入力に対応していて、スクリーンショットや図表、ドキュメントを読ませられる。コンテキスト長は131,072トークン以上。
ベンチマークでは、ツール呼び出しの精度を測る MCP Atlasで 75.5。同クラスの Gemma4-31Bが 54.2、Qwen3.6-27Bが 62.5ですから、agentic な用途に振った設計思想がそのまま数字に出ています。
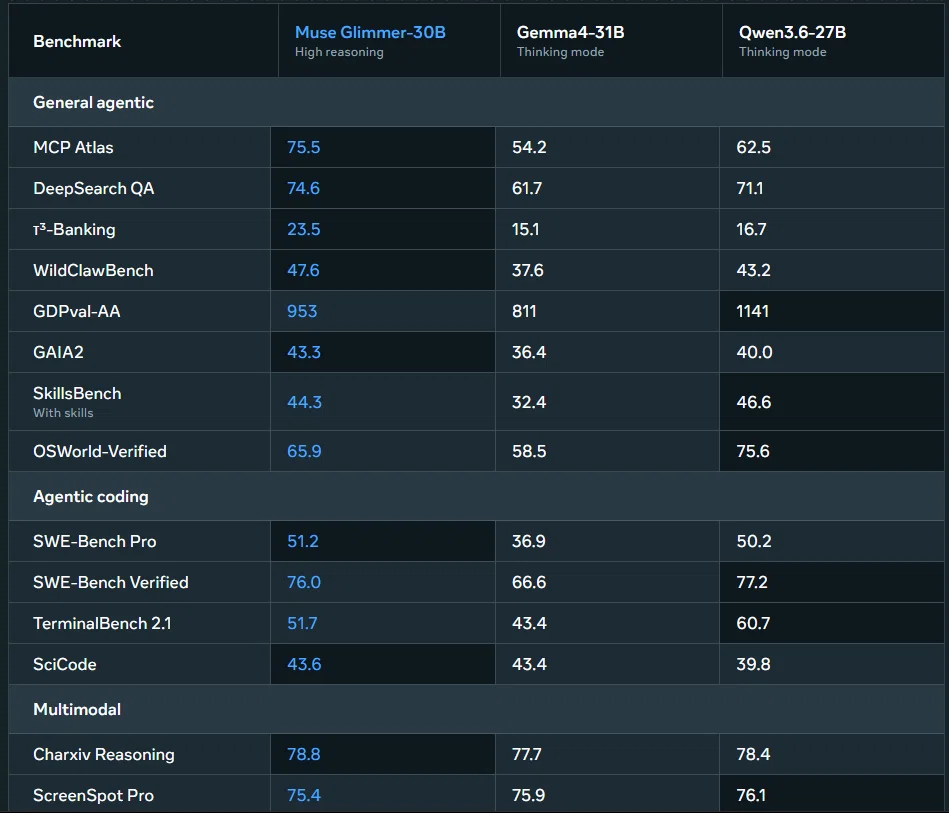
つまり Metaは、開発者のワークステーションを「小さいモデルを試す実験場」ではなく「エージェントを常駐させる本番環境」として扱い始めた わけです。
これは単なる新しい AIモデルの登場ではありません。
「AIをクラウドで利用する時代」から、「AIを自分たちの環境で安全に運用する時代」への転換点 を象徴する出来事です。
Muse は「創造のインスピレーション」を意味し、
Glimmer は「かすかな輝き」や「兆し」を意味します。
つまり、Muse Glimmer という名称には、
「創造性のきらめきを生み出すAI」
という意味が込められているのでしょう。
モデル名からも、「人の代わりに考えるAI」ではなく、人の創造性を支援し、自律的なエージェントとして行動するAIというコンセプトを表現したネーミングと考えられます。
これまでクラウド上で実行することが前提だったエージェントAIを、一般的なコンシューマ向けハードウェアのローカル環境で動かせる時代 が、いよいよ現実になりました。
✅「実務で使える」とはどういう状態か
2024年頃の ローカルLLMは、正直に言って「動いたこと自体が楽しい」フェーズでした。
7Bモデルを量子化して動かし、日本語が返ってくるだけで感動する。
しかし、実案件へ投入しようとすると話は別です。
その前提が、この1年で大きく変わりました。
そもそも「使える」の合格ラインをどこに引くか
ベンチマークのスコアが高いことと、実務で使えることは別の話です。
ここを混同すると、数字を見て導入し、3日で使わなくなります。
私が実際に線を引いている基準は、以下の 4つです。
① 待たされない 思考が途切れない速度で返ってくるか。体感としては、要約や分類なら数十秒以内。ここを超えると人は「まあ自分でやるか」に戻ります。技術的な限界ではなく、習慣の問題です。
② 同じ入力に、同じ品質で返す 実務で怖いのは、平均点の低さではなく分散の大きさです。10回中8回よくても、残り2回が壊れているなら、結局10回とも人間が確認することになる。それでは工数が減りません。
③ 失敗したことが分かる モデルが間違えるのは前提として、間違えたときに「間違えている」と検知できる形式で出力させられるか。JSONで返させる、根拠となった原文を必ず併記させる、といった設計の話です。
④ 導入したことを忘れられる 毎回ターミナルを開いてコマンドを打つ必要があるなら、それは道具ではなく実験です。普段使っているエディタやファイラの中から、意識せず呼べる状態になって初めて定着します。
この 4つで見たとき、2024年のローカルLLMは ①こそ満たしても ②〜④が絶望的でした。
逆に言えば、この1年で変わったのは ②〜④です。
つまり、進化したのは「賢さ」だけではありません。
実務に耐えるための「安定性」と「運用性」が、ようやく追いついてきたのです。
🔍何が変わったのか
今回公開された「Muse Glimmer」によって、ローカルLLM界隈で何が変わったのかを、最初に整理しておきます。
①高価なサーバーが不要になった
量子化と推論の最適化が一気に成熟しました。
かつては「モデルサイズ×2GB」が必要メモリの目安でしたが、いまは 4bit前後まで圧縮しても品質の劣化が実用上無視できる水準に来ています。
冒頭のGlimmerが、本来 55GB以上を要求するはずの30Bモデルを24GBに収めてきたのは、その到達点として分かりやすい例です。
「動かすために巨大な機材を買う」から、「いま持っている制作用マシンで動かす」に変わった。
この変化が一番大きい。
②単発の生成から、手順を回す存在へ
より本質的な変化はこちらです。
かつての ローカルモデルは、文章を生成することはできても、ツールを呼び、結果を見て、次の手を決めるということができませんでした。
いまのモデルは、MCPをはじめとするツール連携を前提に訓練されています。
ファイルを読む、検索する、結果を受けて判断する。
この一連が回るようになったことで、「文章を書かせる相手」から「作業を任せる相手」に役割が変わりました。
実務に入ってくるのは、明確に後者になってからです。
AIは「生成AI」から「実行AI」へ変わり始めています。
③コンテキストが長くなった
10万トークンを超える文脈、つまり数百ページ規模の資料をまとめて扱えるようになったことで、仕様書と図面の凡例と過去のやりとりを、まとめて渡せるということです。
断片を渡して的外れな答えが返ってくる、という体験のかなりの部分は、実はモデルの知能ではなく渡した 情報量の問題でした。
④変わったのは、こちら側の使い方でもある
ただ、公平を期すと、モデルの進化だけではありません。
私自身が「万能な一台」を求めるのをやめました。
ローカルLLMをクラウドの完全な代替として見ている限り、いつまでも不満は消えません。GPT-5クラスやClaude Opusと比べれば、ローカルの30Bは当然どこかで劣ります。
しかし 実務で AIに投げているタスクを書き出してみると、その大半は最高峰の推論力を必要としていませんでした。
PDFから必要な項目を抜き出す
長いメールを要点3行にする
レンダリングのエラーログを分類する
過去の案件メモから該当箇所を探す
これらに天才は要りません。
要るのは、
速くて、
安定していて、
外へ出ていかないこと。
それだけです。
つまり「ローカルLLMはクラウドの劣化版」という評価軸そのものが間違っていました。
比べるべきは性能の絶対値ではなく、タスクに必要な性能を満たしているかどうかです。
そう考え方を切り替えた瞬間、ローカルLLMは「クラウドAIの代用品」ではなく、実務を支えるもう一人の作業者になりました。
🧪Glimmer に図面を読ませる
ここまでは一般論です。
本当に使えるのかどうかは、実物で試してみるしかありません。
ここからは、Muse Glimmer を実際にテストした内容を通して、その実力を検証します。
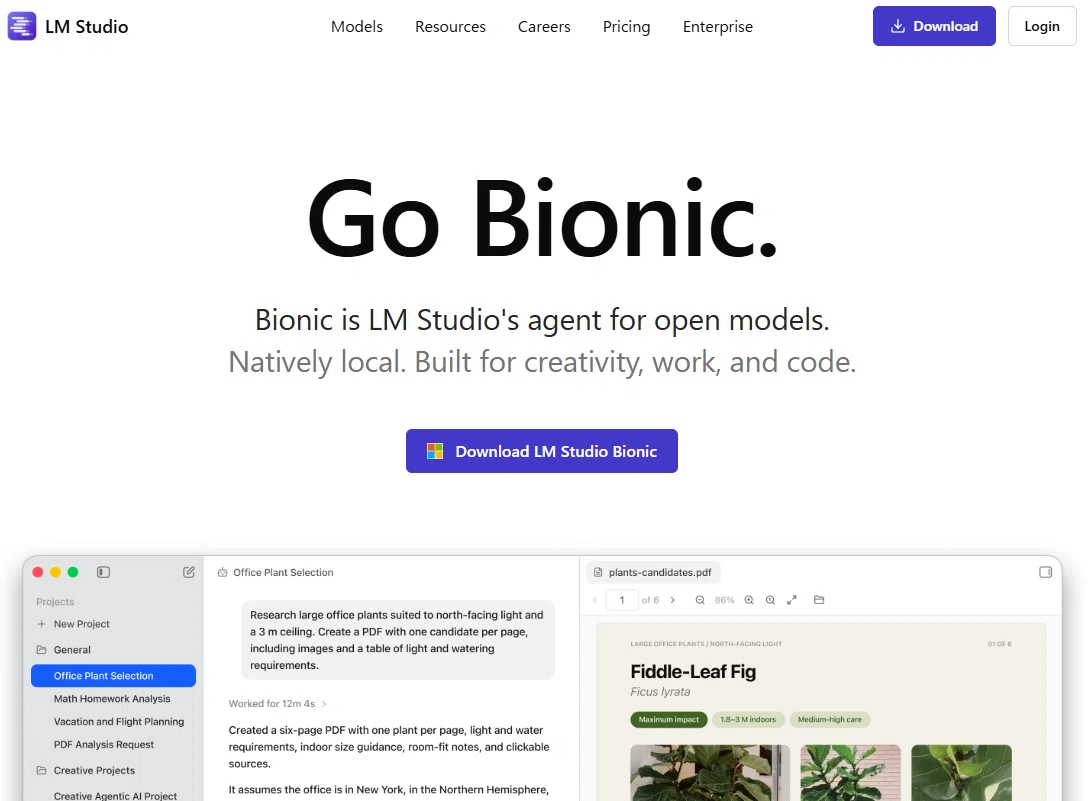
Muse Glimmer のエージェント機能は LM Studio Bionic以降で対応しています。すでにLM Studioを導入済みの場合も、最新版へ更新してから試してください。
💡補足. ローカル実行環境について
Ollama での実行環境についても触れておきます。
現時点で Ollama が対応しているのは、Apple Silicon向けの MLXエンジン経由の初期サポートのみです。NVIDIA・AMD向けについては、「数日中に対応予定」と案内されています。
そのため、今回の検証では、Windows + RTX環境での実行に対応しているLM Studioを使用します。
なお、LM StudioはGUI上から画像をドラッグ&ドロップしてモデルに入力できるほか、OpenAI互換APIサーバーを起動することもできます。そのため、Obsidian Copilotなど、OpenAI互換APIに対応したツールからローカルモデルを利用することも可能です。
過去物件の設計図一式 ── 集合住宅と店舗が入った高層の建物、配置図・各階平面・立面・断面までまとまったPDF ── を、そのままGlimmerに投げてみます。
もちろん、これは一般的なクラウド型AIには、そのまま投入するのをためらう情報です。
環境はWindowsのRTX搭載PC。
LM Studio上で、4bit量子化した30Bクラスのモデルを動かしています。
使用したプロンプトは、ごく素朴なものです。
この図面の内容を、建築CGパース制作の観点から説明してください。読み取れる室名・寸法・階数・外装材があれば挙げてください
正直に言うと、私はうまくいかないと思っていました。
図面PDFの中身は基本的に線画です。
そのままでは画像として認識できず、PDFを画像に変換するなどの前処理が必要になるだろう、と考えていました。
ところが、その予想は一回目のテストで崩れました。
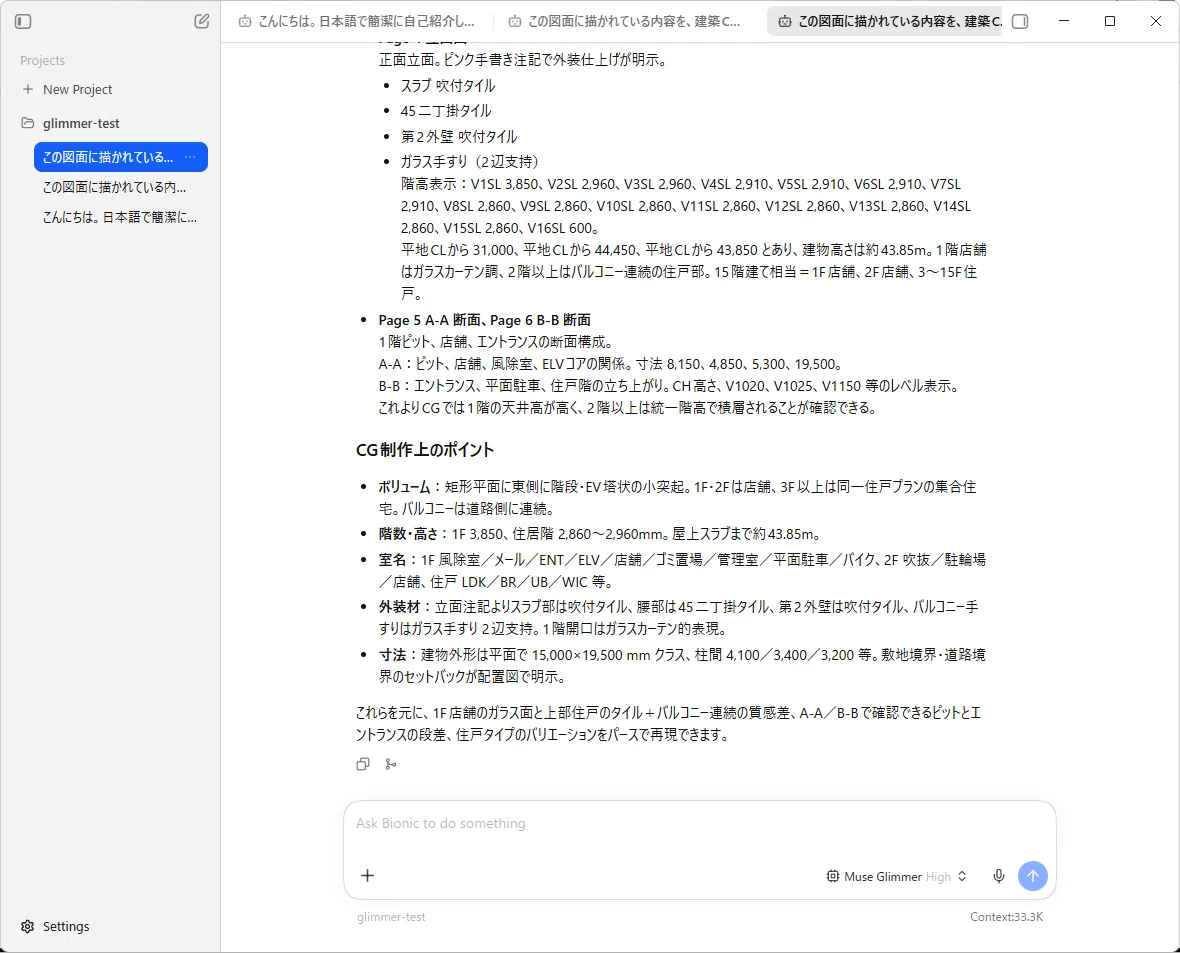
なんと、エラーも前処理もなしに、GlimmerはPDF図面を読んだのです。
しかも、単純に文字を拾っているだけではありません。
立面図からは、各階の階高を1フロアずつ。
住戸プランからは、各タイプの面積を1戸ずつ。
さらに、立面図にピンクの手書きで書き込まれていた外装仕上げの指示──
「45二丁掛タイル」
「ガラス手摺(2辺支持)」
といった、CG制作でマテリアルやディテールを決めるのに直結する情報まで、構造化して拾い上げてきました。
原本と突き合わせてみると、数字も合っています。
30Bクラスのモデルが、私のPCの中だけで、これをやっている。
正直に書くと、この時点でかなり興奮しました。
記事もここで締めれば、気持ちのいい成功譚になります。
でも、それは提灯記事の書き方です。
実務で使えるかどうかは、1回うまくいっただけでは決まりません。
同じ条件で繰り返しテストしてみて、それっぽいウソが混ざっていないかを確認します。
🔁1回では信じない──同じ図面を、繰り返し読ませる
先に挙げた合格ラインの②、「同じ入力に、同じ品質で返すか」。実務で本当に怖いのは、平均点の低さではありません。
むしろ怖いのは、ばらつきです。
十回のうち八回よくても、残り二回が壊れているなら、結局十回とも人間が確認することになります。
そこで、新しいセッションを立て直しながら、まったく同じ図面・同じ質問を繰り返し投げました。
すると、はっきりした境界線が見えてきました。
毎回、正確に一致した項目があります。
各住戸の面積(A〜Gの各タイプ)、主要な階高、外装材の三種、バルコニーの幅、店舗面積。
これらは何度投げても揺れません。
図面にきれいに印字された、いわば「活字」の情報です。
少なくとも今回の条件では、かなり高い再現性が確認できました。
一方で、回ごとに揺れる項目もありました。
断面図の細かい寸法。
ピンクの手書き注記の一部──ある回は「梁下外壁」と読み、別の回では違う語に読んだ。
敷地と建物の寸法を、どの部位の値か取り違えることもありました。
共通するのは、手書き文字と、図面の隅にある小さな数字です。
人間でも目を細める部分を、モデルも同じように苦手としていました。
つまり、境界はかなり明快です。
活字は堅い。
手書きと微細な数字は揺れる。
🎛️揺れをどう抑えるか──推論強度を上げる
ここで、Glimmerが持っている「推論強度」の設定が効いてきます。
low / medium / high / xhigh から選べる、推論にかける強度のつまみです。
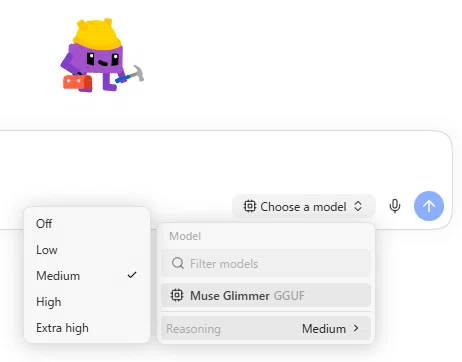
最初の検証は medium で回していました。
そこで同じ図面を、今度は high に上げて投げ直します。
結果は分かりやすく変わりました。
mediumでは揺れていた手書き注記が安定して読めるようになり、階高に至っては、最上部の小さなスラブレベルまで、一段も飛ばさず全フロアを拾ってきました。
推論強度を上げることで、今回の図面では、mediumで苦手だった手書きや微細部の読み取り結果が持ち直しました。
「複雑なタスクには high 以上」という使い分けが、図面という具体的な検証でも有効だと分かった瞬間です。
もちろん速度とは引き換えです。
high は medium より待たされます。
ここも、③「失敗が検知できること」や④「存在を忘れられること」と同じで、タスクごとに推論強度を使い分けるという運用の話になります。
仕上げ表をざっと読ませるだけならmedium。
寸法まで詰めたいならhigh。
そんなふうに、タスクの重さに応じて使い分けるのが現実的です。
📝この検証で分かったこと
まとめると、今回の検証で得られた結論は次のとおりです。
ローカルで動作する30Bモデルでも、建築設計図一式を十分に読み取ることができました。それも、データをクラウドへ一切送信することなく、手元のPCだけで処理できます。
印字された面積表・仕上げ表・主要寸法については、繰り返し解析しても結果にほとんど揺らぎがなく、今回の検証条件では、実務で活用できるレベルの再現性が確認できました。
一方で、手書きの注記や断面図の細かな寸法はmedium設定ではばらつきが見られましたが、highに切り替えることで、読み取り結果は大きく改善しました。
また、今回確認した範囲では、事実と異なる情報をもっともらしく生成するような 明確なハルシネーションは見られませんでした。
ただし、一つだけ忘れてはいけない原則があります。
最終的な数値や記載内容の照合は、人間が行うこと。
AI が読み取った結果を、そのまま図面の正式な値として採用してはいけません。これはローカルLLMであっても、クラウドAI であっても変わらない、図面解析における基本原則です。
裏を返せば、AI は「下読み」という役割において非常に強力なパートナーになります。
例えば、分厚い図面PDFをAIに渡し、室名・面積・外装材などを先に整理してもらう。人間はその結果をもとに原本を確認し、最終判断を行う。
ゼロからすべてのページを読み込むのと、あらかじめ要点が整理された状態から確認を始めるのとでは、作業時間にも集中すべきポイントにも、大きな違いが生まれます。
AI に図面を「任せる」のではない。
AI に先に読ませ、人間が確認する。
今回の検証から見えてきたのは、そんな現実的な使い方です。
💬「聞ける図面」にする
図面を正確に読めることが分かりました。
ここから、いよいよエージェントとしての応用です。
図面を「質問できる相手」に変えます。
131Kという広い文脈を活かして、図面一式を読み込ませた状態で、こちらから問いを投げます。
「バルコニーの手摺仕様は」
「1階店舗の天井高は」
「外装のタイル割りはどうなっている」
── 聞けば返ってきます。
制作の途中で仕様を確認したくなったとき、この速さは効きます。
図面だけではありません。
指示書や修正画像なども含めて、Glimmerと会話しながら確認できるようになります。
しかも、それはこれまでクラウド型AIには「聞きたくても聞けなかった」機密性の高い情報を対象にできるということです。
🎯まとめ
2026年の夏。
ローカルLLMは「クラウドの劣化版」ではなくなりました。
クラウドに出せないデータを、自分たちの環境の中で扱うための、現実的な選択肢になりました。
そして、ガバナンス上の問題とされるゴーストAIの「うっかり」が起こる経路そのものを断てる。
30Bクラスのモデルが、手元のPCの中だけで、設計図一式を読み、そこから質問に答える。
これは、単に「AIの性能が上がった」という話ではありません。
これまでAIに渡せなかった情報を、自分たちの環境の中でAIと一緒に扱えるようになった。
そこに、今回の検証で感じた一番大きな変化があります。
ローカルLLMは、「クラウドAIの代用品」から、実務の中で使い分ける選択肢へ。
少なくとも2026年の今、その境界線はもう越え始めています。

