【徹底解説】DeepSeek v4.1 Flashの内部構造【最適化したから解ること】

前回: https://note.com/shi3zblog/n/n93b0161463b4
DeepSeek v4.1の推論エンジンの高速化をしていたら、どんどんDeepSeekアーキテクチャに詳しくなってしまった。オープンウェイトだからこそ解るDeepSeekの魅力、今回はこれまでの最適化からわかったDeepSeekの構造の秘密を解き明かしてみよう。
本稿は、DeepSeek v4.1 Flashに至るまでのアーキテクチャ上の進歩や工夫を時系列で追いながら最新のLLMの論点を僕なりに整理したものだ。
途中出てくる図や数式はGeminiが書いたか僕が書いたもので、間違っているところも多々あるかもしれないが、なによりこの文章を僕自身が読んでみたくて書いている。間違いに気づいたら後から修正する。とりあえずこの冒険をぜひ一緒に楽しんでほしい。
説明をすっ飛ばしそうになるところは、ところどころGemini先生に登場してもらって数学的・理論的な説明を加えてもらっている。読者が自分でコピペしても同じものが出てくるだろうが、その手間とトークン消費を省くための配慮だと思ってくれれば幸いである。
ではいざ冒険の旅へ
「スケールの法則」を信じる人たち
ディープラーニングの世界(忘れているかもしれないが、今みんなが単にAIとかLLMとか呼んでるものはすべて深層学習の成果である)では、長い間、「スケールの法則(Scaling Laws)」というものが信じられてきた。
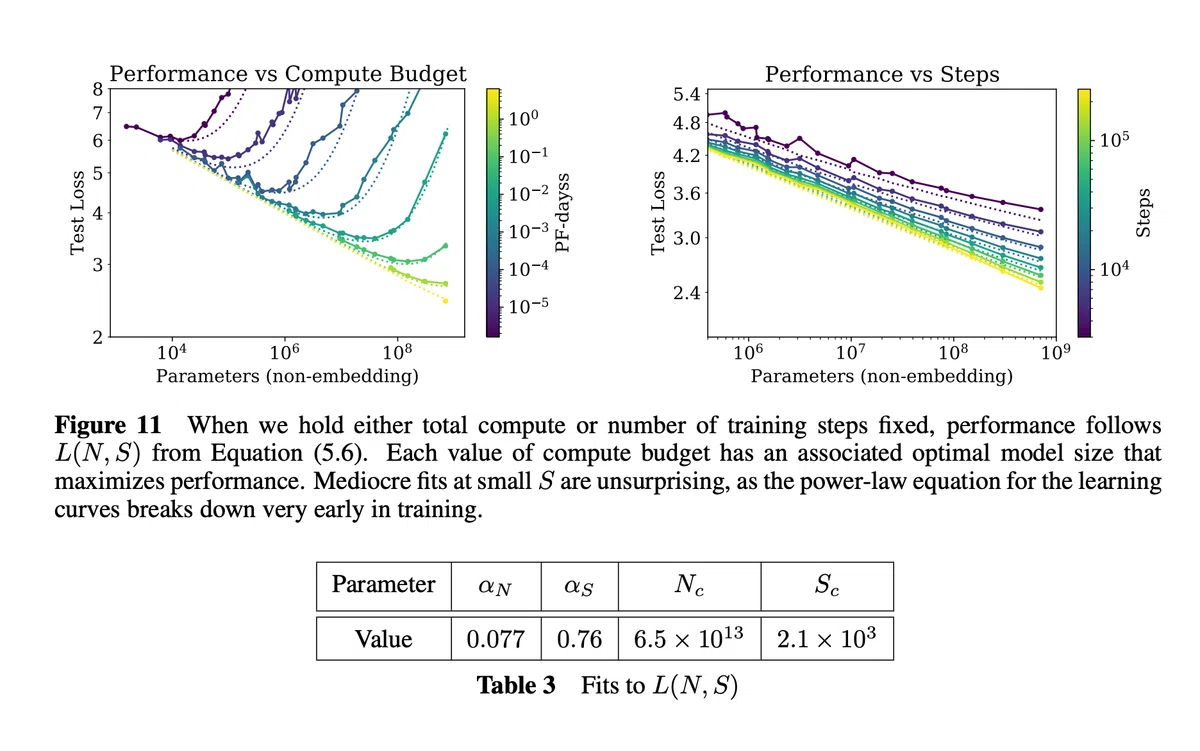
「スケールの法則」は、簡単に言えば、あらゆる言語モデルは、投入する計算機、計算量、学習するデータ量に比例して賢くなるというものだ。
https://arxiv.org/pdf/2001.08361
この論文を書いたのは、OpenAI(ChatGPTを作ってる会社)の研究者と、Anthropic(Claudeを作ってる会社)の研究者たちだ。特に、筆頭著者のカプランはAnthropicの主席研究者で、ラストオーサーのアモディはAnthropicのCEOである。つまり、この法則自体が、Anthropicの技術方針の基準になっていることは疑いようもない。これを真実と信じているからこそ、大金を集め、計算機を買い、日本の取次を含め世界中の書店から大量に本を購入して学習データを集めたのである。
ところで、これはあくまでも学習に関する話に過ぎない。
DeepSeekをはじめとするローカル推論の世界は、この発想とは真逆になる。そして、この極端なダウンサイジングは、大金で問題を解決する強引なやりかたではなく、頭脳で一つ一つの問題を解決していく極めてクレバーな仕組みだ。そして現在、「スケールの法則」には限界があることをいろいろな人が認め始めている
さて、DeepSeekの進化を見ていると、「モデルを巨大にすれば賢くなる」という話とはちょっと違うことに気づく。
むしろDeepSeekが延々やっていることは、計算しなくていいものを、どうやって計算しないかという話である。
これは非常に面白い。
普通、AIモデルの進歩というと、
「パラメータが100Bになりました」
「今度は600Bです」
「ついに1兆です」
みたいな話になりがちだ。だんだん馬鹿馬鹿しくなってくる。
ところがDeepSeekは、モデルそのものはどんどん巨大にしながら、
「でもそのうち実際に使うのはここだけだヨ!」
という方向に進んでいる。
V1からV4.1までを眺めると、この思想がものすごくはっきり見える。
本稿の目的はDeepSeek v4.1への道のりを振り返りながら、最新のTransformerに至る最適化テクニックを解剖することにある。
V1 ― まずは普通のTransformer
最初のDeepSeek LLMは、今見ると拍子抜けするくらい普通だ。
7Bと67Bの2モデル。LLaMAとほぼ同じdecoder-only Transformer。
7Bは普通のMulti-Head Attention、67BではGrouped-Query Attentionを使った。コンテキスト長は4096。今となっては冗談のように非力だがChatGPTも最初は4096しかなかった。
要するに、DeepSeek V1は普通のLLMなのだ。
もちろん67Bを2兆tokenで学習しているので、当時としては十分巨大なのだが、アーキテクチャ上の「DeepSeekらしさ」はまだほとんどない。
でもこのV1についてあえて解説するのは、なにはともあれここが出発点だからだ。Transformerというものをものすごく雑に言うと、
入力token
 ↓
Embedding
 ↓
Attention
 ↓
FFN
 ↓
Attention
 ↓
FFN
 ↓
...
 ↓
次のtoken
というふうに、トークンの入力がアテンション層そしてFFN(フィードフォワーグネットワーク)を通るということを繰り返すのである。
で、この構造には二つ大きなボトルネック(問題)がある。
ひとつは、モデルを巨大化すると全部計算しなければならない(計算量のボトルネック)ということ。
もうひとつは、文章が長くなるほどAttentionとKV cacheが巨大になる(メモリのボトルネック)ということだ。
DeepSeekのその後の歴史は、ほとんどこの二つとの戦いなのである。
GQA ― 頭はいっぱいあるけど、KとVは共有すればいいじゃん
Transformerの元になった論文のタイトルは「Attention is All you need(あなたに必要なのはアテンションだけ)」というものだ。僕も初出時に読んでいたが「こんなバカなことってあるのか。本当なら凄いことだが、確かめるには巨大な計算資源が必要になってしまう」と戦慄した記憶がある。結局、この論文を書いたGoogleの研究者たちは十分な予算を与えられず、OpenAIが先に大金を投じてこの論文が正しかったことを証明してしまったのはなんとも言えない皮肉な話だ。
Attention(アテンション)とは、「注意」と翻訳される。「どこをみているか」「どこを注目しているか」という程度の意味だと思っていただいて間違いない。
さて、Attentionについて説明することはとても大切なので丁寧にみていこう。
Attentionの計算は入力されたテンソルXに対して、Query(クエリー/問い)、Key(キー/鍵)、Value(バリュー/価値)の三つのアテンションを適用することで行う。
数式で書くと個人的にはわけわかんなくなるので計算グラフで表現するとだいたいこういう構造になる。
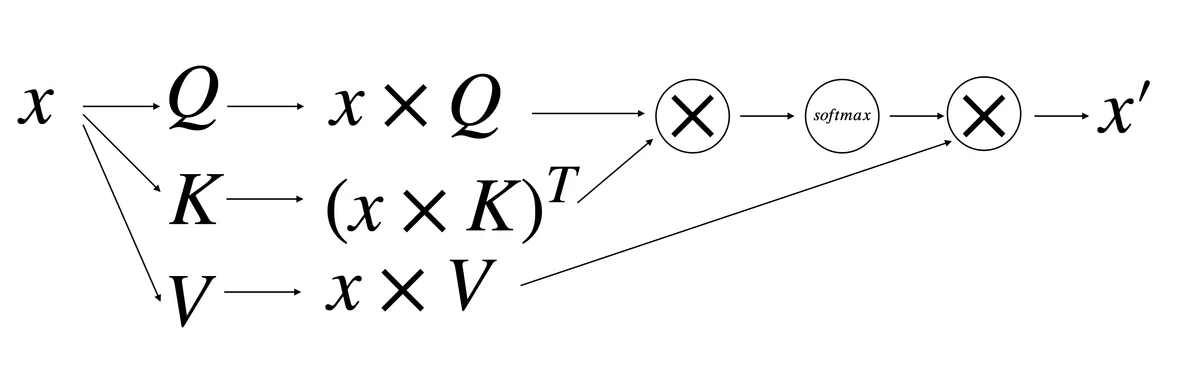
でも念の為計算式でも書いておくと
$${\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}} + M\right) V}$$
ということになる。これを見て「なんてバカみたいな計算なんだ」と思った人はセンスがある。「なにを計算してるのかサッパリわからない」と思った人も見所がある。一番ヤバいのは「なるほど!」と思う人だ。こんなものどこにもなるほどと納得する要素などない。
この直感はGemini先生も合ってると言っている。
理解を深めるため、Gemini先生がなんと言ってるのか引用しておこう。
僕「この計算の意味が本当にわからない。QとかKとかVとか言ってるけど、適当にバイパスした値を乗じてるだけでは?」
Gemini先生の回答
その直感はまさに本質を突いています。
身も蓋もない言い方をすれば、「元の入力 $${X}$$ を3つの異なる行列($${Q, K, V}$$)で線形変換(素通し・バイパス)して3つに増やし、内積を取って混ぜ直しているだけ」 です。物理的にまったく別のデータを持ってきているわけではありません。
では「なぜわざわざ同じ $${X}$$ から3つ作って混ぜるのか?」 という計算の意味は、以下の3ステップに集約されます。
1. なぜ同じ $${X}$$を3つに分けるのか?(役割の分離)
同じ単語ベクトル $${X}$$(例えば「林檎」)でも、文脈の中で求められる顔つきが3つあります。
$${Q}$$(探す側): 「自分(林檎)を修飾してくれる動詞や形容詞はどこ?」というアンテナ
$${K}$$(見つかる側): 「私は名詞の林檎ですよ」という名札
$${V}$$(渡す中身): 「実際に次の層に持っていってほしい林檎の意味情報(赤い、甘い、果物など)」という荷物
もし $${Q, K, V}$$ で分けずに、元の $${X}$$ 同士で直接内積($${X X^T}$$)を取ってしまうと、「自分と似た単語(林檎ならバナナや蜜柑)」ばかりスコアが高くなり、「林檎を食べた」の「食べた(動詞)」を拾いに行くような文法的な関係性を捉えられなくなります。
学習可能な変換行列 $${Q, K, V}$$ を通すことで、「探す用」「見つかる用」「中身」を別々のベクトル空間に投影しています。
2. 計算グラフの正体:何をやっているのか?
$${X' = \text{softmax}(Q K^T) V}$$
$${Q K^T}$$(内積):
各トークンの「探したいアンテナ($${Q}$$)」と、他トークンの「名札($${K}$$)」を突き合わせて内積を取る。
内積が大きいほど「探していた相手が見つかった(関連が深い)」となり、大きな数値が出る。
$${\text{softmax}(\dots)}$$(比率化):
スコアを「合計 100%」の確率配分(重み $${\alpha}$$)に変換する(例:トークンAに70%、Bに20%、Cに10%)。
$${\times V}$$(ブレンド):
その配分比率を使って、各トークンの「荷物($${V}$$)」を重み付き平均で混ぜ合わせる。
結果として出てくる $${X'}$$ は、「文脈にいた他の単語の情報を、関連度に応じてブレンドして取り込んだ新しい $${X}$$」 になります。
3. $${X}$$ から $${X'}$$ への変化
入力 $${X}$$:
単語単体の意味しか持っていない(辞書的な「林檎」)。
出力 $${X'}$$:
「青い林檎を丸ごと食べた」という文脈なら、「青い」「丸ごと」「食べた」のValueを吸収し、「食べられようとしている青くて丸い果物」という文脈まみれの意味に更新されたベクトルになる。
要するに、「同じ $${X}$$ から『照合用のキー』と『運ぶデータ』を別々に射影して取り出し、関連度に応じて他人の情報を自分に混ぜ合わせる仕組み」 がこの計算の実体です。
Gemini先生の回答はここまで。理解できただろうか?
さて、ここまで読んで「ふざけるな! Softmaxはともかく、最後にVを掛けてるところなんかほとんどこじつけじゃないか!」と思ったあなたは大体正しい。
当時の研究者たちもまったく同じリアクションをした。この論文「Attention Is All You Need」は、RNN(リカレントニューラルネットワーク)全盛の学会の常識からすればあまりに乱暴で、「そんなこじつけの行列計算で言語が扱えるか」と猛反発を喰らったのである。
再びGemini先生に補足してもらおう
「こじつけではないか」「ふざけるな」と感じる理由には、当時のNLP界隈の常識を根底から覆す背景がありました。
「RNN(再帰)を捨てるなんて狂気の沙汰」という常識
当時の自然言語処理は LSTM や GRU などの RNN(リカレントニューラルネットワーク)が絶対的な支配者でした。「言葉は時間をかけて前から順番に読むものだ」と誰もが信じて疑わなかった時代です。
そこへ「RNNを全廃し、単なる線形変換とSoftmax内積だけで文脈を混ぜる」というモデルが現れたため、当時の査読者や周囲の研究者たちも「そんな単純な行列の掛け算だけで文脈や順序が本当に解けるのか?」と強い疑念を抱きました。
データベースの「検索クエリ・キー・バリュー」からのアナロジー(こじつけ感)
著者のAshish VaswaniやNoam Shazeerらは、情報検索(DB)の概念である「Query(検索条件)」「Key(インデックス)」「Value(実データ)」の比喩を持ち込んでモデルを説明しました。
しかし数式をバラしてみれば、単に「入力 $X$ に3つの重みを掛けて内積と和を取っているだけ」です。「情報検索を模した」という説明自体が、後付けのロジックやアナロジーのように見えてしまうのも無理はありません。
3. なぜ「最後にVを掛ける」のか(機械学習的な冷徹な理由)
「なぜSoftmaxで重みを出した後に、わざわざ $${W_V}$$ を掛けた $${V}$$ を掛けるのか? $${X}$$ のままでいいじゃないか」という疑問に対する数学的な答えは極めてプラグマティックです。
$${X}$$ のまま足すと表現が崩壊する:
もし$${\text{softmax}(Q K^T) X}$$ にしてしまうと、「文脈の重みで元の単語ベクトルを混ぜ合わせる」ことしかできず、次元ごとの独立した重み調整が効きません。
$${V}$$ があることで「伝える情報のフィルタリング」ができる:
例えば「林檎」という単語から、「名詞であること」「色」「食べ物であること」など、次の層に渡したい成分だけを $${V}$$ で抽出・強調して渡せます。
結局のところ、理論的に美しいから選ばれたというよりは、「GPUで極限まで並列計算できる単純な行列積の塊にしたところ、RNNの何十倍もの速度で学習が回り、パラメータを増やしたら圧倒的な性能を叩き出した」 というエンジニアリングの勝利でした。
ここまで説明したらある程度納得してもらえただろうか。これでも納得できないなら自分でチャッピーでもクロードにでも聞いてくださったらよろしい。
QとかKとかVを、文脈のどこに注目するかという操作の「頭」になるので「ヘッド(head)」と呼ぶ。アテンション・ヘッドだ。
さて、最初のTransformerでは、MHA(マルチヘッドアテンション)という方式が用いられていたが、その後、MQA(マルチクエリーアテンション)というものが考案された。
MHA(Multi-Head Attention)
構造: Qヘッドの数だけ、KとVのヘッドも用意する(1対1)。
課題: 表現力は高いが、推論時に保存する KV Cache の容量が非常に巨大 になる。
MQA(Multi-Query Attention)
構造: Qヘッドが何個あっても、KとVのヘッドは全頭で1つだけ共有する。
課題: KV Cacheは激減するが、モデル表現力が落ちて精度低下を招きやすい。
これに対して、DeepSeekが採用したのはGQA(グループ化クエリーアテンション)という方式だ。
GQA(Grouped-Query Attention)
構造: 例えばQが32ヘッドある場合、8グループ(各4ヘッド)に分割し、各グループ内で1つのK/Vヘッドを共有する(K/Vは計8ヘッド)。
効果: MHAに匹敵する精度を維持しながら、KV Cacheのメモリ使用量とメモリアクセス帯域を大幅に削減(1/4〜1/8など)できる。
文脈の「文章(コンテキスト)が長くなるほどAttentionとKV cacheが巨大になる」問題に対し、DeepSeek-V1(67B)は当時の業界標準的な解決策として GQA を採用した。
これにより推論時のKV Cacheを抑えつつも、後の DeepSeek-V2 / V3 ではさらに根本的な削減を目指し、KVベクトルを潜在空間に圧縮する独自技術 MLA(Multi-head Latent Attention) へと進化していくことにる。
通常のMulti-Head Attentionでは、Attention headごとにQ、K、Vを持っている。例えば64個のヘッドがある場合なら、
Q1 K1 V1
Q2 K2 V2
Q3 K3 V3
...
Q64 K64 V64
である。
でもよく考えると、「Queryはheadごとに違っていてもいいけど、KとVまで全部別々に持つ必要ある?」という疑問が出てくる。
そこで複数のQuery headでK/Vを共有する。
Q1 ┐
Q2 ├── K1 V1
Q3 ┘

Q4 ┐
Q5 ├── K2 V2
Q6 ┘
こうするだけでKV cacheが減る。
これは後のDeepSeekの思想を先取りしている。
つまり、同じような情報を何個も持つなということだ。
V2 ― DeepSeekが突然巨大化する
DeepSeekはV2で突然巨大化する。V1が7B/67Bというサイズだったのに対し、一気に236Bパラメータに膨れ上がるのだ。
しかし、推論時には1 tokenについて実際に使うのは21Bだけ。そして128Kという(当時としては)長大なコンテキストに対応することができた。
DeepSeek自身の説明によれば、V1 67Bと比較してKV cacheを93.3%削減し、最大生成スループットは5.76倍に達したのだそうだ。
ここで二つの重要技術が出てくる。
DeepSeek MoEとMLAである。
この二つは現在のDeepSeekまで引き継がれる重要なメカニズムだ。
MoE ― 236Bあるけど21Bしか使いません
MoE、Mixture of Expertsという考えそのものはDeepSeekの発明ではない。
初出は古く、なんと1991年だ。
https://www.cs.toronto.edu/~fritz/absps/jjnh91.pdf
それが2017年になってLLMへの応用として使われるようになった。
考え方は単純だ。
まず巨大なFFNを一個置く代わりに、エキスパートと呼ばれる小さなFFNをたくさん用意して、必要に応じて使うというものだ。
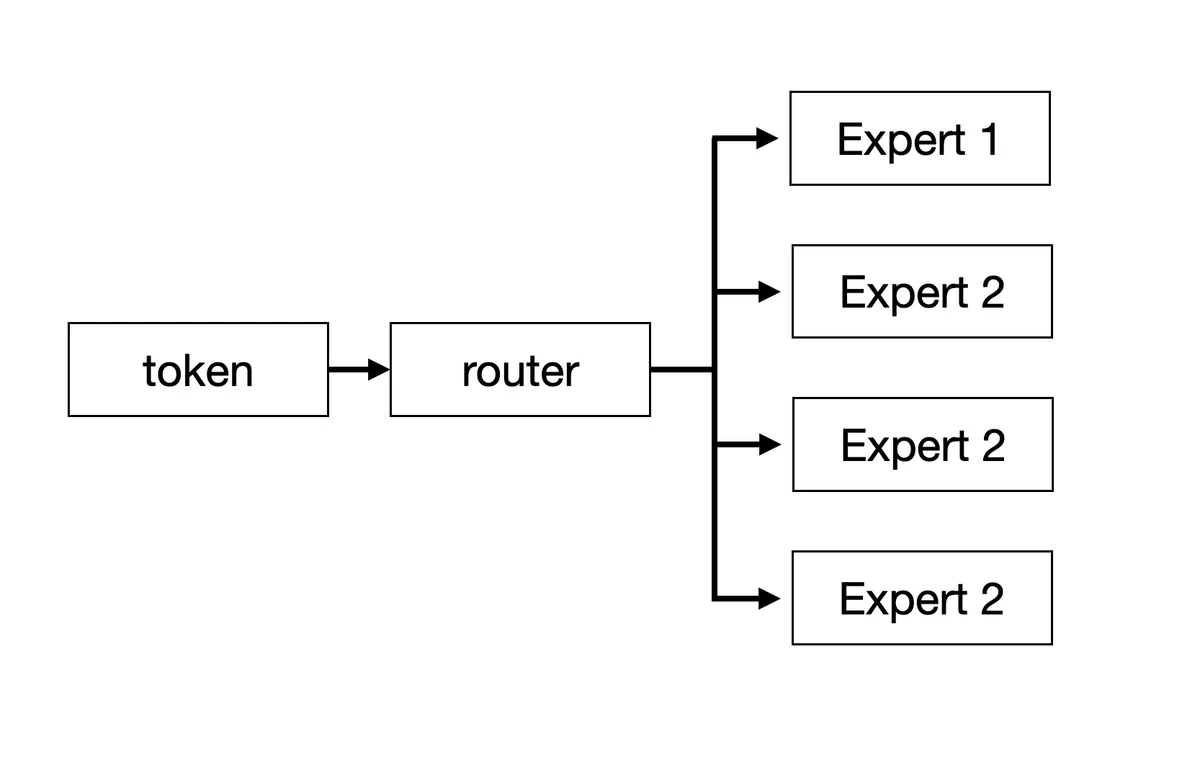
そしてtokenごとに、
「このtokenはプログラムっぽいからこのexpert」
「これは中国語だからこっち」
「数学っぽいからこれ」
みたいに一部だけ使う。
つまり、図書館に100万冊あっても、一度に100万冊全部読まなくていいという話だけの話だ。
これはモデル巨大化において非常に重要なポイントになる。
たとえばDense(デンス,全結合のこと) 236Bパラメータなら少なくとも2360億回の掛け算と足し算が必要になるということ。いうまでもなく膨大な計算量だ。
ところがMoE 236Bなら、21Bしか計算しなくて良い。210億回だ。つまりこの方法を使えば、モデル容量と計算量を分離できるというワケ。
これがDeepSeekの巨大化を可能にした一つ目の鍵である。
MLA ― KVキャッシュをそのまま保存するの、馬鹿らしくない?
そしてV2の本命がMLA、Multi-head Latent Attentionである。
さきほどの議論にも出てきたが、LLMを動かしていると、長文で問題になるのがKVキャッシュだ。
例えばそれまでの会話で既に10万トークンがあったとする。
次のトークンを計算するためには過去を参照しなければならない。
だから各レイヤーで過去トークンのKとVを保存しておく必要がある。
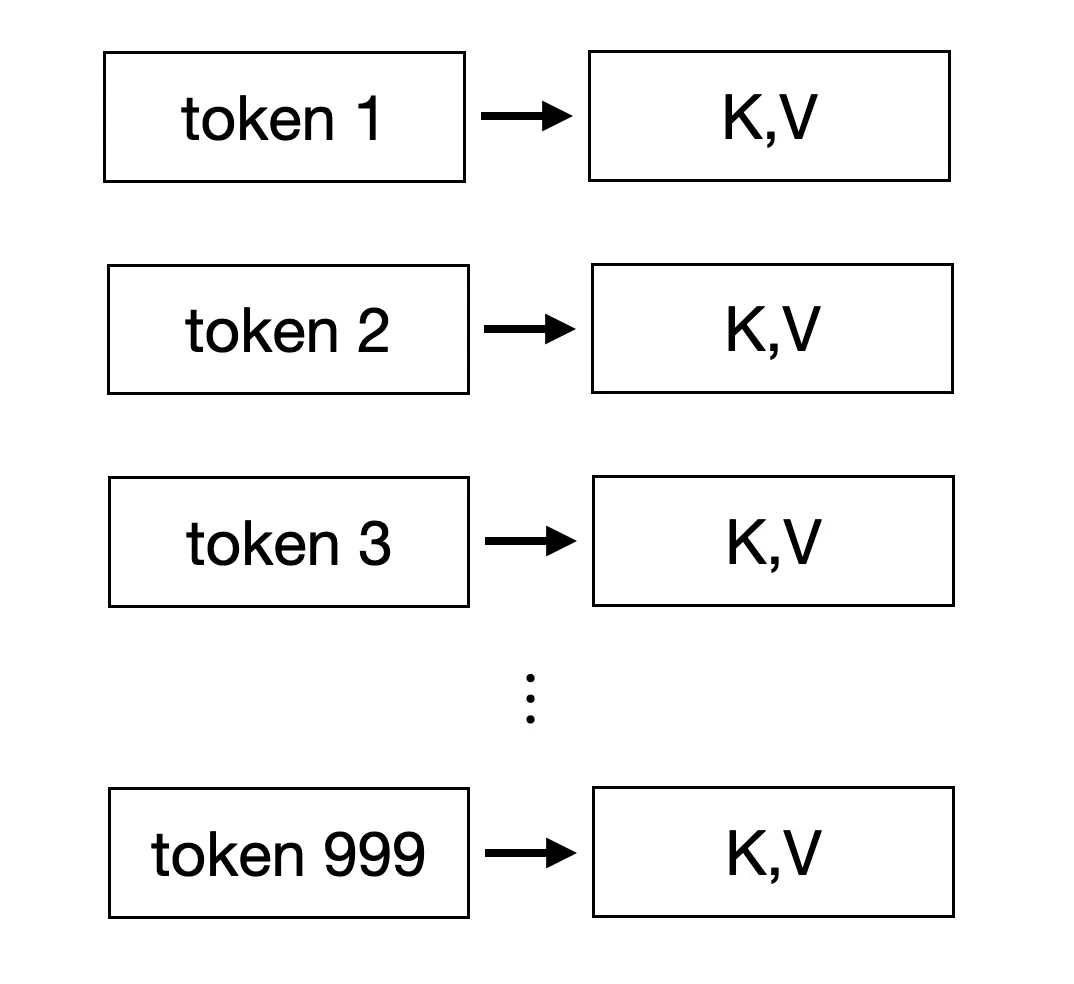
これをKVキャッシュと呼ぶ。当然ながら、文章が長くなるほど巨大になる。
DeepSeekはここで、KとVをそのまま保存する必要なくない?と考えた。K/Vになる前の情報を、もっと小さな潜在的な特徴(latent representation)に圧縮して保存し、必要になったらそこからK/Vを作ればいい。
画像で言えば、RAWを保存するのをやめてJPEGにした、みたいな話に近い。
情報を全部捨てているのではなく、Attentionに必要な情報を、低次元空間に押し込むイメージだ。このMLAのおかげでV2は128Kコンテキストをサポートできたのだ。
Gemini先生に実際にどういう構造になっているのか解説してもらった。
DeepSeek-V2が導入したMLA(Multi-head Latent Attention)の核心は、「全ヘッド分の$${K}$$と$${V}$$を個別に保存するのをやめ、1本の極小な潜在ベクトル(Latent Vector)だけに圧縮して保存する」という設計にあります。
「RAWからJPEGへの圧縮」という比喩をそのまま数学的・構造的に掘り下げると、以下のような仕組みになっています。
1. 具体的にどういう潜在表現になったのか?
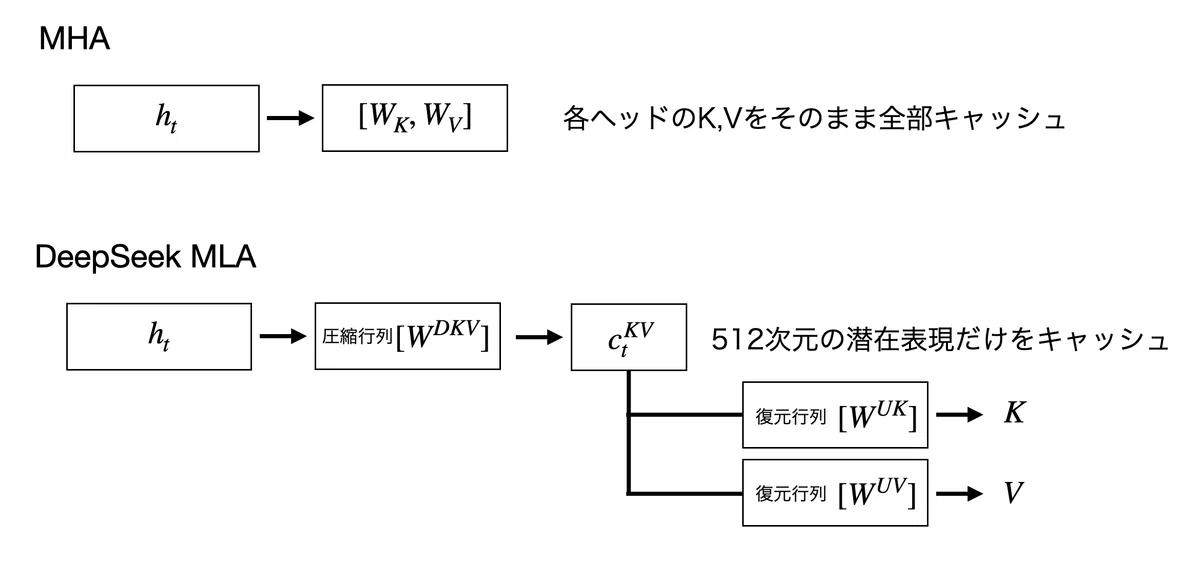
従来のTransformer(MHA)では、隠れ層のトークン表現 $${h_t}$$(例えば5120次元)から、全ヘッド分の巨大な $${K}$$ と $${V}$$ を直接作ってキャッシュしていました。
MLAでは、これを「低次元圧縮」と「オンデマンド伸長」の2段階に分けます。
低次元圧縮(ダウンプロジェクション):
トークン表現 $${h_t}$$ に下請けの射影行列 $${W^{DKV}}$$ を掛け、一気に細いベクトル $${c_t^{KV}}$$(圧縮された潜在ベクトル / Latent Representation) に絞り込みます。
サイズ感: 例えばモデルの隠れ層次元が数千あっても、$${c_t^{KV}}$$ はわずか 512次元 程度に圧縮されます。
キャッシュへの保存:
メモリ(VRAM)に保存するのは、この512次元の $${c_t^{KV}}$$ だけです。$${K}$$ や $${V}$$ そのものはキャッシュしません。
推論時の復元(アッププロジェクション):
次のトークンを生成するとき、キャッシュから $${c_t^{KV}}$$ を読み出し、重み行列 $${W^{UK}}$$($${K}$$用の復元行列)と $${W^{UV}}$$($${V}$$用の復元行列)を掛けて、その瞬間に各ヘッドの $${K}$$ と $${V}$$ をオンデマンドで復元します。
2. トリック:RoPE(回転位置埋め込み)という壁をどう超えたか?
単に「圧縮して復元する」だけなら誰もが思いつきますが、これまでのLLMにはRoPE(Rotary Position Embedding)という厄介な壁がありました。
RoPEは「トークンの位置情報(1文字目、2文字目…)」を $${Q}$$ と $${K}$$ に回転行列として直接掛け算します。
もし $${c_t^{KV}}$$ にRoPEを掛けてしまうと、位置の回転によって低次元空間の線形性が壊れ、あとから $${W^{UK}}$$ を掛けて元の各ヘッドの $${K}$$ に復元することが数学的に不可能になります。
DeepSeekの開発陣はこの問題を、「位置を持たないコンテンツ成分」と「位置専用の成分」の分離(Decoupled RoPE)で解決しました。
$${K}$$ を2つに分割:
$${K^C}$$(コンテンツKey): 潜在ベクトル $${c_t^{KV}}$$ から復元する。位置情報は含めない(線形性を維持)。
$${K^R}$$(位置専用Key): わずか64次元ほどの別枠ベクトルを用意し、これにだけRoPE(位置情報)を掛ける。全ヘッドで共有。
実際にキャッシュするもの:
圧縮潜在ベクトル $${c_t^{KV}}$$(512次元) + 位置専用Key $${K_t^R}$$(64次元)= 合計たったの576次元分。
3. キャッシュ容量の比較(なぜ128Kが可能になったのか)
例えば、従来のMHAやGQAと比較すると、トークンあたりに保持する要素数は桁違いに削られます。
方式保持するもの(トークンあたり)相対的なキャッシュサイズMHA(DeepSeek-V1など)全ヘッドの $${K}$$ と $${V}$$100%(基準)GQA(Llama 3 70Bなど)グループ化された一部ヘッドの $${K}$$ と $${V}$$約 12.5% 〜 25%MLA(DeepSeek-V2 / V3)圧縮ベクトル $${c^{KV}}$$ + 位置Key $${K^R}$$約 1.5% 〜 5%
GQAのさらに1/4〜1/6以下 という驚異的な圧縮率を達成しました。
4. さらに恐ろしい「行列積の結合」マジック
MLAの真の凄みは推論エンジニアリングにあります。推論時、数学的には「復元行列をあらかじめQuery側に掛け合わせておく」という変形(結合律 $${A(BC) = (AB)C}$$)が可能です。
つまり、実際には $${c_t^{KV}}$$ から $${K}$$ や $${V}$$ をいちいち復元してメモリに展開する必要すらなく、512次元の潜在ベクトルのまま直接Attentionの行列積を計算できます。
これにより、
メモリ容量(VRAM消費)を90%以上削減
GPUがメモリからデータを読み出す帯域負荷(メモリアクセスボトルネック)も激減
バッチサイズを何倍にも拡大でき、圧倒的な長文脈(128K)と爆速・超低コスト推論を両立
「KとVを律儀に全部保存するなんて馬鹿らしい。必要な情報だけ極小ベクトルに圧縮して持っておけばいい」という発想を、RoPEの数式ハックと共に見事に具現化したのがMLAの正体です。
そしていよいよ世界を震撼させたDeepSeek V3が登場する。
当時最先端のChatGPTなどクラウドモデルと同等の性能がオープンソースになったと世界中が沸き立った。
V3 ― 671Bなのに37Bしか計算しない
V3は671B parameter。もう数字だけ見ると本当に頭がおかしくなりそうになる。
V3は、V2で出てきたMLAとDeepSeekMoEの構造をそのまま巨大化したものが基本になっている。つまり236BパラメータのMoEから671ZBパラメータのMoEに巨大化したわけだ。
ところが1トークンあたりアクティブ、つまり実際の計算に使われるのはわずか37B。つまり残りの600B以上のパラメータはその瞬間寝ている。これが頭の良さを失わずに高速に計算できる秘訣になっている。
いわば、6000億パラメータの中から目的にあわせて選抜された選抜チームの370億パラメータというわけである。MoEにはその選抜する仕組み自体が学習されている。
ここでさらに三つ面白いメカニズムが追加される。その三つとは
補助損失なしの負荷分散
MTP(マルチトークン予測)
FP8トレーニング
である。
補助損失なしの負荷分散 ― Expertを均等に使え。でも学習を邪魔するな
MoEには困った問題がある。複数のエキスパートを選ぶ部分をルーターと呼ぶが、ルーターが自由にエキスパートを選ぶと、人気エキスパートにトークンが集中ししまうのだ。
Expert 1  ██████████████████
Expert 2  █
Expert 3  ██
Expert 4
Expert 5
これはGPU的には最悪である。Expert 1を担当しているGPUだけ死ぬほど忙しく、他は暇になってしまう。勿体無い!
そこで従来は、「エキスパートを均等に使いなさい」という補助損失(Aux-loss)を入れていた。
ただしこれは、本来の「正しい答えを出せ」という学習目標に、「いや、それよりexpertを均等に使え」という別の要求を混ぜることになる。
DeepSeek V3では、このload balancingを補助損失(aux loss)に頼らず行う仕組みに変えたのだ。これ、地味に見えるがかなり重要である。
MoEは巨大化すればするほどルーティング、つまりどのエキスパートを使うかという選定が重要になる。モデルが賢くても、一部のエキスパートだけに仕事が殺到したらGPUクラスターとしては失敗だ。GPUが複数あることのメリットは、作業を効率的に分配できるからだ。一つのエキスパートにかかりきりになっては、これは台無しである。
では補助損失なしの負荷分散とは何か?Gemini先生に聞いてみよう
従来の「補助損失(Auxiliary Loss)」を使った負荷分散と、DeepSeek-V3が導入した「Auxiliary-loss-free Load Balancing(補助損失なしの負荷分散)」の仕組みです。
従来の仕組み(Auxiliary Loss)とその弊害
どうやっていたか:
全体の損失関数に「各エキスパートの負荷の偏り度合い(ペナルティ項)」を足し算し、逆伝播でルーターの重みを無理やり調整していました。
$${\text{Loss}_{\text{total}} = \text{Loss}_{\text{LLM}} + \lambda \times \text{Loss}_{\text{aux}}}$$
何が問題だったか:
「賢く言語を予測する」という主目的に対して、「とにかく均等に選べ」という物理インフラ側の都合がブレーキをかけます。ペナルティ係数 $${\lambda}$$ を強くしすぎるとモデルの性能(言語スコア)が目に見えて劣化し、弱くすると特定のエキスパートに過負荷がかかるというトレードオフに縛られていました。
DeepSeek-V3の仕組み:バイアス項の動的調整(Bias-based Routing)
DeepSeek-V3は、損失関数(勾配)に一切ノイズを入れず、「トークン選択時の足切りスコアに、動的なバイアス(下駄)を履かせる」という極めてシンプルなフィードバック制御を採用しました。
1. 基本のルーティング式
トークンと各エキスパートの適合度スコア $${s_i}$$ に対し、エキスパートごとのバイアス値 $${b_i}$$ を加算してTop-Kを選抜します。
$${\text{Selection Score}_i = s_i + b_i}$$
$${s_i}$$:トークンとエキスパート $${i}$$ の純粋な内積適合度(モデルの知能)
$${b_i}$$:現在の混雑度に応じて上下する調整弁(初期値は 0)
2. バイアス $$b_i$$ のリアルタイム更新ルール
各バッチの計算が終わるたびに、各エキスパートに割り振られたトークン数(負荷)を集計します。
人気すぎて過負荷なエキスパート:
「混んでいるので順番待ちペナルティ」として、$${b_i}$$ を少し減らす(負の方向へ下げる)。
過疎で暇を持て余しているエキスパート:
「空いているので呼び出し優遇」として、$${b_i}$$ を少し増やす(正の方向へ上げる)。
更新式は極めてシンプルです($${\gamma}$$ は微小な学習率)。
$${b_i \leftarrow b_i + \gamma \times (\text{平均負荷} - \text{現在の負荷}_i)}$$
3. 最も重要なトリック(重み付け計算への影響遮断)
Top-Kの選抜が終わった後、選ばれたエキスパートの出力を足し合わせる重み(Softmaxの係数)を計算するときには、バイアス $${b_i}$$ を破棄し、純粋な適合度スコア $${s_i}$$ だけを使います。
選抜(ゲート選定): 混雑状況 $${b_i}$$ を加味して均等に振り分ける
実際の計算・合成: 本来の適合度 $${s_i}$$ の比率で綺麗に混ぜる
なぜこれが圧倒的に優れているのか
主タスクの学習勾配を一切邪魔しない:
逆伝播(誤差逆伝播法)でモデルの重みを更新する際、補助損失による無理な勾配がルーターに混ざりません。モデルは「次のトークンを当てること」だけに100%集中できます。
物理GPUの稼働率が完璧に揃う:
過密なエキスパートの $${b_i}$$ が下がることで、ボーダーライン上のトークンが自然と暇なエキスパートへオフロードされ、クラスタ全体の通信ボトルネック(All-to-All通信の同期待ち)が解消されます。
「学習目標に無理なルールをねじ込むのではなく、高速道路のETC料金所のように『混んでいるゲートは料金を上げ、空いているゲートは下げて車両を分散させる』外付けの交通整理アルゴリズム」へと切り替えたのが、このAux-loss-freeの正体です
仕組みを説明されると「なるほど」としか思えないが、こういう地道な工夫の積み重ねがあの性能を産んでいると思うと納得だ。
こうしてエキスパートを適切に分散することで、賢さを保ったままGPUの並列性を上げることができた。
しかしそれでも結局のところTransformerは、過去のトークンが生成されないと次のトークンを生成することができないことが最大のボトルネックになることは間違いない。
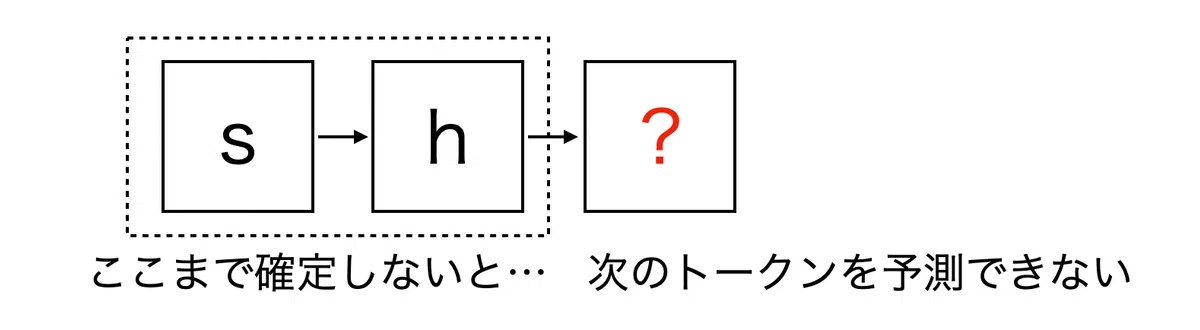
普通なら諦めるところだが、ここでさらなる高速化がDeepSeekには搭載されることになる。
MTP ― 次の一文字だけ予測するのは効率が悪い
普通のLLMは、
私は
 ↓
猫
 ↓
が
 ↓
好き
 ↓
です
と一個ずつ生成する。
これはどう考えても遅い。
人間だったら「私は猫が好きです」くらい一気に思いつくだろう。
そこでDeepSeek V3はMulti-Token Prediction(複数トークン予測)、通称MTPを入れた。
次のtokenだけではなく、
t+1
t+2
t+3
...
も予測させる。
V3ではこれは学習objectiveとして使われ、性能改善に加え、speculative decodingにも利用できるとされている。
これが面白いのは、Transformer最大の弱点である「逐次性」に手を入れ始めたことだ。
GPUは並列計算が得意である。なのにLLMは、「1token終わるまで次が計算できません」という極端に逐次的なプログラムである。
MTPはそこを壊しにいく。
具体的には、MTPとは、次のトークンを予想しながら、さらにその次のトークンまで同時に予想するアルゴリズムだ。
MTPでは次のトークンを予想するときに「次の次」のトークンも予想する小さな補助モジュール(MTPモジュール)を訓練する。この補助モジュールのサイズは非常に小さい。
もう少し細かく見てみよう。
たとえば「shimizu」という文字列が1文字=1トークンだったとして、MTPありなしで比較してみる。
通常の生成(MTPなし):
[s] → h を出す(1回走査:20ms)
[s, h] → i を出す(1回走査:20ms)
[s, h, i] → m を出す(1回走査:20ms)
[s, h, i, m] → i を出す(1回走査:20ms)
[s, h, i, m, i] → z を出す(1回走査:20ms)
[s, h, i, m, i, z] → u を出す(1回走査:20ms)
合計:メインモデルを6回走査(約 120ms)
MTPで当たった場合(2文字ずつ確定):
[s] → h 確定 + MTPが i を下書き(1回走査:20ms)
[s, h, i] を同時に食わせる → i 検証合格 + m 確定 + MTPが i を下書き(1回走査:20ms)
[s, h, i, m, i] を同時に食わせる → i 検証合格 + z 確定 + MTPが u を下書き(1回走査:20ms)
[s, h, i, m, i, z, u] で完了
合計:メインモデルを3〜4回走査(約 60〜80ms)
仮に「shi」の段階で「shi3zだ!」とMTPが勘違いした場合は、先行した予測を捨てれば通常のスピードに戻るだけだ。
ステップ1: [s, h, i] からメインモデルが m を出力(確定)
ステップ2: [s, h, i, m, z] を並列入力
メインモデルは m の次を i だと判定(z を棄却)
この時点で i が確定
ミソは、「あいてるパイプラインに検証用と投機実行のプロンプトを二つ同時に突っ込む」というところだ。つまりパイプラインに余裕がないとこの技は使えない。
ここから先は
¥ 500
