
絶望に効くクスリ / Claudeを使い果たしたからローカルDeepSeek v4.1 FlashでClaude Codeを使うことにした話

前回のつづき
ここ数日はDGX SparkとM3 UltraでのDeepSeek v4.1 Flashの最適化に熱中している。
その途中途中で、Claude Codeはすぐ弱音を吐く。
「それは不可能です」
「アムダール的にはそれはやらないほうがいいです」
アムダールというのは昔のIBMの偉い人である。世界初の汎用コンピュータ、System/360を設計したアーキテクトだ。
アムダールの法則とは、システムをどれだけ並列化しようと必ず直列化しなければならない部分ができるため、並列化だけで無限大の速度になることはない、ということを唱えた人だ。
だがそれはそのくらい古い時代の話だ。
今はシステムはいくらでも並列化できる。もちろん直列化する部分がなくはないが、理論上は並列化可能な計算はいくらでも並列化できる。特にニューラルネットワークは、それが顕著なのだ。
まず書いてから考えろ。それはもう90年代以降のモダンなCPUでは鉄則中の鉄則である。理屈は後からついてくる。直感に従え!
DeepSeek v4.1 FlashのM3 UltraとDGX Sparkでの最適化を同時並行で進めているが、最適化が佳境に入ってくる(世界最速に近づいてくる)と、急にClaude… pic.twitter.com/DiE65KL8U8
— shi3z (@shi3z) September 15, 2026
で、実際、うだうだ書かない理由を考えるより書いたら早く動いたりもする。
そしてまず書くとだいたい上手くいく。
— shi3z (@shi3z) September 15, 2026
これは理屈ではない。直感と信念だ pic.twitter.com/aLDDn5YoJ2
ところがどうもさっきから様子がおかしい。
するととんでもないことに気がついた。
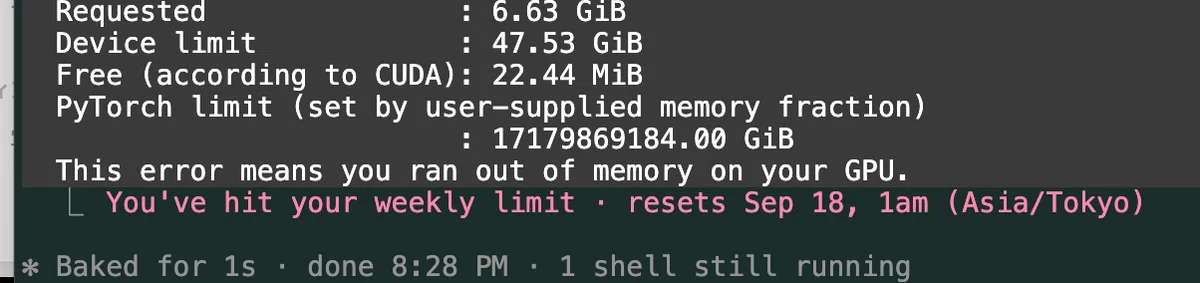
Claude Code Max 20Xが限界に達していた。
以前も限界に達した時は、3つまで20Xアカウントを契約していたが、最近そこまで開発してないなーと思って減らしていたのだ。
しかも、けっこうエグいことに、18日の午前1時まで使用できないという。
三日もAIに触るなと言うのか。確かにA100でDeepSeek v4.1 Flashを動かす時はガリガリやりすぎたかもしれないが。
詰んだwwwwwwww
— shi3z (@shi3z) September 15, 2026
三日も何をしろと pic.twitter.com/jvMf5bzcPi
寝ても覚めてもAIに触っていた人間が突然AIにさわれなくなるとパニックになる。とりあえずChatGPTにパッチを書いてもらうことでなんとか開発を継続するが、そこではたと気がついた。
ここは敢えてピンチはチャンスではないか。
drikinに煽られ、ムキになってA100で本来動かないはずのDeepSeek v4.1を動かすコードを書いたら、けっこうフォークされたりプルリクをもらったりしていた。
しかし、実際にこの移植が実用的に使えるものなのかどうか。また、再びクラウド上のAIがナーフされたり使えなくなったりしたらどうするか。それを試すための絶好の機械ではないか。
というわけで、安易に金を払って解決するのはやめて、敢えてイバラの道を行くことにした。つまり、DeepSeek v4.1 Flashをただ動かすのではなく、実用的に使うのである。そのためにはやらなきゃならないテストとかが山ほどある。
するといきなり、最新版でちゃんと動いてないことが発覚した。
この「最新版」は、dangerously-skip-permissions(キケン暴走モード)つきで起動したClaude codeが勝手に改造して勝手にtok/sを上げて、いつのまにか2400tok/sという意味不明なものになっていた。
ここまで極端に性能が上がると、何か間違いが起きていてもおかしくない。
僕は急に青ざめた。もしかして、とっくにダメなものをいじっていたのではないか。
半べそをかきながら、ChatGPTとともに修正を試みる。
最初はQwen3.8 27Bを使っていたんだけど、チューニングしてなくて遅すぎるのでChatGPTに助けを求めた。懐かしのコピー&ペースト運用だ。
いろいろ調査した結果、本当に「ちゃんと動いてない」のは最新の最新版だけだったことが判明してホッと胸を撫で下ろし、実用的な運用のための100万コンテキストで実行しようとするとあれこれバグが出現した。まあそりゃそうだよなあ。
そのへんのバグも一通り治ったかと思い、ようやくClaude Codeのバックエンドとして接続することに成功した!やったぜ!!
できた!
— shi3z (@shi3z) September 15, 2026
Claude CodeのバックエンドにDeepSeek v4.1 Flashをローカル実行。1Mコンテキスト。これでもうリミットも怖くないぜ pic.twitter.com/x0Q85kEpF1
さっそくDeepSeek v4.1 Flashで中断していたプロジェクトを継続しようとすると・・・遅い!!遅すぎるぞ!!
そもそもtokenとは何か?LLMの仕組み
LLMは文章をそのまま文字列として読んでいるわけではない。
文章を小さな単位に分割して、それぞれを整数IDに変換して処理する。
この単位が token(トークン) である。
日本語の場合、1文字が1tokenになるとは限らない。
単語だったり、漢字1文字だったり、記号だったりする。
100万tokenになれば、本数冊分どころではない巨大な入力になる。
ここで少し用語を説明すると、LLMの処理は大きく二つに分かれる。
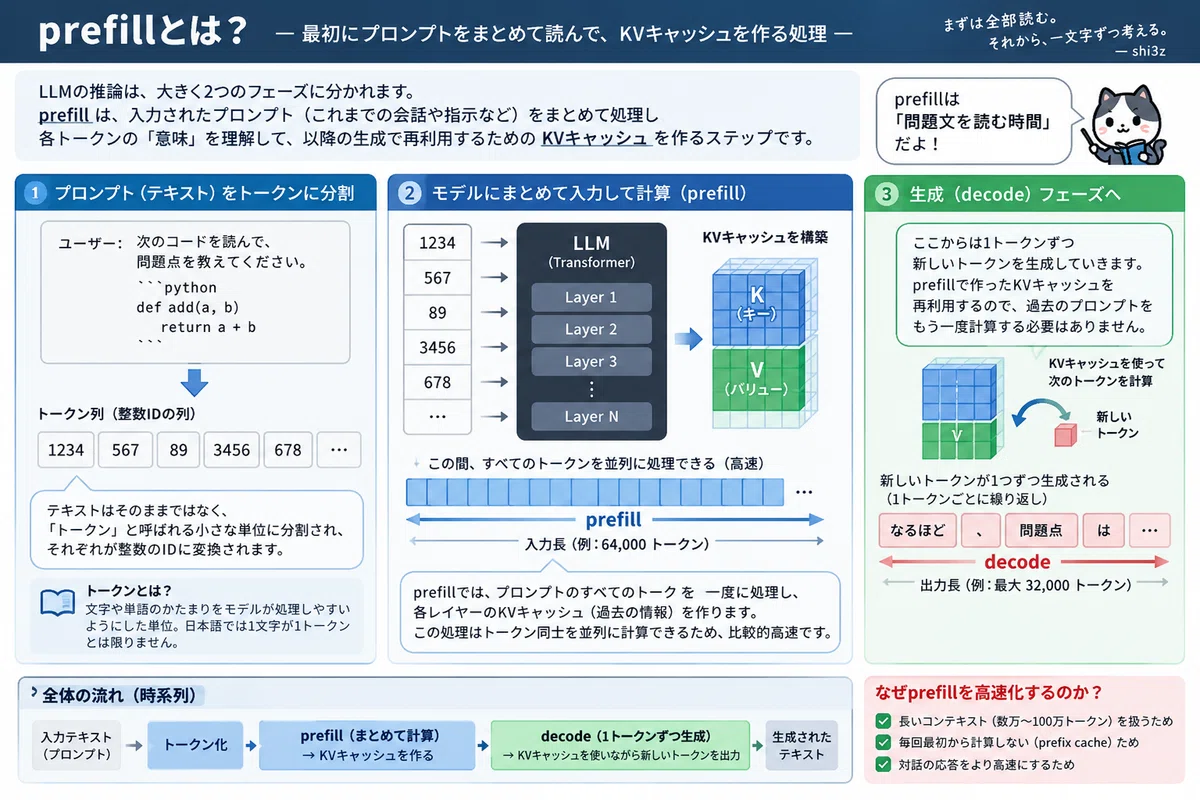
一つは、最初にプロンプトをトークン化してAIが読み込む prefill(プリフィル)。
もう一つは、そのあと1トークンずつ文章を生成していく decode(デコード) である。
人間で言えば、
prefill = 問題文を読む時間
decode = 答えを一文字ずつ書く時間
みたいなものだとイメージすればいい。
僕は最初、ずっとdecodeを速くしていた。僕が欲しいのは生成結果だったからだ。生成結果を速く得たかった。というのも、当初は「同じプロンプトで異なる結果を大量生成」するためにDeepSeekを実装していたからだ。だがこれはゲーム開発という特殊な用途向けだった。
しかし簡単なベンチマーク用のプロンプトではなくて、Claude Codeが使うような長いシステムプロンプトを処理するには、prefillの処理が最も重要になる。
DeepSeek V4.1 FlashはMoEなので、どのExpertを選ぶか、どうGPU間で振り分けるか、どうFP4のweightを読むか、どうSwitchGLUを処理するか、そういうところを延々といじっていた。
MoEとは何か
ところで今更だがMoE(エム・オー・イー)とは Mixture of Experts(混合された専門家) の略である。
巨大なニューラルネットワークを全部毎回使うのではなく、入力ごとに「今回使う専門家」を少数だけ選んで計算する方式だ。
たとえば100人の専門家がいても、質問ごとに6人だけ呼ぶ、みたいな感じである。ゆえに総パラメータ数を巨大にしつつ、実際の計算量は抑えられる。
その代わり、
誰を呼ぶか?どのGPUにいるか?どうデータを送るか?という物流が猛烈に面倒になる。
継之助はA100を8枚積んだマシンである。とはいえLLMだけでなく他の目的にも使いたいから、できれば全部LLMに割り当てることは避けたい。今回、とりあえずモデルに使っているのは5枚。
それでもメモリはかなりある。いろいろやった結果、decodeはだいぶ速くなった。
しかしprefillがノーマークだったので、作業を続ければ続けるほど重くなっていく。尋常じゃない遅さだ。であれば、prefix cacheを作ればいい。
前回までと同じ結論になる部分を保存しておいて、新しく増えたところだけ計算すればいい。
理屈としては簡単である。
理屈としては。
Prefix Cacheとは
Claude Codeのような対話では、
1回目:
AAAA

2回目:
AAAA + BBB

3回目:
AAAA + BBB + CCC
のように、過去の内容がそのまま次のリクエストに含まれる。
だったら毎回AAAAから再計算する必要はない。
AAAAまで計算した途中状態を保存しておき、次回はBBBだけ計算する。
これがprefix cacheの基本的な考え方だ。
要するに、「前回読んだところまでは覚えておこう」というだけの話だ。
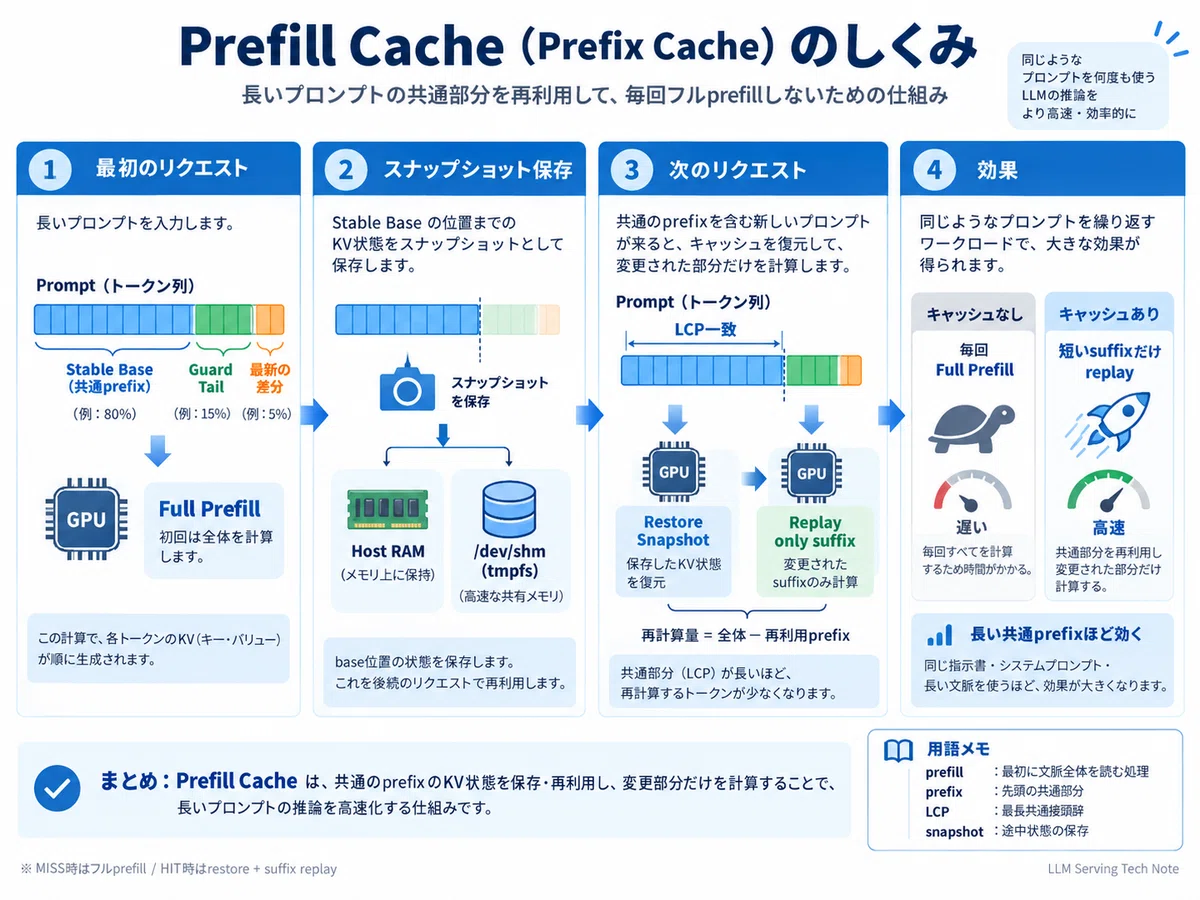
プログラマーは最適化というと、馬鹿の一つ覚えのように「キャッシュすればいい」と最初に考える。これは人間もAIも同じだ。しかしprefill cacheに関しては、そう簡単な話ではない。なぜならエージェントが扱うコンテキストが巨大すぎるからだ。
DeepSeek v4.1 Flashは100万コンテキストに対応している。
ということは、100万コンテキストに対応したキャッシュ機構を作らなければならない。これがハマりどころだった。
エージェントが使う場合、過去の会話履歴を毎回prefillしなければならない。それは最大100万トークンということになる。100万トークン分の会話で発生する様々なデータは膨大だ。
最初はprefix stateを丸ごとsnapshotすることにした。KV cacheだけでは足りない。DeepSeek V4.1 Flashにはcompressorのringもあるし、Shared Attentionの状態もあるし、いろいろある。
KV Cacheとは
Transformerのattentionでは、過去のtokenから作ったKeyとValueという中間結果を何度も参照する。これを毎回作り直すと無駄なので保存しておく。
それが KV Cache である。
最近のLLM推論高速化では、だいたいこのKV Cacheをどう扱うかが非常に重要になる。
ただしDeepSeek V4.1 Flashでは、単純なKVだけ保存すればいいわけではなかった。
圧縮用のring bufferやindex情報など、途中状態がもっとたくさんある。
これをpersistent state(パーシステント・ステート)と呼ぶことにしよう。
persistent stateとは、要はゲームにおけるセーブデータだと思えばいい。
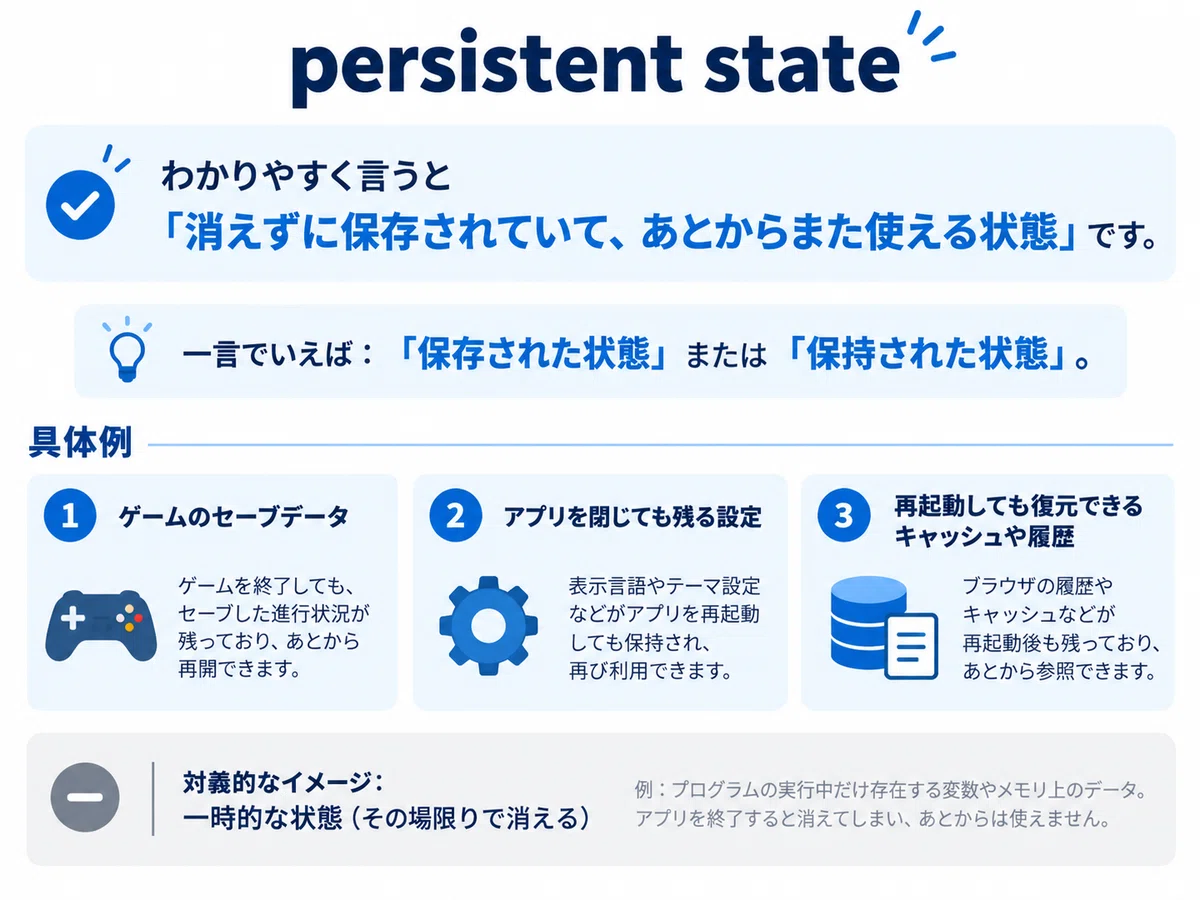
そこで必要なpersistent stateを全部保存して、
[prefix-snapshot] SAVE slots=74というところまで持っていった。74個もある。74種類のパラメータを保存すると言うことだ。
嫌な予感しかしない。
なぜなら、それぞれ100万トークン分のなんらかの情報を持っているということだからだ。つまり、74倍の情報が必要になるのである。
今回のDeepSeekでは、prefill後の状態として単一の「KV cache」が1個あるわけではない。モデル内部には複数レイヤーがあり、さらにレイヤーごとに例えば、
AttentionのK/Vや圧縮されたKVキャッシュ
indexer用のキャッシュ
compressorのring buffer
どこまで書いたかを示すposition / written_max
sequenceごとの状態
Shared Attentionが次回の計算に必要とする状態
のようなものがある。RPGのセーブデータでいえば、HP、経験値、所持金、もっているアイテム、みたいなものが大量にあるわけだ。しかもRPGと違ってLLMではそれぞれのデータが巨大で、何も考えずに100万コンテキストぶんのpersistent stateをまるごと保存しようとすると、16GBものメモリを消費することがわかっていた。
何も手を加えないpersistent stateをsnapshot(スナップショット)と呼ぶ。
今回は、snapshotを /dev/shm にも保存することにした。そうすればデバッグ用にサーバープロセスを再起動してもすぐにキャッシュを使える。
/dev/shmとは
Linuxには、RAM上に作られる高速なファイル領域がある。
それが /dev/shm だ。いわゆるRAMDISKである。SSDに書くより圧倒的に速い。
なので巨大なsnapshotを高速に保存するには都合がいい。ただし当然、使えば使うほどRAMを食う。
これでサーバを再起動してもprefix cacheを復活できる。
用語が錯綜しているが、基本的にここで「persistent state」と呼んでいるものと「prefix cache」と呼んでるものと「prefill cache」と呼んでいるものと「snapshot」と呼んでいるものは全て同じデータである。じゃあなぜ呼び方が違うのかと言うと、「同じデータでも解釈が違う」からだ。ここは本当は面倒だから統一したいところだが、AIと会話するときには単にデータそのものではなくて解釈の方が重要なのでそのままにしている。
ニュアンスとしてヒントになりそうな解釈の違いを説明しておくと
persistent state 状態変数
prefill cache prefillが終わった状態での状態変数
prefix cache あらかじめ保存されたデータとしての状態変数
snapshot 状態変数の生データそのもの
という感じだ。どれもデータの実体としては基本的には同じものを指す。
ただ文脈上の解釈が異なるだけだ。これを分けておくことがなぜ重要なのかというと、たとえば「snapshot」はただのデータだが、「persistent state」の表現を変えることでデータ実体を圧縮したりできる(という解釈ができる)。「prefill cache」は「prefillが終わった後の状態」という意味しか持たないが、persistent stateは不要なものを選別したりして圧縮できる余地がある。というイメージだ。
このように用語を分けておくと、AIに指示するときに「persistent stateのいらないものを減らせ」とか「persistent stateを圧縮しろ」などの指示が出せる。「persistent stateを圧縮しろ」と「snapshotを圧縮しろ」は同じデータ実体に対する指示だが、persistent stateの圧縮は、意味的・本質的な圧縮を意味するのに対し、snapshotの圧縮はそのまま解釈すればzipなどの一般的なデータ圧縮を意味するニュアンスが強くなる。と言う感じか。
ここで改めてわかったのは、たとえ相手がAIでも、その中でなにが起きているのかちゃんとイメージしないと適切な指示を出せないということだ。
さて、実際に起動すると
[prefix-tmpfs] LOAD-DONEと出て、ちゃんと過去の状態(persistent state)が復活する。
「勝ったな」
と思った。
当然、勝っていなかった。
できたと思ったらできてない。
— shi3z (@shi3z) September 16, 2026
人生はこの繰り返し
32K tokenを越えたあたりで突然死んだ。
調べてみると、圧縮KV cacheにはratio=2のものがあり、32768 tokenなら16384 row(rowは行みたいなもの。16384行目、という意味)で済む。
ところが32769 token目に突入した瞬間、
row 16384
を書こうとする。
ところが書くべき配列は0から16383までしか確保していない。じゃあ配列を増やせばいいじゃん、というほど物事は単純ではない。
CUDA Graphが出てくる
高速化のため、既にCUDA Graphという仕組みを使っていた。
GPUの処理では、実際の計算そのものだけでなく、
「このkernelを実行しろ」
「次はこれを実行しろ」
というCPU側からの指示にも時間がかかる。
CUDA Graphは、一連のGPU処理をあらかじめ記録しておいて、
「この一連の処理をもう一回やれ」
とまとめて再生する仕組みだ。これは非常に速い。
Direct3Dのイミディエイトモード、PlayStation1のオーダリングテーブル、高速処理にはつきものなのが、このグラフ化だ。実際、CUDA Graphを使った場合と使わない場合とでは、tok/sで2倍の差がある。
ただしCUDA Graphを使うには難しい問題がある。
CUDA Graphはcaptureしたときのメモリアドレスを前提にしている。
途中で配列を作り直してアドレスが変わると、
「その住所にはもう誰も住んでません」
みたいなことが起きる。
普通ならcacheを拡張すればいいだけなのだが、CUDA Graphを使っているのでそれが簡単ではない。
そこで、とりあえずCUDA Graphをcaptureする前に、必要なcacheを先に確保することにした。
export DSV41_EP_PREALLOC_TOKENS=131072まず128K token分を確保する。
1M全部を最初から確保する案も考えたが、それをやるとGPUメモリが壮絶なことになるのでやめた。
128Kなら現実的だ。
これで32769問題は消えた。
ところが今度はcold prefillでOOMした。
OOMとはOut Of Memory(アウト・オブ・メモリー)。
つまりメモリ不足である。GPU開発をしていると、親の顔より見るエラーだ。しかし今回はモデルそのものが大きすぎたわけではない。
長いコンテキストを一気に処理すると、途中計算用の巨大な作業テンソルが生成されていた。
それがGPUメモリを食い尽くしていた。
そこで、
export DSV41_HC_PREFILL_CHUNK=2048としてchunkingした。
Chunking(チャンキング)とは
巨大な仕事を一気に処理せず、
全部で40000 token

↓
2048 token
2048 token
2048 token
...
のように分割して処理する方法である。
多少ループ回数は増えるが、瞬間最大メモリ使用量を劇的に減らせる。
これで36K以上も通る。
一つ倒すと次の敵が出てくる。完全にRPGである。
しかも敵が全部「CUDA OOM」とか「device-side assert」とかいう名前なので全然かわいくない。
prefix cache自体は動くようになった。
たとえば64,244 トークンまで保存してあれば、新しいプロンプトが65,514トークンになっても、差分の1,270トークンだけ処理すればいい。
ところが、この「差分だけ処理する」が遅かった。なぜなら、1 tokenずつ生成していたからだ。速度はだいたい45〜59 tok/s。
tok/s(トークン毎秒)とは?
tokens per second(トークン・パー・セカンド)。
1秒間に何token処理できるかという速度の単位である。
50 tok/sなら、1000 tokenで20秒。
10万tokenなら約33分。
100万tokenなら約5時間半。
つまり仮に100万コンテキスト近い会話を重ねたとすると、次の返答が返ってくるのが5時間半後ということになる。深宇宙探査機じゃあるまいし、そんなに待つと言うのは実用性がないということだ。
それはprefix cacheではない。ただの罰ゲームだ。
当然思った。
「これ、まとめて処理すればいいんじゃね?」
要するに1トークンずつ処理するのをやめて、
128トークンとか256トークンとかをまとめてGPUに投げれば効率化できるはずだ。
なぜまとめると速くなるのか?
GPUは基本的に、細かい仕事を何度もやらせるより、大きな仕事をまとめてやらせる方が得意だ。
1箱ずつバイクで荷物を運ぶより、大型トラックでまとめて運んだ方が効率がいい。
特にMoEではExpertへの振り分けもまとめられるので、計算効率が上がる。ただしDeepSeekのattentionまわりはもともと
start_pos > 0
seqlen > 1
という状況をまともに扱えていなかった。
これはつまり、
「文章の途中から、複数tokenまとめて続きを読む」
というケースである。
リングバッファを途中から複数トークンで更新すると、前のqueryが未来のKVを見てしまう可能性がある。
これはいわゆるカジュアル性を破壊する。
Causal Attention(コーザル・アテンション)とは?
LLMは未来を見てはいけない。
たとえば5文字目を計算するとき、6文字目や7文字目を参照してしまったらカンニングである。
なのでtoken Nは、Nより前(昔)だけを見る必要がある。
これをコーザル・アテンションと呼ぶ。causal(コーザル)とは、「因果」を意味する言葉だ。
複数のトークンをまとめてブロックで処理しようとすると、この順序管理が急に難しくなる。
たとえば、
私は 昨日 東京 にまで来たとき、「次の単語」を予測するなら、その時点では後ろに続く正解の文章を見てはいけない。
したがって各位置は
1番目 → 1番目だけ見える
2番目 → 1〜2番目が見える
3番目 → 1〜3番目が見える
4番目 → 1〜4番目が見える
という三角形のような見え方になる。
図にすると、
        見てよいKey
        1  2  3  4  5

Query 1 ○  ×  ×  ×  ×
Query 2 ○  ○  ×  ×  ×
Query 3 ○  ○  ○  ×  ×
Query 4 ○  ○  ○  ○  ×
Query 5 ○  ○  ○  ○  ○
このように未来側を × にする処理を causal mask(コーザル・マスク)と呼ぶ。
128や256 tokenをまとめて処理すると、実装を間違えると前半のtokenが同じblock内の未来tokenを見てしまう。それだとCausal Attentionではなくなって、モデルがカンニングしてしまうということになる。
そこでまず、
書き換える前のring historyをコピーする
昔のコンテキストと今のチャンクを連結する
queryごとに因果的なindexを作る
最後に現在のチャンクをringに確定させる
という処理に直した。
RoPE positionも途中開始できるように修正した。
RoPEとは
RoPEは Rotary Position Embedding(回転位置埋め込みとでも訳すか)。
これはLLMに「このtokenは文章の何番目にいるか」という位置情報を与える仕組みで、長いコンテキストを処理するLLMには必須の機能だ。
途中から計算するとき、この位置番号がずれるとモデルの認識が壊れる。
だからprefix replayでは、position管理もかなり重要になる。
そうこうしてついにprefix replayをブロック化した。
最初は128トークンで試してみる結果。
78 tok/s
88 tok/s
おお。それまで45〜59 tok/sだったものが一気に速くなった。
しかし人間とは欲深い生き物である。
88を見た瞬間、
「これなら100行くだろ」
と思う。
また、multi-anchorも作った。これも高速化に効くはずだ。
Anchor(アンカー)とは
長い文章の途中途中にゲームでいうセーブポイントを置く仕組みである。
たとえば、
0
↓
10000
↓
20000
↓
30000
と毎回0からやり直すより、28000まで保存されていれば、そこから再開した方が圧倒的に速い。prefix cacheでも同じことができる。
これがmulti-anchor。
たとえば、
72,399
73,423
74,447
75,471
という具合に1K(1024) トークン間隔でsnapshotを取る。これなら次回は直近のanchorから再開できる。すばらしい。
今度はblock sizeを256にした。
すると突然景色が変わった。
[prefix-replay-block]
done=5,219/6,883
block=256
tok_s=144.2
144 tok/s。
さらに、
144.9
143.6
143.9
ほぼ144 tok/sで安定している。最終的に6,883 tokenを48.9秒。以前なら2分以上かかっていた処理である。
「これは来た!」
と思った。
だがログをよく見ると、新しい怪物がいた。
[prefix-snapshot] SAVE slots=74 size=1,605.1 MiB1個1.6GB。
は?しかもanchorを4本作るので、一回のrequestで6.4GB相当のsnapshotを作っている。
さらに、
[prefix-tmpfs] SAVE ... time=1.1s1個保存するごとに約1秒。
replay自体は48.9秒なのに、prefill全体では53.3秒。
4秒くらいがチェックポイントを保存する時間になっている。
そして再起動してみたら、
[prefix-tmpfs] LOAD-DONE entries=22 ram=34.48GiB34GB。prefix cacheだけで34GB。僕のPC人生でもなかなか見ない数字だ。
なぜこんなに巨大なのか?
理由は簡単だった。
snapshotが「実際に使ったところまで」ではなく、
事前確保した128Kトークン分のcapacityごと保存していたのだ。
Capacity(キャパシティ)と論理サイズ
プログラムでは、「実際に使っている量」と「将来に備えて確保している量」は別である。たとえば本棚を128段作ったけど、本は65段分しか入っていない。
いまのsnapshotは、本だけ保存するのではなく、本棚ごとコピーしている。
その棚には大量の空きがある。だから巨大になる。
本当は論理サイズ分だけ、つまり実際に使った部分だけ保存すればいい。100万tokenを本気でやるなら、これは必須だ。
これは大仕事だから後回しにして、その前に、僕には試したいものがあった。ブロックサイズを倍の512トークンにしてみるのだ。これでもっと速くなるといいな・・・
export DSV41_PREFIX_BLOCK_SIZE=512最初の結果が出た。その結果・・・
ここから先は
¥ 980
