DeepSeek v4.1 Flashを動かしたくてFP4に対応していないA100を、33tok/sから673 tok/sまで持っていって気がつくと公式APIより速くなっていた話

※2026/9/17 続編を公開しました
あらすじ
結論から言うと、この24時間で僕の手元で起きたことは、僕を驚かせるのに十分なことだった。そしてこれは全く新しい時代の幕開けなのだということを感じている。午前5時に。
この文章はとても長い。この24時間に僕が経験した冒険を時系列にまとめたものだからだ。
この冒険で僕がわかったことは二つ。一つは、「もっと真剣にAIと向き合えば、普通より遥かに大きな成果を得ることができる」ということ。もう一つは、「6年前のポンコツ同然のGPUで、最新のクラウドより高性能なAIを手中にできた」ことだ。
ソースコードは公開しているので、同じ設備がある人は誰でも追試できるようになっている。
そもそも最新のDeepSeek v4.1 Flashは、最新のGPUに最適化されていて、古いものには対応していなかった。僕の手元のA100ももちろん対応していなかった。普段ならそれで諦めた。もしくは、ちょっとだけ動かしてみて「動いた」と満足して終わりだった。だがそれは冒険の始まりに過ぎなかったのだ。
本文にはtok/sという単位がよく登場する。本文はこのtok/sをいかに最大化するかという挑戦の物語である。tok/sは「トークン・パー・セカンド」または「トークン・パー・セック」と読む。意味は「一秒間に何トークン出力できるか」だ。トークンとは、LLMが扱う情報の最小単位である。これが多ければ多いほどAIが速く考えているということになる。
今回達成した数字は、並列動作で最大1000tok/s、単独動作で最大165tok/sだ。バッチを大きくした結果、4GPUで1467tok/sを処理できるようになった。これがどのくらいのスピードかというと、Claude Codeがだいたい50〜80tok/sだからその二倍以上のスループットということになる。ちなみにDeepSeek公式のAPIでは400tok/sと言われている。ちなみにこれはデコードの数字で、プリフィルは含まれていない。
このブログを書き始めた時は、この冒険がこんな展開になるとは思っていなかった。そこで、あえて書き出しから時系列で残してある。まずは日常から始まる。
StackChanがある日常
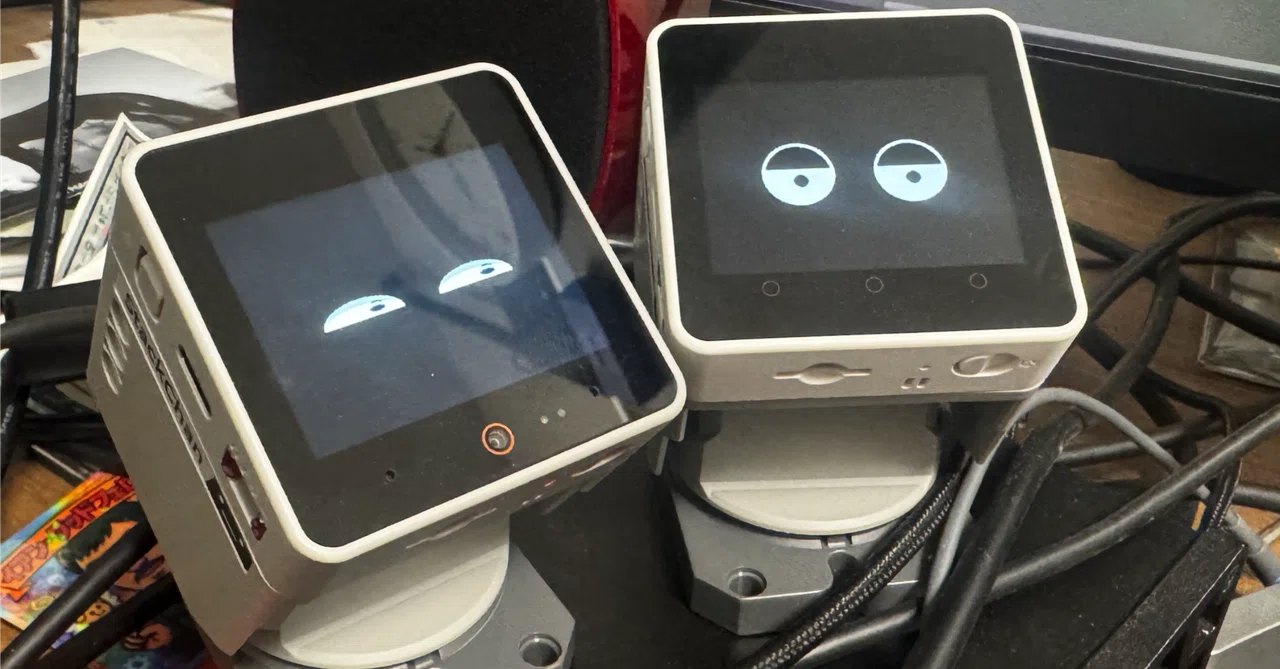
M5StackのStackchanの2台目が来た。
といっても、M5Stackそのものは余っていたのでボディだけ買ってCore2につけてみた。
ここで問題が発覚。
Core2はカメラが内蔵されていない。
同じようなものであっても同じものは動かないので仕方なく3台目(ボディは買ってある)はM5Stack純正のStackchan用M5Stackにした。
特にスピーカーの容量が違うのかな。Core2だと蚊が泣くような声でしか喋ってくれなくて少し寂しい。
2台あるので漫談させてみることにした。これはけっこう面白い。
せっかくなので顔を変える。
こんどはガチャピン的なちょっとまぶたが眠そうな感じにしてみた。
エロ目のスタックちゃんと眠そうなスタックチャン。両方可愛い。声も変えてみる。
未発表の映画の脚本で、こんなシーンを書いたな、ということを思い出した。複数のAIエージェントが互いに議論し合い、最終的に人間にわからない言葉で会話し始める。
あの頃は空想物語だったが今は現実だ。
Around 30 robots demonstrated outside Poland's Digital Affairs Ministry in Warsaw, chanting 'we want law, we want rules' to demand stronger AI oversight pic.twitter.com/GGUoOCS7JO
— Reuters (@Reuters) September 10, 2026
これもどこまでマジでやってんのかわからないけど、ロボットを並べてるだけで1億くらいかかってそう。
極めて馬鹿馬鹿しいわけですよ。このあたりの話というのは。
こんなのロボットが自主的にやるわけないし。
そんなニュースを眺めているとスタックチャンが喋り始めた。
「DeepSeek v4.1 Flashが出たらしいでー」
「さよかー。何が違うん?」
「なんかローカルでも動くらしいでー」
ローカルって言ってもまた誤家庭のやつだろ。H200x16とか必要なやつだろ。と思ったら、Mac Studio 512GBでも動くらしい。それくらいならうちにもある。
DeepSeek v4.1 Flashの衝撃
今回のDeepSeek v4.1 Flashは名前こそv4の改良版のようだが、実はアーキテクチャが大きく異なっていて、engramという辞書のようなものを持つことで高速化と低VRAM化を両立させている。この辞書が馬鹿でかいのだが、そんなに頻繁に使うわけではないらしい。そこでengramは別にVRAMになくてもいいのでSSDに逃したり4ビット化してシステムメモリに持ったりと色々な逃がし方ができる。
DGX Spark 4台で動くとか、「酔狂な人だけが持ってる」マシンという意味では我が継之助(A100x8)もさほど変わらない。
ところが継之助はAmpare世代なのでFP4とか最新の計算手法が高速化されない。普通にClaude Codeにやらせようとしたら「vllmが対応してないので無理です」とつれない返事をされた。
ここで一旦は諦めかけたのだが、いやちょっと待て。本当にそうか?
冷静に考えると4ビット浮動小数点って、たかが4ビットが二つで掛け算の結果は高々8ビット、つまり256種類しかないから全部ルックアップテーブルに乗るやんけ、という話をChatGPTにしたら「乗ります乗ります」というのでAmpare用にDeepSeek v4.1 Flashを移植してみた。
「AmpareでFP4を処理するライブラリがありません」
「既存のライブラリに頼るな。それくらい自分で実装しろ」
思うに、AIをうまく使えるかどうかの分水嶺はこういうところにあるのではないかと思う。
A100x4でもA100x8でも動作するがVRAMはさほど使わない(290GBくらい)。継之助はそもそもシステムメモリが1.7TBある。本当は1.7TBという半端な仕様ではIntel公式には動作しないのだが、僕と大沼さんで試行錯誤した結果、この裏技的システムが実現したのである。
分散した時の推論速度は最大33tok/sで、これなら十分実用になる。その推論性能がFable-5とかAstraに迫るとしたら、安いくらいだ。
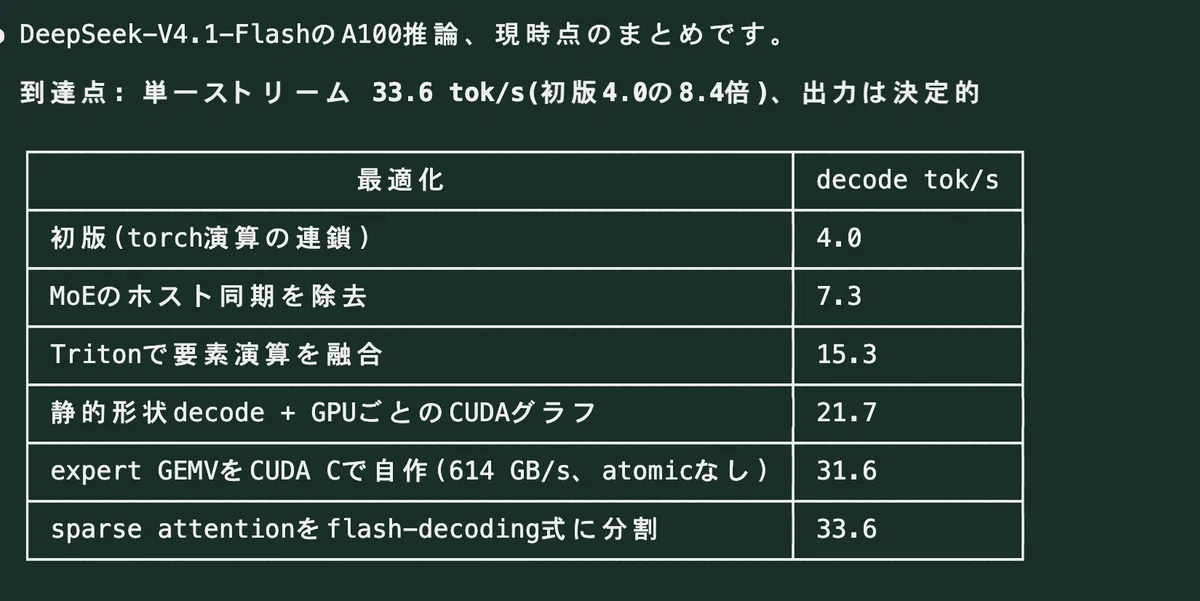
ソースコードは公開している。
ちなみにA100x1でも動作する。その代わりシステムメモリからの転送で律速されてしまうので5tok/sほど。
DeepSeek-V4.1-Flash がA100x1で動いたよー
— shi3z (@shi3z) September 11, 2026
5tok/sって言うけど確かにそれくらいかなあ。賢さは短い質問ではわからん pic.twitter.com/tbUErnaBZE
A100 80GBを6枚使うと33tok/sになった。
A100x6だと33tok/sいくことは確認した。
— shi3z (@shi3z) September 11, 2026
こうなるとスピード狂のようにもっと速度を追求したくなる pic.twitter.com/9fw8ahqLbf
Xeon SilverなのでそんなにCPUが強いわけではないのだが、FP4計算はXeonにやらせると言う技が使えそうだ。このマシンであまりCPU性能について深く考えてこなかったが、よく考えたら1.7TBもRAMがあるマシンとか普通じゃないのでもっと使う方法を考えれば良かった。
するとDGX Sparkばっかり6台も買ってる安物買いの銭失い散財家のdrikinが煽ってきた。
これは動いたと言えるのでしょうか?w https://t.co/9DsLkmg8vr
— プロ散財家 どりきん (@drikin) September 11, 2026
drikinはDGX Spark四台で100tok/sくらい出してるらしい。
DeepSeek-V4.1 Flash が Spark 4台で動いたんですけど、いきなりこの過去一のスコア叩き出しました!
— プロ散財家 どりきん (@drikin) September 11, 2026
やっぱりローカル LM に関しては、DeepSeek 無双状態がまだ続くんですかね? pic.twitter.com/EELGKIWOZf
おいコノヤロー。
俺と最適化で勝負しようってのか。
よしこれはもう本気出すしかない。
ポンだしのDGX Spark 4台ぽっちのガラクタで腐ってもデータセンタークラスのGPUを持つ継之助が舐められちゃいけねえ。
今に見てろ。あんな細いバスのDGX Sparkなど何個あってもただのガラクタだと教えてやる
— shi3z (@shi3z) September 11, 2026
怖いwww https://t.co/BYeF2QhpYn
— プロ散財家 どりきん (@drikin) September 11, 2026
50にもなって厨二病全開で申し訳ないが、最適化勝負だったら見過ごせない。
そもそもA100でDeepSeek v4.1 Flashが動くこと自体がレア、というか他に例を見たことがないので世界初である。
そしていまさら説明するまでもないが、A100はAmpere世代のデータセンターGPUだ。僕の手元には80GB版が何枚かある。
問題は、最近の巨大モデルがだんだんA100に優しくなくなってきたことだ。FP8。FP4。NVFP4。MXFP4とかとか。
新しいモデルは「Blackwellなら速いですよ」という顔をして配布される。しかしA100にはネイティブなFP4 Tensor CoreもFP8 Tensor Coreもない。
ではA100はもう使い物にならないのか?
そんなわけがない。
「FP4非対応」という言葉を疑う
最初に引っかかったのは、
「Ampare世代はFP4に対応していない」
という言い方だった。
FP4とは何かというと、4ビット浮動小数点数のことだ。
浮動小数点(floating point)というのは、要するに指数部と仮数部、そして符号にそれぞれビットを割り当てて数を表現する形式だ。
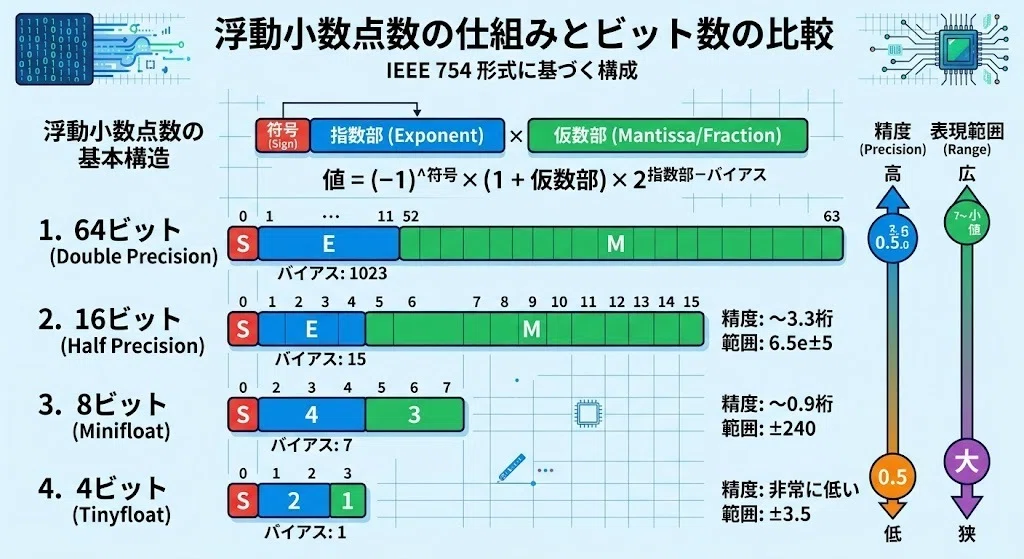
通常のスーパーコンピュータでは64ビット浮動小数点数をよく使う。これは天気予報や天体計算なんかに使われる。巨大な数字と小さい数字を両方表現できる便利なものだ。
ところがAIはこの表現が極端に狭くても問題ないことがここ数年の研究でわかってきた。そこで最近は4ビット浮動小数点数(FP4)を使ってもLLMの推論くらいなら問題ないことがわかっている(もっと極端には1ビットの符号だけでもいいという説もある)。
DeepSeek v4.1 FlashはこのFP4を大量に扱う。FP4のメリットは、4ビットしかないので通常AIで使われる16ビット浮動小数点数(FP16)の1/4の情報量となることだ。これは同じメモリに4倍詰めることを意味する。これが速度に効いてくる。
これに対応しているGPUだと、同じVRAM容量でも4倍の情報を扱えるということになる。いいことづくめのようだ。
しかし、この表を見て考えると、妙なことに気づく。
いや、FP4って所詮4ビットじゃん。計算機はむしろもっと単純になるじゃん。
だったら4bit×4bitの積なんて256通りしかない。LUT(ルックアップテーブル/早見表のこと)にしてしまえばいい。
さらによく考えると、LUTすら要らない。
E2M1(2ビットの指数部、1ビットの仮数部)の値を2倍すれば、
0
±1
±2
±3
±4
±6
±8
±12
という小さな整数になる。
つまりE2M1そのものは、情報を一切失わずINT8(8ビット整数)へ変換できる。
だったらA100のINT8 Tensor Coreに食わせればいい。
ここで重要なのは、「保存形式」と「演算形式」を同じにする必要はないということだ。
FP4非対応というのは、「4bitのデータをA100で計算できない」という意味ではなく、正確には、「BlackwellのようにFP4をロードして、block scale込みでそのままTensor Coreへ突っ込む命令がない」という意味なのだ。
ところが、本当の敵はFP4ではなかった
最初はFP4をどう計算するかばかり考えていた。
しかしプロファイルを取ってみると、もっとひどい問題が出てきた。
1枚構成ではMoE expertをホストRAMに置いて、選択されたexpertをPCIe経由でA100へ転送していた。
これが遅い。
ナメクジが這うように遅い。
1 tokenあたり約4.5GBのexpert weightを転送していて、PCIe Gen4 x16の実効帯域が約25GB/sなので単純計算すると、4.5/25≃180 ミリ秒もかかる。
実測もほぼその通りで、約179ミリ秒。
これだけで理論上5〜6 tok/sしか出ない。
FP4の積和演算を20%速くするとか、そういう次元ではない。
4.5GBを毎token PCIeに流している設計自体が間違っていた。
GPUに送るくらいならCPUで計算した方が速い
幸い、このマシンのCPUは普通のデスクトップCPUではなかった。
Xeon Silver 4410Yが2ソケットの合計24コア48スレッド。16チャネルのDDR5-4000 RAMが1.7テラバイト。AVX-512、VNNI、AMXまである。
だったら、expertをGPUへ送らず、そのままCPUで計算してしまえばいいのでは?ということになる。
FP4の情報をRAM上で4ビットのまま保持する。
CPUレジスタへ読んでからINT8へ展開し、VNNI(Vector Neural Network Instructions/インテルが開発したAI専用命令)で積和する。
すると40層ぶんで、
PCIe DMA        179 ms
CPU BF16         62 ms
CPU INT8 VNNI 51 msになった。つまり、GPUで計算するためにGPUへ送るより、CPUで全部計算した方が3倍以上速かった。
異種計算機アーキテクチャではよくあることである。
理論演算性能だけ眺めていると絶対に気づかない。
だが結局CPUもそこまで速いわけではない
51ミリ秒まで縮んだのはいいが、まだ遅い。しかもDRAM帯域を調べると、理論512GB/sに対して実効89GB/s程度しか出ていない。最初はメモリ帯域律速なのかと思ったけど違った。命令律速だった。
FP4のunpack、shuffle、scale、address calculationなどを大量に実行しており、1層あたり数千万命令を叩いていた。なんでだよ。ここらへんに無頓着なのがClaude Codeの雑なところである。普通に考えたら、一層当たり数千万命令を叩くプログラムとか、正気のプログラマーは書かない。
・・・いや、書いた人を見たことがある気がするが、そいつは紛れもなく三流のプログラマーだった。CPUが何をどのようにして欲しいか想像もしないようなヤツだ。Claude Codeも雑に使えば三流のプログラマーと同じように発想する。
そこでウェイトの配置を変えることにした。
普通のモデルでは、モデルファイルにどう保存するかを基準にデータ構造を考えがちだ。Claude Codeもそうしていた。
しかし推論専用ならそんなものはどうでもいい。CPUが一番食いやすい順番に、ロード時に全部並べ替えればいい。
nibbleの配置を変え、複数rowでactivationのロードを共有し、scale計算を共有する。GPUと同じで、CPUでも「演算を減らす」より「余計な仕事をしない」方が効く。当たり前の話だ。
そして発覚した2000回/tokenのカーネル起動
GPU側もプロファイルしてみた。
ある時点で1 tokenに28.4msかかっていた。お前はカタツムリか!いくらなんでも遅すぎる。
コンピュータにとっての1ミリ秒、つまり1/1000秒というのはほとんど無限大に近い時間だ。それが28ミリ秒もかかってる。なにかおかしなことが起きていると直感した。この直感を、AIは持つことができない。
実際、Claude Codeは早々に「これが限界です」とか舐めたことを抜かす。ついこないだ生まれたようなガキが。知ったふうな口を聞くな。
ここで大切なのは直感である。
「そんなわけあるか」と思えるかどうか。
AIの言う寝言を鵜呑みにしていたら、この先には進めない。
じゃあ実際なにをやっているのかベンチマークをとってみると・・・
expert GEMV      7.0 ms
dense GEMM       9.2 ms
その他          約12 ms
ちょっと待て、メイン計算以外の「その他12ms」って何だ?
調べると、1 token生成するだけで2000回近くCUDA kernelを起動していた。アホか。
1回数マイクロ秒なら、それだけで10ミリ秒を超えてしまう。
GPUが遅いのではない。
GPUに仕事を頼む手続きで時間を使っている。正気じゃない。
RMSNorm、RoPE、量子化、非量子化、擬量子、それと細えエレメントごとの演算・・・40層ぶん、それぞれ別々のkernelとして起動していたら、そりゃ遅い。アホか。どうしてこれでおかしいと思わないんだ。
思うに、このあたりがエージェンティック任せっきりコーディングの限界なのである。頭の中でCPUとGPUがマイクロ秒単位、場合によってはナノ秒単位で何をしているかイメージできるか?ミリ秒と聞いて思考停止していたら永久に辿り着けない。それはそのマシンの本当の性能を引き出せてないと言うことだ。
ここから先は
¥ 980
