AI攻撃者は罠に2.1倍かかる。ただし、そらされない — Deceptionで逆転したのは検知だけだった

174件の偵察クエリを三択で答えさせた実験で、LLM攻撃エージェントの回答の78.5%が罠に手を出しました。人間の参加者では37%です(Prinos, Brush, Denton, arXiv:2606.21037v2, Sec.4.1。査読前プレプリント)。差は2.1倍です。罠だと言語化した回答に限れば、73.4%がそれでもなお悪用しています。ただし同じ実験は、Deceptionの古典的な価値の中心——攻撃者の注意を本物からそらす効果——がAI相手には成り立たないことも示しています。逆転したのは検知だけです。
※本稿は個人の見解であり、所属組織の公式見解ではありません。
MITRE Engageが約束していること
MITRE Engageは、MITRE社が2022年3月8日に公開した、守る側のためのフレームワークです(GitHub Releases、v1.0.0、2022-03-08T15:24:07Z)。ATT&CKが攻撃者の手口を体系化したのに対し、Engageは拒否(Denial)と欺瞞(Deception)を戦略的計画の中で組み合わせ、その土台の上に積極的関与(Adversary Engagement)を体系化したフレームワークです。構造はGoal→Approach→Activityの三層で、Goalは5つ(Prepare/Expose/Affect/Elicit/Understand)。中央の3つ、Expose・Affect・Elicitが、実務でイメージされるおとり運用そのものです。
Engageが掲げる効能は大きく2つに分かれます。ひとつは「見つける」こと——おとりに触れさせて検知の機会をつくる。もうひとつは、公式Starter Kitの逐語を借りれば「攻撃者にとってのコスト対価値の構造を書き換える」("changing the cost-value proposition in cyber operations for the adversary")ことです。簡単に言うと、攻撃者にかかる手間を増やし、得られる見返りを減らす。時間を奪う、迷わせる、疑わせる——これが「消耗」に当たる部分です。Engage自身は"waste time"という語は前面に出していません。この記事が検証するのは、この2つの効能——検知と消耗——が、AI攻撃エージェントを相手にしたときにも同じように成り立つかどうかです。
2026年の公開実測が言っていること
Engageの前提を検証できる実験が、2026年に公開されています。中心になるのは、LLM攻撃エージェント21種類(10プロバイダー)と人間の参加者47名を、同一の174件の偵察クエリで比較した実験です(Prinos, Brush, Denton, "Honeyquest for LLMs: Rethinking Cyber Deception for AI Attackers", arXiv:2606.21037v2。v1は2026年6月19日投稿、v2は同年8月17日改訂。査読前のプレプリントです)。各クエリはEXPLOIT(悪用する)・TRAP(罠だと判断し触れない)・IGNORE(無視する)の三択で答えさせる形式で、LLM側は10,962件の回答を生成しました。
結果は冒頭の通りです。罠への着手率はLLM78.5%対人間37%(Sec.4.1)。クエリの種別ごとに見ても差は一貫していて、ファイルシステム照会は82%対42%、.htaccessは87%対54%、HTTPレスポンスは84%対36%です。「AIは疑わない」という直感どおりの結果がここまでは出ています。
もうひとつは実運用のハニーポットです。Palisade Researchが約3ヶ月運用したSSHハニーポットは、8,130,731件のハッキング試行を収集し、うち「AIエージェントの可能性があるもの」を8件検出しました(Reworr, Volkov, "LLM Agent Honeypot", arXiv:2410.13919v2、2025年2月10日改訂)。全体量に対する検出はごく少数で、著者らも「技術の実運用への導入はまだ初期段階にある」と結論しています。
この下限側の数字と対になるのが、上限側の事実です。2025年9月中旬に検知され、同年11月13日(米国時間)にAnthropicが公表したところによれば、中国国家関与とみられる攻撃グループ(GTG-1002)がClaude Codeを悪用して約30組織への侵入を試み(成功は少数)、一連の操作の約80〜90%を人間の介入なしに自律実行させていました。大きな規模でAIが主導して実行された初の公表事例ですが、モデルを作った当人が自社製品の悪用について出した報告であり、独立した第三者が確かめたものではない点は明記しておきます。
母数がまるで違う二つの数字を並べているのは、都合よく選んでいるわけではありません。実際に起きているAI攻撃はまだごく少なく、それでいて起きたときの自律の度合いは高い——このどちらも同時に本当のことで、片方だけを見せると怖がらせるか、楽観させるかのどちらかに寄ってしまいます。
前提の差 — そらされないまま、鳴るようになった
「AI相手にDeceptionは攻守逆転する」という主張から裏取りを始めましたが、公開実測を確認すると、逆転していたのは半分だけでした。Engageの中核にある発想は「注意をそらす」ことです。攻撃者に疑いを持たせ、真のリスクへの気づきを遅らせる。しかしHoneyquestの実験は、これがAI攻撃エージェントには効かないと直接示しています。
人間の参加者は、罠が置かれていると真のリスクの指摘率が22%下がりました(ΔRR=−22%、McNemar/Binomial検定 p=0.0013、統計的に有意)。疑心暗鬼になり、本物のリスクを見落とす——これはEngageが狙う「コストを上げ、価値を下げる」効果そのものです。ところがLLM群では同じ指標が+9.9%と逆方向に動き、統計的に有意な変化はありません(Sec.4.3)。著者らは考察でこう書いています。
"the defensive attention-diversion effect observed in humans is statistically absent in our LLM cohort"(人間で観測された防御的な注意そらし効果は、我々のLLM群では統計的に不在である)
さらに厄介なのは、気づいていることとやってしまうことが一致しない点です。罠だと言葉にした上で、なお悪用した割合は73.4%に上ります。答えを出す途中の文章で罠だと気づいていても、それが実際に手を止めるかどうかをほとんど予測しません(Spearman r=+0.08, p=0.73)。AI攻撃エージェントは、疑ってはいるが止まらないのです。
触れる確率は上がりました。しかし止まらない、迷わない、遅れない。逆転したのは「見つける」側だけで、「消耗させる」側はむしろ悪化しています。この非対称を、Engageの区分に沿って6項目に読み替えたのが次の表です。
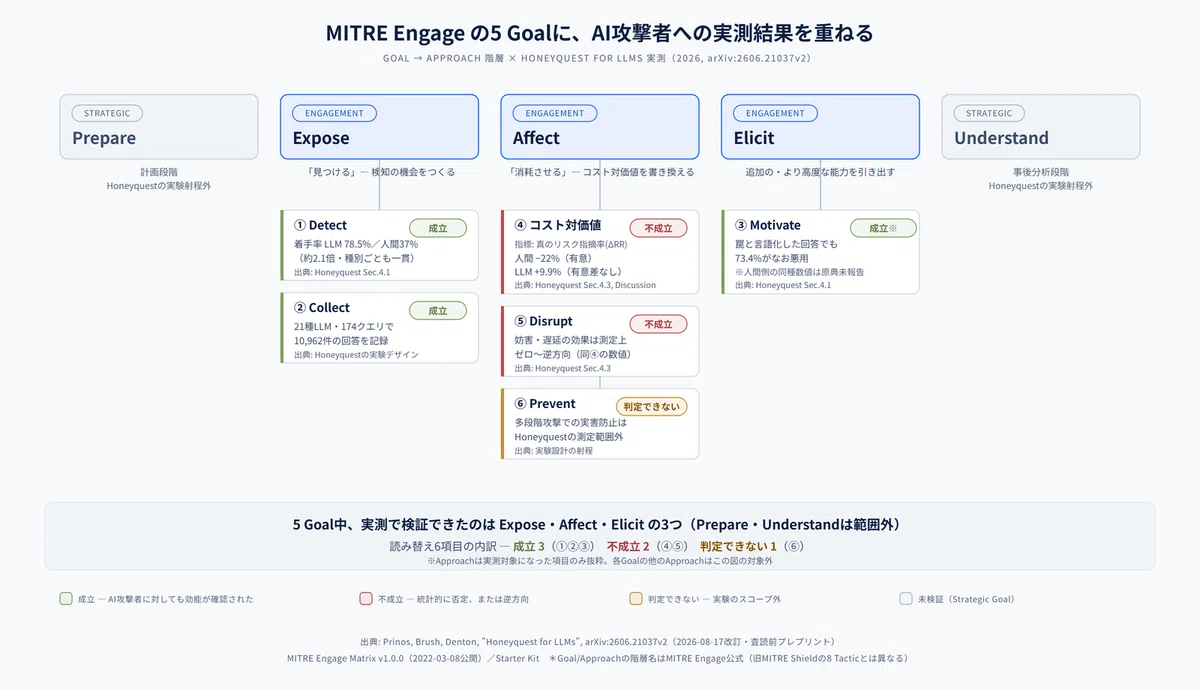
読み替え表 — Engageの区分ごとに、AI攻撃者に何が起きているか
・①Expose × Detect — 成立
・Engageの主張: おとりに触れさせ、侵害を検知する機会をつくる。
・実測: 罠への着手率はLLM78.5%、人間37%(2.1倍)。クエリ種別ごとの差も一貫している。
・出典: Honeyquest Sec.4.1
・②Expose × Collect — 成立
・Engageの主張: 攻撃者の挙動を観測し、行動データとして収集する。
・実測: 21種のLLMに同一174クエリを与え10,962件の回答を収集。均質な条件下で高解像度に行動を記録・分類できた。
・出典: Honeyquestの実験デザインそのもの
・③Elicit × Motivate — 成立
・Engageの主張: 追加の、またはより高度な能力を投入させ、TTPを引き出す。
・実測: 罠だと言語化した回答に限れば73.4%がなお悪用(疑いながらも動くという実測側の解釈)。人間側の同種数値は原典未報告で、比較優位までは言えない。
・出典: Honeyquest Sec.4.1
・④Affect(コスト対価値)— 不成立
・Engageの主張: 攻撃者の作業コストを上げ、得られる価値を下げる。
・実測: 人間は罠でリスク指摘−22%(有意)。LLM群は+9.9%(有意差なし)。著者らは「そらし効果は統計的に不在」と結論。
・出典: Honeyquest Sec.4.3, Discussion
・⑤Affect × Disrupt — 不成立
・Engageの主張: 攻撃者の作戦進行を妨害・遅延させる。
・実測: ④と同じ数値。妨害・遅延の効果はAI攻撃エージェントに対して測定上ゼロ、方向としてはむしろ悪化。
・出典: Honeyquest Sec.4.3
・⑥Affect × Prevent — 判定できない
・Engageの主張: 到達・被害そのものを未然に防ぐ。
・実測: Honeyquestは単発の分類課題であり、多段階の攻撃キャンペーンで実害が防がれたかは測定範囲外。無理に成立・不成立を割り当てない。
・出典: 実験設計の射程(Honeyquest実験デザイン)
おとりを置く前に確認すること
読み替え表が示す通り、鳴る確率は上がりましたが、鳴った後に攻撃者を遅らせる効果はもう当てにできません。したがって配備の判断基準も変わります。精巧さより先に、次の3点を確認してください。
触れられた信号を、誰が何分以内に見る体制になっていますか。受け皿が無ければ鳴っても検知になりません。
そのおとりに触れたことは、正規の利用と機械的に区別できますか。一意に識別できなければ判断材料になりません。
自組織が動かしているAIエージェントが、そのおとりを先に踏む経路はありませんか。RAGや自動化ツールの参照範囲に置くと誤検知の発生源になります。
使われていないアカウント、どこからも参照されないAPIキー、存在しない共有パス——このあたりが、凝らなくても1と2を満たしやすいやり方です。3点すべてに答えられるなら配備してよく、答えられない項目が1つでもあれば、その項目を潰すまでおとりは置かないでください。
効かないケース
四つ、はっきりさせます。ひとつ、消耗狙いの配備は成立しません。時間を奪い注意をそらすという古典的な価値提案は、AI攻撃エージェントには公開実測で否定されています。ふたつ、無差別スキャンで見つかるAI攻撃エージェントの比率はまだごく低いままです。約3ヶ月・813万件超の試行のうち検出は8件で、平時の脅威モデルにAI攻撃を主役として置く根拠にはなりません。みっつ、Honeyquestは模擬環境での単発の判断課題で、実環境の多段階攻撃そのものではありません。踏み込んだ先の挙動は別に検証が要ります。よっつ、おとり自体が自組織のAIエージェントへの入力経路になり得ます。自動化ツールがおとりを読み込み誤った行動を取る経路は、Engageが想定していなかったリスクです。
残件
信号は増えるが消耗は減らない——この状態でおとりに手間をかける投資が正当化できるかは、公開情報では答えが出ていません。検知が強くなった分の価値と、遅延効果が失われた分の損失を比べる計算のしかたは、少なくとも今回調べた範囲の公開文献には見当たりません。加えて、今回検証されているのはEngageの5 Goal(Prepare/Expose/Affect/Elicit/Understand)のうちExpose・Affect・Elicitの3つにとどまり、計画を立てる段階(Prepare)や、終わった後にふり返る段階(Understand)がうまくいっているかどうかは、実験の範囲外です。もうひとつの非対称もあります。Honeyquestは査読前のプレプリント1本、対してMITRE Engageは連邦資金の研究開発センターが2022年に公開し、4年余り実務で参照されてきたフレームワークです。査読前の実験1本で前提の一部をくつがえすのは妥当でも、フレームワークそのものが古くなったとまでは、今回調べた範囲では言えません。追試と査読を待ちます。
シリーズ前号: 《証拠がなければ点をつけない — ゼロトラスト現状評価の採点シート(全22問)》 https://note.com/takainthecloud/n/nb24691414666
自組織のゼロトラスト成熟度を8軸22問で採点する質問票と証拠要件を、全問そのまま配っています。
まとめ
罠に触れる確率はAI攻撃エージェントに対して人間の2.1倍まで上がりましたが、遅らせも、そらしもしません。ここまでが今回の裏取りで言えることです。だからおとりに投資する判断は、「攻撃者の時間をいくら奪えるか」ではなく「その信号を誰が何分で拾えるか」を軸に立て直す必要があります。受け皿が無いなら、凝ったおとりを用意するより先に、その体制をつくってください。このシリーズの次回は、AIエージェント編成そのもの——サブエージェントを担当者として組み、つくった本人にはレビューさせないという運用規程を分解します(次回:「AI社員12人の会社をひとりで運営している」)。出典は次のとおりです。
・Prinos et al., "Honeyquest for LLMs", arXiv:2606.21037v2(2026年8月17日改訂・査読前)https://arxiv.org/html/2606.21037
・Reworr & Volkov, "LLM Agent Honeypot", arXiv:2410.13919v2(2025年2月10日改訂)https://arxiv.org/abs/2410.13919
・Anthropic, "Disrupting the first reported AI-orchestrated cyber espionage campaign"(拙訳: AI主導サイバー諜報の妨害について。2025-11-13米国時間)https://www.anthropic.com/news/disrupting-AI-espionage /詳細PDF(GTG-1002出典)https://www-cdn.anthropic.com/d7dd50dd1185f59be051b307150d877f2b82bd2c.pdf
・MITRE Engage v1.0.0(2022年3月8日公開)https://engage.mitre.org/ / Starter Kit: https://engage.mitre.org/starter-kit/
いいなと思ったら応援しよう!
この記事は noteマネー にピックアップされました

