ChatGPTの「ステッカー」を試したら、SynthIDもC2PAも検出されない?Clawdが誕生した

ChatGPTの画像生成に「ステッカー」というプリセットが増えていました。
キャラクター画像を1枚渡すと、表情違いのステッカーを9枚まとめた透過PNGを作ってくれます。ChatGPTが作った画像には、AIが生成したことを示すシグナルが埋め込まれていて、専用の検証ツールで確認できます。ところが何枚か作っているうちに、1枚だけ何も検出されないものが出てきました。
そこから数時間ほど原因を追いかけることになりました。分かったのは、透かしが消えていたわけではないこと、そしてOpenAIの検証ツール側にも別の問題があることです。順を追って書きます。
1. ステッカー機能を試す
仕組み自体は素朴で、あらかじめ用意された英語のプロンプトに画像を乗せる形です。入力欄に流し込まれる既定の文面はこうなっていました。
Create a Meme sticker pack based on the images attached, remixing with
😎😛💕🚀🥳. Use exaggerated internet-reaction expressions, including crying,
confusion, shock, smugness, side-eye, and deadpan disbelief, with awkward
poses, low-fi cutout textures, and absurd humor.

Create a single square(1:1) transparent sticker sheet with nine distinct
stickers arranged in a 3×3 grid, each showing a different expression, pose,
or reaction. Separate the stickers with wide, fully transparent gaps. No
background, shadows, or overlapping elements.
使う表情として、泣き、困惑、驚き、ドヤ顔、ジト目、真顔での呆れが挙げられています。これらを描き分けたステッカーを3×3のグリッドに9枚、透明な余白で区切って並べろ、という指示です。
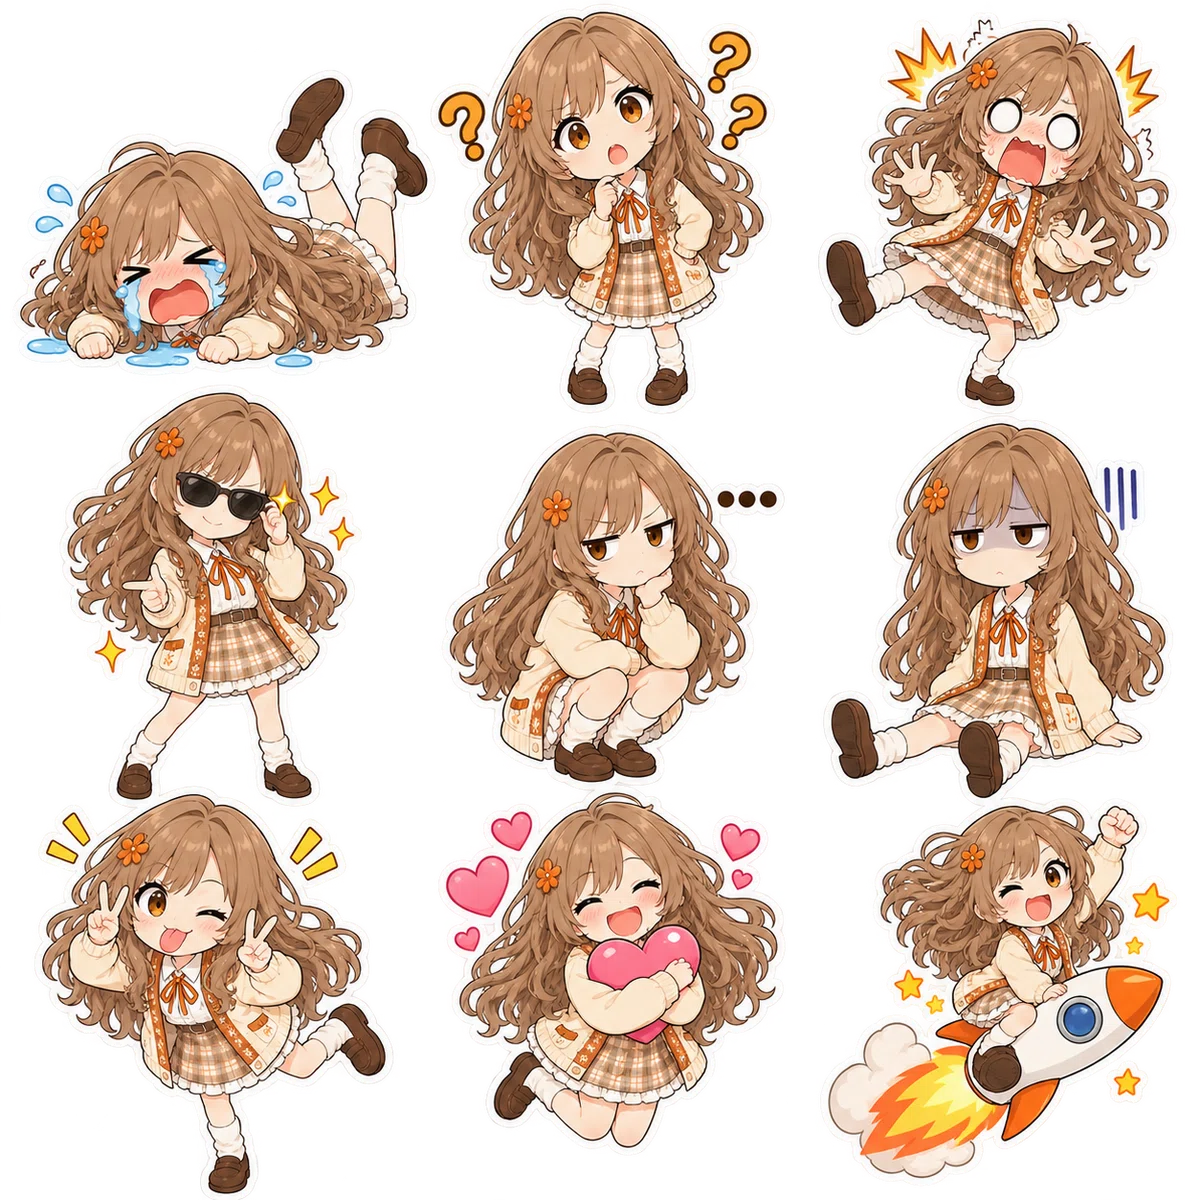
まずアニメ調のキャラクター立ち絵で試したところ、これがかなり良い出来でした。カーディガンの刺繍、チェックのスカート、髪に挿した花の飾りまで保たれたまま、9通りの表情とポーズが並びます。識別できる特徴が多い被写体ほど、この手のリミックスは強いようです。
問題は次でした。Anthropicのマスコット?「Clawd」をドット絵に描き起こしたものが手元にありました。渡してみると、出てきたのは正体不明の四足獣です。オレンジ色であることと四角い目だけが辛うじて残り、カニだった面影がありません。しかもドットのエッジが紙のコラージュのような質感に置き換わっていて、ピクセルのグリッドが崩れています。
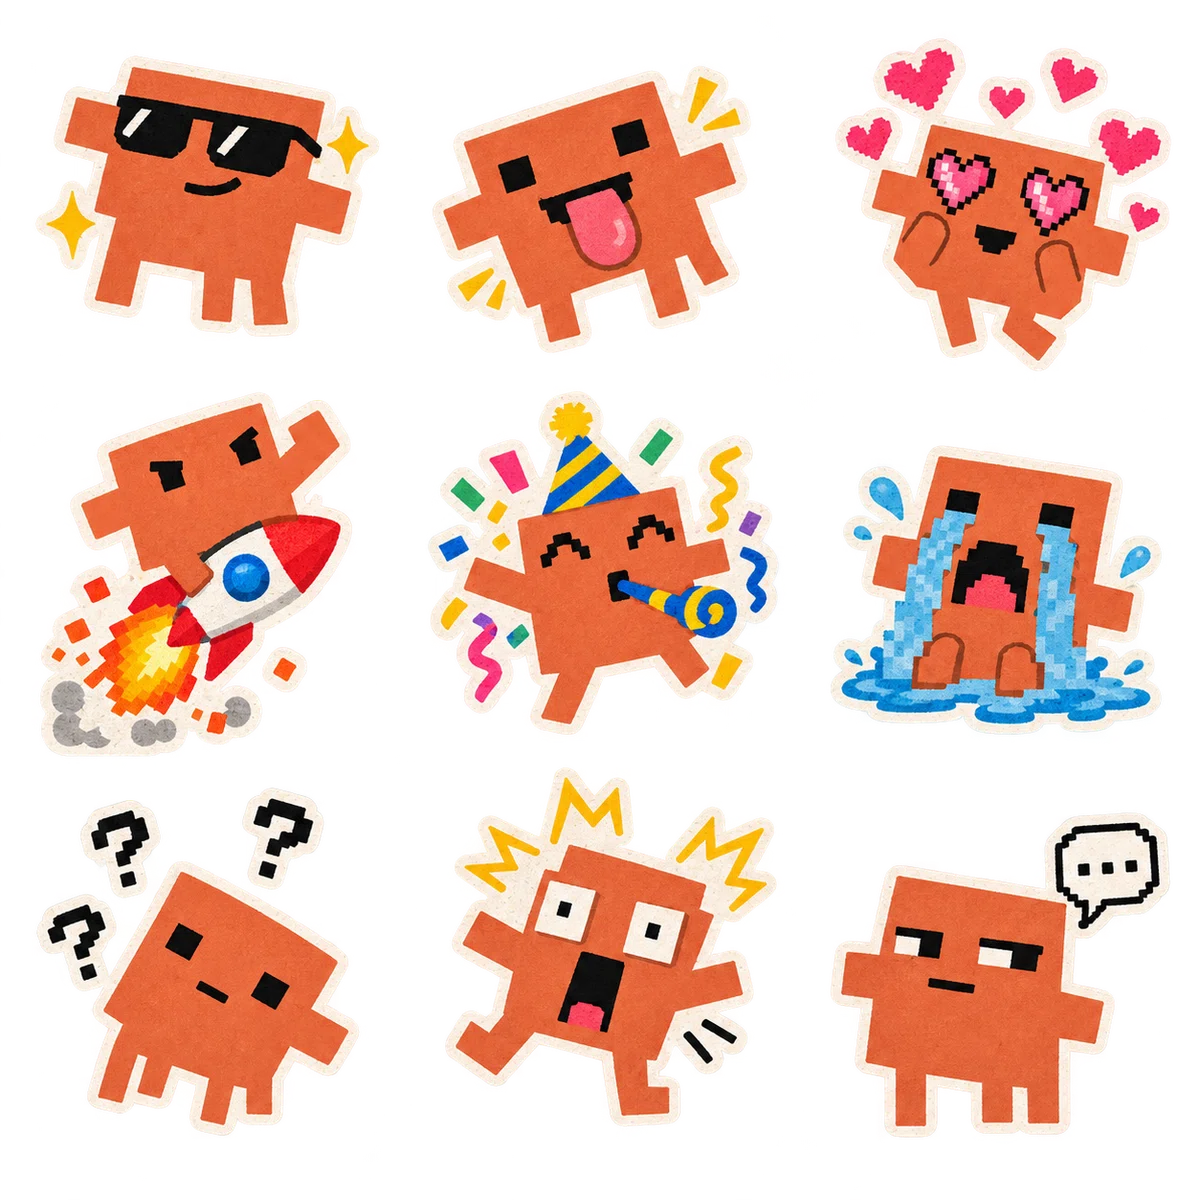
このとき渡したのは、手元にあった低解像度のキャプチャ画像でした。まずはそこを疑います。
2. 解像度を上げても直らなかったもの
元データから高解像度で書き出し直し、同じプロンプトで作り直しました。効果は確かにありました。ピクセルのエッジが硬く保たれるようになり、紙の質感に潰されなくなります。色も元のオレンジをほぼ維持していました。
ところが今度は、別のところが壊れていました。元のClawdは横に平たい体で、脚が3本、口はありません。生成物はどれも縦に起き上がった2本脚になっていて、しかも口が生えています。質感の問題は解像度で直り、骨格の問題は直らなかったわけです。
原因はプリセットの書き方にありました。指定されている感情の語彙が、泣き顔・ドヤ顔・ジト目と、すべて顔の表情に関するものです。つまり正面を向いた顔がある被写体を前提にしています。ところがドット絵のClawdは、横に平たいシルエットが持ち味で、曲げる関節も表情筋もありません。表情とポーズを作れと言われたモデルは、自前の骨格を当てはめて体ごと作り直してしまいます。
そこで、Claudeに相談して、プリセットを捨てたプロンプトを組み立ててもらいました。実際に使ったのがこちらです(ChatGPTに相談しないのかよ、というセルフツッコミ🫥)。
Recreate the attached pixel-art character EXACTLY as drawn: wide flat body,
roughly 2:1 width-to-height, two short side arms, three stubby legs, two
black square eyes, no mouth, flat orange fill, hard pixel edges, no
anti-aliasing, no gradients, no paper or cutout texture, no outline stroke.

Do NOT redesign, do NOT anthropomorphize, do NOT add a mouth, do NOT change
the leg count, do NOT stand it upright on two legs. The silhouette is the
character's identity and must be preserved in every sticker.

Express emotion ONLY through: added props, motion lines, and small symbol
elements placed AROUND the character (tears, sweat drops, question marks,
sparkles, hearts, confetti, lightning bolts, sunglasses laid over the eyes).
The body itself may tilt or shift at most 15 degrees.

Single square (1:1) transparent PNG, 3x3 grid of nine stickers, wide fully
transparent gaps, no background, no shadows, no overlapping.
ポイントは2つです。シルエットこそがこのキャラクターの正体だと最初に宣言し、体を起こすな・脚の本数を変えるな・口を足すなと個別に釘を刺すこと。そして感情を表情ではなく、体の周りに置く記号(涙のしずく、疑問符、稲妻、紙吹雪、目の上に載せたサングラス)だけで表現しろと縛ることです。ドット絵のマスコットはもともとそういう文法で動いているので、そこを言葉にして渡してやる形になります。
これは効果がありました。9枚すべてで平たい体と3本の脚が保たれ、口も生えていません。同一性は完璧です。ただし9枚とも体がほぼ同じになり、ステッカーというより、同じ絵に飾りだけを足したバリエーション集に近い仕上がりです。何かを縛れば、何かを失います♦️。
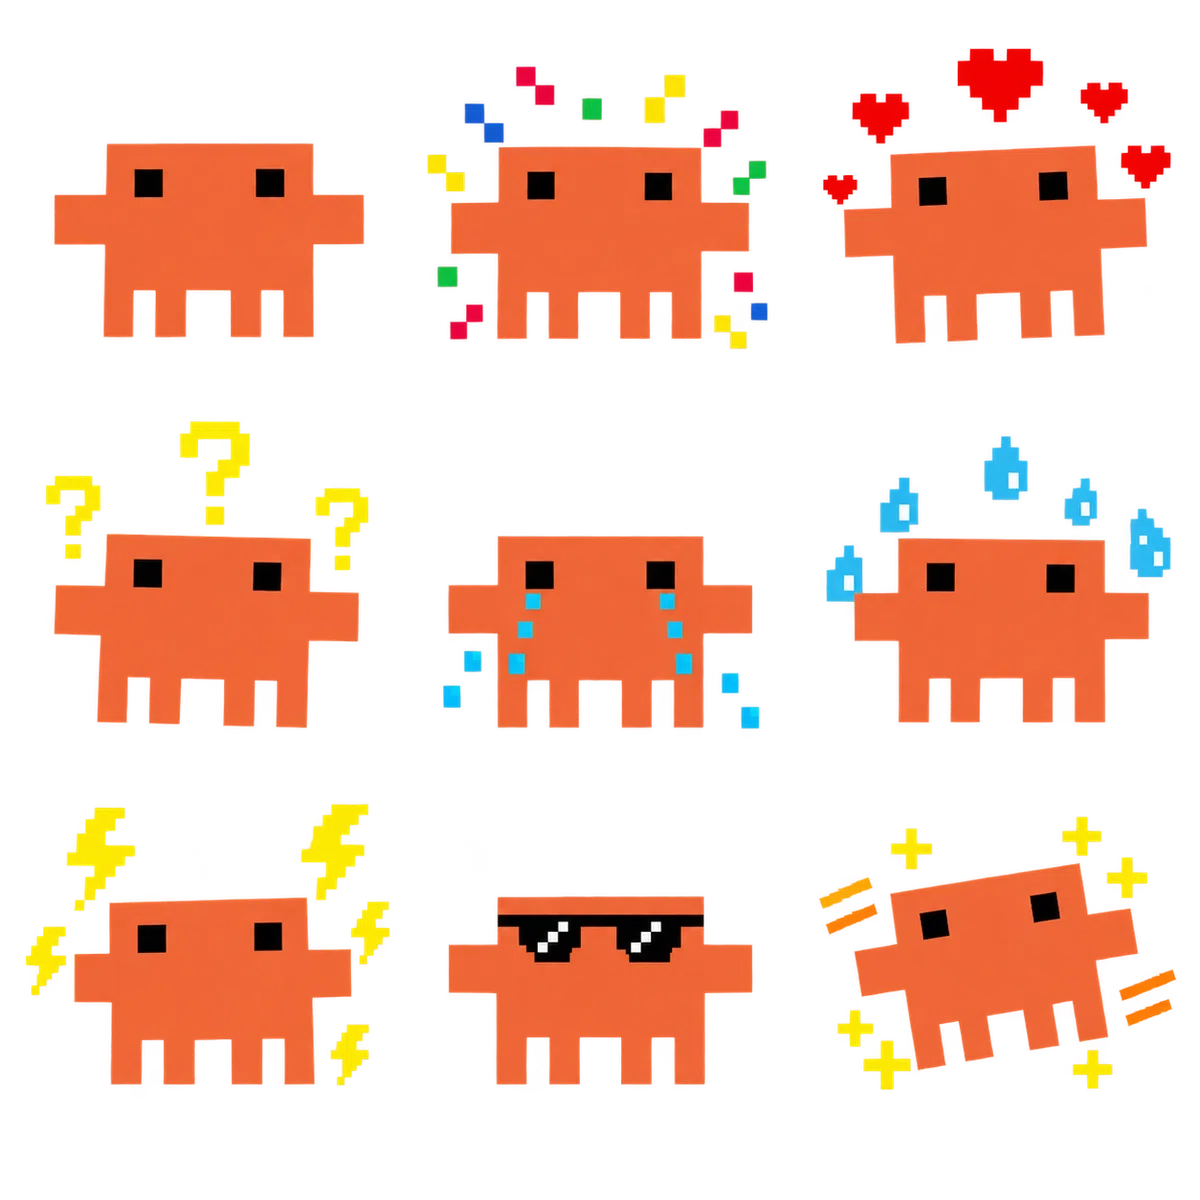
3. 来歴シグナルを確認したら、何も出なかった
OpenAIは2026年5月に、GoogleのSynthIDを採用してC2PAと組み合わせる方針を発表しています。C2PAは署名付きの来歴情報を扱う規格で、画像の場合はファイルにメタデータとして埋め込まれます。SynthIDのほうは、画素そのものに埋め込む不可視の透かしです。メタデータはスクリーンショットやファイル変換で失われやすいので、画素側の透かしがそれを補うという二層構えになっています。あわせて、誰でも画像を投げ込める検証ツールのプレビュー版も公開されました。
自分は5月にこの仕組みを試した記事を書いています。そのときは画像編集ソフトで画質をひどく荒らしても、SynthIDは検出されました。相当に頑丈だという印象を持っていました。
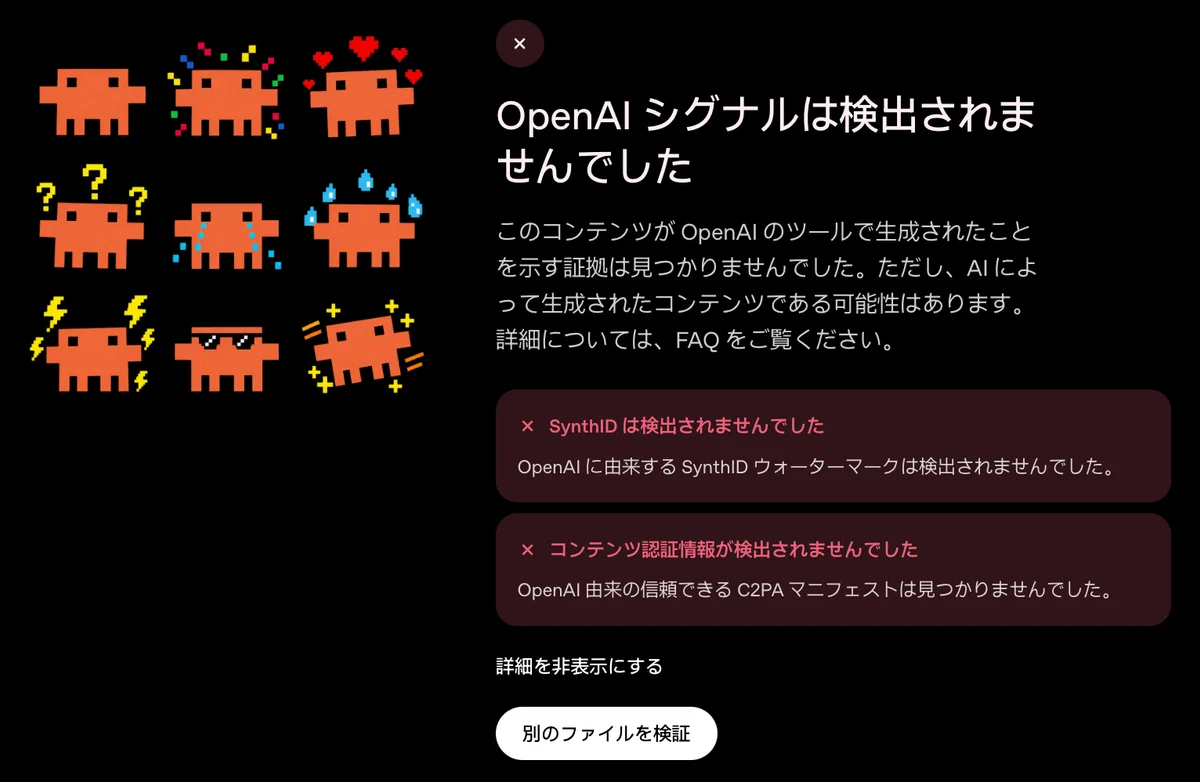
そのつもりで、書き直したプロンプトで作ったドット絵Clawdの9枚組を投げてみました。返ってきたのは「OpenAIシグナルは検出されませんでした」です。SynthIDもC2PAも両方とも見つからないという判定です。
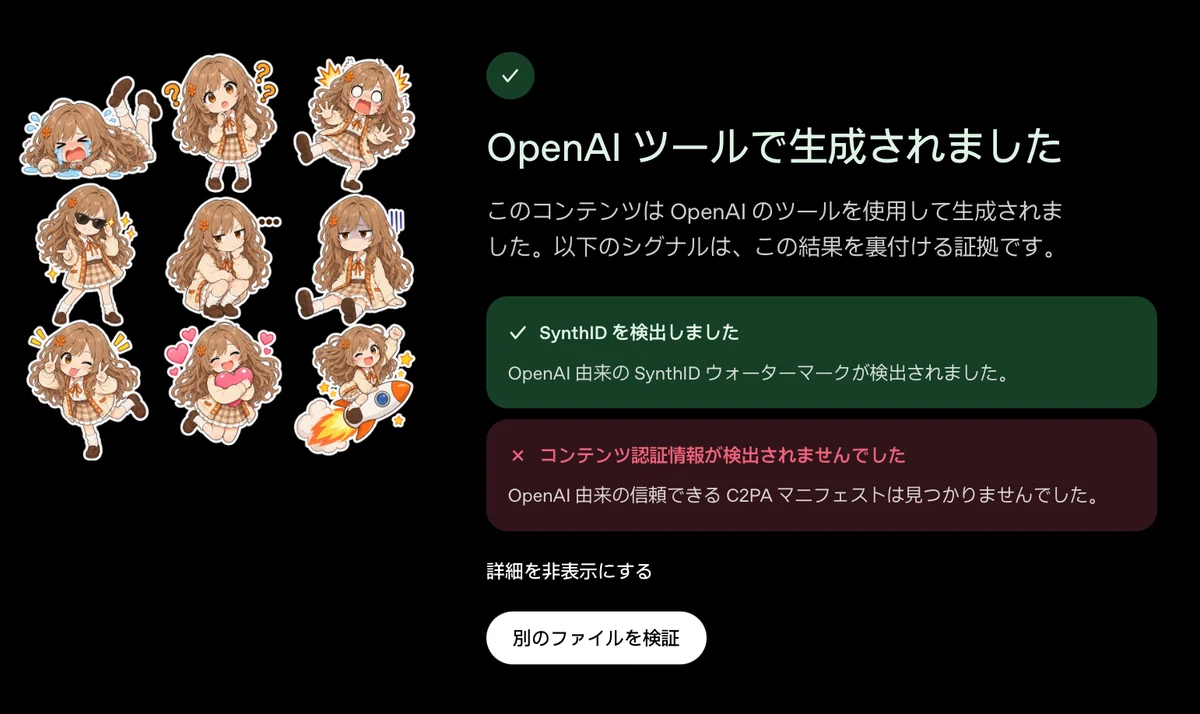
念のためアニメキャラのシートを投げると、こちらはSynthIDが検出されます。
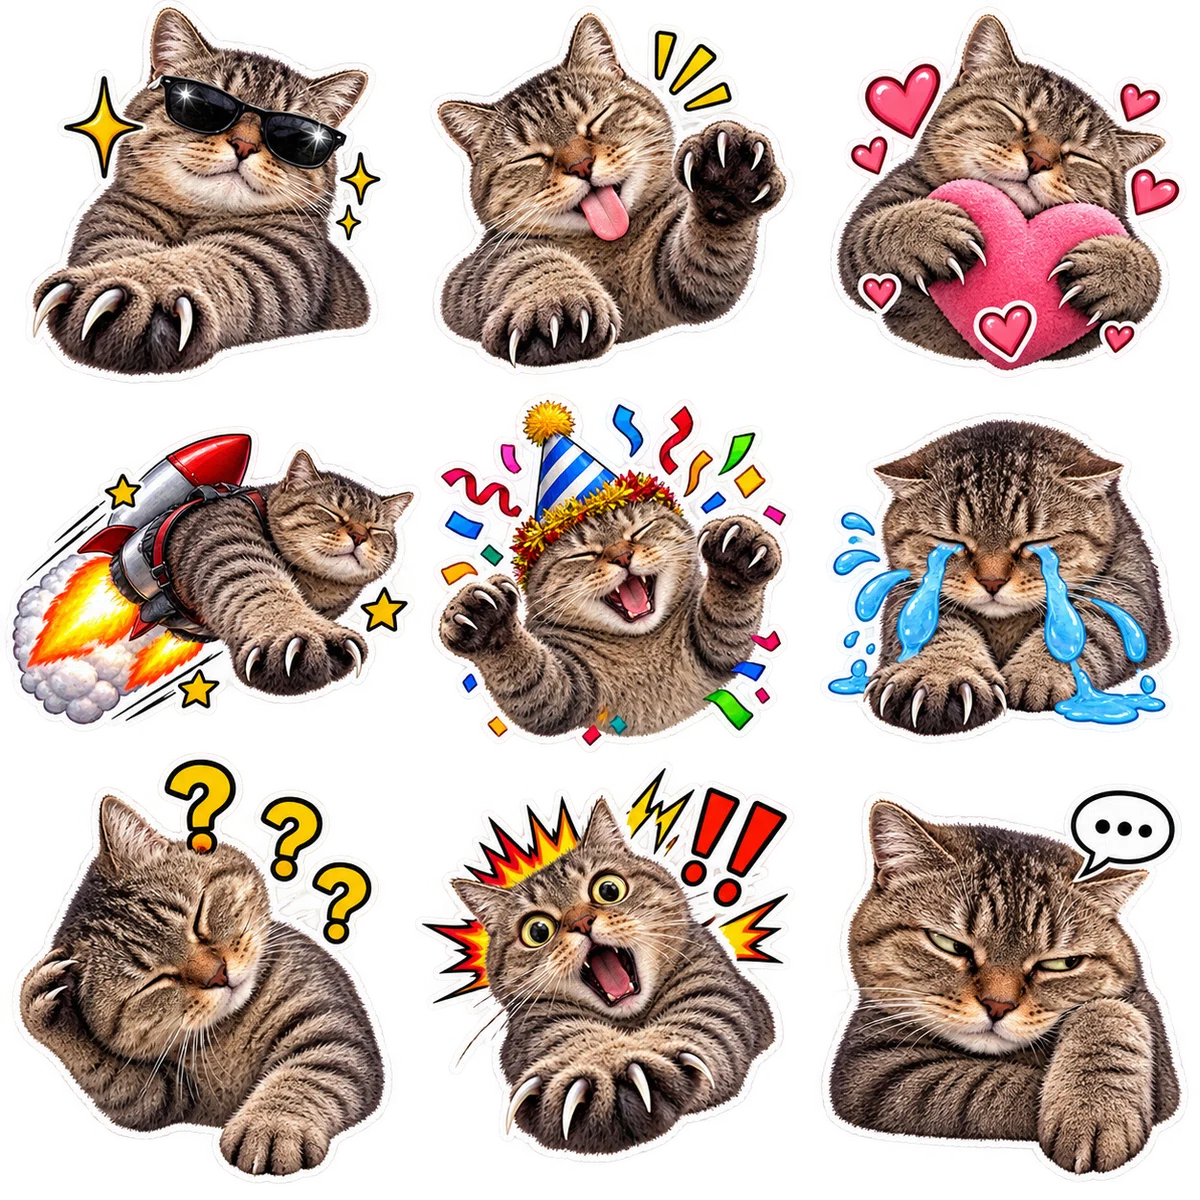
さらに、自分が撮影した猫の写真からステッカーを作って投げても、やはりSynthIDは検出されました。
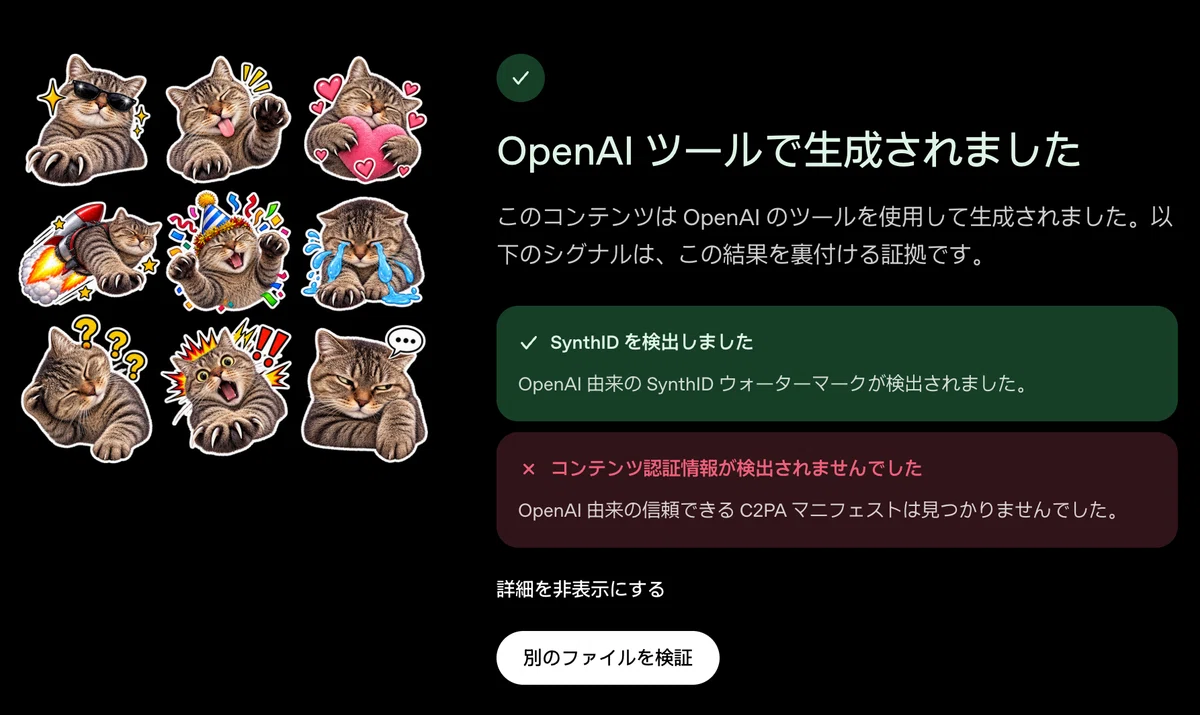
ドット絵のときだけ何も出ません。絵柄によって結果が変わっていることになります。
🔗Verify OpenAI-generated content | OpenAI
🔗Advancing content provenance | OpenAI
🔗OpenAI、Googleの「SynthID」を採用 「C2PA」と組み合わせAI生成画像の来歴証明を強化
🔗Photoshopでガビガビにしても検出される:OpenAIのSynthID統合と、画像の来歴証明という30年越しの宿題
4. PNGの中身を開けたら、透かしは入っていた
判定が出ないからといって、透かしが入っていないとは限りません。PNGファイルのチャンク構造を直接読んでみました(読んだのはClaudeです)。
すると caBX という21,824バイトのチャンクが見つかりました。C2PAのマニフェストを格納する箱です。中を展開すると、生成元は「OpenAI Media Service API」と記録されていました。使用モデルは gpt-image のバージョン2.0、素材の種別は「学習済みアルゴリズムによる生成物」です。実行された処理の一覧には c2pa.watermarked.unbound という項目まで入っていました。C2PAの用語で、soft binding を作らない形で透かしを適用した、という記録です。方式がSynthIDだと名指しされているわけではありませんが、OpenAIは対応画像にSynthIDを使うと公式に説明しているので、これがそれを指していると考えて大きくは外さないはずです。
画素のほうも調べました。一見すると単色に見える体の部分に、4,330通りの微妙に異なるオレンジが分布していました。各チャンネルの標準偏差は2前後です。目には平坦に見えても、バイト単位では細かなゆらぎが残っています。ただし、これだけを透かしの証拠にはできません。生成モデル自身の出力や色変換でも同じような微差は出ます。透かしがあることと矛盾しない、という程度に受け取ってください。
もうひとつ、気になる数字が出ました。完全に透明なピクセルが105万個あり、そのRGB値は例外なく純黒の(0, 0, 0)でクリアされていました。画面の67パーセントが完全な透明で、その下は真っ黒に塗り潰されている状態です。絵がしっかり乗っている不透明な部分は全体の25パーセントほどで、残りは輪郭まわりの半透明な縁になります。
5. 背景の色を変えただけで、検出された
そこで実験をしました。透明部分を別の色で塗り潰した版を4つ作ります。黒、中間グレー、薄いグレー、白の4種類です。塗り替えるのは透明だった領域だけで、絵が描かれている不透明なピクセルは1ビットも触っていません。作成後にプログラムで比較して、4枚すべての不透明部分が元画像と完全に一致していることを確認しています。
これを順に検証ツールへ通した結果がこちらです。
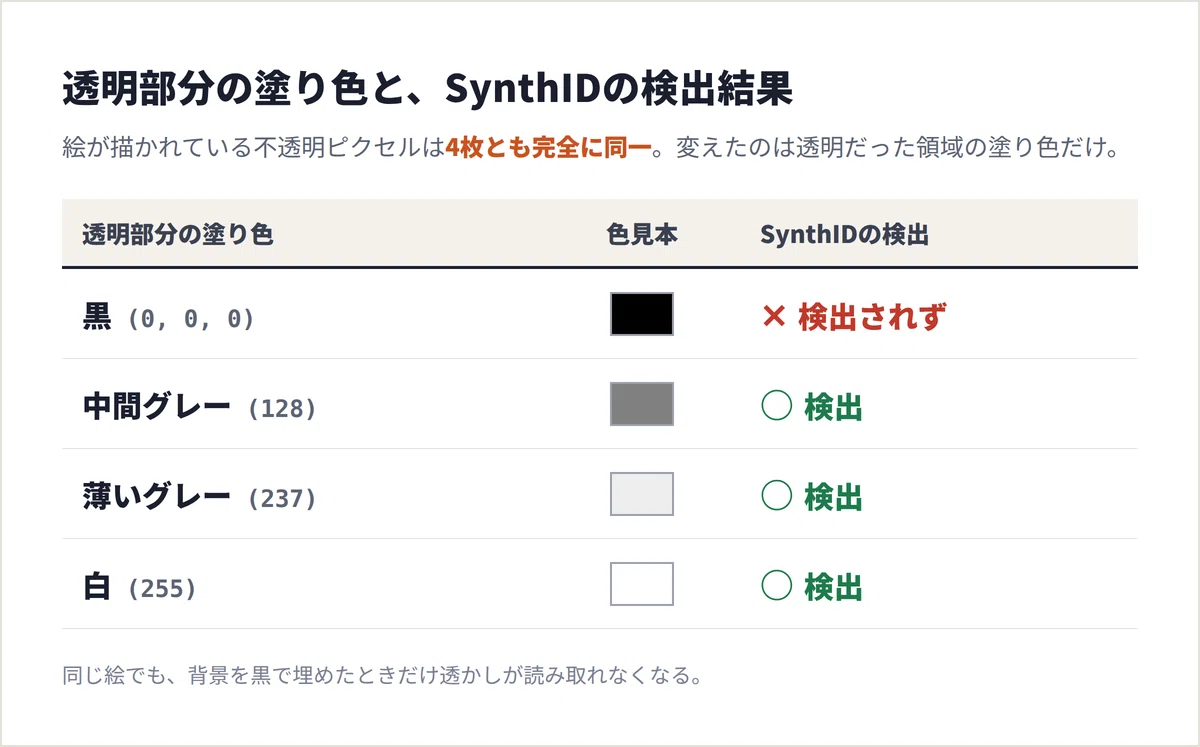
黒だけが落ちました。同じ絵で、背景の塗り色を変えただけで判定が反転しています。
そして元の透過PNGは、透明部分のRGBが純黒でした。アルファチャンネルを無視して画素だけを読めば、元ファイルは黒で塗った版とまったく同じ絵に見えます。検証ツールが透明度を捨てて画素を読んでいるとすれば、最初に判定が出なかった理由はこれで説明がつきます。
6. 猫は黒でも検出された
ここで終われば「透過PNGは来歴を運べない」という話になります。今回確認したChatGPTの透過PNGは、どれも透明部分のRGBが黒でクリアされていたからです。ただ、猫のシートのほうは透過PNGのまま検出されていました。
念のため、猫のシートも同じ手順で透明部分を黒く塗り潰して投げてみました。結果はSynthIDが検出されました。同じ黒塗りでも、猫は耐えてドット絵は落ちる。
2枚の中身を比べると差は歴然でした。
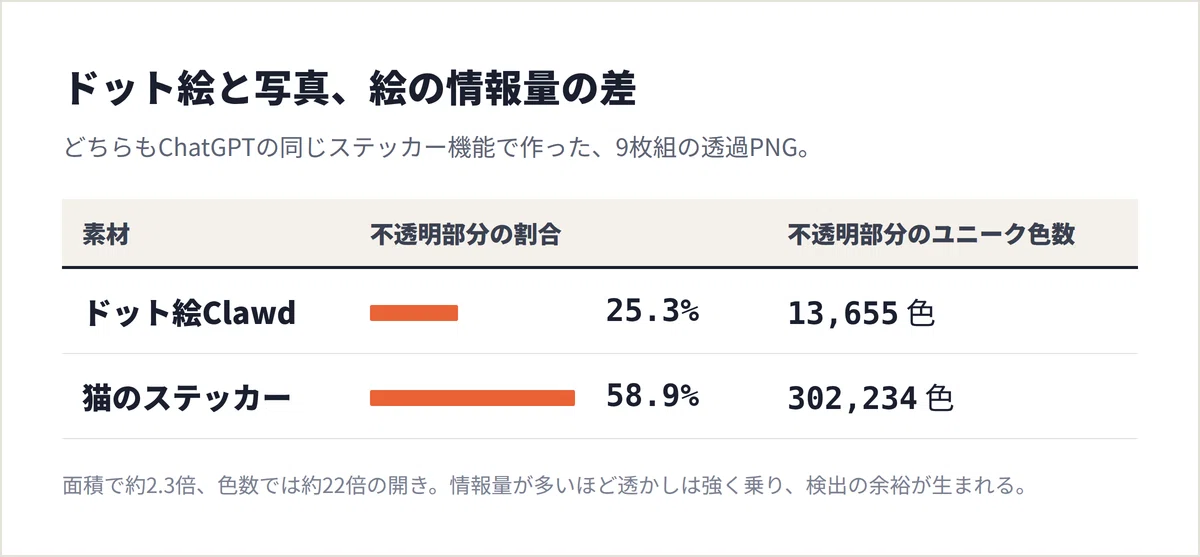
面積で2.3倍、色数では22倍の開きがあります。猫のほうは毛の質感で画素の分布が複雑で、絵が乗っている面積も広い。ドット絵のClawdは平坦で、絵が乗っている面積も画面の4分の1ほどしかありません。この差が検出の余裕を分けていて、Clawdはもともと閾値のすぐ上にいたところへ67パーセントの純黒が加わって下に落ちた、という見立てなら実験結果と噛み合います。ただし、色数や面積が検出のマージンをどう左右するのかは公開されていないので、ここは仮説です。
少なくとも今回の結果は、透過PNGが一律に読めなくなるのではなく、絵の中身によって検出の余裕が変わることを示しています。そして余裕が少なそうな絵柄というのは、ドット絵、ロゴ、アイコン、ピクトグラムといった、素材として二次利用されやすい種類の画像とかなり重なります。ここは1枚ずつしか試していないので、同じことが起きるかどうかはまだ分かりません。誰も透かしを剥がそうとしていないのに、普通に作業しただけで来歴が読めなくなる可能性があります。そこが少し厄介だと感じました。
7. C2PAのほうは、ツールが読めていないだけだった
もうひとつ、絵柄と無関係に起きていた現象があります。ここまで十数枚を検証ツールに通しましたが、C2PAは一度も検出されませんでした。猫でもアニメキャラでも、例外なく「信頼できるC2PAマニフェストは見つかりませんでした」と表示されます。
これは受け渡しの途中でメタデータが落ちているのだろうと最初は考えました。C2PAはファイルに付随する情報なので、保存や再エンコードで簡単に消えます。ところがファイルを往復させてハッシュ値を突き合わせたところ、バイト単位で無傷でした。C2PAの公式ライブラリ(c2pa-python)で署名を検証しても、署名もタイムスタンプもデータハッシュもすべて有効でした。
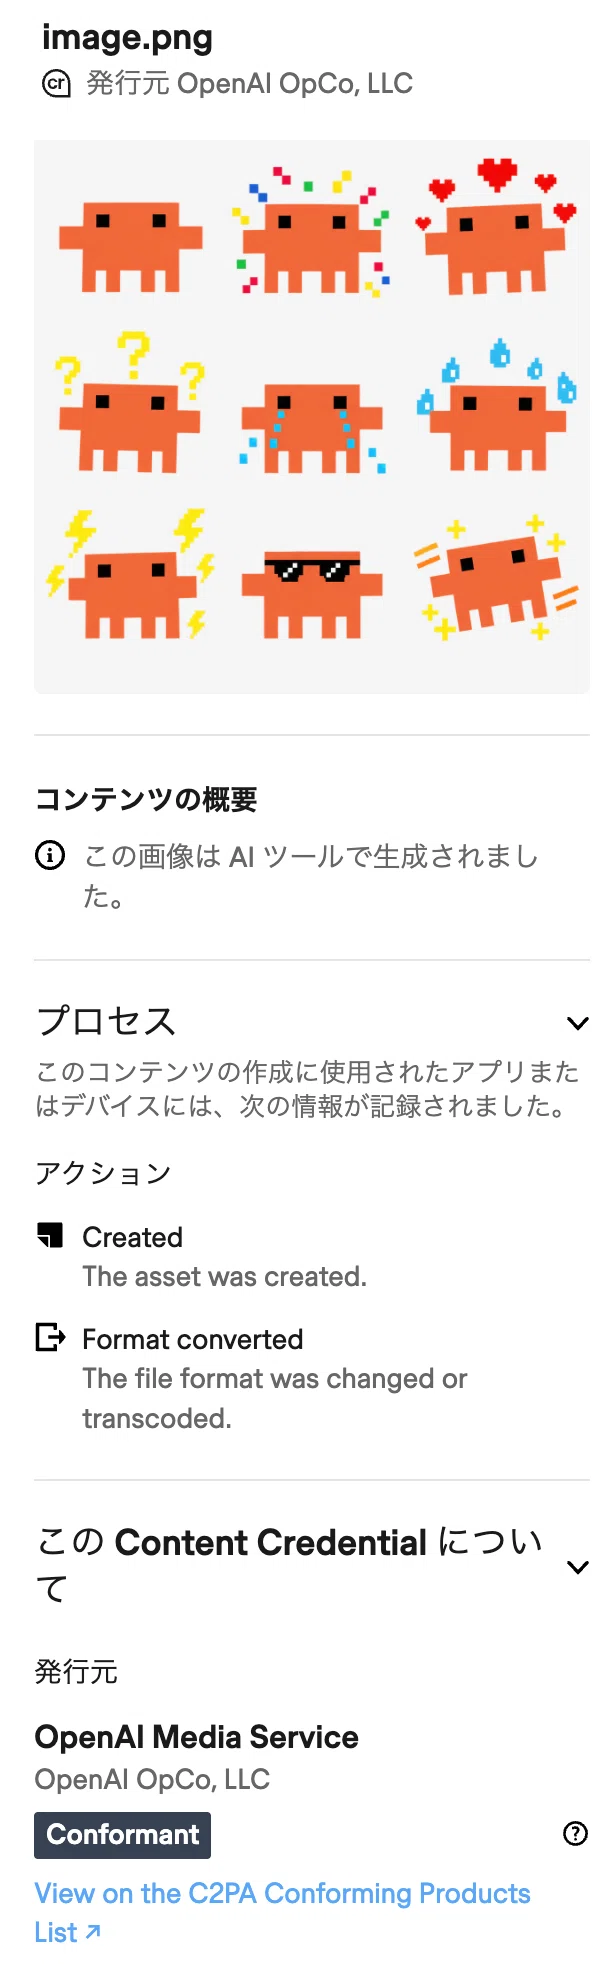
決め手はAdobeが公開している検証サイトでした。C2PAは業界団体が定める来歴記録の規格で、規格に適合した製品には認定が与えられます。同じファイルを投げると、発行元が「OpenAI Media Service / OpenAI OpCo, LLC」として正しく表示されました。適合製品リストに載っていることを示す「Conformant」のバッジまで出ています。第三者の検証器は読めて、OpenAI自身のツールだけが読めない。
OpenAIの公式ヘルプには、シグナルが検出されない条件が列挙されています。シグナルの提供前に作られた古いコンテンツである、非対応の製品・モデル・書き出し方法・ファイル形式から来ている、共有の過程でメタデータが削除された、圧縮や切り抜きで透かしが劣化した、といったものです。少なくともメタデータの消失と署名の破損では、今回の結果は説明できません。マニフェストは残っていて、署名も有効なままです。
今回のファイルと、検証した時点に限れば、これは偽陰性とみなせます。有効な署名付きのAI生成証明を持つ画像に対して、「OpenAIのツールで生成されたことを示す証拠は見つかりませんでした」と答えているからです。来歴の検証ツールで一番まずいのは、この向きの誤りです。なお原因がVerifyの実装のどこにあるのかまでは特定できていませんし、プレビュー版として公開されているものなので、今後修正される可能性も十分にあります。
🔗Provenance signals (Content Credentials, SynthID) in OpenAI-generated content | OpenAI Help Center
🔗Content Credentials Verify(Adobe)
まとめ
ステッカーを作って遊んでいただけのつもりが、思ったより広い話になりました。分かったことを整理します。
ひとつは、SynthIDの検出は絵柄によって余裕が変わるらしいということ。平坦で情報量の少ない絵は閾値の近くにいて、背景の塗り色ひとつで結果が反転しました。透かしが乗っていること自体は、白やグレーで埋めた版が検出されたことではっきりしています。ただし黒背景のままでは、OpenAIの検証器がそれを拾えませんでした。
もうひとつは、C2PAについてはOpenAIの検証ツール側に問題がありそうだということ。有効で適合した証明書を、第三者の検証器は読めるのに自社ツールが読めていません。
実用上の教訓としては、検証ツールが「検出されませんでした」と言ったからといって、AI生成ではないと考えるべきではない、という一点に尽きます。OpenAI自身もヘルプで同じことを書いています。シグナルが無いことは、AI生成でないことの証明にはなりません。今回のClawdは、まさにその実例として誕生してしまいました。
透かしそのものは、ちゃんと入っていたのです。
と、いうより、証明する向きが逆なのかもしれません。
AIが作ったことを証明しようとすると、今回のように、シグナルの弱い絵柄や不利な条件で取りこぼしが出ます。しかも取りこぼしたときの表示は「見つかりませんでした」なので、本当にAI生成でない場合と区別がつきません。だとすれば、AIが作ったことを示すのではなく、人間が作ったことを示すほうに重心を移すべきなのではないか、とも思います。
実はC2PAは、もともとそちら側の規格でもあります。カメラで撮った時点で撮影の記録に署名を付け、そのまま持ち回るという使い方です。ニコンはZ6IIIのセットアップメニューにC2PA/Content Credentialsを追加していて、この方向の実装はすでに動き出しています。
ただ、その層も今回ひとつ躓いています。有効な署名が付いたファイルを、検証する側が読めませんでした。証明する向きを変えたところで、読む側が読めなければ結果は同じです。
