ChatGPT Images 2.5|画像生成の何が変わったか、速さと編集の仕組み

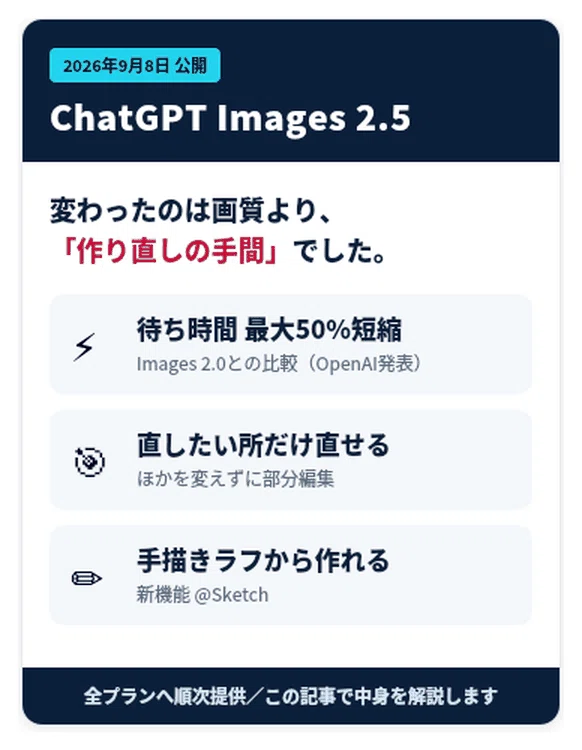
AIで画像を作ってみたものの、思った絵が出ない。「背景はこのままで、服だけ赤くして」と頼んだら、今度は人物まで別人になって返ってきた。一度でも生成AIで画像を作った方なら、この往復にうんざりした覚えがあるはずです。2026年9月8日、OpenAIが新しい画像モデル「ChatGPT Images 2.5」を公開しました。見出しだけを読むと「画質が上がった」という話に見えます。でも、発表の中身を読み込むと本題はそこではありませんでした。今回いちばん変わったのは、絵の美しさではなく、あなたが作り直しにかける時間のほうです。
ひとことで言うとChatGPT Images 2.5とは、生成を速くし、直したい所だけを直せるようにしたChatGPTの新しい画像モデルです。
僕はTrex(Tレックス)。AIブリッジエンジニアとして、AIを毎日実務で使い倒しています。自己紹介はこちら
🔍 そもそもChatGPT Images 2.5って、なに?
ChatGPT Images 2.5とは、ChatGPTの中で画像を作ったり直したりする部分を担う、新しい画像生成モデルのことです。2026年9月8日に公開され、それまでのChatGPT Images 2.0の後継にあたります。
ここで「モデル」という言葉に引っかかった方のために、たとえ話をひとつ。ChatGPTを車だとすると、モデルはエンジンです。ハンドルやシートの位置、つまり画面の見た目や操作の入り口は大きく変わらないまま、動力源だけが新しいものに載せ替わった。今回の更新はそういう性質のものです。だから僕たちが特別な設定をしなくても、いつもの入力欄に「こういう絵を作って」と書くだけで、新しいエンジンが動きます。
使える範囲も広く、ChatGPT、ChatGPT Work、Codexのユーザーが、デスクトップ、モバイル、Webの全プランで利用できるとOpenAIは案内しています。ただし反映のタイミングには差が出ることがあるので、まだ手元で見当たらない方は少し待ってから試してみてください。
名前の話も整理しておきます。ChatGPTの中では「ChatGPT Images 2.5」、開発者向けのAPIでは「GPT-Image-2.5」と呼ばれますが、どちらも同じ世代の顔違いです。ちなみにOpenAIによると、ChatGPT ImagesとAPIのGPT-Imageモデルを合わせて、毎週30億枚を超える画像が作られているそうです。画像生成はもう、一部の人の遊びではなくなっています。
⚙️ 何が変わったのか、中で起きていること
OpenAIが挙げた改善点は、大きく4つです。参照写真の被写体をより忠実に保てること、指定した箇所だけを正確に編集できること、複数回の編集を重ねても指示が保たれること、そして生成の待ち時間がImages 2.0と比べて最大50%短くなったこと。この4つは別々の話に見えて、実はひとつの流れの上に並んでいます。
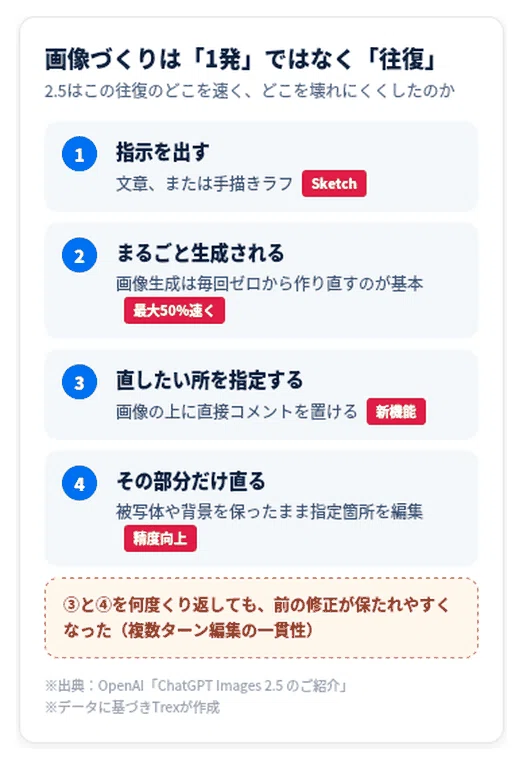
そもそも、なぜ「一部だけ直す」がこれほど難しかったのか。画像生成の基本は、指示を受け取るたびに絵をまるごと作り直すことにあります。人間の修正のように、完成した絵の上から部分的に筆を入れているわけではありません。だから「背景はそのままで服だけ赤に」と頼んでも、モデルは絵の全体を作り直してしまい、顔つきや小物まで一緒に変わってしまう。これが、作り直すたびに別物が出てくる正体です。
Images 2.5は、この「変えてはいけない部分を保つ力」が上がったモデルです。複雑な被写体や背景でも、ほかのディテールを変えずに指定箇所だけを編集しやすくなった、とOpenAIは説明しています。さらに、長い会話の中で編集を何度も重ねても、前の変更が維持されやすくなりました。1回直すたびに前の苦労が消える状態から、直した分がきちんと積み上がる状態に変わったわけです。
加えて、現実世界の情報を含む画像の内容がより正確になり、透明な背景を含む複雑なレイアウトにも対応できるようになりました。指定したビジュアルスタイルの再現性も向上しています。チラシやバナーのように、文字と図版の位置関係が意味を持つ画像を作る人にとっては、ここが効いてきます。
そして速度です。待ち時間が最大50%短縮という数字は、単に快適という話にとどまりません。画像づくりは、1枚で決まることのほうが珍しい作業です。たとえば1枚あたり30秒かかっていたものが15秒で返るなら、10回試す前提なら待ち時間は5分から2分半に縮みます。試行回数を増やせるということは、当たりを引く確率が上がるということでもあります。
💡 で、実務ではどう使うのか
モデルの性能と同時に、ChatGPTの操作面にも新しい機能が4つ加わりました。これが実務では本体より効いてきます。
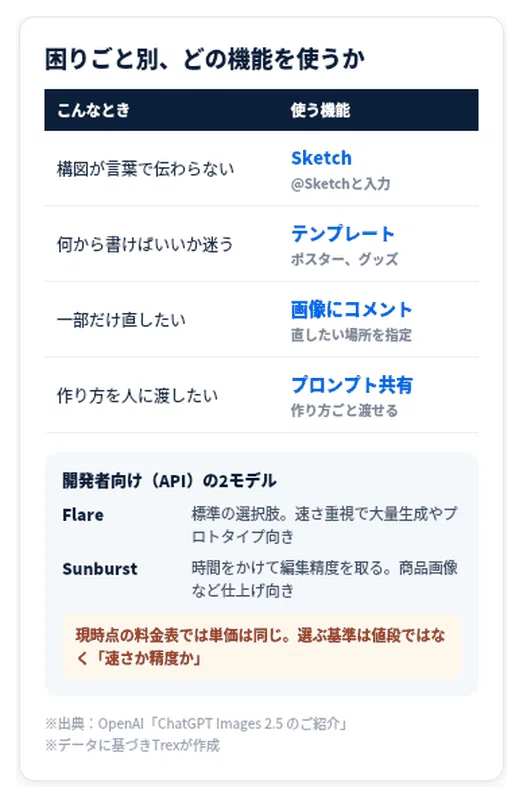
1つ目がSketchです。ChatGPTの入力欄に「@Sketch」と入力すると描画画面が開き、そこに手描きのラフを描いて、それを下敷きに画像を作らせることができます。棒人間と四角で「左に人物、右に見出し」と描くだけで十分です。構図を言葉だけで伝えようとすると座標の説明合戦になりますが、絵なら一発で伝わります。2つ目がテンプレート。ポスターやグッズといった定番の形式が用意されていて、そこに伝えたい文言やスタイルを足していく形で始められます。白紙からプロンプトをひねり出す必要がなくなる機能です。
3つ目が、画像に直接コメントを置いて編集する機能。直したい場所を指で示しながら「ここだけ」と言えるので、文章で位置を説明する手間が消えます。4つ目がプロンプト共有で、画像と一緒に作り方も渡せるようになりました。社内で「この見た目で揃えたい」というとき、レシピごと配れるのは地味に大きい変化です。
使い分けの筋道はシンプルです。構図そのものが違うならSketchに戻る。構図は合っていて一部だけ違うならコメント編集。作るものが定型ならテンプレートから始める。この3択を持っておくと、やり直しの回数が目に見えて減ります。
APIを使う方向けにも触れておくと、今回は2つのモデルが用意されました。GPT-Image-2.5 Flareはほとんどの用途で標準となる速いほう、GPT-Image-2.5 Sunburstは生成に時間をかけて編集の精度を取りにいくほうです。現時点で公開されている料金表では、この2つのトークン単価は同じとされています。つまり選ぶ基準は値段ではなく、速さを取るか精度を取るかになります。大量に作るならFlare、そのまま納品する商品画像ならSunburst、という判断でまず問題ありません。
もうひとつ、仕事で使うなら知っておきたいのが出どころの扱いです。OpenAIはC2PAという規格のメタデータと、目に見えない電子透かしを引き続き使い、自社ツールで作った画像を識別しやすくしていると説明しています。AIで作った画像であることは、隠せる前提では設計されていません。クライアントワークで使うなら、AI生成であることを前提に合意を取っておくのが安全です。
🙋 僕はこう使っている
僕は今回の更新以降、完璧な長文プロンプトを一発で当てにいく作り方をやめました。ラフな指示で1枚出し、気になる所にコメントして直す。この往復のほうが、結果的に早く狙いに着きます。1回で決めようとすると、外したときに何が悪かったのか分からず、また長文を書き直すことになるからです。判断の軸はいつも時間単価です。きれいな絵が出るかより、毎日回せるかで道具を選んでいます。ただし、文字の入ったチラシや価格の載ったバナーは、最後に必ず人の目で確認します。もっともらしく崩れるのがAIの得意技であることは、モデルが新しくなっても変わりません。
📝 まとめ
ChatGPT Images 2.5は、2026年9月8日に公開されたChatGPTの新しい画像モデルでした。参照写真の被写体を保てること、指定箇所だけを直せること、編集を重ねても崩れないこと、待ち時間が最大50%短くなったこと。そこにSketch、テンプレート、コメント編集、プロンプト共有という4つの入り口が加わりました。冒頭でお話しした「直したら別人になる」問題は、画像生成が毎回まるごと作り直す仕組みだったことから来ています。今回の更新は、その作り直しを減らす方向に踏み込んだものです。画質の進化ではなく、作業工程の進化。そう捉えると、明日から何を変えればいいかがはっきりします。まずは1枚出して、気になった所にコメントを置いてみてください。
🔗 その他のマガジン記事は以下をご確認ください!
https://note.com/trex_ai/m/m9ea42d92706b
