Wan2.2 S2V GGUF でリップシンクを試す【ComfyUIワークフロー】

音声+画像でリップシンク的な動画を生成できる Wan2.2 S2V の GGUF モデルが公開されたので、とりあえず試してみました。RTX 4060TI 16GB + 64GB RAM のマシンで動くことは確認しました。
参考にしたワークフローは下記にあります。
上記のワークフローは公式モデルを使っていて、かなりのVRAMを必要とします。以下のワークフローは GGUF 版のモデルなどを使って省メモリ化+高速化しています。
ワークフロー
ComfyUI は最新版(v0.3.52-14以上)である必要があります。
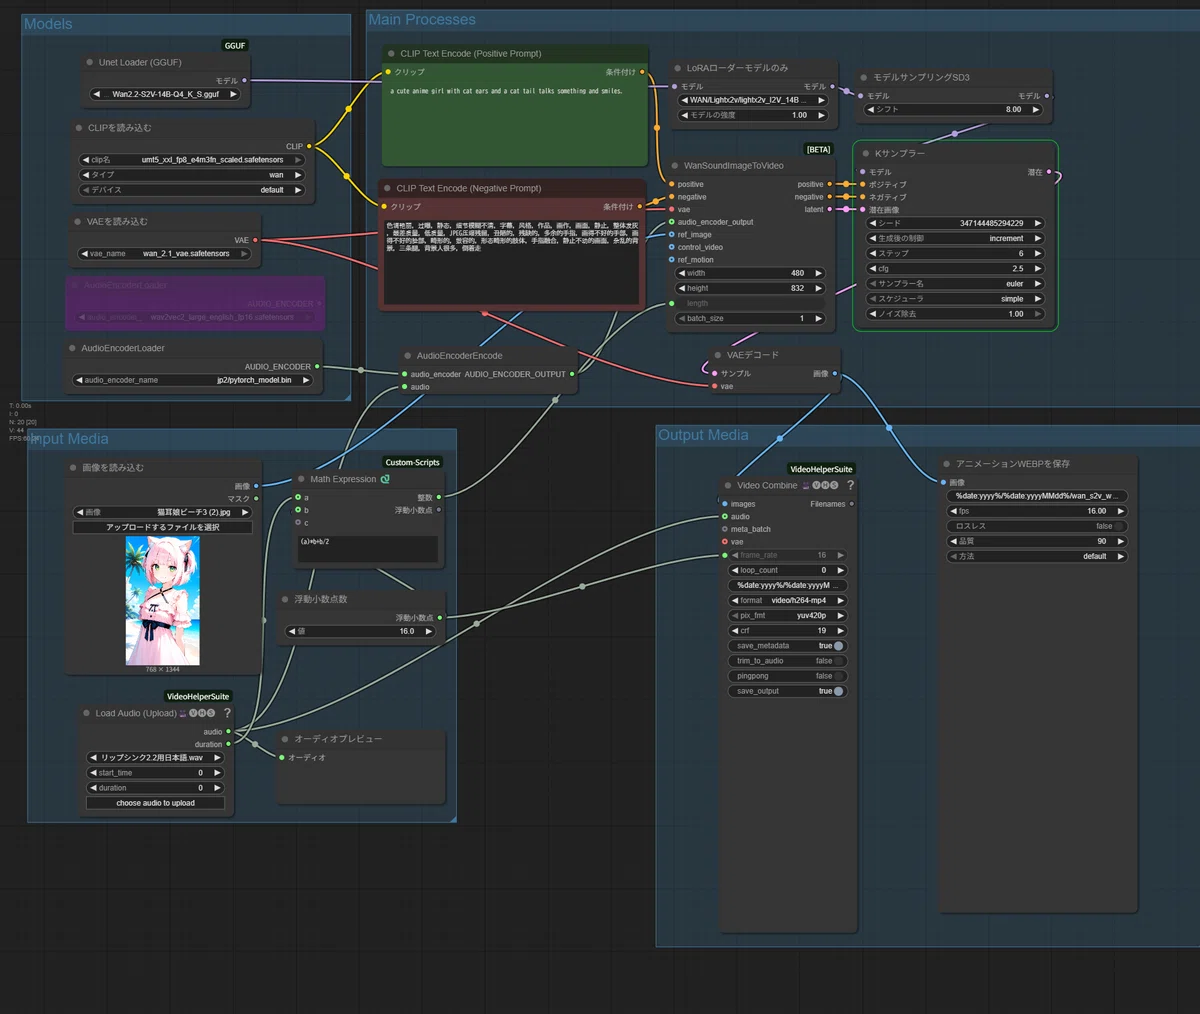
モデル
英語用です。
日本語については下記のモデル2種が使用できることは確認しました。
試していませんが fp8 モデルも公開されています。
テスト
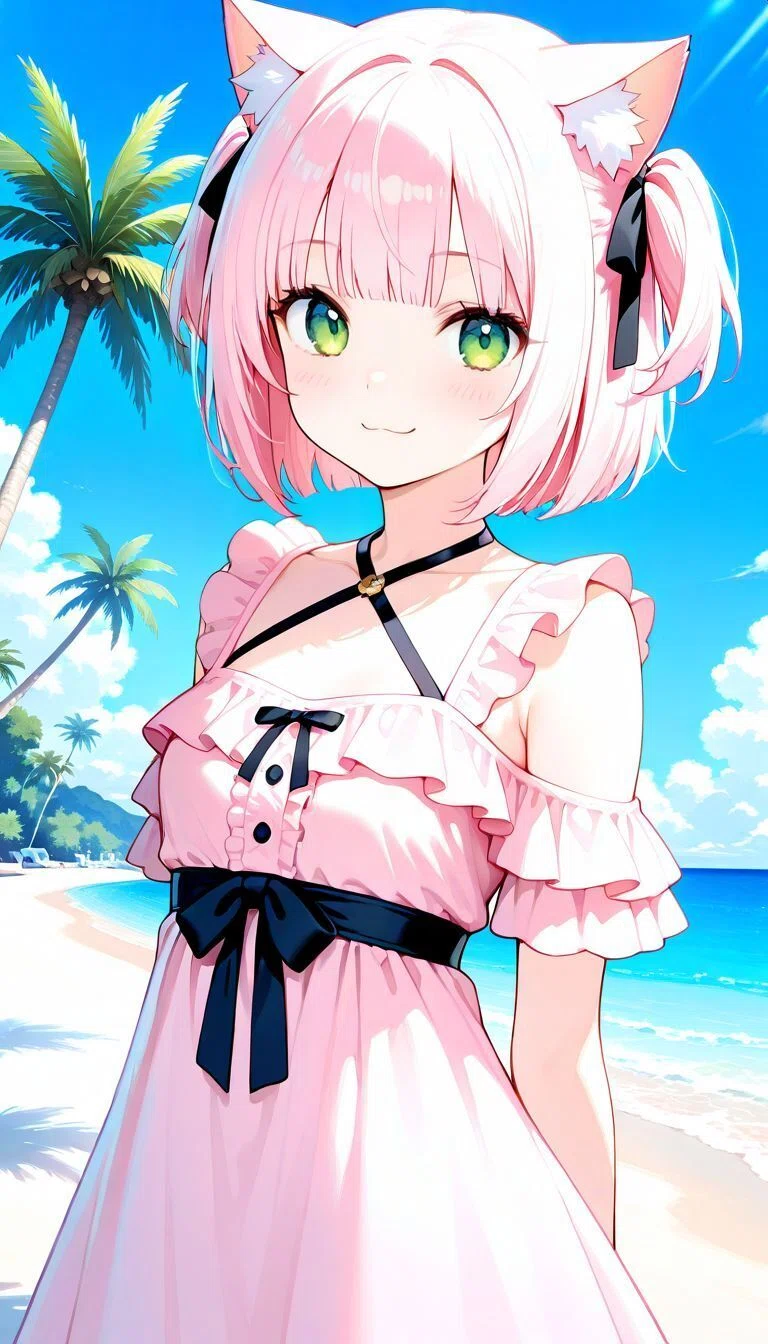
入力画像に下記画像を入れます。
音声データです。下記は英語版です。
下記は日本語版です。いずれも Gemini にしゃべらせたものです。
プロンプトは下記です。
a cute anime girl with cat ears and a cat tail talks something and she smiles.出力動画
日本語、英語のセリフの両方とも、英語の wav2vec を使っています。steps は 6 で試しました。4 だと少し粗くなります。CFG は 1 にしています。
RTX 4060TI 16GB + 64GB Memory のマシンで、5 秒の動画の出力に 370 秒ほどかかりました。参考までに、CFG = 2.5 にすると 5 秒の出力に 800 秒ほどかかりました。
2キャラ、英語、日本語で試しました。英語はそこそこですが、日本語は予想通りもう一つな感じです。
最初の2フレームほどが白飛びしやすいので、音声の冒頭に 16-18sec 程度の無音の区間を作っておいて、動画を生成した後でその部分のフレームを削除するとかしたほうがいいかもしれません。
また、生成は遅くなりますが、CFG = 2-3 程度、steps を 6-10 の範囲で変化させると動画の質が上がることがあります。VRAM やメモリに余裕があるなら GGUF モデルの Q8_0 や fp8 モデルを使用するのもよさそうです。
日本語の歌やセリフで試した結果については、下記の記事に書きました。
備考
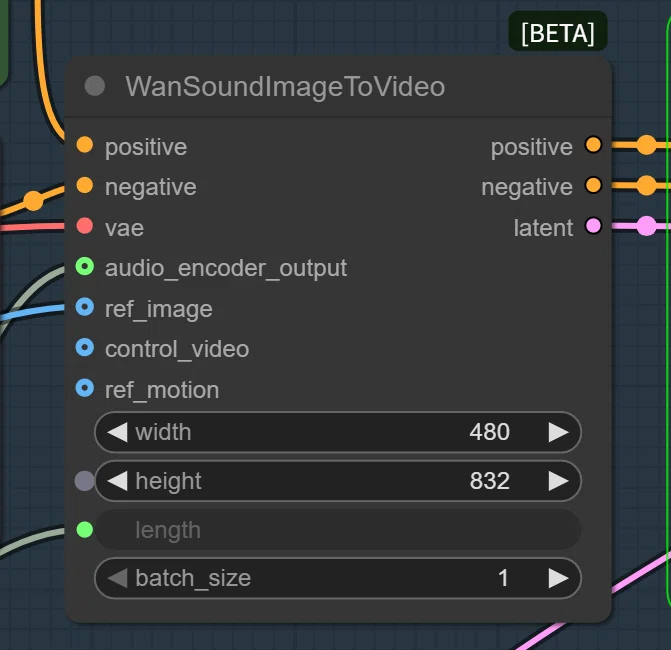
新しく追加された WanSoundImageToVideo ノードには ref_image とか control_video といった入力ピンがあるので、これらを駆使すればいろんなことができそうで夢は広がります。
サンプルで作ってみた画像は画質や口の動きにやや課題があるので、もう少しパラメータを詰めてみたいところです。
若干、音に遅れて口が動く傾向がある気がするので、音声を少しずらして動画を作ればよいかもしれません。
関連記事など
Reddit:Wan2.2 Sound-2-Vid (S2V) Workflow, Downloads, Guide; https://www.reddit.com/r/comfyui/comments/1n1gikw/wan22_sound2vid_s2v_workflow_downloads_guide/
