Wan2.2 S2V で長尺リップシンク動画を生成してみる【ComfyUI ワークフロー】

Wan2.2 S2V の ComfyUI の公式ワークフロー(テンプレート)が長尺動画を生成できるように最初から設計されていたので試してみました。
ComfyUI を最新版(v0.3.55-7以上)にすると、テンプレートの「ビデオ」の中から S2V のテンプレートが選べます。
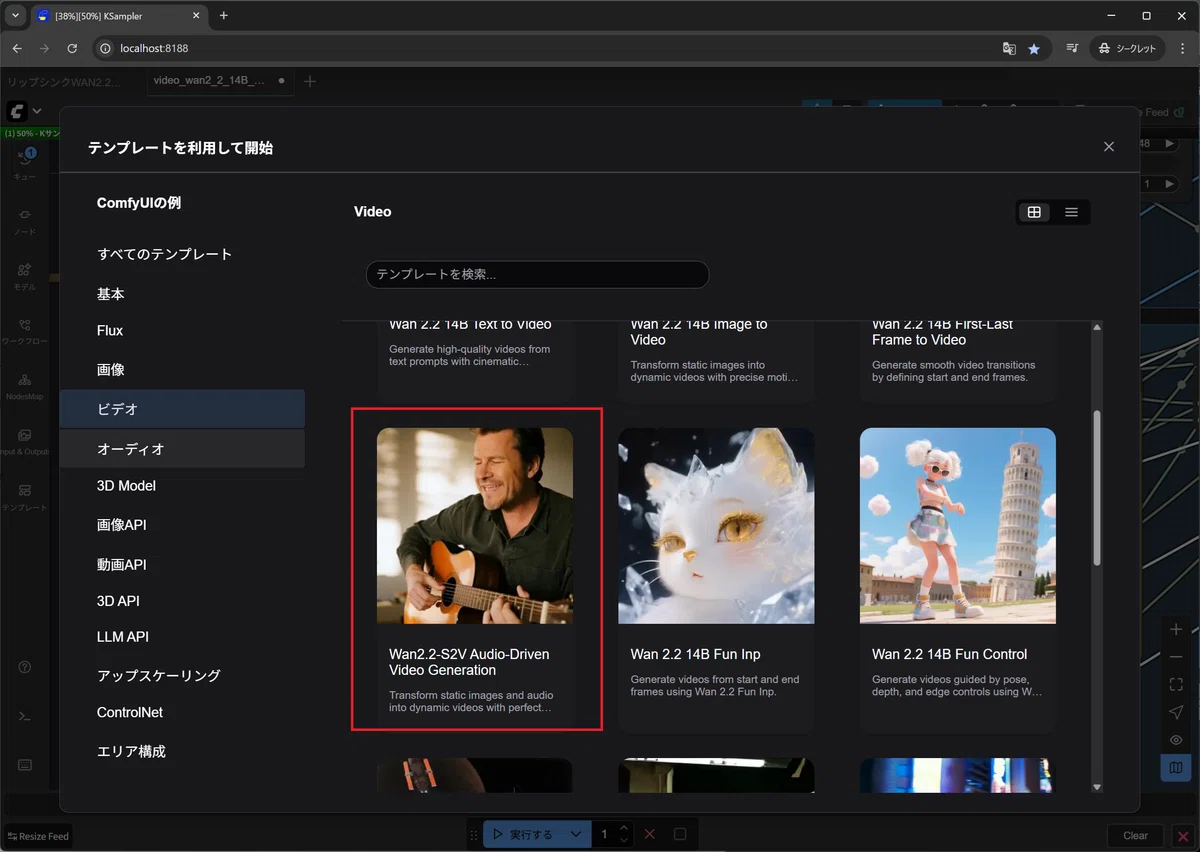
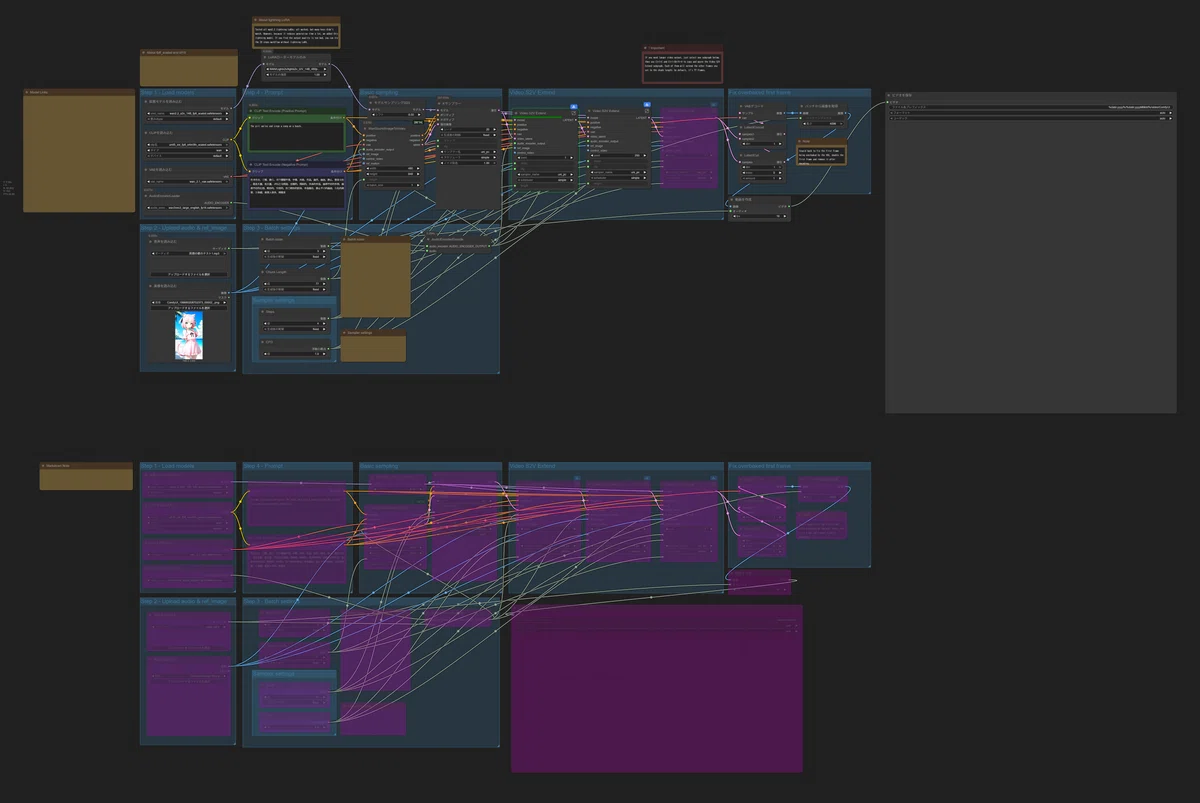
なお 2025/8/30 現在の公式ワークフロは複雑な上に、いろいろと問題がありそうなので、時間がたつと上記と違うワークフローに差し替えられる可能性はあります。
日本語音声への対応
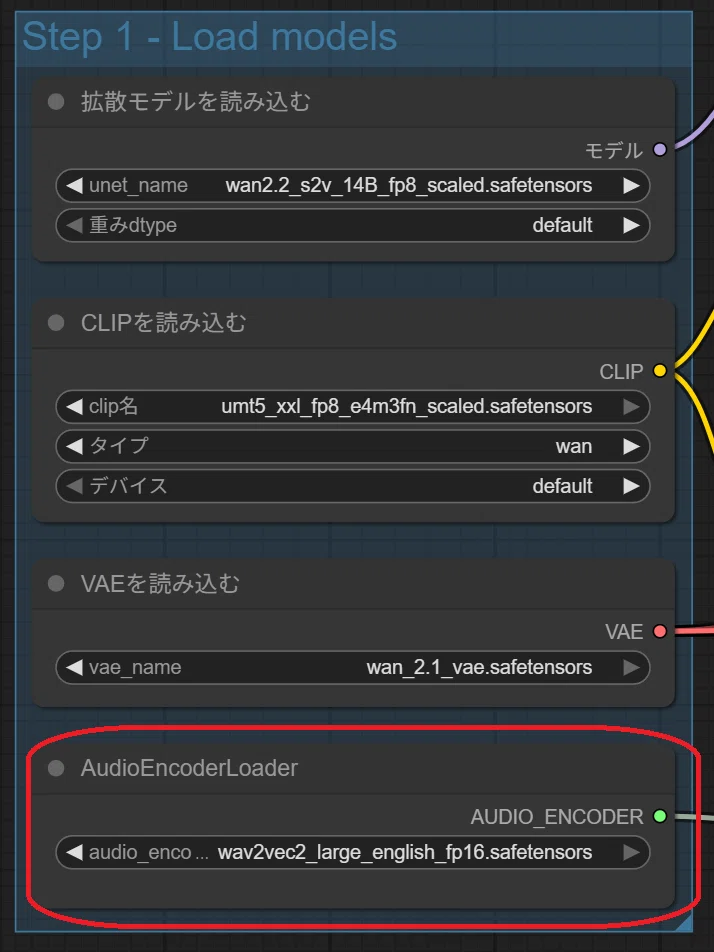
デフォルトのワークフローは音声を英語として認識するモデルが使われているため、日本語でしゃべっている音声を入れるとリップシンクがうまくいかない可能性があります。
日本語のモデルはいろいろとありますが、得手不得手があるようなので、音声の内容に応じていくつか試してみてください。
wav2vec2 のモデルは、ワークフローの step1 グループの一番下のノードでで変更できます。
出力画像の長さ(尺)の調整
Video S2V Extend とかかれたグループにあるサブグラフひとつ で約 5 秒 ( 77 frame) の尺が追加されます(Basic Sampling の部分だけで約 5 秒の動画が生成されます)。
デフォルトでは2つのサブグラフが有効になっているので、このまま実行すると15秒の尺の動画が生成されます。
今回は 17 秒の音声データを入れたので、サブグラフを3つとも有効にしてみました。
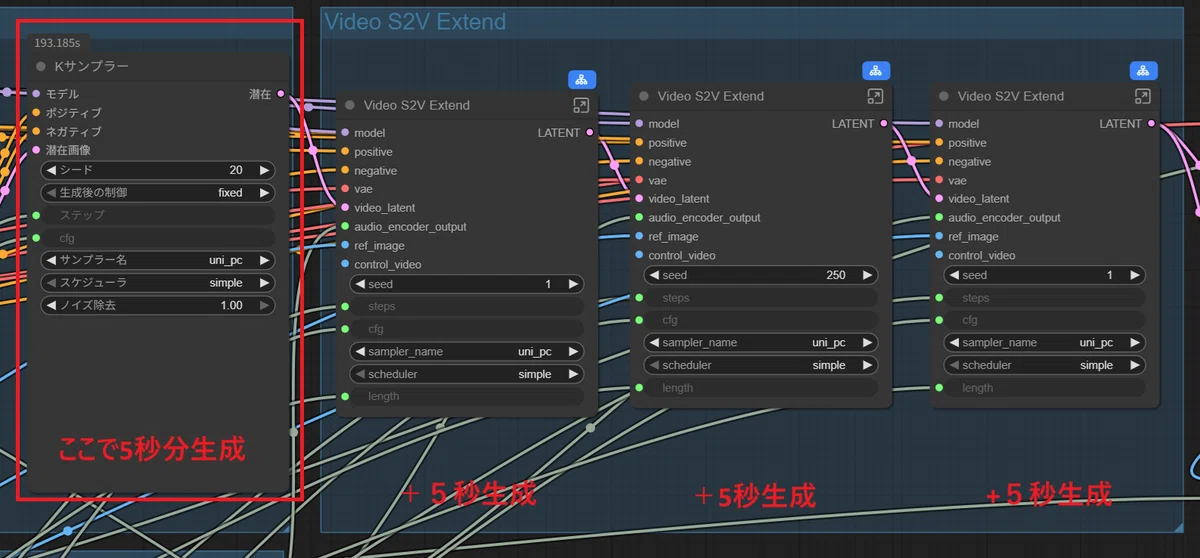
音声データより全体の尺が長くなっても、無音のまま動画が生成されます。たとえば15秒の音声データで20秒の動画を作ると、末尾の5秒は無音のまま動画が生成されます(生成される動画の内容はプロンプトに依存します)。
4Step LoRA モデルの変更
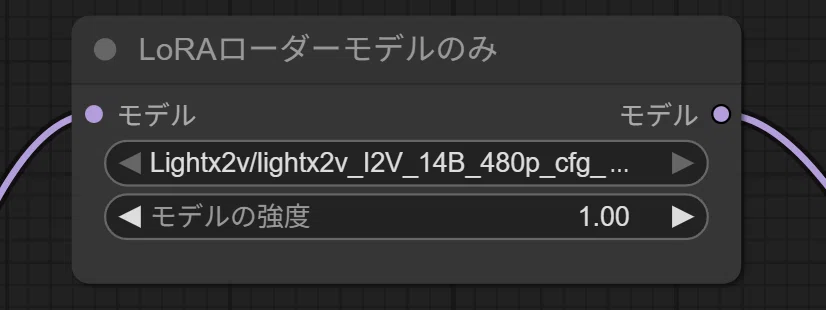
デフォルトで指定されている T2V の 4steps lora を使うと、画像がかすれたりブレたりすることがあります。そのため、今回のテストでは LoRA のモデルを I2V のものに差し替えました。
ワークフローの内番上にある「LoRAローダーモデルのみ」と書かれたノードのモデルを上記のものに差し替えます。
テスト
細かい調整はとりあえず後回しにして、パラメータはすべてデフォルトのままで動画を出力させてみました。
RTX 4060TI 16GB + 32GB RAM の PC で 20 秒弱の動画の出力に約 25 分かかりました。参考までに、A100 80GB VRAM のマシンでは 300 秒前後で生成できました。
音声は、英語の歌と日本語の歌の両方を入れてみました。下の動画では、最初の20秒は英語で歌い、後の20秒は日本語で歌を歌います。
結論
出力した動画について、時間経過とともに少しずつ絵柄が変わっている感じはありますが、大きく崩れることなく20秒まで生成できてる気はします。
リップシンクについては、英語の歌はそこそこかなと思います。日本語のほうは予想通りもう一歩という感じなので、のちほど日本語の wav2vec2 でも試してみます。
画質については課題がありそうで、フレーム数を増やしたり、解像度を上げるなどの後処理をする必要はありそうです。
なお、理論上はサブグラフをコピーして後ろに追加していけば、いくらでも長い動画を生成できるはずです。
ただ、このワークフローではプロンプトが動画全体でひとつだけしか与えることができないため、どこのサブグラフでどのような動作をさせるかという細かい指定ができません。少し改造すればできるようになりそうなので、これについても後日試してみたいと思います。
