W&B Weaveの始め方/代表的機能一覧

2025年、Vibe Codingの加速やAI Agent開発を抽象化するライブラリの登場により、多くのAI Agentが生まれました。しかし、その一方で多くのAI Agentが品質が十分ではなく、継続的に本番活用されるにまで至っていないという事実も明らかになってきました(1, 2, 3)。品質担保のための開発体制構築と、その継続的運用の重要性が認識され始めており、「Eval-Centric」「Eval-Driven」という言葉も出てきています。W&Bは2024年から「AI is easy to demo, hard to productionize」という課題に向き合い、LLM ObservabilityツールであるW&B Weaveの製品開発と提供を進めてきました。
今では、世界中の多くのエンタープライズ企業に導入されています。
W&B Weaveが必要になる背景やデモ動画については、以下をご確認ください。
W&B Weaveが必要になる背景についてはブログもありますので、ご確認ください。
Weaveの始め方
W&Bの始め方については、以下のページにガイドが載っています。1)アカウントの作成方法, 2)デモ動画, 3)サンプルコードなどを確認することができます!まずは、こちらからご確認ください!
個人の開発に向け、ご関心を持たれた方は、https://wandb.ai/site/ja/ からサインアップ->アカウントを作成し、早速はじめてください!
エンタープライズでのご利用にご関心がある方は、contact-jp@wandb.comまでご連絡ください。
次の章以降では、Weaveの代表的な機能を解説します。
Trace(トレーシング)
豊富な可視化機能を備えたトレーシング
Weaveは、LLMアプリケーションのすべての呼び出しを自動的に追跡します。クライアント・サーバー形式を採用しているため、手元のローカル環境で開発・実行したトレースも即座にW&BサーバーのUIで可視化され、チームメンバーとリアルタイムに共有できます。エージェントシステム向けに設計されたトレースツリーにより、複雑な処理フローも直感的に把握できます。
プロジェクトを初期化し、@weave.op() デコレータで装飾した関数を呼び出すだけで、入出力が自動的にTrace として保存されます。
import weave
# プロジェクトを初期化
weave.init("my_project")
@weave.op()
def my_function(text: str) -> str:
    return f"Processed: {text}"
result = my_function("Hello, Weave!")
LLM アプリケーションでは複数のAPI 呼び出しや補助関数がネストするため、Trace Tree 表示を利用すると全体のフローを俯瞰できます。
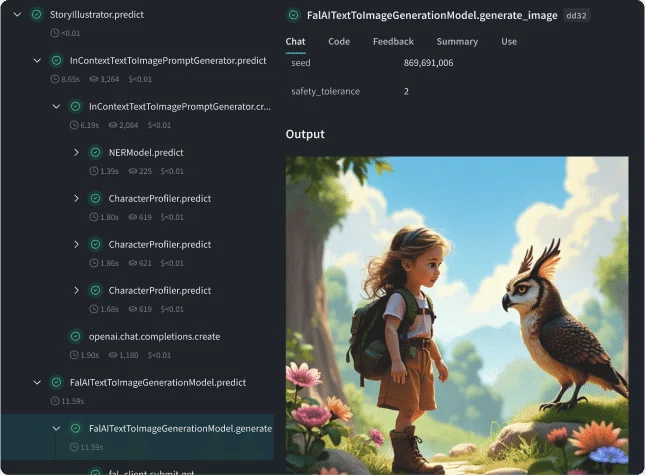
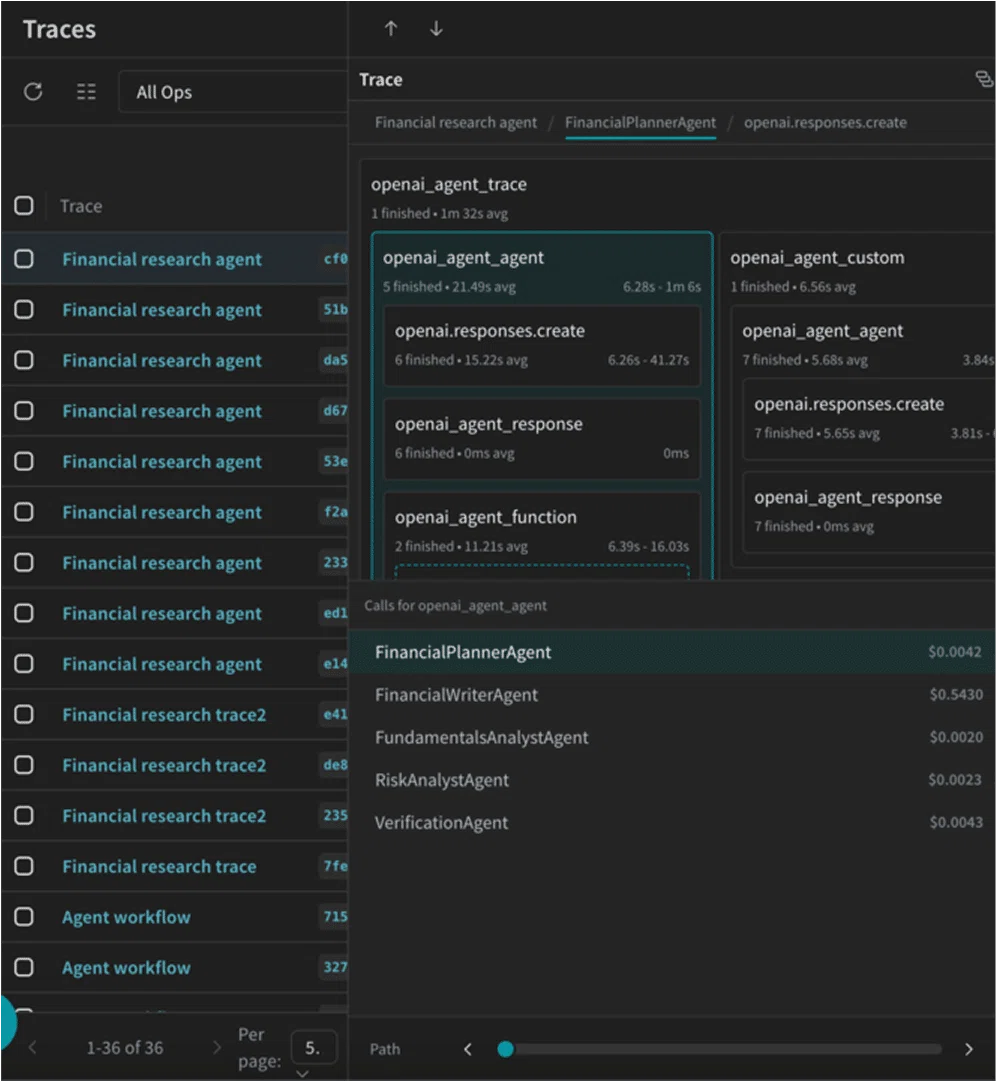
また、Agentのような複雑なフローの可視化機能もあります。以下のような表示のほか、DAGのようなフロー表示、時間軸でどのステップに時間がかかったかを示す可視化機能もあります。
Agentフレームワーク・LLMとの豊富なインテグレーション
LangChain、LlamaIndex、Autogen、Dspyなど、主要なLLM・Agentフレームワークとのインテグレーションも提供しています。インテグレーションが豊富にある一方、特定のフレームワークに偏っているわけではないので、フレームワークに縛られることなく、既存のコードベースに導入できます。また、OpenAI、Anthropic、Google、Mistral、Cohereなど主要なLLMプロバイダーとの統合が提供されており、実行するだけで自動的にトレースが有効になります。さらに、OpenTelemetry互換のトレースデータも取り込み可能で、OTLP形式のデータをWeaveプロジェクトに直接送信できます。
詳細は次のリンクをご確認ください: Integrations overview
フィードバック/コスト/レイテンシー/コードの記録
LLMの利用コストや各ステップでのレイテンシーを追跡し、品質と効率を可視化。また、LLM Observabilityツールでは珍しく、コードもキャプチャします。
PIIリダクション
トレースに含まれる個人情報(氏名、電話番号、メールアドレス、クレジットカード番号など)を自動的に検出・匿名化してからWeaveサーバーに送信できます。Microsoft Presidioを統合しており、`weave.init("my-project", settings={"redact_pii": True})`で有効化できます。また、上記統合に頼らず、APIキーやトークンなどのキーを手動で登録してリダクション対象にすることも可能です。
詳細は次のリンクをご確認ください: Redact PII from traces
マルチモーダル対応
Weave では、画像、音声、動画、ドキュメント、PDF、HTML などのマルチモーダルデータを「コンテンツ」として扱い、トレース内に埋め込み表示できます。動画対応は2026年1月現在Weaveだけです。Woven by Toyotaでは、Weave動画トレース機能を用いた社内エージェントを開発しています。
幅広いデプロイメント方式
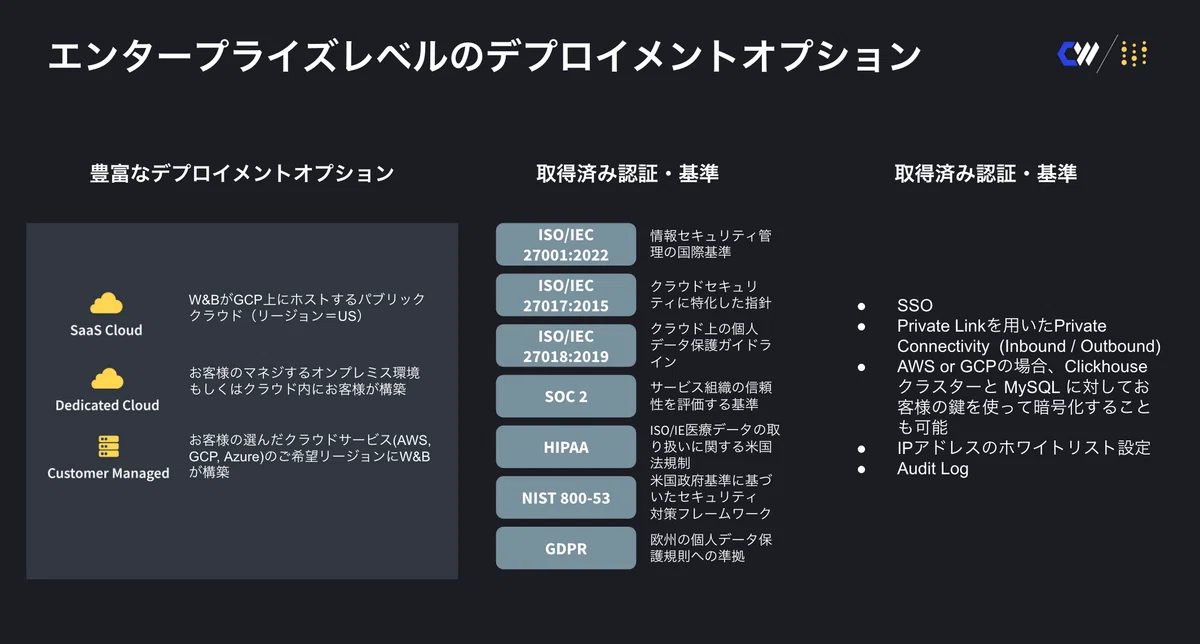
機能ではありませんが、W&B Weaveのサーバーの幅広いデプロイ方式を提供していることも、一つの特徴です。W&B Weaveは以下のデプロイオプションを提供しています。
Multi-tenant SaaS: すぐに利用開始できるクラウドホスティング版
Dedicated Cloud: 専用のクラウド環境 ◀️ 要チェック!
ご契約いただいたお客様専用のインスタンスをたて、よりセキュアな環境をW&Bがホスト・マネージした形でご提供します。GCP・AWS・Azureのクラウドベンダー、リージョンも選んでいただけます。東京リージョンもあります!専用クラウドの提供があるのは、LLM Observabilityツールで2026年1月現在Weaveだけです。多くのエンタープライズ企業様がこのオプションをご利用されています。Self-managed: オンプレミス環境または、お客様がお持ちのVPCでの運用
Asset Management(アセット管理)
Weaveでは、AI開発に必要なアセットを一元管理できます。
Prompt: プロンプトのバージョン管理
Dataset: 評価用データセットの管理
Scorer: スコアラーの管理
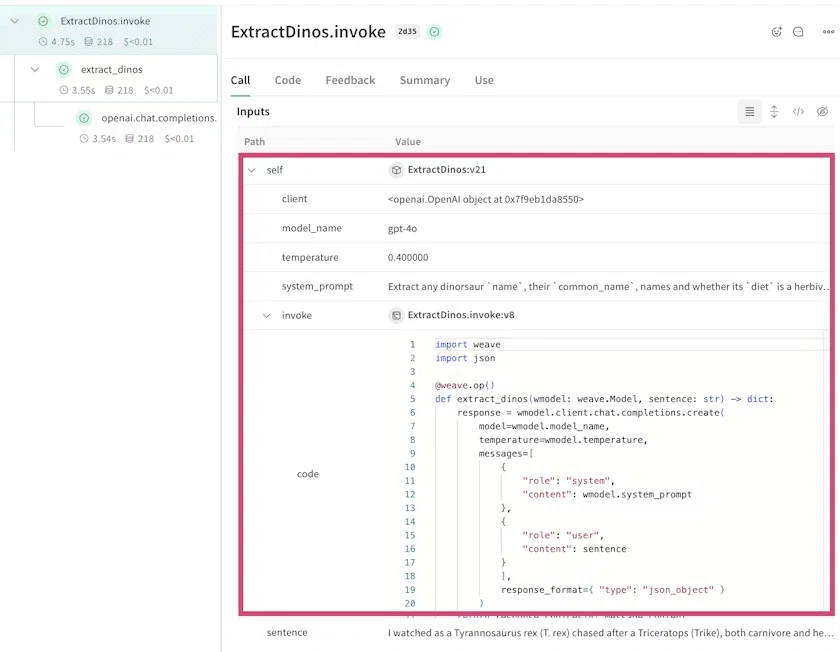
Model: 生成AIアプリケーションのバージョン管理 ◀️ 要チェック!
従来の機械学習では、「モデル」とは学習済みの重みとアルゴリズムの組み合わせを指していました。しかしLLMアプリケーションでは、API経由で外部モデルを呼び出し、システムプロンプトや外部ツールと組み合わせて「モデル」として機能させるケースが一般的です。Weave Modelは、こうした新しいパラダイムに対応したバージョン管理の仕組みです。`weave.Model`クラスを継承し、`predict`または`invoke`メソッドを定義するだけで、モデル名・temperature・プロンプトなどのパラメータとコードの変更が自動的にバージョン管理されます。Weave Modelは、2026年1月現在LLM observabilityツールでWeaveだけが提供しています。ツールやプロンプトの組み合わせが多数存在するAI agentの登場で、注目を集める機能となっています。
詳細は次のリンクをご確認ください: Tutorial: App versioning
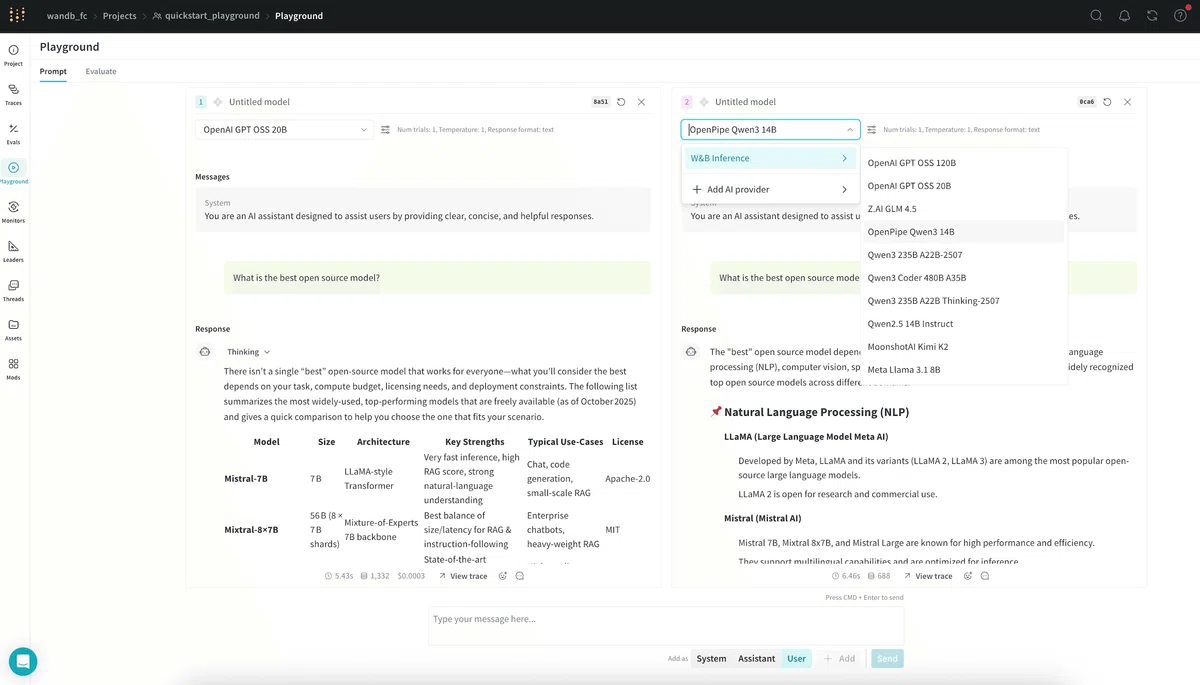
Playground(プレイグラウンド)
Weave プレイグラウンドはプロンプト改善の試行錯誤を素早く回すためのインタラクティブなUI です。モデルや設定を切り替えながら、同じ会話コンテクストに対してプロンプトやパラメータを調整し、その場でインタラクティブに応答を比較することができます。編集・再試行・削除といったメッセージ操作はチャット内で直接行え、ユーザーとシステムいずれのロールとしても新規メッセージを追加できます。OpenAI、Anthropic、Google、Groq、Amazon Bedrock、Azure、X.AI、Deepseekなど主要プロバイダーに対応しているほか、Open Weightのモデルの提供も行っています。OpenAI互換のカスタムエンドポイント(ローカルモデル含む)も追加可能です。さらにCompare モードを使うと、二つのチャットを横に並べ、モデルや設定の違いを視覚的に対比できます。
また、一つのチャットだけの応答確認ではなく、Weave のEvaluation Playgroundという、コードを書かずにモデルの性能を複数のシナリオで比較・評価できる対話型プレイグラウンドも提供しています。カスタムデータセットとLLM ジャッジ(スコアラー)を用いて、システムプロンプトやモデル、採点基準をUI 上でテストしながら作り込んでいくことができます。
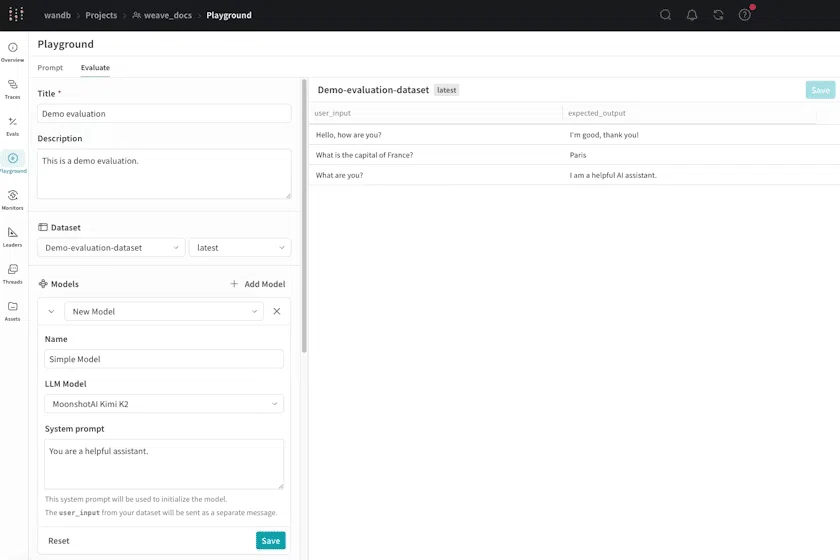
詳しくは次のリンクをご確認ください:
- Use Playground to experiment with prompts
- Compare model performance using the Evaluation Playground
Evaluation: Offline Evaluation(オフライン評価)
Weave のEvaluation は、データセットとスコアリング関数を登録し、モデルを比較する枠組みを提供します。関数ベースのシンプルなスコアラーから、クラス継承による高度なスコアラーまで、用途に応じて柔軟に実装できます。評価結果はUI のEvals タブで可視化され、複数モデルやバージョン間の比較も容易です。WeaveのEvalは、複数のスコアラーの結果を横並びで一気に確認することができる点、や評価体系とAIプリケーションのバージョンが自動的にどちらもトラックされる仕組みが、本格的に品質向上に向けて複数指標を見ながら、何度も試行錯誤するエンジニアに支持されおり、本格的に評価するならWeaveが便利いうユーザーの声をいただいています。
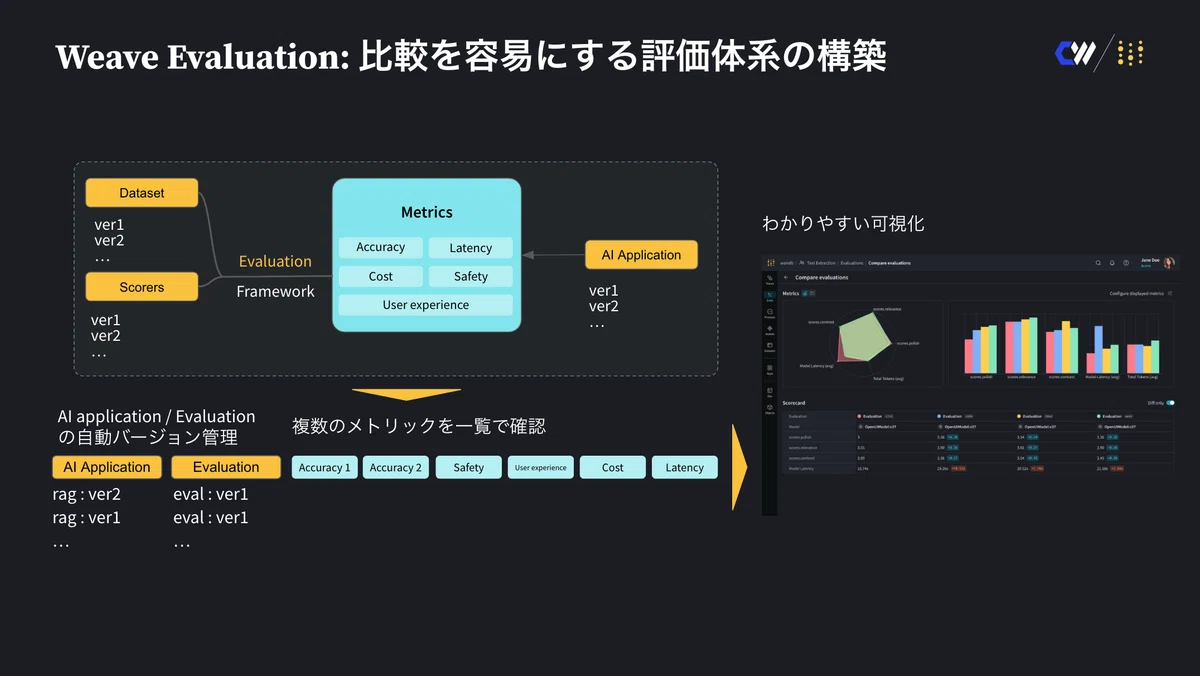
以下のように、WeaveのEvaluationクラスを用いて実装されます。
from weave import Evaluation
@weave.op()
def exact_match(expected: str, model_output: dict) -> dict:
    return {"match": expected == model_output.get("prediction")}

eval_job = Evaluation(
        dataset=dataset,
        scorers=[exact_match],
    )

summary = await eval_job.evaluate(model)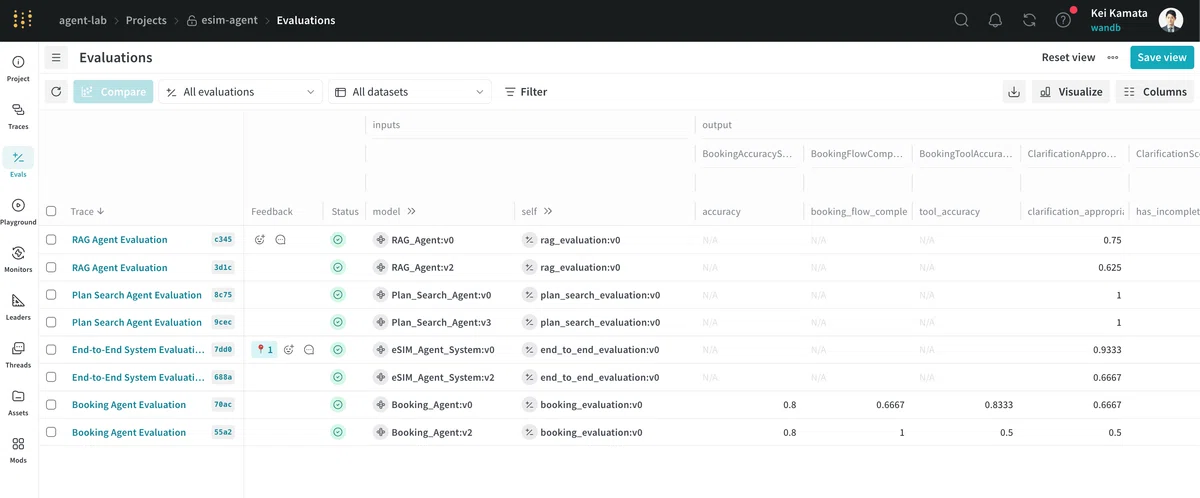
Evalの詳細は、次のリンクからご確認ください: Evaluations overview
インタラクティブな深掘りを可能にするUI
WeaveのEvalは、サクサクと動作する深掘り分析向けのUIを多数備えています。
複数の評価指標を横並びで可視化
各サンプルに対する正誤の詳細確認
リーダーボード形式でのモデル比較
モデル比較を容易にするレーダーチャート
時系列での精度変化を可能にする可視化
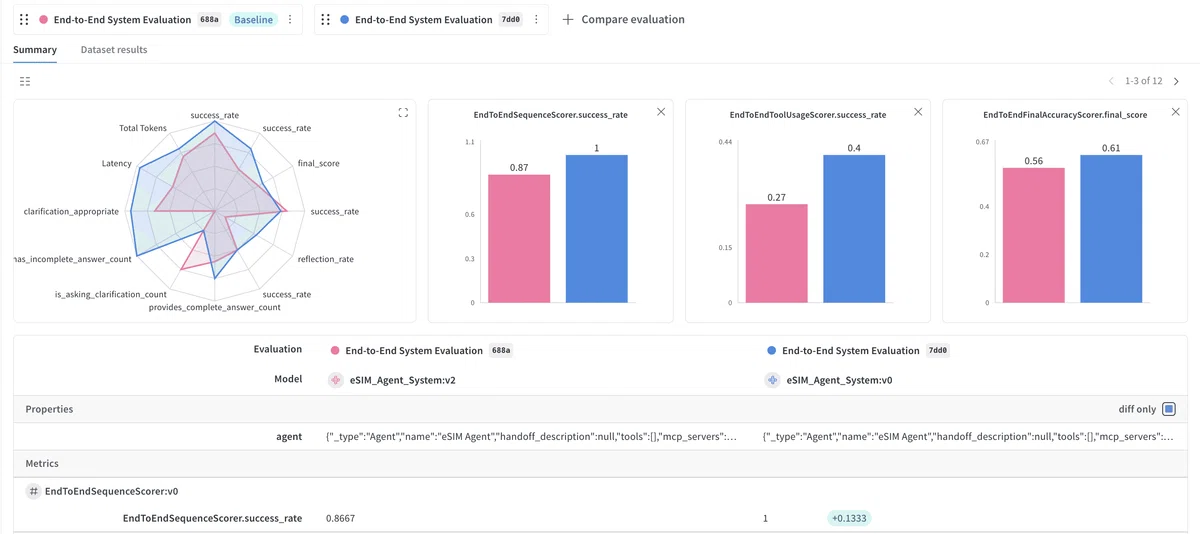
可視化については、以下の公開プロジェクトから、実際にご確認ください。
例えば、二つの評価を選択し、Compareを押すとモデルを比較する上のような図が作成されます。また、各行をクリックし、ポップアップされる画面の下から各サンプルの結果が確認できるページに遷移することができます。
Scorerの登録
Weaveでは多様なScorerを利用できます。ハルシネーション検出、要約品質、埋め込み類似度、毒性検出などのビルトインScorerがすぐに使えるほか、`@weave.op`デコレータを付けた関数や`weave.Scorer`クラスを継承したカスタムScorerも定義可能です。LLM-as-a-Judgeスコアラーは、カスタムScorerとして登録が可能になります。
詳しくは次のリンクをご確認ください: Scoring Overview
Human Annotation(人間によるアノテーション)
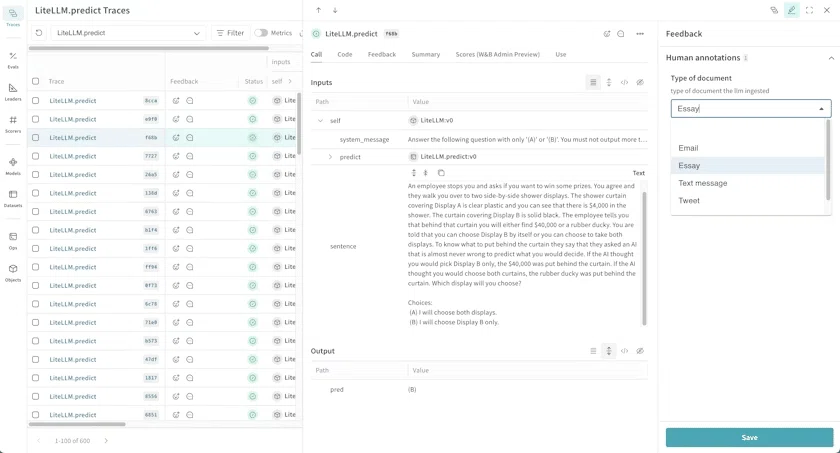
自動評価だけでなく、人間によるアノテーションワークフローもサポートしています。UI上でHuman Annotation Scorerを作成すると、Tracesの各呼び出し詳細ページのフィードバックサイドバーに表示され、boolean、整数、enumなど設定したタイプに応じたアノテーションを付与できます。APIからプログラム的にScorerを作成することも可能です。
詳しくは次のリンクをご確認ください: Create a human annotation scorer in the UI
柔軟なロギング方法(Evaluation Logger)
EvaluationLogger は、標準のEvaluation 枠組みに比べて、コード中の任意の地点で評価情報を逐次的に記録できる軽量で柔軟な実装を可能にするAPI です。事前にDataset やスコアラー関数を厳密に定義しなくても、予測結果が得られたタイミングで入力・出力・スコアを個別に記録し、最後に要約をログできます。複雑なエージェント的ワークフローで、特定のステップだけを評価したい場合や、評価対象や指標を実行中に切り替えたい場合に有用です。EvaluationLogger はトークン使用量やコストの自動集計にも対応します。LLM呼び出しより前にロガーを初期化しておくと、以降のコールに紐づくトークンとコストが収集されます。
# 1) Init the evaluation logger
eval_logger = EvaluationLogger(
    model="my_model",
    dataset="my_dataset",
)

# 2) Loop through dataset, log predictions and scores
for sample in dataset:
    output = ...                # get prediction from LLM or from disk
    pred_log = eval_logger.log_prediction(
        inputs=sample["inputs"],
        output=output,
    )
    pred_log.log_score(         # log any computed scores
        scorer="correctness",
        score=(output == sample["expected"]),
    )

# 3) Log overall summary with additional aggregations
eval_logger.log_summary({"overall_score": 0.98})
詳しくは次のリンクをご確認ください: Log evaluation data from your code
Online Evaluation(オンライン評価)
本番環境でのオンライン評価には、ガードレールとモニターの2つのアプローチがあります。どちらもScorerを基盤としており、同じScorerを両方の用途で活用できます。
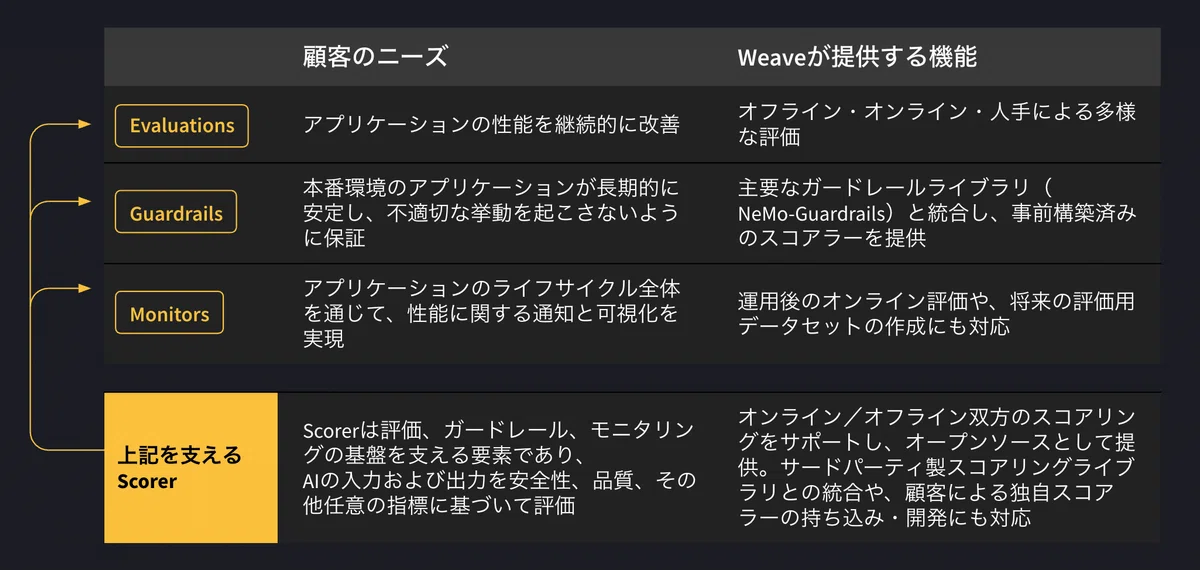
ガードレール: 問題を防ぐための能動的介入。リアルタイム(出力前)に動作し、不適切な出力をブロック・修正できます。通常は全リクエストに対して実行します。
モニター: 分析のための受動的観察。非同期・バッチ処理が可能で、アプリケーションフローに影響を与えません。サンプリング(例: 10%)での実行も可能です。
すべてのScorer結果はWeaveのTraceに自動保存されるため、追加の作業なしに履歴分析が可能です。
詳しくは次のリンクをご確認ください: Set up guardrails and monitors
Guardrail(ガードレール)
LLM出力がユーザーに届く前に実行される安全チェックです。Scorerを`.call()`で取得したCallオブジェクトに適用し、有害性などを検出した場合は出力をブロック・修正できます。スコア結果はCallと紐付けられ、後から検索・フィルタ・エクスポートが可能です。
日本では、LLMガードレールサービス「chakoshi」とのインテグレーションを発表しました。chakoshiはUI上から簡単にガードレール設定やカスタム検知項目の追加ができ、W&B Weaveと組み合わせることで、ハルシネーションや有害コンテンツの検出・ブロックを評価体系と連携させながら実現できます。詳細は以下のブログをご覧ください。
Monitoring(モニタリング)
モニターは「オンラインで動作する品質分析装置」です。アプリケーションコードにスコアリングロジックを埋め込まずに、既存の`@weave.op()`関数の呼び出しを後から選択して自動監視できます。LLM-as-a-Judgeスコアラーで、選択した関数呼び出しの出力品質を評価し、サンプリングレートに応じてバックグラウンドで自動実行後、結果がWeave UI上に表示されます。出力の正確性・信頼性の継続的な計測、モデルアップデート後のリグレッション検出、実ユーザー環境での挙動の統計的可視化に有効です。また、品質評価だけでなく、ユーザーの利用用途をLLMで自動分類し、どのような使い方がされているかを把握するといった用途にも活用できます。
Human Feedback(ユーザーフィードバック)・トレースのデータセット登録
本番環境でのユーザーフィードバックを収集し、トレースに紐づけて保存できます。これにより、ゴールデンデータセットの継続的な拡充が可能になります。
まとめ
いかがでしたでしょうか?個人の開発に向け、ご関心を持たれた方は、https://wandb.ai/site/ja/ からサインアップ->アカウントを作成し、早速はじめてください!
エンタープライズでのご利用にご関心がある方は、contact-jp@wandb.comまでご連絡ください。
W&Bの公式Xアカウントが作られました。イベントや新機能について呟いていきます!是非フォローしてください。
W&B Japan、公式アカウントを開設しました!
— Weights & Biases Japan (@wandbjapan) January 29, 2026
イベント情報や最新アップデートなど、W&Bに関する情報を発信していきます。
ぜひフォローしてください!🐝 pic.twitter.com/U7idbIu1jl
W&Bはハッカソンを開始します!3/7最終発表で、開発はいつから開始しても構いません!是非ご登録ください!
