【GASでWebスクレイピング】ページ取得から定期監視の仕組みまで

この記事で得られること
「特定のWebページの情報を定期的にチェックしてスプレッドシートに記録したい」
GASならこれが無料で実現できます。
たとえば、こんなケースです。
ECサイトの商品価格を毎日記録して推移を追いたい
競合サイトの新着情報を自動でキャッチしたい
求人ページや在庫状況の変化をウォッチしたい
為替や仮想通貨のレートを定点観測したい
APIが公開されていないサービスでもWebページさえあればデータを取得できるのがスクレイピングの強みです。
この記事では以下の内容をカバーします。
UrlFetchAppでHTMLを取得する基本
正規表現とテキスト処理でデータを抽出する方法
変更検知+通知の仕組み
トリガーで定期監視を自動化する設計パターン
スクレイピングのマナーと注意点
前提知識
この記事は以下の知識がある前提で書いています。
GASでスプレッドシートの読み書きができる
UrlFetchAppの基本的な使い方がわかる
エラーハンドリングの基本がわかる
基本:GASでWebページを取得する
HTMLの取得
GASでWebページのHTMLを取得するのは外部APIを叩くのと同じ要領です。
/**
 * 指定URLのHTMLを取得する
 * @param {string} url - 対象URL
 * @return {string} HTMLテキスト
 */
function fetchPage(url) {
  const options = {
    method: 'get',
    muteHttpExceptions: true,
    // 一般的なブラウザのUser-Agentを設定
    headers: {
      'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36'
    }
  };

  const response = UrlFetchApp.fetch(url, options);
  const statusCode = response.getResponseCode();

  if (statusCode !== 200) {
    throw new Error(`ページ取得失敗 (${statusCode}): ${url}`);
  }

  // UTF-8 固定で取得。Shift_JIS など他の文字コードのサイトでは文字化けすることがあります
  return response.getContentText('UTF-8');
}APIとの違いは返ってくるのがJSONではなくHTMLテキストだという点です。
ここからの「必要なデータの抽出」がスクレイピングの本題になります。
注: getContentText('UTF-8')はUTF-8前提の取得です。Shift_JISなど別の文字コードを使うサイトでは文字化けすることがあります。
その場合は引数を省略したgetContentText()に切り替えてください(GASがContent-Typeヘッダーから文字コードを自動判定します)。
なぜUser-Agentを設定するのか
User-Agentヘッダーを設定しているのはGASのデフォルトUser-Agentだとアクセスをブロックするサイトがあるためです。
ただしこれはサイト側のポリシーを回避するためではなく正常なHTTPリクエストとして扱ってもらうためです。
スクレイピングのマナーについては記事の最後で詳しく触れます。
データ抽出の3つのアプローチ
GASにはDOM操作ライブラリ(cheerioやjsdomのようなもの)がないためHTMLからデータを抽出するには工夫が必要です。
主に3つのアプローチがあります。
アプローチ①:正規表現
最もシンプルで汎用的な方法です。
/**
 * HTMLから正規表現でデータを抽出する
 */
function extractWithRegex(html) {
  // 例: <span class="price">¥3,980</span> から価格を取得
  const priceMatch = html.match(/<span class="price">(.*?)<\/span>/);
  const price = priceMatch ? priceMatch[1] : null;

  // 例: <title>ページタイトル</title> からタイトルを取得
  const titleMatch = html.match(/<title>(.*?)<\/title>/);
  const title = titleMatch ? titleMatch[1] : null;

  // 例: 複数マッチ(すべてのリンクテキストを取得)
  const linkPattern = /<a[^>]*>(.*?)<\/a>/g;
  const links = [];
  let match;
  while ((match = linkPattern.exec(html)) !== null) {
    links.push(match[1]);
  }

  return { price, title, links };
}
正規表現の弱点はHTMLの構造が少しでも変わると壊れることです。
class="price"がclass="price sale-price"に変わっただけで抽出に失敗します。重要な監視には、後述のアプローチ②③を検討してください。
アプローチ②:XmlServiceでパースする
取得対象がXHTML(XML準拠のHTML)であればGAS組み込みのXmlServiceが使えます。
/**
 * XmlServiceでHTMLをパースする
 * ※整形されたXHTMLでないと動かないことが多い
 */
function parseWithXml(html) {
  try {
    // XMLとしてパース(不正なHTMLだとエラーになる)
    const doc = XmlService.parse(html);
    const root = doc.getRootElement();

    // 名前空間の処理(XHTMLの場合)
    const ns = XmlService.getNamespace('http://www.w3.org/1999/xhtml');

    // 要素を探索
    const title = root.getChild('head', ns).getChild('title', ns).getText();
    return title;
  } catch (e) {
    console.error('XMLパースに失敗(HTMLが不正な可能性): ' + e.message);
    return null;
  }
}
現実には、多くのWebページのHTMLはXML準拠ではないためXmlServiceがそのまま使えることは少ないです。
主にRSSフィードやAPIのXMLレスポンスを扱うときに有効です。
アプローチ③:構造化データ(JSON-LD)を狙う
最近のECサイトやブログにはSEO目的でHTML内にJSON-LD形式の構造化データが埋め込まれていることがあります。
これを抽出すれば正規表現よりはるかに安定したスクレイピングができます。
/**
 * HTML内のJSON-LD構造化データを抽出する
 * @param {string} html - HTMLテキスト
 * @return {Array} JSON-LDオブジェクトの配列
 */
function extractJsonLd(html) {
  // type 属性の前後空白・追加属性(nonce 等)・改行を含むタグにも対応
  const pattern = /<script[^>]*\btype\s*=\s*["']application\/ld\+json["'][^>]*>([\s\S]*?)<\/script>/gi;
  const results = [];
  let match;

  while ((match = pattern.exec(html)) !== null) {
    try {
      const data = JSON.parse(match[1].trim());
      results.push(data);
    } catch (e) {
      // パース失敗は無視(不正なJSON-LDが埋まっていることがある)
    }
  }

  return results;
}

/**
 * JSON-LDから商品情報を取得する
 */
function getProductFromJsonLd(url) {
  const html = fetchPage(url);
  const jsonLdList = extractJsonLd(html);

  // @type が "Product" のデータを探す
  const product = jsonLdList.find(item =>
    item['@type'] === 'Product' ||
    (Array.isArray(item['@graph']) && item['@graph'].some(g => g['@type'] === 'Product'))
  );

  if (!product) {
    console.log('商品の構造化データが見つかりませんでした');
    return null;
  }

  // @graph 内にある場合
  const productData = product['@type'] === 'Product'
    ? product
    : product['@graph'].find(g => g['@type'] === 'Product');

  return {
    name: productData.name,
    price: productData.offers ? productData.offers.price : null,
    currency: productData.offers ? productData.offers.priceCurrency : null,
    availability: productData.offers ? productData.offers.availability : null,
  };
}
JSON-LDのメリットはHTMLの見た目が変わっても構造化データは維持されることが多い点です。
Amazon、楽天、Yahoo!ショッピングなど大手ECサイトの多くが商品ページにJSON-LDを埋め込んでいます。
実践:価格監視ツールを作る
ここまでのテクニックを組み合わせて実用的な価格監視ツールを作ります。
シート構成
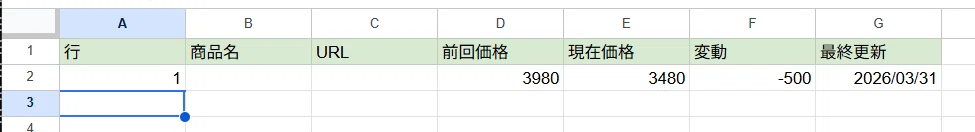
コード
/**
 * 価格監視のメイン処理
 */
function checkPrices() {
  const sheet = SpreadsheetApp.getActiveSpreadsheet().getSheetByName('監視リスト');
  const lastRow = sheet.getLastRow();

  if (lastRow < 2) return;

  const data = sheet.getRange(2, 1, lastRow - 1, 6).getValues();
  const updates = [];
  const alerts = [];

  data.forEach((row, index) => {
    const [name, url, prevPrice, lastCurrentPrice, , ] = row;

    // URLなし行はスキップ(既存値をそのまま保持して行対応を維持する)
    if (!url) {
      updates.push([row[2], row[3], row[4], row[5]]);
      return;
    }

    try {
      const currentPrice = scrapePrice(url);

      if (currentPrice === null) {
        // D列は数値のまま保持(文字列を入れると次回の差額計算が NaN になるため)
        updates.push([prevPrice, lastCurrentPrice || prevPrice, '取得失敗', new Date()]);
        return;
      }

      // C列(前回価格)← 前回のD列値、D列(現在価格)← 今回取得した価格
      // 文字列が混入しても NaN にならないよう number であることを確認してから使う
      const prevForCalc = (typeof lastCurrentPrice === 'number' && lastCurrentPrice > 0)
        ? lastCurrentPrice
        : (typeof prevPrice === 'number' && prevPrice > 0 ? prevPrice : null);
      const change = prevForCalc !== null ? currentPrice - prevForCalc : 0;
      updates.push([lastCurrentPrice || prevPrice, currentPrice, change, new Date()]);

      // 価格が下がったらアラート対象に追加
      if (change < 0) {
        alerts.push({
          name: name,
          prevPrice: prevForCalc,
          currentPrice: currentPrice,
          change: change,
          url: url
        });
      }

      console.log(`${name}: ¥${prevForCalc || '---'} → ¥${currentPrice} (${change >= 0 ? '+' : ''}${change})`);
    } catch (e) {
      // D列は数値のまま保持(文字列を入れると次回の差額計算が NaN になるため)
      updates.push([prevPrice, lastCurrentPrice || prevPrice, 'エラー', new Date()]);
      console.error(`${name}: ${e.message}`);
    }

    // サイトへの負荷を考慮して間隔を空ける
    Utilities.sleep(3000);
  });

  // C〜F列を一括更新
  if (updates.length > 0) {
    sheet.getRange(2, 3, updates.length, 4).setValues(updates);
  }

  // 値下がり通知
  if (alerts.length > 0) {
    sendPriceAlerts(alerts);
  }

  console.log(`チェック完了: ${updates.length}件(値下がり: ${alerts.length}件)`);
}

/**
 * URLから価格を取得する(JSON-LD → 正規表現のフォールバック)
 * @param {string} url - 商品ページURL
 * @return {number|null} 価格(数値)
 */
function scrapePrice(url) {
  const html = fetchPage(url);

  // まずJSON-LDを試す(最も安定)
  const jsonLdList = extractJsonLd(html);
  let productData = null;
  for (const item of jsonLdList) {
    if (item['@type'] === 'Product') {
      productData = item;
      break;
    }
    // @graph 内に Product が入っているパターンにも対応
    if (Array.isArray(item['@graph'])) {
      const found = item['@graph'].find(g => g['@type'] === 'Product');
      if (found) { productData = found; break; }
    }
  }
  if (productData && productData.offers && productData.offers.price) {
    return Number(productData.offers.price);
  }

  // JSON-LDがなければ正規表現にフォールバック
  // ※対象サイトに合わせてパターンを調整すること
  const pricePatterns = [
    /["']price["']\s*:\s*["']?(\d[\d,]*)/,         // JSON内の price フィールド
    /class="[^"]*price[^"]*"[^>]*>[\s\S]*?(\d[\d,]+)/i, // class に price を含む要素
    /¥\s*(\d[\d,]+)/,                               // ¥記号の後の数値
  ];

  for (const pattern of pricePatterns) {
    const match = html.match(pattern);
    if (match) {
      const price = Number(match[1].replace(/,/g, ''));
      if (!isNaN(price) && price > 0) {
        return price;
      }
    }
  }

  return null;
}

/**
 * 値下がりをメールで通知する
 */
function sendPriceAlerts(alerts) {
  const subject = `【価格アラート】${alerts.length}件の値下がりを検知`;

  let body = '以下の商品で値下がりが検知されました。\n\n';
  alerts.forEach(alert => {
    body += `■ ${alert.name}\n`;
    body += `  ¥${alert.prevPrice.toLocaleString()} → ¥${alert.currentPrice.toLocaleString()} (${alert.change.toLocaleString()}円)\n`;
    body += `  ${alert.url}\n\n`;
  });

  // スクリプトプロパティ NOTIFY_EMAIL に通知先を設定しておくと確実
  // 未設定の場合は getActiveUser().getEmail() を試みる(時間主導トリガーでは空になることがある)
  const email = PropertiesService.getScriptProperties().getProperty('NOTIFY_EMAIL')
    || Session.getActiveUser().getEmail();
  if (!email) {
    console.error('通知先メールアドレスが取得できませんでした(NOTIFY_EMAIL プロパティを設定してください)');
    return;
  }

  GmailApp.sendEmail(email, subject, body);

  console.log(`値下がりアラートを送信しました(${alerts.length}件)`);
}
設計のポイント
JSON-LD → 正規表現のフォールバック戦略。
まず安定性の高いJSON-LDを試して、なければ正規表現で取得します。
この順番にすることでJSON-LDが使えるサイトでは正規表現のメンテナンスコストがゼロになります。
前回価格の保持。
C列に前回価格を残しておくことで「いつ・いくら変動したか」を追跡できます。
D列の現在価格がC列に移動するタイミングは次回チェック時。
この2段構造が変動検知の基盤です。
通知はGmailApp。
Slack通知(記事③で紹介)でもいいですがGASはGmailとの連携が最も簡単です。
スクリプトプロパティ NOTIFY_EMAIL`に通知先アドレスを設定しておくのが確実です。
未設定の場合は Session.getActiveUser().getEmail()にフォールバックしますが、時間主導トリガーで実行するとこの値が空になることがあるためプロパティへの設定を推奨します。
変更検知の応用パターン
価格だけでなくページの内容が変わったかどうかを検知するパターンも便利です。
/**
 * ページの変更を検知する
 * ページ全体のハッシュ値を比較して、変更があれば通知
 */
function detectPageChange() {
  const sheet = SpreadsheetApp.getActiveSpreadsheet().getSheetByName('変更監視');
  const lastRow = sheet.getLastRow();

  if (lastRow < 2) return;

  // A列: サイト名, B列: URL, C列: 前回ハッシュ, D列: ステータス, E列: 最終チェック
  const data = sheet.getRange(2, 1, lastRow - 1, 5).getValues();

  data.forEach((row, index) => {
    const [name, url, prevHash, , ] = row;
    if (!url) return;

    try {
      const html = fetchPage(url);

      // HTMLから動的要素(タイムスタンプ等)を除去してからハッシュ化
      const cleanedHtml = html
        .replace(/<script[\s\S]*?<\/script>/gi, '')  // スクリプト除去
        .replace(/<style[\s\S]*?<\/style>/gi, '')    // スタイル除去
        .replace(/\s+/g, ' ')                        // 余分な空白を統一
        .trim();

      const currentHash = Utilities.computeDigest(
        Utilities.DigestAlgorithm.MD5,
        cleanedHtml
      ).map(b => (b < 0 ? b + 256 : b).toString(16).padStart(2, '0')).join('');

      const rowNum = index + 2;
      const changed = prevHash && prevHash !== currentHash;

      sheet.getRange(rowNum, 3).setValue(currentHash);
      sheet.getRange(rowNum, 4).setValue(changed ? '変更あり' : '変更なし');
      sheet.getRange(rowNum, 5).setValue(new Date());

      if (changed) {
        console.log(`変更検知: ${name}`);
        const email = PropertiesService.getScriptProperties().getProperty('NOTIFY_EMAIL')
          || Session.getActiveUser().getEmail();
        if (email) {
          GmailApp.sendEmail(
            email,
            `【変更検知】${name} が更新されました`,
            `以下のページに変更がありました。\n\n${name}\n${url}`
          );
        } else {
          console.error('通知先メールアドレスが取得できませんでした(NOTIFY_EMAIL プロパティを設定してください)');
        }
      }
    } catch (e) {
      console.error(`${name}: チェック失敗 - ${e.message}`);
    }

    Utilities.sleep(3000);
  });
}
Utilities.computeDigest()でページ内容のMD5ハッシュを生成し前回の値と比較します。
1文字でも変わればハッシュが変わるので更新を確実に検知できます。
スクリプトやスタイルを除去してからハッシュ化しているのは広告の差し替えやトラッキングコードの変更などコンテンツと無関係な変更で誤検知しないためです。
トリガーで定期監視を設定する
/**
 * 監視用トリガーを設定する
 */
function setupMonitoringTriggers() {
  // 既存トリガーを削除
  ScriptApp.getProjectTriggers().forEach(trigger => {
    const funcName = trigger.getHandlerFunction();
    if (funcName === 'checkPrices' || funcName === 'detectPageChange') {
      ScriptApp.deleteTrigger(trigger);
    }
  });

  // 価格チェック: 毎日午前8時
  ScriptApp.newTrigger('checkPrices')
    .timeBased()
    .everyDays(1)
    .atHour(8)
    .create();

  // 変更検知: 6時間ごと
  ScriptApp.newTrigger('detectPageChange')
    .timeBased()
    .everyHours(6)
    .create();

  console.log('監視トリガーを設定しました');
}
価格チェックは1日1回で十分なケースが多いです。
変更検知は監視対象によって頻度を調整してください。
頻度を上げすぎると対象サイトへの負荷になるので必要最小限にとどめるのがマナーです。
スクレイピングのマナーと注意点
スクレイピングは便利ですがやり方を間違えるとサイトに迷惑をかけたり法的なリスクを負ったりします。
以下の点を必ず守ってください。
robots.txtを確認する
多くのサイトはrobots.txtでクローラーのアクセスルールを公開しています。たとえばhttps://example.comというサイトなら「https://example.com/robots.txt」 にアクセスして、対象パスが`Disallow`になっていないか確認してください。
/**
 * robots.txtを確認するヘルパー
 */
function checkRobotsTxt(siteUrl) {
  try {
    // GAS では標準 Web API の URL クラスが使えないため正規表現でオリジンを抽出する
    const originMatch = siteUrl.match(/^(https?:\/\/[^\/]+)/);
    if (!originMatch) {
      console.error('URLの形式が正しくありません: ' + siteUrl);
      return;
    }
    const robotsUrl = originMatch[1] + '/robots.txt';
    const response = UrlFetchApp.fetch(robotsUrl, { muteHttpExceptions: true });

    const statusCode = response.getResponseCode();
    if (statusCode === 200) {
      console.log(response.getContentText());
    } else if (statusCode === 404) {
      console.log('robots.txt が見つかりません(404)');
    } else {
      console.log(`robots.txt を確認できませんでした(ステータス: ${statusCode})`);
    }
  } catch (e) {
    console.error('robots.txt の確認に失敗: ' + e.message);
  }
}
守るべきルール
リクエスト間隔を十分に空ける。
最低でも3秒できれば5秒以上の間隔を空けてください。
1秒間隔で大量リクエストを投げるのはDDoS攻撃と変わりません。
必要最小限のアクセスにとどめる。
価格だけ知りたいなら商品ページだけにアクセスしサイト全体をクロールする必要はありません。
利用規約を確認する。
サイトの利用規約でスクレイピングが明示的に禁止されている場合は、たとえ技術的に可能でもスクレイピングはやめましょう。
取得データの利用範囲を守る。
取得したデータを個人的に分析・監視に使う範囲であれば問題になりにくいですが、大量に収集してデータベース化したり再配布したりすると著作権や不正競争防止法に抵触する可能性があります。
APIが公開されているならAPIを使う。
スクレイピングは「APIがないときの代替手段」です。
APIが用意されているサービスならそちらを使うほうがサーバー負荷も低くデータの安定性も高いです。
GASスクレイピングの限界
GASでのスクレイピングには知っておくべき限界があります。
JavaScriptで動的に生成されるコンテンツは取得できない。
UrlFetchAppが取得するのはサーバーから返される生のHTMLです。
ReactやVue.jsなどで画面描画後にデータを挿入しているサイトでは必要なデータがHTML内に存在しません。
この場合はPuppeteerなどのヘッドレスブラウザが必要になりますがGAS単体では使えません。
対処法として多くのSPA(シングルページアプリケーション)はデータ取得にAPIを呼んでいます。
ブラウザのDevToolsでネットワークタブを確認しAPIエンドポイントが見つかればそこを直接叩くほうが確実です。
CAPTCHAやログインが必要なページは対応できない。
認証が必要なサイトではCookieの管理が複雑になりCAPTCHAは突破できません。
実行時間の6分制限。
大量ページのスクレイピングはGASの実行制限に引っかかります。
前回の記事で紹介したバッチ処理パターン(処理位置を保存して分割実行)で対処してください。
まとめ
この記事で紹介した内容を整理します。
GASのUrlFetchAppでWebページのHTMLを取得できる
データ抽出はJSON-LD → 正規表現のフォールバック戦略が安定する
価格監視は「前回値との比較+メール通知」で実用的なツールになる
変更検知はMD5ハッシュの比較で確実に検知できる
トリガーと組み合わせれば完全自動の監視システムが構築できる
マナーとルールを守ることが大前提(robots.txt確認、リクエスト間隔、利用規約)
スクレイピングは「APIがないサービスのデータを取得する」ための手段です。
APIが公開されている場合はそちらを使うほうがあらゆる面で優れています。
外部API連携の実践としてeBay Browse APIとGASを組み合わせたリサーチ自動化ツールの作り方も公開しています。
OAuth認証やレート制限対策など、本格的なAPI連携のハマりどころが気になる方はこちらもどうぞ。
このnoteでは、エンジニアの副業・自動化の実践過程を発信しています。
フォローしておくと、新しい記事の通知が届きます。
