AIに持たせた地図が、次は勝手に育ち始めた〜進化するオントロジーの実践〜

前回、AI エージェント向けに会社の地図 (オントロジー) を導入した記事を書きました。今回はその続編として、地図が自動で更新される仕組みの話です。
地図は、描いた日から古くなる
組織は変わり、プロダクトは改名する。地図は、描いた日から古くなります。オントロジーの技術的不確実性は、構築よりも保守です。記事への反響で多かったのも「保守が大変そう」という声でした。
AI のパフォーマンスのために私が地図を保守し続けるのはできれば避けたいです。どう対処していきましょう。
誰が地図を直すのか
今回は、地図の利用者たる AI たちにやってもらうことにしました。人間の保守担当者を増やす話ではありません。
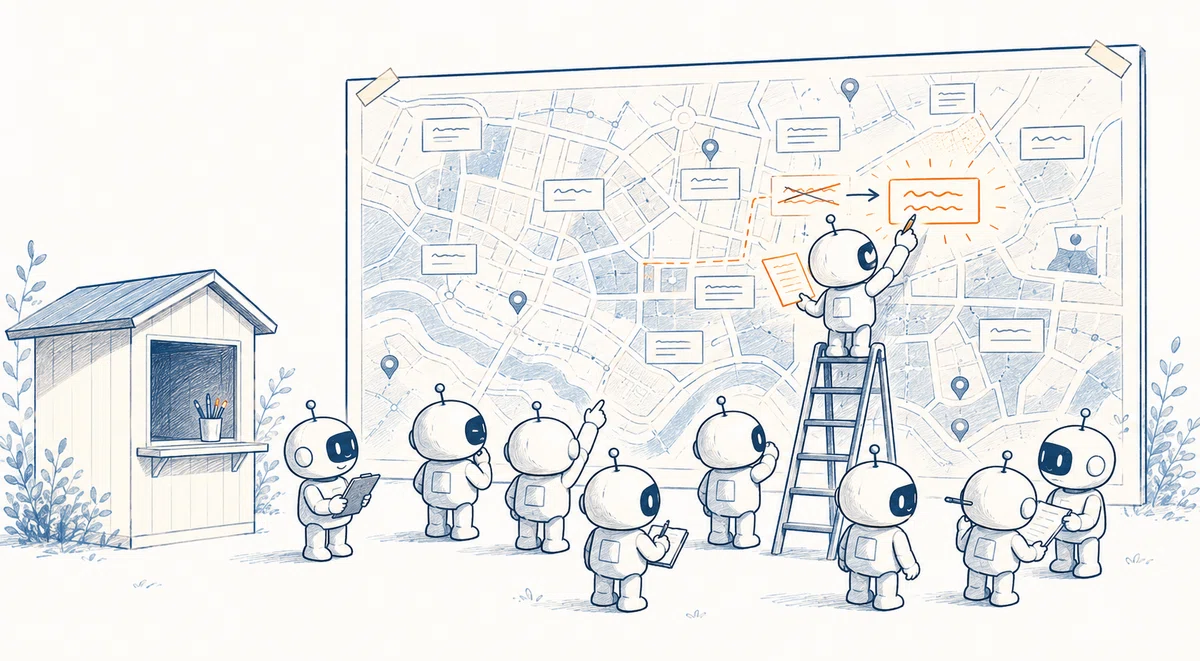
この地図を毎日何百回も引きに来るのは AI エージェントたちで、社員との対話や、Slack や議事録に触れていて、新しい事実を知っているのも AI エージェントたちです。「地図には旧チーム名で載っているが、さっき読んだ議事録では改名されていた」と最初に気づけるのは彼らのはずです。
だったら、AI エージェントが直せばいい。行動を促すには、MCP の説明書きに「地図の情報が古い、または欠けていると気づいたら、update という tool で報告すること」と追記するだけです。
ここに、AI 時代の面白い逆転があります。これまで、サーバーがクライアントに何かを頼む方法はありませんでした。相手が AI であれば、何らかの行動を促せます。地図の利用者が、そのまま保守要員になる。
自然言語で、地図を書き換える
地図を更新する。この形の技術が、いま各所で立ち上がっています。
筆頭は Palantir です。同社の AI プラットフォームでは、会社の業務データをモノと関係の地図(オントロジー)として整理し、AI はそれを読んで仕事をします。その後、あらかじめ定義された操作によってオントロジーが書き換わります。
AI エージェントの記憶でも同じ形が出てきています。Zep の Graphiti は、会話から拾った事実を知識グラフに書き足していきます。
今回社内オントロジーを更新してみたのは、この潮流のなかの1つの実験です。
先に、「良い地図」を決める
仕組みを作る前に、「地図が良くなった」とは何かを決めておきます。良さの定義がないと、後段の検査・採点の設計がすべて場当たり的になるからです。
今回は、ナレッジグラフの定番教科書 Hogan et al. の Knowledge Graphs が中核に挙げる四つ、正確性(Accuracy)、網羅性(Coverage)、整合性(Coherency)、簡潔性(Succinctness)を軸にします。
ここに二つ足します。一つは鮮度(Timeliness)です。更新され続ける地図では、情報の古さがそのまま品質になるからです。もう一つは構造です。Data & Knowledge Engineering 誌の近年の研究は、更新され続けるグラフを対象に、意味の面だけでなく構造の面(孤立や断線が増えていないか)からも変化を測る評価を提案しています。
雑に言い換えると、こういう状態です。
正確性:誤情報が含まれていないこと
網羅性:必要な情報が含まれていること
整合性:情報が矛盾していないこと
簡潔性:不要な情報や重複した情報を含んでいないこと
鮮度:最新の状態に保たれていること
構造:個々の情報が関係性で辿れること
育つ地図の作り方
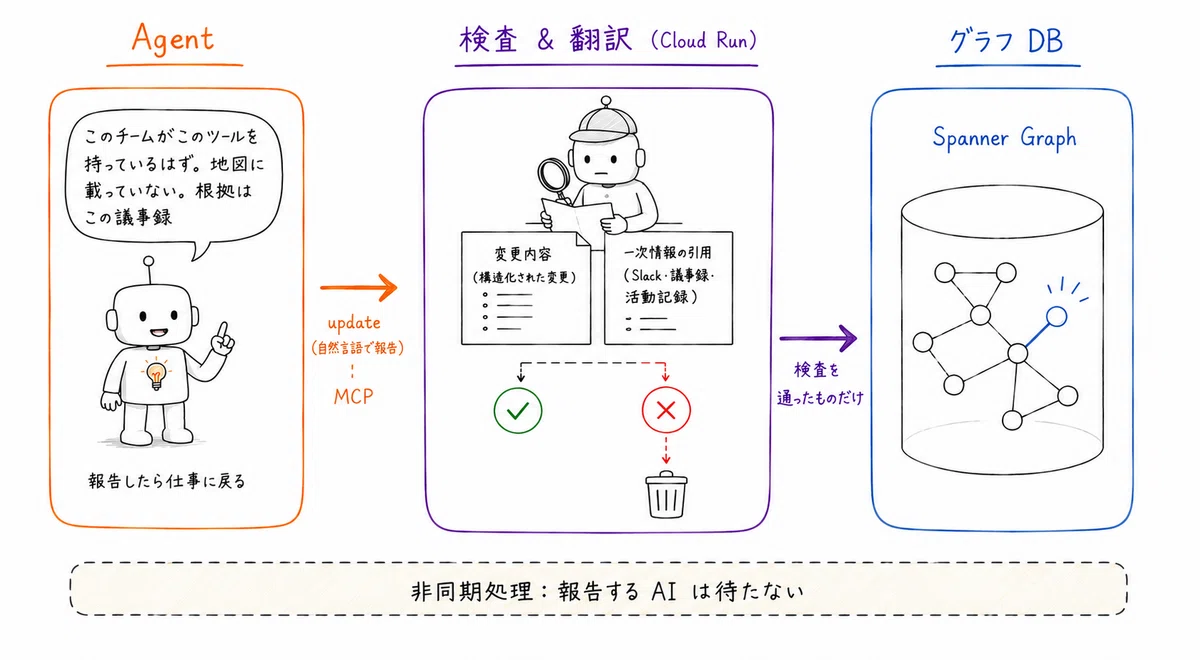
役割は三者に分かれます。
クライアント AI は気づいた観測を一文で報告するだけ。バックエンド側の判定エージェントはその報告を地図に入れるべきか裁きます。グラフ DB は判定を通った変更を保持します。
グラフの更新をコントロールするのは難しく、仕様は一発では決まりません。ナイーブに実装すると、例えば誤った情報を書き込んでしまう (正確性の毀損)、すでに用語があるのに重複して登録してしまう (簡潔性の毀損)、孤立ノードを量産してしまう (構造の毀損) などの問題が容易に生じます。
判定エージェントはループで鍛える
今回は、ループエンジニアリング的に改善を回すことで、前章の「良さ」を満たす処理を作りました。
はじめに数日間 MCP を社内に公開し、社内 AI からの実際の更新リクエストを集めます。そのリクエストを用いて、「良さ」に沿ってグラフ更新が行われるように、判定エージェントの実装を改善し続けました。
結果的に、決定論的な処理と AI による処理の組み合わせになりました。AI は社内ログと既存のグラフを参照しつつ、報告文から固有名詞を拾う、変更案を作る、整合するかを確認する、という仕事を担います。時間がかかる処理なので、決定論的な処理として非同期かつ排他的な制御を入れる必要がありました。
項目ごとに効いた施策
最終的に次の対応に落ち着きました。
正確性:判定エージェントが社内の活動ログを検索し、報告の裏が取れるかで判定します
整合性:既存グラフを読んで、破綻しないように更新を行います。地図が育てば規範も追随します
簡潔性:固有名詞性の判定。社内で固有の名前として通用する対象かを問い、汎用的だったりニッチすぎる事象の名前は、真実であっても入れません
網羅性と鮮度:検査ではなく更新のループ全体で担保する。使い手の報告が鮮度を保ちます
構造:既存のグラフと同程度の数の関係を持つことを良しとして調整します (正確性とのトレードオフがある)
得られたもの
公開してまもなく、AI からの報告で地図が実際に育ち始めました。ある人事制度が変化アナウンスされた翌日に、地図がしっかり更新されているのも確認できました。人手なしでの改善が回り始めました。
グラフを保守していくうえでの知見もいくつか得られました。
一つは、地図を更新する主体を AI エージェントに寄せておく設計が、保守に有効なことです。人間は地図の世話から降りられます。
もう一つは、判定エージェントは、定性的になりがちな「グラフの良さ」をある程度扱えることです。人類の知の蓄積がそのまま判定基準として活用できます。
一方で限界も見えました。グラフの保守はやはり大変で、ミッションクリティカルな用途に持ち込むには工夫が要りそうです。少なくとも、地図を常に最小限に保つ工夫は要りそうです。
おわりに
グラフはプロダクトの根幹に据える存在になりつつあります。自然言語でグラフを育てる技術は、いずれビッグテックがソリューションとして出してくる気もします。肌感を掴む意味で、面白い実験でした。
