AIに会社の地図を持たせたら、3年目社員のように働き始めた 〜精度とトークン効率を上げるオントロジーの実践〜

AI に仕事を頼むと、まず会社のことを説明する仕事が発生する。この困りごとは世界共通のようで、Y Combinator は「Company Brain」というカテゴリを立て、世界のすべての会社が必要とするようになる、と言っています。AI 活用のブロッカーは、もうモデルの性能ではなく、社内に散らばったままのドメイン知識。最近よく見かける「オントロジー」は、この潮流の言葉です。
先日、AI アシスタントに「hecate まわりの最近の動きをまとめておいて」と頼みました。hecate は Ubie 社内のあるシステムのコードネームですが、返ってきたのは、それが何かを知らないまま書かれた、もっともらしい推測の要約でした。AI は一般的な概念には博識なのに、社内のことになると新入社員以下で、しかも記憶を工夫しないと勝手には覚えてくれません。
この記事は、この課題への解として、会社の地図をオントロジーとして作った話です。
この記事は、できるだけミニマムに再現できるように書きました。「うちでもやりたい」と思ったらエージェントに食わせて試してみてください。
社内の会話は固有名詞と略称だらけ
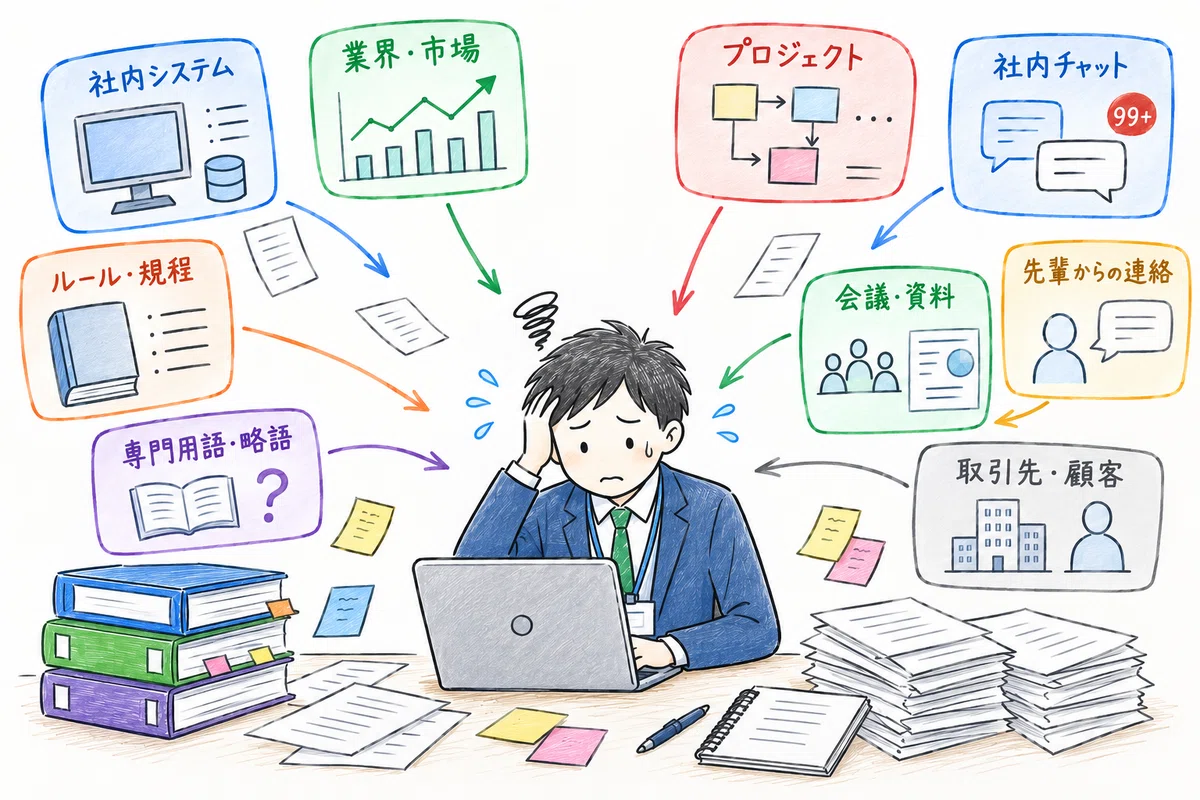
社員、部署、プロジェクト、システム。議事録を1枚開けば、社外の人には読めない固有名詞と略語が数十個並んでいます。人間の新入社員が最初に躓くのもここで、だから多くの会社には用語集やオンボーディング資料があります。
では AI にはどうするか。すぐ思いつく手は二つあります。
一つめは、頼みごとのたびにプロンプトで説明することです。これは単純に面倒で、しかも説明する人によって内容がブレます。二つめは、社内ドキュメントを片っ端から読ませることです。今度はトークン、つまりお金と時間が爆発します。さらに厄介なことに、ドキュメントの山の中では3年前の組織図と先週の組織図が同じ顔をして並んでいます。どちらが今の正解かは、どこにも書かれていません。
活動ログを検索できるだけでは足りなかった
幸い、Slack のやりとりや Meet の録画、ドキュメントといった社内の一次情報は、すでに一般的に AI から参照できるようになってきています。社内で「今起きていること」を追うならこれでかなり戦えて、実際、しばらくは足りている気でいました。
ところが使い込むほど、いくつかの壁に当たりました。まず、略語や通称で検索するとヒットしません。同じ基盤を「hecate」と呼ぶ人と「認証基盤」と呼ぶ人がいて、ログはその表記ゆれを吸収してくれません。断片的な情報で回答して質が下がることもありました。一方で、回答の質を上げようとすると、結局大量のログを読ませることになり、やはり遅くて高くつきます。
例えるなら、用語集も組織図もない会社で、Slack 検索だけを頼りに働いている新人です。検索の腕前は一流なのに、会社の全体像を知らない。
会社の地図を1枚挟む
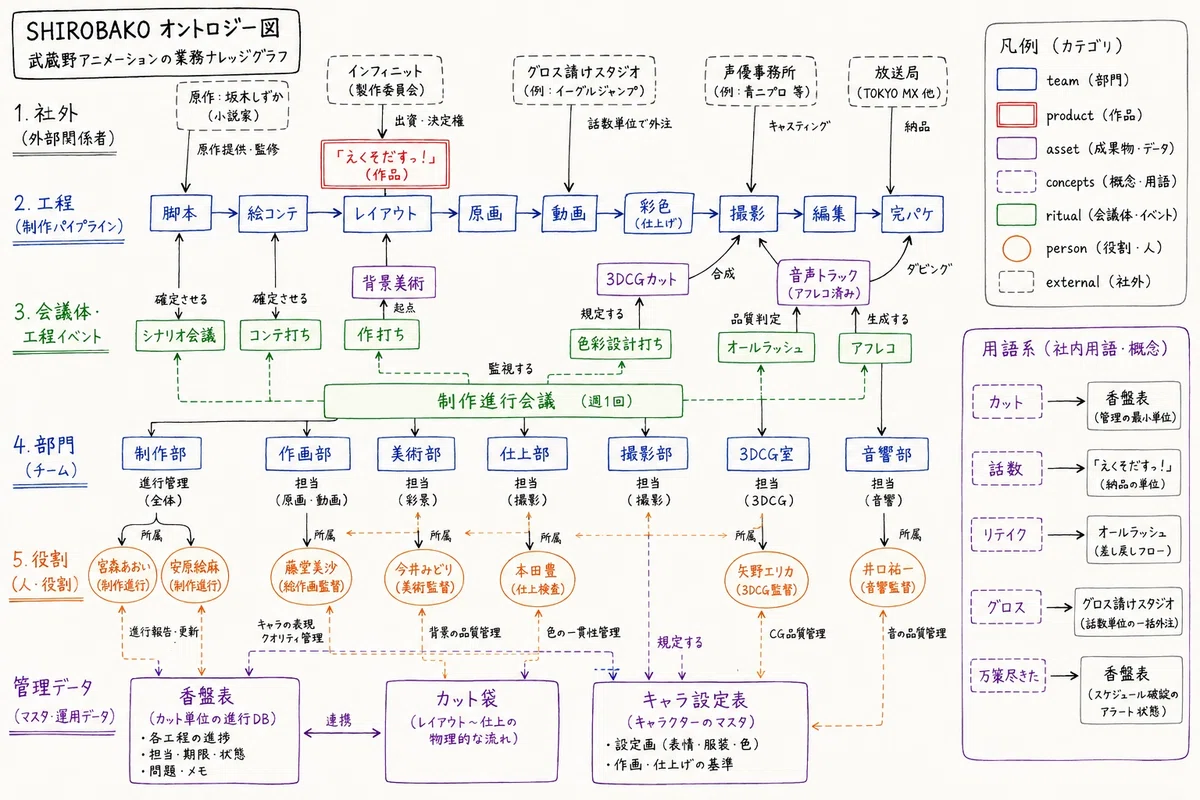
足りないのは検索の腕前ではなく、地図なのではないか。そう考えて、会社の地図を作ることにしました。
name: hecate(認証・ID 連携基盤)
type: asset
description: 認証認可と ID 連携を担う社内基盤
aliases: [Hecate, ヘカテ, 認証認可基盤, ID連携基盤]
relations:
  owned-by: [data-platform]
owner_role: Data Platform Lead (kunpe)
sources: [関連する Notion ページ]
作った地図は、社内の用語、組織、プロダクト、会議体、顧客情報などを、こういうカードで表したものです。
オントロジーという言葉の実体は、このカードの束です。ただし、普通の用語集にない工夫が2つだけあります。
一つは、定義に加えて「関係性」を持たせたことです。カード同士は「所属している」「所有している」「依存している」といった関係でつながっているので、AI は地図の上を辿れます。冒頭の hecate なら、「hecate → 持ち主は Data Platform チーム → 有識者は xx」であったり「hecate → 依存システムは yy → 影響するビジネスは zz」と辿ることで、周辺知識を参照することが出来ます。もっともらしい推測は、もう返ってきません。
もう一つは、載せない情報を決めたことです。地図に載せるのは、3ヶ月程度変わらない事実だけ。進捗や数値のような鮮度が命の情報は、載せる代わりに関連する検索語を AI に渡して、社内のログを検索させます。地図で当たりを付けて、生の記録で裏を取る。二段構えです。
頻繁に変わる情報を人手で維持する台帳は、データマネジメント領域の経験上、必ず腐ります。この線引きは、その対策です。
本当に効くのか
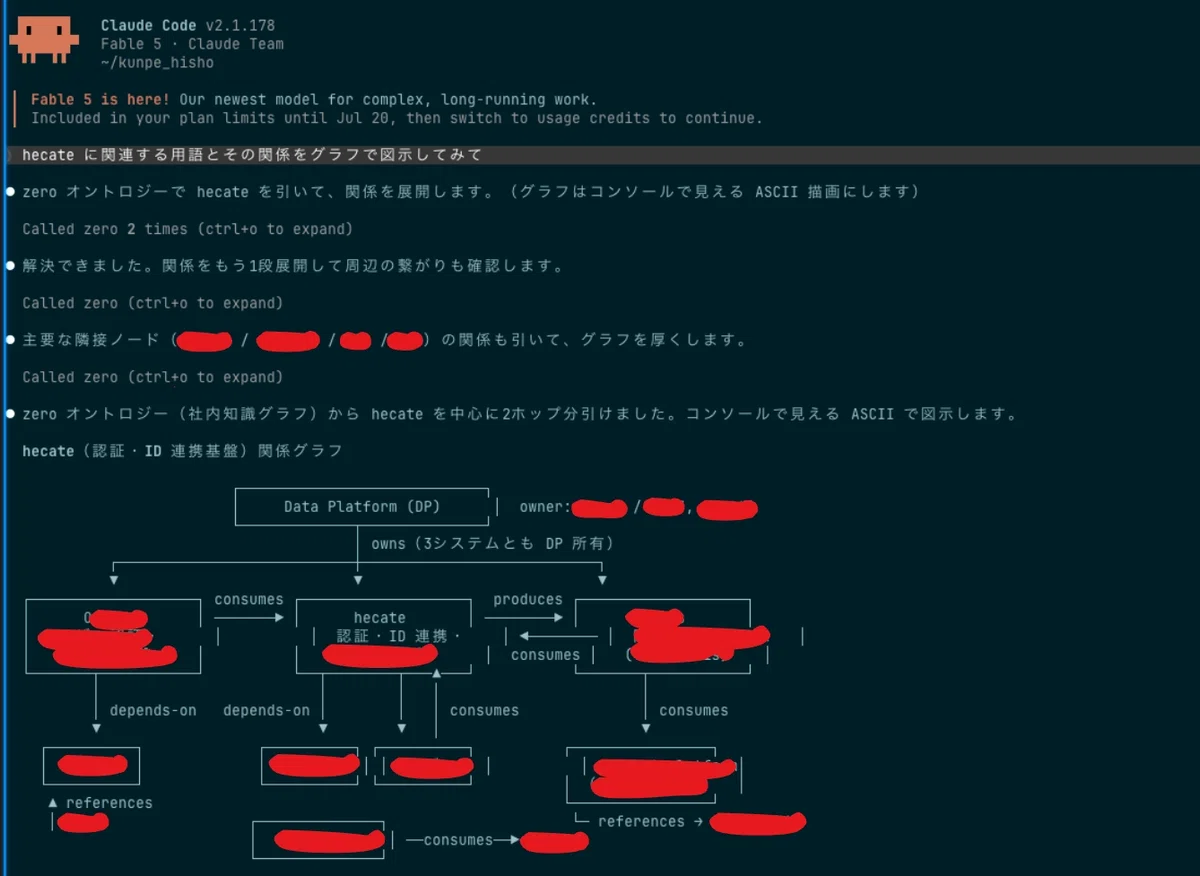
とはいえ、便利だと言い張るだけでは仕方ありません。本格導入の前に効果を計測してみました。
評価観点は、現実の実務上の問いに正しく答えられるかどうかです。社員が実際に Slack で発した業務上の疑問からデータを作り、評価に用いました。A~E の設定は、AI が参照できる情報の違いです。
結果は次のとおりです。品質スコアは相対比較に基づいています。
A: 何も参照させない → 品質スコア 8 /150 (品質下限)
B: オントロジー単体 → 品質スコア 43 /150
C: 社内ログの都度検索 → 品質スコア 112 /150
D: オントロジー + 社内ログの都度検索の併用 → 品質スコア 119 /150
E: 社内ログの全件網羅 → 品質スコア 125 /150 (品質上限)
オントロジー単体 (B) では社内ログの都度検索 (C) に遠く及びません。しかしオントロジー + 社内ログの都度検索の併用 (D) は C を上回り、上限の E との差は小さくなりました。つまり、オントロジーを検索を併用することで、社内ログを全件網羅する AI と遜色ない振る舞いをしたと言えそうです。
記載していませんが、E は1回答に8分以上かかっており、現実的には利用できません。
体感としても、AI の振る舞いに変化があります。固有名詞を正しく解釈する。みんなが参照している Notion ページを正しく見に行く。xx さんが詳しそうなので聞けばいいと判断できる。分からないことは分からないと言える。施策の影響範囲を把握してケアしてくれる。入社初日の新人が、3年目の顔をするようになりました。
今日からできる、作り方
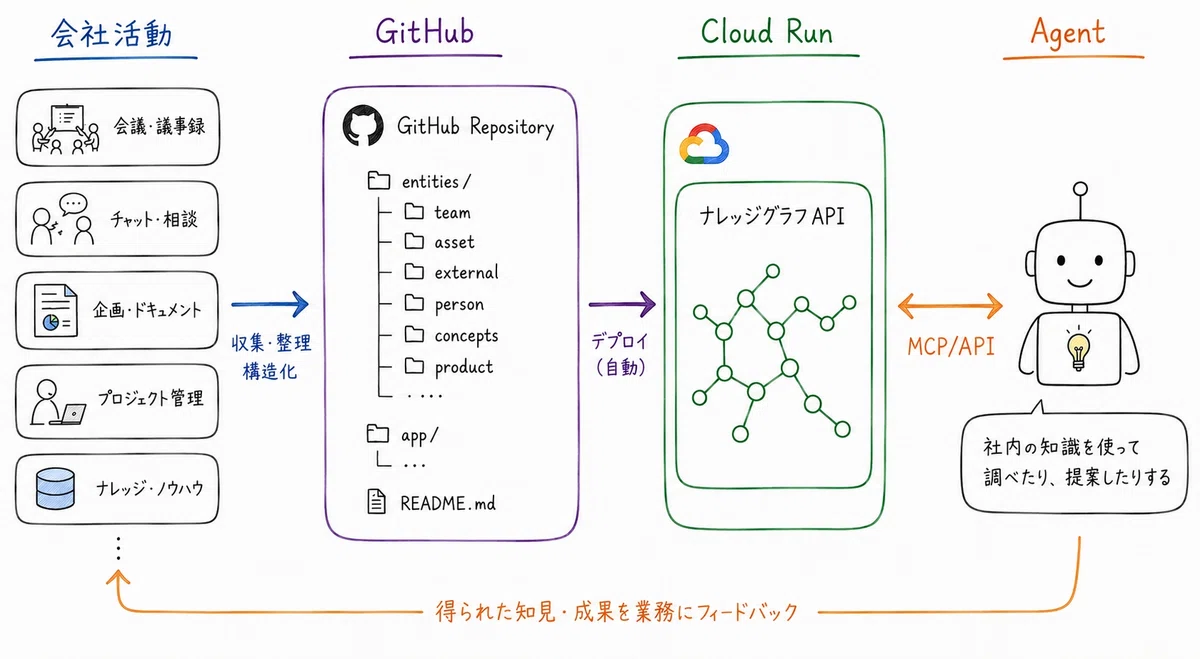
ここまで読んで、大掛かりなデータ基盤を想像した方がいるかもしれません。実態は自由研究サイズです。この記事の内容は所要2日程度でした。抑えておく要点は、次の4つです。
1. データは「1カード = 1YAML ファイル」で GitHub に置く
CI で SQLite に固めて疑似 Graph DB として、小さなコンテナ1つで API サーバとして動かします。外部のデータベースサーバはありません。本体がテキストファイルなので、修正もレビューも普段のプルリクエストの流れに乗ります。そしてデータは中央管理なので、カードを1枚直せば、その瞬間から全社員と全エージェントが新しい情報を引きます。
Ubie でのカードはいま599枚、カード間の関係は1,179本、別名は3,274個あります。ただし、人間が決めたのはカードの型(組織、プロダクト、データ資産、会議体、用語など)と、関係の種類(6種類)だけです。中身を書いたのは AI で、社内の活動ログを読ませて書いてもらいました。
2. サーバ側の機能は3つだけ
上記のデータに対してアクセスする機能を定義します。機能は増やさず、「迷ったら lookup」に寄せました。AI に渡す道具は、少ないほど正しく使われます。
lookup: 名前や別名からカードを引く。迷ったらまずこれ
expand: カードから関係を辿る。組織階層も依存関係もこれ 1 本
seeds: 活動ログを検索するための検索語セットを作る。地図とログの二段構えの橋渡し
3. MCP と CLI の両方で提供する
手元の AI アシスタントにも、社内で動くエージェントにも、接続設定を渡すだけで組み込めます。このとき、AI に渡す使い方も同時に配ります。MCP の場合は instructions、CLI の場合は同梱する SKILL.md として、以下のようなテキストを配っています。
1. 社内の固有名詞・略語・概念に出会ったら、推測したり生ログを全文検索したりする前に、まず lookup で引くこと。初手は常に lookup(解決も曖昧検索フォールバックも内部で行う)。
2. 関係(道) を辿るときは expand。組織階層は expand(entity, predicate='part-of', direction='in', node_type='team', depth=-1)。
3. 進捗・数値・最新の意思決定はここには無い。それらが必要なときは、seedsで検索語プール(別名・関係先キーワード) を作り、lookup の sources / owner_role と合わせて Slack / Notion などの社内の生情報を検索すること。zero で当たりを付けてから生ログを引く二段構えが、直接全文検索より速く正確。
4. 「誰に聞けばいいか」「どこを見ればいいか」に答えるだけでよい質問は、owner_role / sources を返して止めてよい。裏取りなしに生ログの断片から事実を断定しないこと。
4. 振る舞いのログを残し、継続改善につなげる
すべての呼び出しをサーバ側で計測しています。未ヒット語、頻繁に引かれている用語は、それぞれデータ改善のタネになります。
グラフ構造の保守は、従来とても気の重い作業でした。人力なら1ヶ月で放置されることでしょう。今回は中身のデータ作成だけでなく、継続的な保守も AI に任せる前提にして、はじめてこのサイズに収まりました。

みんなが面白がって使ってくれたおかげで、社内への浸透はある程度うまくいき、社員が個人の AI アシスタントから引くだけでなく、社内で動く各種 エージェントにも組み込まれています。この手の基盤は使われないと意味がないので、まずはこれが第一歩です。
会社の OS へ
では、この先はどこへ登るのか。
冒頭で触れた YC の「Company Brain」の定義には、続きがあります。それは全社検索でもドキュメントに答えるチャットボットでもなく、「会社がどう働いているかの、生きた地図(living map of how a company works)」だ、というものです。
AI 研究者の Andrej Karpathy も、LLM Wiki のなかで、必要になるたびに検索してかき集める方式では知識が何も積み上がらないと指摘し、LLM 自身が構造化された wiki を維持し続ける、複利的な方式を提案しています。検索で得た答えはその場で使い捨てになりますが、一度カードにした知識は、次の問いの土台になります。
そして Palantir Foundry です。最近、Foundry についての投稿を見かけました。Foundry は「データを集める(パイプライン)、業務の意味でモデリングする(オントロジー)、現場が使う(アプリケーション)」の三層でできている、というものです。データ活用の先頭を走る会社が製品の背骨に据えているのは、検索でも AI そのものでもなく、オントロジー + アプリケーション層です。
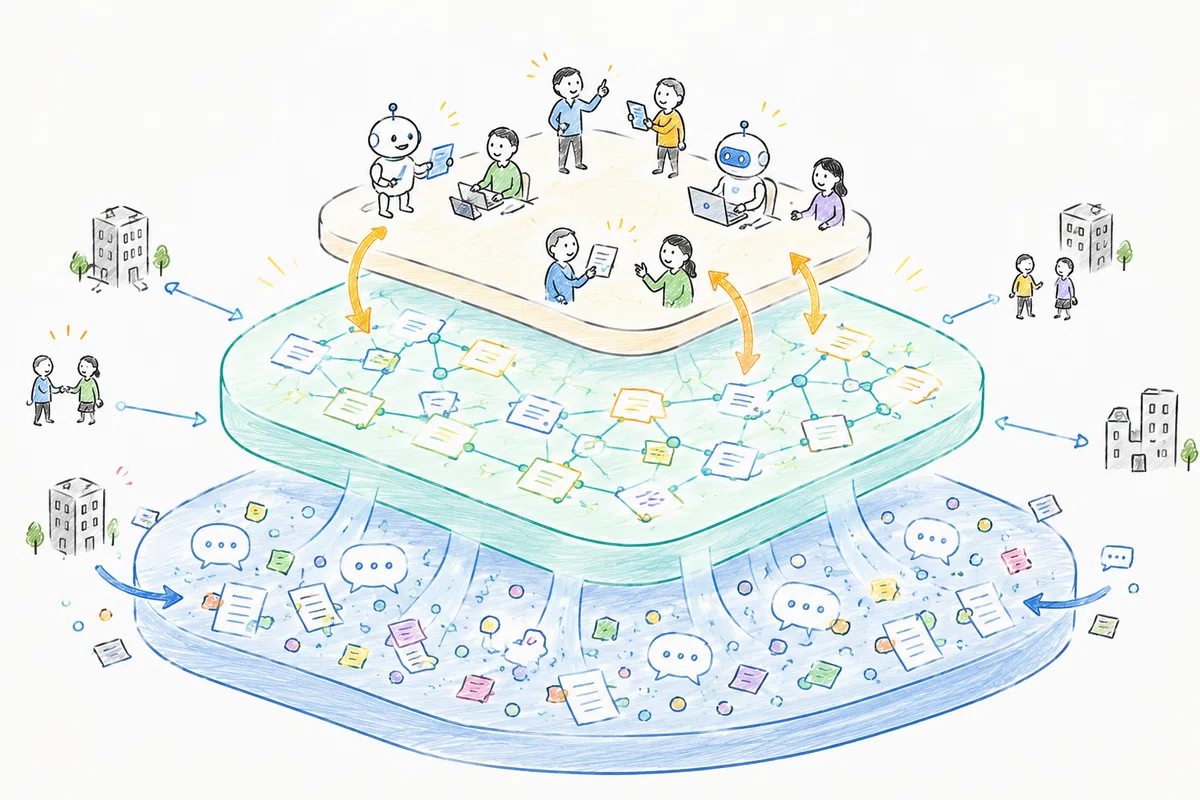
この整理に重ねると、今回の取組みは、会社の様々な生データの上に、「意味づけする」層をオントロジーとして作ったということになります。
次に登るのは、最後のアプリケーション層です。この層では、AI ないし人間は地図を読むだけでなく、地図を通じて業務を実行し、その結果がまた地図に書き戻されます。地図が業務から学び続ける循環です。ここまで来ると、オントロジーは「あると便利な辞書」ではなく、業務のマストハブな基盤になります。
その先で見据えているのは、社内業務の効率化を超えて、オントロジーを事業価値そのものに変換することです。会社の活動は顧客や協力関係にあるステークホルダーがいてはじめて成り立つので、地図に載せる範囲も社内には閉じません。Ubie は医療の会社なので、医療ドメインの構造や暗黙知を地図に載せ、ステークホルダーへの価値提供に還元できる基盤を作ること。そこまで行けば、オントロジーは「会社の OS」と呼べるものになります。
おわりに
オントロジーという言葉は、学術的で難しく聞こえます (実際様々な文脈がある言葉です)。でも、この記事でやったことは単純で「会社の言葉を構造化して AI に持たせた」。それだけです。これが近々すべての事業に必須な資産になりそうです。
始めるハードルは下がりきっています。データマネジメントの形も変わりました。初期構築も保守も、十分に賢くなった AI が実現する時代です。オントロジーをやっていきましょう。
なにかあれば X Mention / DM で教えてください。
追記: 続編はこちら
