[語学の深み]Google翻訳機のバグを利用した不思議な発見!謎のJIS漢字の羅列を他国語から日本語に翻訳したら、平仮名混じりの文とJIS漢字のまんまで翻訳される2パターンで現れた😲その謎を〜深堀り・推測してみた編〜 自由発想21

〜前回の記事はこちら〜
1、はじめに🌏
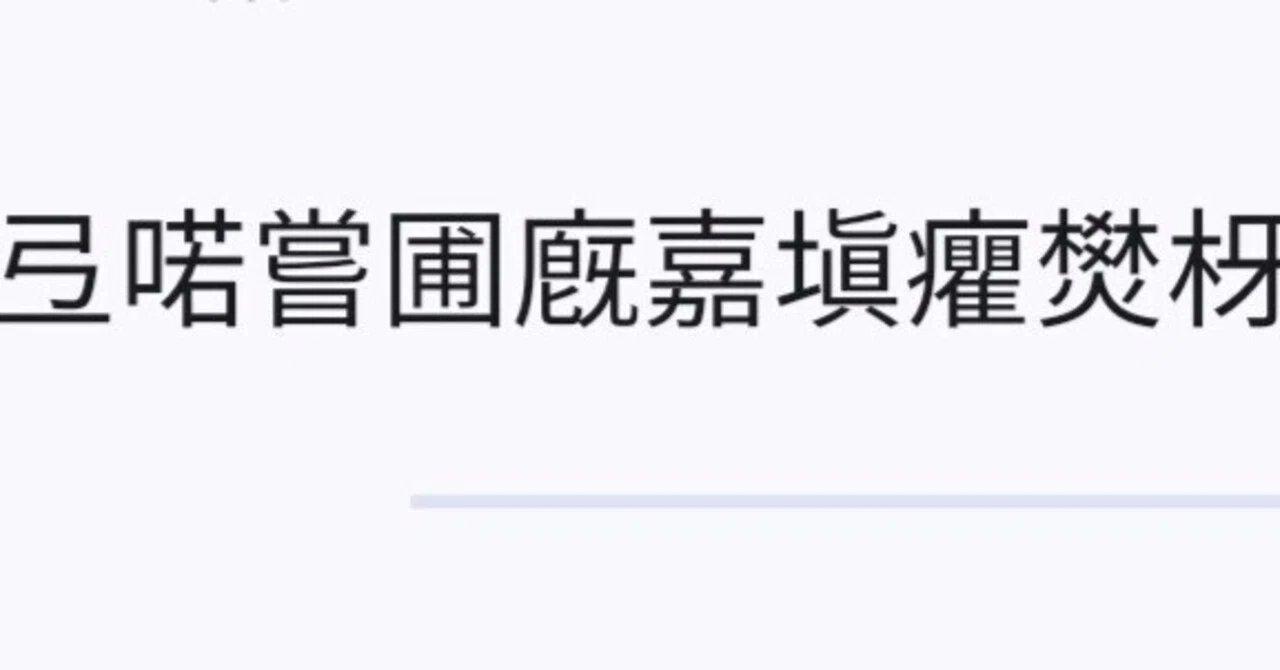
前回の記事で紹介した、謎のJIS漢字の羅列
「弖喏嘗圃廐嘉塡癯燓枒芪胍」 を、
🎀① タイ語やチベット語から日本語に翻訳すると、
なぜか
「世界には美しく美しい木がたくさんあります」
や
「続きを読む」
という平仮名混じりの文が出現しました。
🎀② 英語や中国語、ポルトガル語から日本語に翻訳すると、
なぜかJIS漢字のまんまで出てきました。
そんな疑問を解決すべく、
「なぜこの2パターンになったのか?」を
深掘り・推測していきたいと思います!
2、本編 〜推測編〜 💭
[1]平仮名混じりの文になる場合😲
一言で言うと、
AI翻訳特有の「空気を読みすぎるクセ」
が隠れていると推測します!
①AIのハルシネーション現象✨
Google翻訳などのAIは
入力された文字がどれだけ意味不でも
意味を無理やり解釈しようとします。
タイ語やチベット語のように、
日本語との翻訳データが英語ほど多くない言語ペアでは、
AIが引き出しの少ないヒントから
それっぽい綺麗な文章を捏造してしまうことがあります。
②「世界には美しく美しい木がたくさんあります」の謎🌳
今回並べた漢字をよく見ると、
圃(にわ)、枒(また・木の枝)、芪(くさびら・薬草)など、
自然や植物に関連する漢字が含まれています。
AIがこれらの漢字の部首から、
連想ゲームのように
「木、美しい、たくさんある」という
ワードを繋ぎ合わせ、
一つの文章を生成したのかもしれません。
③「続きを読む」の謎💻
Web上の膨大なデータを学習しているAIが、
よくある「クリックして続きを読む」という定型文を、
データ不足を補うための
デフォルトの回答として出してしまった
バグだと考えられます。
[2]JIS漢字のままの場合👍
一言で言うと、[1]と逆で、
AIがこれまで学習してきたデータの厚みが強く判断力が良いので、勝手に解釈されない
と推測します!
①圧倒的なデータの厚み🌏
英語や中国語は、世界中で使われているため、
翻訳データが桁違いに多いです。
なので、AIは、
「この漢字の羅列は特定の意味を持たない固有名詞、あるいは単なる記号の集まり」
と正確に判断できるため、
変に気を利かせて文章化せず
そのまま出力するを選んだと推測できます。
②中国語における漢字の認識🇨🇳
特に中国語の場合、
AIにとって漢字は日常的な文字です。
たとえ日本のJIS漢字であっても、
AIはそれを文章ではなく、
文字そのものとして処理するため、
勝手に平仮名を混ぜてポエムを作るような
誤作動が起きにくいと考えられます。
3、おわりに👀
翻訳機の裏側に隠れたAIの思考回路を
ちょっとだけ覗き見ることができましたね!(笑)
皆さんも、もし変な翻訳結果を見つけたら、
ぜひコメントで教えてくださいね!
