AI大模型:全网狂热背后的真相揭露!

在聊到AI的时候,我们都离不开“大模型”这三个字。

AI大模型已经完全融入了各个领域,也融入了我们的生活,它好像无所不在、无所不能。

  • 百度李彦宏说:大模型改变世界;
  • 360周鸿祎说:大模型是新时代“发电厂”;
  • 李开复博士说:AI大模型是不能错过的历史机遇;
  • ……

那么,究竟什么是大模型?

今天我想和你深度聊聊,从概念到技术,从发展到未来,讲大模型剖析透彻,更好地看清未来方向。

欢迎和我链接,一起探讨大模型的更多可能性。照例,我准备了一份干货给你:

《中国AI大模型应用研究报告》

为了更快了解你的需求,请WX扫码下方二维码获取资料。(保存图片)

PART.01 大模型究竟是什么,它是否就是AI的代名词?

大模型究竟是什么?它是否就是AI的代名词?

简单来说,你可以理解为大模型是人工智能(AI)领域中的巨型神经网络模型。


它们的作用类似于大脑,可以处理和分析大量数据。

这些模型通过训练过程学习,以执行各种任务,让计算机获得类似人类的“思考”能力。

从而理解、生成例如自然语言处理、图像识别、游戏玩法等等。

下面这张示意图是ChatGPT写给你的,一个通俗的概念。

“投喂”→“产出”


大模型的工作原理就是这样,它接收数据、通过学习提高自身的能力,并执行各种任务以生成有用的结果。

我们都知道ChatGPT,Chat是指聊天,那GPT呢?

G代表生成性(Generative),P代表预训练(Pretrained),T代表模型架构(Transformer)。

这就是大模型的一种,而大模型之所以大,正是因为参数量大,GPT-3的参数量1750亿,GPT-4的参数量达到1.8万亿。

有人把大模型的训练比作是“炼丹”,这个词还挺有灵性的。

我们通过预训练、微调、提示工程、泛化等等一系列动作,处理复杂的任务,用大模型助力我们实现新的突破。

PART.02 2023,大模型元年

不少人称2023年为大模型元年,不管是技术的创新和成熟,还是应用的广泛认知,都可以看出来,AI大模型行业进入了一个新的发展阶段。

从OpenAI推出搭载GPT-3.5的ChatGPT一鸣惊人开始,AI大模型就冲进了我们的生活。

GPT-4和其他高级语言模型,比如文心一言等等大模型的发布,都展示了AI在理解和生成自然语言方面的惊人能力。

这些大模型不仅推动了技术界的发展,也引起了公众的广泛关注。

AI大模型开始在各个行业中发挥越来越重要的作用,包括医疗、教育、金融、娱乐等多个领域。

比如说在我熟悉的教育领域里,AI大模型正在重塑商业模式,创造新的市场机会。


当然,大模型不是在今年才开始运作的,它的发展历程就久远了,基本可以分为三个关键时期:起始期、生长期和爆发期。

第一个是起始期。

AI领域的起始期可以追溯到上世纪50年代和60年代,当时研究人员开始尝试构建智能系统。然而,由于计算能力和数据限制,这些模型相对简单。

后来,随着计算能力的提高和大规模数据集的可用性,AI模型在20世纪末和21世纪初进入了生长期。这一时期出现了一些重要的模型,比如说,深度神经网络。

从去年到今年,可以这么说,AI模型进入了爆发期,这一时期的代表是大规模预训练模型,如GPT-3、BERT和T5等。

这些模型拥有数十亿甚至数百亿的参数,能够执行复杂的自然语言处理和计算任务。

PART.03 国内大模型产业,跟上时代快速爆发

中国也在大模型领域取得了重要进展,有多家知名公司和机构开发了自己的大模型。

从今年3月开始,国内的AI大模型如雨后春笋般涌现。

《中国人工智能大模型地图研究报告》显示,截至2023年5月底,国内10亿级参数规模以上基础大模型至少已发布79个。


不可否认的是,美国在AI大模型上还是属于领头,但中国大模型也实力不可小觑。

从2020年起,中国的大模型进入了高速发展阶段,如今,中美两国大模型的数量占全球大模型数量的近90%,中国大模型数量已进入第一梯队。

国内的一些知名大模型和应用场景可以看看撼地发布的这个数据。


可以看出,国内大模型产业是热闹非凡啊。

这个当下,几乎所有的重要企业和研发机构都在推出大模型,IDC预测,2026年中国AI大模型市场规模将达到211亿美元,人工智能将进入大规模落地应用关键期。

从投资、创业到应用,中国几乎是目前世界上最活跃的市场。

随着核心技术的突破,产业生态的持续完善,利用场景的深化,训练数据的打磨,大模型时代的序幕才刚刚拉开。

PART.04 未来已来,大模型的发展是大势所趋。

未来大模型会进一步影响整个行业。

比如我所在的IT行业里,我们浅谈一下以GPT系列为代表的大模型将如何重塑IT行业的结构。


从基础设施层,云层来说,这一层主要是提供计算能力,包括大量的GPU或XPU。这是大模型运行的基础,也是支撑整个IT行业的核心。

再到IaaS层,是构建更高层服务的基石。提供基础计算、存储、网络、数据和安全服务。

以GPT系列等大模型为代表,MaaS层提供了通用的AI能力,可以被进一步应用于各种特定领域。

而VFM层(垂直基础模型)将通用的大模型应用于特定领域,如自动驾驶、蛋白质解析、气象预报等。这些垂直模型也可以相互结合,形成新的应用。

最上层当然是软件即服务,SaaS层将各种模型和技术融合成具体的应用,如企业软件、消费者应用等。

再到边缘计算和模型部署。

在部署端,比如电话、个人电脑、物联网设备、机器人和智能汽车等,需要将AI模型部署到边缘设备上。这里的关键是模型的大小和速度。在像自动驾驶这样的应用中,模型需要小而快,以实现低延迟和高精度。

以及一些边缘计算的机会:边缘计算、边缘模型、模型交互、联邦学习和小模型的开发是当前和未来的一个重要趋势。

这些技术有助于在设备上更有效地运行AI模型,同时保护隐私和减少对中心云的依赖。


总得来说,大模型将在IT行业中发挥越来越重要的作用,不仅在基础模型层,更在垂直模型和边缘计算层。

这些技术的发展将推动IT行业的结构重塑,同时也带来了新的机会和挑战。

未来,AI大模型也会在医疗、教育、自动驾驶等领域发挥更大的作用,为人类带来更多的便利和进步。

毫无疑问,大模型赋能千行百业将是一场硬仗,自主创新才能真正实现超越,让我们一起期待更广阔的大模型之路。

既然大模型现在这么火热,各行各业都在开发搭建属于自己企业的私有化大模型,那么势必会需要大量大模型人才,同时也会带来大批量的岗位?“雷军曾说过:站在风口,猪都能飞起来”可以说现在大模型就是当下风口,是一个可以改变自身的机会,就看我们能不能抓住了。

那么,我们该如何学习大模型?

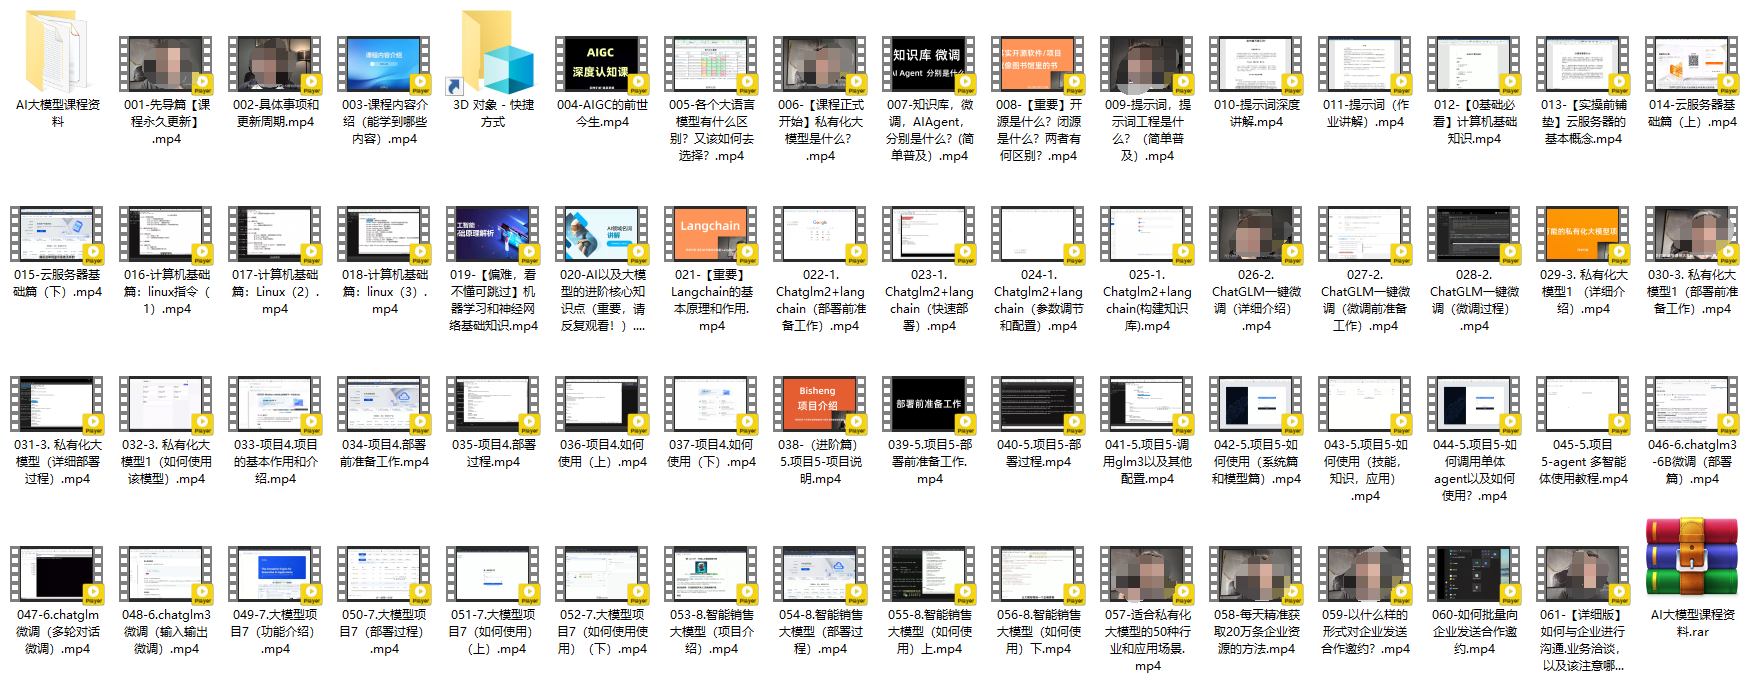
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

一、大模型全套的学习路线

学习大型人工智能模型,如GPT-3、BERT或任何其他先进的神经网络模型,需要系统的方法和持续的努力。既然要系统的学习大模型,那么学习路线是必不可少的,下面的这份路线能帮助你快速梳理知识,形成自己的体系。

L1级别:AI大模型时代的华丽登场

L2级别:AI大模型API应用开发工程

L3级别:大模型应用架构进阶实践

L4级别:大模型微调与私有化部署

一般掌握到第四个级别,市场上大多数岗位都是可以胜任,但要还不是天花板,天花板级别要求更加严格,对于算法和实战是非常苛刻的。建议普通人掌握到L4级别即可。

以上的AI大模型学习路线,不知道为什么发出来就有点糊,高清版可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

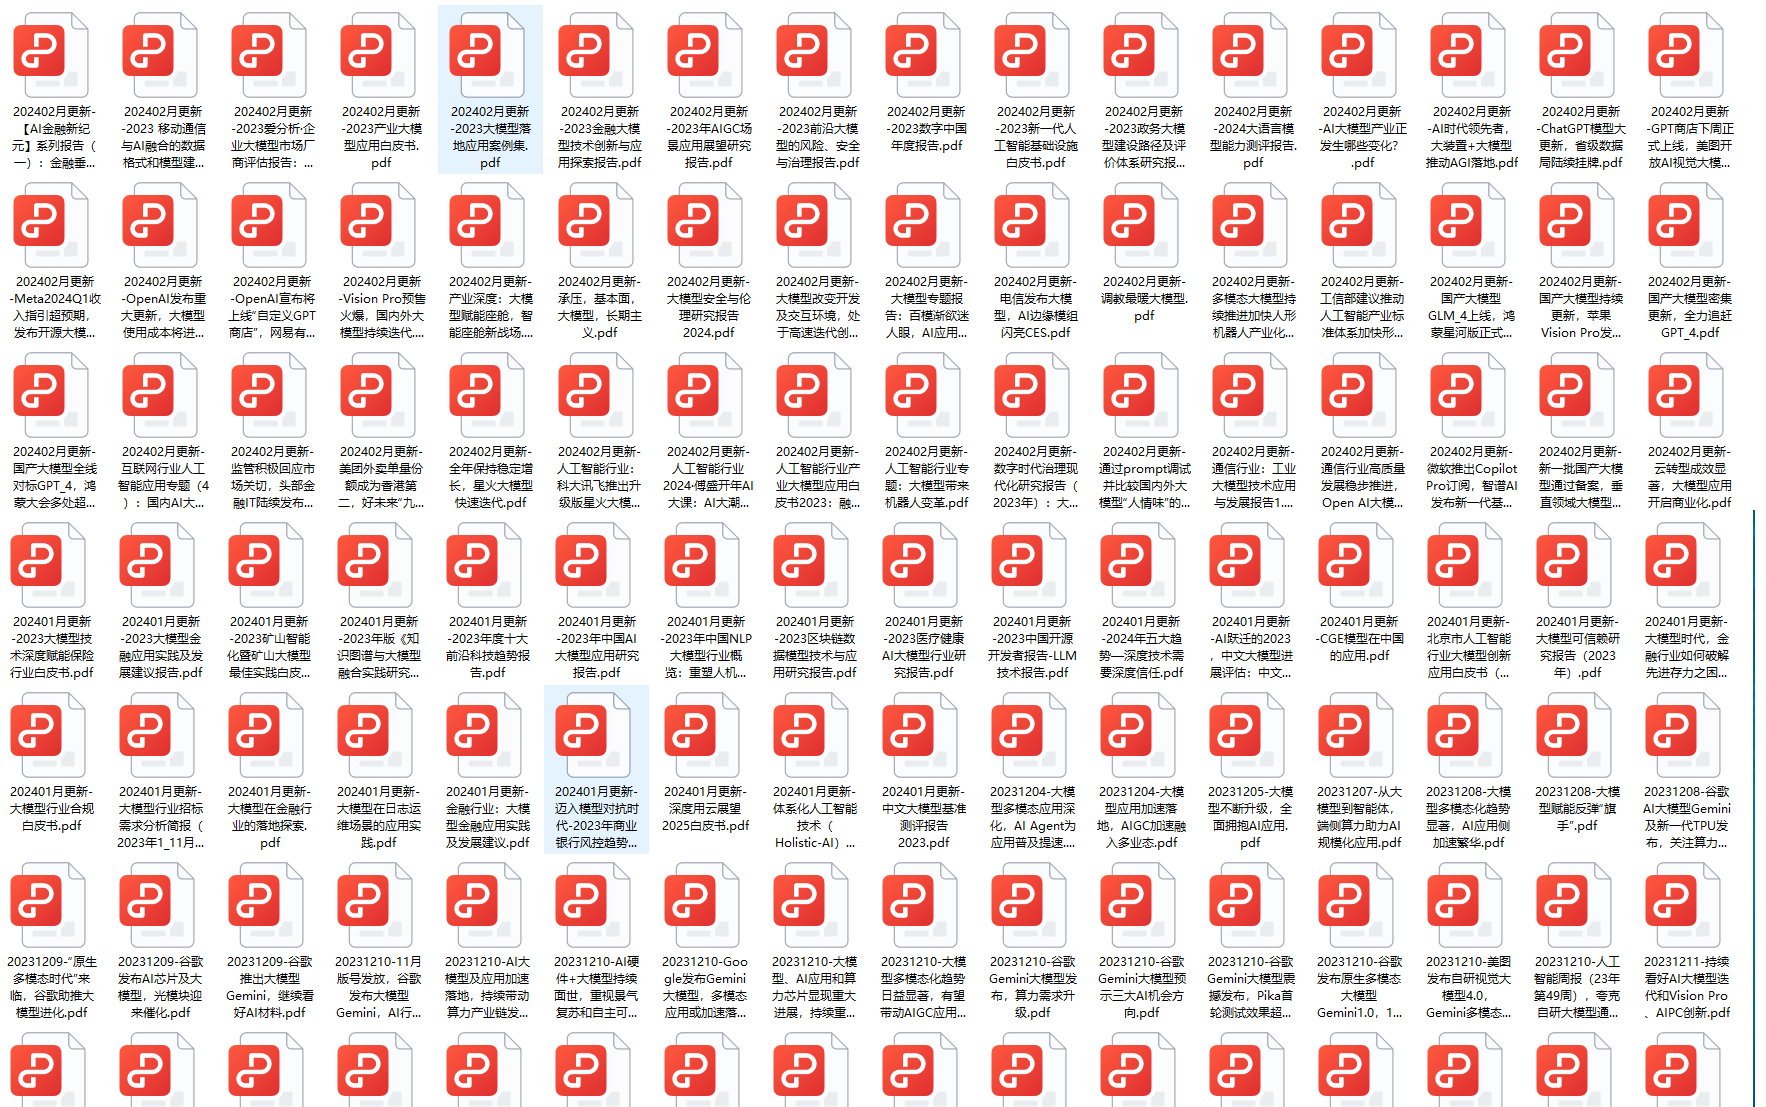
二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

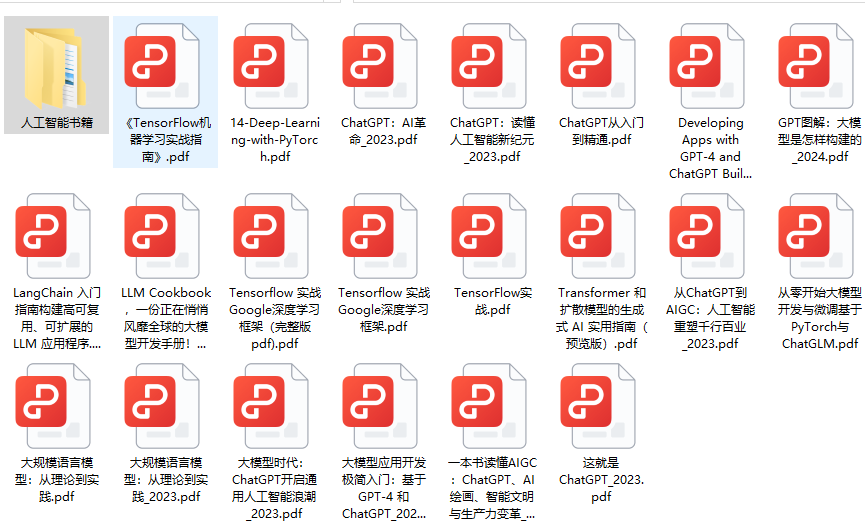
三、大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

相关推荐

2025 年就业竞争激烈!当1222 万毕业生遭遇 “35 岁门槛” 与 AI 革命的双重冲击

2025 年就业竞争激烈!当1222 万毕业生遭遇 “35 岁门槛” 与 AI 革命的双重冲击

EnjoyEDU的博客 6万+

狠狠收藏!关于Deepseek,看这一篇就足够了

最近,AI界黑马DeepSeek爆火。AI圈、科技博主、职场人,甚至连朋友圈的宝妈群都在聊——“DeepSeek太强了!”“国产GPT之光!”“中文能力碾压!但Deepseek这个名词对部分人来说还比较陌生,怎么高效使用也是一个未知数,今天,就让我们一起走进DeepSeek的世界,看看它到底有多厉害!顺便再给你个DeepSeek万能使用模板,让你彻底摆脱提示词焦虑,让AI真正成为你的“最强大脑”!

EnjoyEDU的博客 2万+

从零到手搓一个Agent:AI Agents新手入门精通

Agents 代表着生成式AI模型的进阶形态,它们拥有自主行动能力,能够利用工具与外界交互,并根据目标进行决策,具有更广泛的应用范围和更强大的能力。随着技术的不断发展,Agents 将会改变我们的生活和工作方式,并推动人工智能进入新的发展阶段。未来,Agent 将成为人工智能发展的重要方向,为我们带来更智能、更便捷的未来。

EnjoyEDU的博客 1万+

前端工程师3-6个月大模型学习路线:收藏这份系统化进阶指南,轻松上手AI Agent开发

本文为前端工程师量身定制了一份3-6个月的AI Agent学习路线,结合前端背景,逐步深入AI基础、Prompt工程、LangChain.js、RAG、工具调用等核心技术,通过6个实战项目帮助读者快速掌握大模型开发,并推荐Vercel AI SDK作为首选工具,辅以免费核心课程和练习平台,助力前端工程师顺利转型AI Agent开发领域。这是一份为期 3-6 个月 的系统性学习路线,结合你前端工程师的背景,最大化利用已有经验,降低学习曲线。

EnjoyEDU的博客 18

每天推荐一个最值得用的AI开源项目:CrewAI,让AI协作像管理团队一样简单

crewAI 是 Python 写的多 Agent 编排框架,核心就一个心智模型:角色扮演。你给每个 Agent 写清楚它是谁、要达成什么、有什么背景,再给它分任务,它就会像团队里的一员那样干活。和写一堆 if-else 或者硬啃 LangGraph 的图编排比起来,crewAI的门槛低到会写人物设定就能上手。

EnjoyEDU的博客 19

FDE月薪7万还招不到?收藏这份AI落地工程师(FDE)学习指南,抢占高薪风口!

本文介绍了FDE(前线部署工程师)这一新兴高薪岗位,作为连接AI模型与企业实际应用的桥梁,FDE负责将AI技术落地到各行各业。文章指出,FDE薪资高达百万,人才需求激增,是AI领域的重要就业方向。对于想进入AI领域的程序员或小白,学习FDE相关技能将是一个难得的机遇。一个 2023 年还极其小众的岗位,2026 年变成了 AI 时代最贵的人头:FDE,前线部署工程师。大模型公司百万年薪开抢,不是因为它稀罕,是因为"把 AI 用起来"这件事,比"把模型训出来"更难赚钱。

EnjoyEDU的博客 56

前端工程师转型AI Agent:收藏这份学习路线,轻松掌握大模型开发

前端工程师适合转向 AI Agent 开发,并不是因为这条路没有门槛,而是因为已有能力与 Agent 系统存在大量可迁移的连接点:API 经验有助于接入模型和工具。异步经验有助于理解并发任务与流式执行。状态管理经验有助于设计 Agent Workflow。SSE、WebSocket 和事件驱动经验有助于呈现执行过程。UI 与产品经验有助于构建真正可用的 Agent 交互。

EnjoyEDU的博客 113

小白程序员快速入门大模型:从Token到Workspace Agent全解析

很多人第一次接触 AI是从 ChatGPT开始的:你输入一句话,它就能写文章、写代码。但如果往底层看,其实 AI并不是像人一样直接阅读一整篇文章。它会先把你输入的内容拆成一个个更小的信息单位,这个单位就叫Token(令牌)。举个简单例子:你输入”我喜欢人工智能”,在模型眼里,它可能不是一整句话,而是被拆成”我 /喜欢 /人工智能”。不同模型的拆分方式不完全一样,有时候一个中文词会被拆成几个Token,有时候一个英文单词也可能被拆成几段。

EnjoyEDU的博客 40

小白程序员必看:收藏这份RAG实战指南,轻松构建知识问答系统

最后,分享一个在众多项目中验证过的RAG系统迭代路径:1、MVP阶段:固定分块 + 单路向量检索 + 基础Prompt → 快速验证可行性2、优化阶段:调优分块策略 + 混合检索 + Reranker → 提升检索准确率3、进阶阶段:查询改写 + Agentic RAG + GraphRAG → 处理复杂场景4、生产阶段:缓存优化 + 监控告警 + A/B测试 + 持续迭代 → 稳定运行RAG不是一个一次性的工程,而是一个需要持续打磨的系统。

EnjoyEDU的博客 430

小白程序员必备:这份由浅入深的大模型学习路线,助你轻松入门并收藏起来!

学习大模型往往容易陷入啃论文和堆资料的误区,导致学习混乱。本文提供了一份循序渐进的学习路线图,帮助初学者有效避开无效内卷,逐步掌握大模型技术。很多人学大模型一上来就啃论文、堆资料,越学越乱,踩满坑。这份由浅入深学习路线,帮你避开无效内卷,循序渐进入门大模型。

EnjoyEDU的博客 501

金融小白必看!大模型如何改变金融业,收藏这份 Agent 学习指南

金融业正成为 Agent 落地的热门领域,大模型厂商、云厂商和金融科技公司纷纷入局。文章探讨了金融业为何成为 Agent 落地的理想试验场,分析了不同类型机构在 Agent 发展中的路线,并指出 Agent 落地金融正处于一个微妙的临界点,未来金融的风控范式将外溢到更多行业。未来,这套机制可以毫不费力地下沉到自动驾驶的调度计费、智能制造的供应链自动采购、乃至智能政务的资金划拨之中。

EnjoyEDU的博客 323

新手程序员必看:如何用缓存技术提升大模型推理效率,降低成本

本文深入探讨了在部署大模型时,如何通过缓存技术优化推理性能。文章首先介绍了KV Cache的概念及其在减少重复计算和首字等待时间中的作用,随后详细阐述了Prompt Cache的优缺点和使用场景。接着,文章重点介绍了LMCache的设计理念,它将KV Cache从推理进程拆分出来,形成共享、分级的缓存服务,有效解决了显存压力和跨进程调度问题。最后,文章提供了实用的上线检查单,帮助开发者评估是否需要引入缓存技术,以及如何优化缓存策略。

EnjoyEDU的博客 350

小白逆袭:3个月从终端小白到大模型高手,收藏这转型秘籍!

本文讲述了一位程序员从连终端都害怕的新手,到三个月后能熟练谈论大模型技术的转变过程。文章强调了持续学习和实践的重要性,通过观看、分析和模仿专业视频,不断拓展知识边界。最终,他成功转型,展现出在大模型领域的专业能力。对于想要学习大模型的小白或程序员来说,这是一个鼓舞人心的案例,提醒大家只要有决心和毅力,就能够实现技能的飞跃。三个月前,他连终端黑屏都怕。三个月后,宇树的面试官推了推眼镜,把“你凭什么”咽了回去。

EnjoyEDU的博客 455

小白程序员必备:轻松入门AI Agent开发,大厂校招岗位速通指南

循环、分支、多智能体分工问题。

EnjoyEDU的博客 297

小白程序员必备:2026大厂AI人才抢夺战,你准备好了吗?

文章指出,科技大厂校招正转向AI领域,AI算法、全栈及Agent工程师需求激增。企业内部也在推动AI能力认证和全员AI化培训。AI人才被分为三层:底层技术人才、应用开发人才和业务效能人才。普通职场人应积极学习AI工具,提升业务效能,在AI协作中展现价值,以应对外部替代和内部竞争压力。关键在于实践应用AI工具,取得可量化的业务成果,并更新个人AI技能标签,以被招聘市场识别。先跑起来的人,会先被看到。明年,很多科技大厂就只招AI人才了?!

EnjoyEDU的博客 295

小白程序员轻松入门大模型:手把手教你用ReAct模式打造AI工具Agent

本文介绍了Agent设计中的ReAct、Plan-and-Execute、Reflection三种模式,通过漫剧Agent实例讲解了ReAct模式的实现原理。重点解析了ReAct循环的Thought、Action、Observation执行过程,并分享了System Prompt约束、最大步数控制、异步执行等工程细节。文章还介绍了Plan-and-Execute和Reflection模式的理论要点及适用场景,最后总结三种模式的区别和选择方法,适合AI初学者学习大模型应用开发。一、三种设计模式速览真实项目中经

EnjoyEDU的博客 139

大模型 Agent 架构选型指南:ReAct vs Plan-and-Execute,小白程序员必看

综合上述,任何一个业务系统从来不会是只有一种解决方案,也没有最完美的解决方案,更不会是非此即彼的解决方案。需要根据业务类型选择最适配的方案。以后再遇到有人说应该选 ReAct 还是 Plan-To-Execute 时,你可以根据这篇文章的思想好好跟他掰扯掰扯了。

EnjoyEDU的博客 531

2027届LLM与Agent岗位求职指南:收藏这份硬核准备路线图!

1068份JD看下来,2027届大模型校招并没有一扇只认论文的窄门。研究岗看论文与实验,应用岗看项目与交付,平台岗看系统与可靠性,Infra看底层与性能。路不止一条,怕的是站在路口,把每块牌子都抄进简历,却一步也没走深。先选路。再做项目。拿结果说话。这比攒一串新名词,管用得多。

EnjoyEDU的博客 394

6年Java转AI涨薪40%?淘汰你的从来不是AI,是公司方向

文章指出淘汰你的不是AI,而是公司战略方向。通过案例对比,掌握AI应用能力的Java工程师更具竞争力,传统后端经验是AI落地的护城河。建议程序员边工作边转型,积累可部署项目经验,警惕假转型公司,AI是放大器而非替代品。最近在知乎刷到一个帖子,看完心里挺不是滋味的。帖主是个干了6年Java的后端,去年公司开全员大会,宣布All in AI,点名让他转Python。他咬咬牙转了,同期一位同事选择跳槽,去了另一家继续写老本行的公司,临走前还劝他,说放着安稳日子不过,去折腾什么AI,疯了。

EnjoyEDU的博客 248

AI、大模型、智能体到底啥关系?别再被黑话绕晕了,程序员小白必看

概念是嵌套的,不是并列的;大模型在做的是预测下一个词;智能体是一种使用方式,不是一种新模型;选对场景比选对模型重要得多。技术会一直变,但我们要与时俱进。这比记住任何一个具体名词都有用。

EnjoyEDU的博客 259

前端工程师的转型之路:收藏!从AI冲击中突围,成为炙手可热的AI工程师

如果今天有一个前端工程师来问我,我很焦虑,我该怎么转。我会给他一个非常具体的回答。第一,先停止把全栈当终点,把 AI 工程师当方向。第二,别先去卷 Go、Java 语法,先补数据库、服务端认知、系统设计、部署和排错这些骨架。第三,马上开始做一个真正能上线的产品,不要继续停在教程里。第四,整个过程都用 AI First 的方式去推进,遇到问题先问 AI,遇到重复劳动先问能不能交给 Agent,别等准备完。

EnjoyEDU的博客 621

小白程序员必备:收藏这份 Agent 图编排指南,轻松玩转大模型任务流

本文深入浅出地介绍了 Agent 图编排的核心概念与实现方式,帮助初学者理解如何通过图结构优化 Agent 任务流设计。文章重点阐述了节点与边的设计原则、数据流优化方法,并探讨了并行处理、故障隔离、验证机制等关键技巧。通过学习本文,读者能掌握如何根据真实任务数据流重构 Agent 流程,提升系统效率与稳定性,是程序员进阶大模型应用开发不可多得的实践指南。很多人第一次设计多步 Agent 时,都会自然地写成一条串行流水线:A → B → C → D。

EnjoyEDU的博客 614

3年Java开发,学历还行。后面是建议转agent还是继续干Java?现在Ai Coding率都要90%以上了。

java还是agent3年java开发,学历还行。后面是建议转agent还是继续干java?现在aicoding率都要90%以上了。有没有有经验的老哥来分享一下。1、先搞清楚:Agent到底是什么“你知道什么是Agent吗,有多少需求”。现在网上一提Agent,好像明天全世界都要招Agent工程师了。但实际上,真正把Agent做成独立业务、大规模招人的公司,掰着手指头数得过来。大部分公司所谓的"Agent开发",不过是给现有业务套个AI壳子,让大模型调调API、写写文案、做做推荐。

EnjoyEDU的博客 379

35岁程序员转行大模型:收藏这份实战指南,开启高薪新机遇!

35岁转行大模型,看似危机,实则是职业生涯的重要转机。技术变革期往往是重新洗牌的机会,资深程序员凭借丰富的经验和快速学习能力,完全可以在新领域建立竞争优势。大模型技术仍处于早期阶段,就像2000年代的互联网和2010年代的移动互联网,未来还有巨大的发展空间和可能性。现在入局,不仅能抓住当前的技术红利,更能为未来十年的职业生涯奠定基础。转型之路不会一帆风顺,需要克服学习曲线、适应新思维模式、可能还会面临短期薪资调整。但长远来看,掌握大模型技术将成为软件工程师的核心竞争力,这种投资终将获得丰厚回报。

EnjoyEDU的博客 342

大厂校招薪资揭秘:前端、AI、测开方向薪资大盘点,小白必看!

固定现金:每月多少,保证发几个月,首年怎么折算。浮动收入:年终和绩效的条件是什么,像京东那种「70% 能拿满」的说法要问清楚。额外奖励:签字费何时发、有无返还条件,像百度那样分 2 年发的要单独算;股票分几年归属。实际工作:做什么、在哪做,岗位内容是不是自己想积累的方向。

EnjoyEDU的博客 341

小白程序员必看:轻松掌握Multi-Agent协作,让大模型为你所用

Multi-Agent 就是"多个 Agent 协作"。一个 Agent 能力有限,但多个 Agent 分工协作,就能做更复杂的事。就像一个团队,每个人做自己擅长的事,最后集成起来。Multi-Agent 有几种协作模式:主从模式、流水线模式、对等模式、辩论模式。但它也有很多挑战:协调成本、通信开销、一致性问题、错误传播、调试困难。

EnjoyEDU的博客 350

Java程序员收藏:2026年这4条赛道让你越老越吃香,轻松绕开35岁危机!

本文针对Java程序员在AI时代面临的挑战,提出转型方案。文章指出,AI能替代简单CRUD工作,但复合能力依然稀缺。建议Java程序员向AI业务集成、信创国产化、云原生/平台化、垂直行业等方向转型,提升自身竞争力,避免35岁危机。强调工龄不如能力,要拥抱变化,持续学习。很多人突然醒悟:自己干了五六年、十年,好像一直在重复同一件事。以前以为是行业太累,现在才发现:不是你不努力,是时代不需要只会CRUD的程序员了。但我想说一句大实话:Java没有凉,凉的是单一业务搬运工。

EnjoyEDU的博客 325

掌握这4种“大模型推理范式“,让AI正确率飙升十几倍(小白程序员必看)

CoT —— 一支笔。让它把草稿写出来,中间结果就成了可见输入。ReAct —— 一部电话。让它能在推理中途打给外部世界,把事实取回来。ToT —— 一张可擦的草稿纸。允许它同时想几个方向,允许它擦掉重来。结构化输出——一张标准表格。让它写在格子里,你的程序才接得住。推理范式的升级,从来不是"让模型变聪明",而是让它的推理过程获得默认状态下没有的东西:草稿、事实、回溯,和约束。落地顺序也就很清楚了:先用一句"让我们一步步思考"试试——它一分钱不花,却能让同一个模型的正确率翻好几倍。

EnjoyEDU的博客 281

程序员如何从零开始学习大模型,掌握AI全栈开发技能

前端没有因为 AI 消失,变窄的是过去那种只盯页面和接口的职责边界。Next.js 给 Coding Agent 补AGENTS.md和运行时可见性,支付宝把 Skills 放进接入链路,说明 Agent 已经进了正式交付,而不只是个人提效工具。转 AI 全栈别一上来堆框架。先把 Coding Agent 用进真实项目,规则和 Skills 写清楚,再补后端。语言选 Node 还是别的不重要,HTTP、鉴权、数据库、缓存、任务、部署这些工程问题逃不掉。

EnjoyEDU的博客 134

企业接入大模型,数据对不上?收藏这份数据准备指南,轻松搞定!

企业大模型要真正发挥价值,离不开准确、统一、可信的数据基础。主数据统一业务对象,元数据解释数据含义,参考数据统一分类规则。三者共同决定了企业交给AI的数据能否被准确识别、理解和关联。FineDataLink 这类数据集成工具,可以帮助企业将这些规则落实到数据接入、清洗、加工和流转过程中,为后续AI应用提供更可靠的数据基础。大模型能把数据用得多聪明,首先取决于企业能不能把数据管理清楚。在急着选模型、建知识库、开发智能体之前,先把这三类数据理顺,往往能让后面的AI建设少走不少弯路。

EnjoyEDU的博客 503
上一篇: 文心一言、Kimi等4款AI大模型测评对比及推荐(AI大模型训练)
下一篇: 7月,一个新方向爆了,70k很稳......
大模型.
博客等级 码龄7年 1万+粉丝 2363原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值