


摘要:网站崩溃从来不是单一原因。根据公开研究和行业报告,流量过载、代码变更、数据库瓶颈、第三方依赖故障、DDoS 攻击、DNS/CDN 异常、基础设施故障和前端问题是最常见的八类根因。每一类故障在监控数据上都有可识别的特征,掌握这些特征,能把平均定位时间从小时级压缩到分钟级。
凌晨两点,监控群突然刷屏:“网站打不开了。” 运维同学打开电脑,面前是几十个指标图表,却不知道该先看哪一个。
这是很多人的真实场景。网站崩溃本身不可怕,可怕的是不知道崩在哪里。本文把常见的崩溃原因归纳为八类,并给出每一类在数据上的典型表现,帮助你下一次遇到事故时,能更快找到突破口。
一、网站崩溃到底有多贵?先看几组公开数据
在聊技术之前,有必要理解为什么这件事值得认真对待。根据 Splunk 与 Oxford Economics 联合发布的《2025 全球可观测性报告》(基于 Global 2000 企业数据),大型企业每年因系统宕机造成的损失已高达4000 亿美元,相当于这部分企业总利润的约 9%。
Uptime Institute 2024 年的调研则给出了更直观的单位成本:平均每次 IT 宕机的成本达到每分钟 14,056 美元,大型企业可超过每分钟 23,000 美元;93% 的企业报告单次事故小时级损失超过 30 万美元。
| 可用性目标 | 允许年停机时间 | 适用场景 |
|---|---|---|
| 99.9%(三个 9) | 约 8.76 小时 | 一般商业网站、企业应用 |
| 99.99%(四个 9) | 约 52.56 分钟 | 支付、核心 API、基础设施 |
| 99.999%(五个 9) | 约 5.26 分钟 | 金融核心、医疗关键系统 |
数据来源:Cloudflare 可用性文档、Google SRE Book(2016)
Google 在《Site Reliability Engineering》(2016)中提出的 Error Budget 概念,本质上是把可用性转化为“可接受的失败额度”。例如 99.9% 的可用性目标意味着 0.1% 的 Error Budget,一旦用完,就该暂停发布、优先做稳定性工作。
二、八类常见故障与它们的数据特征
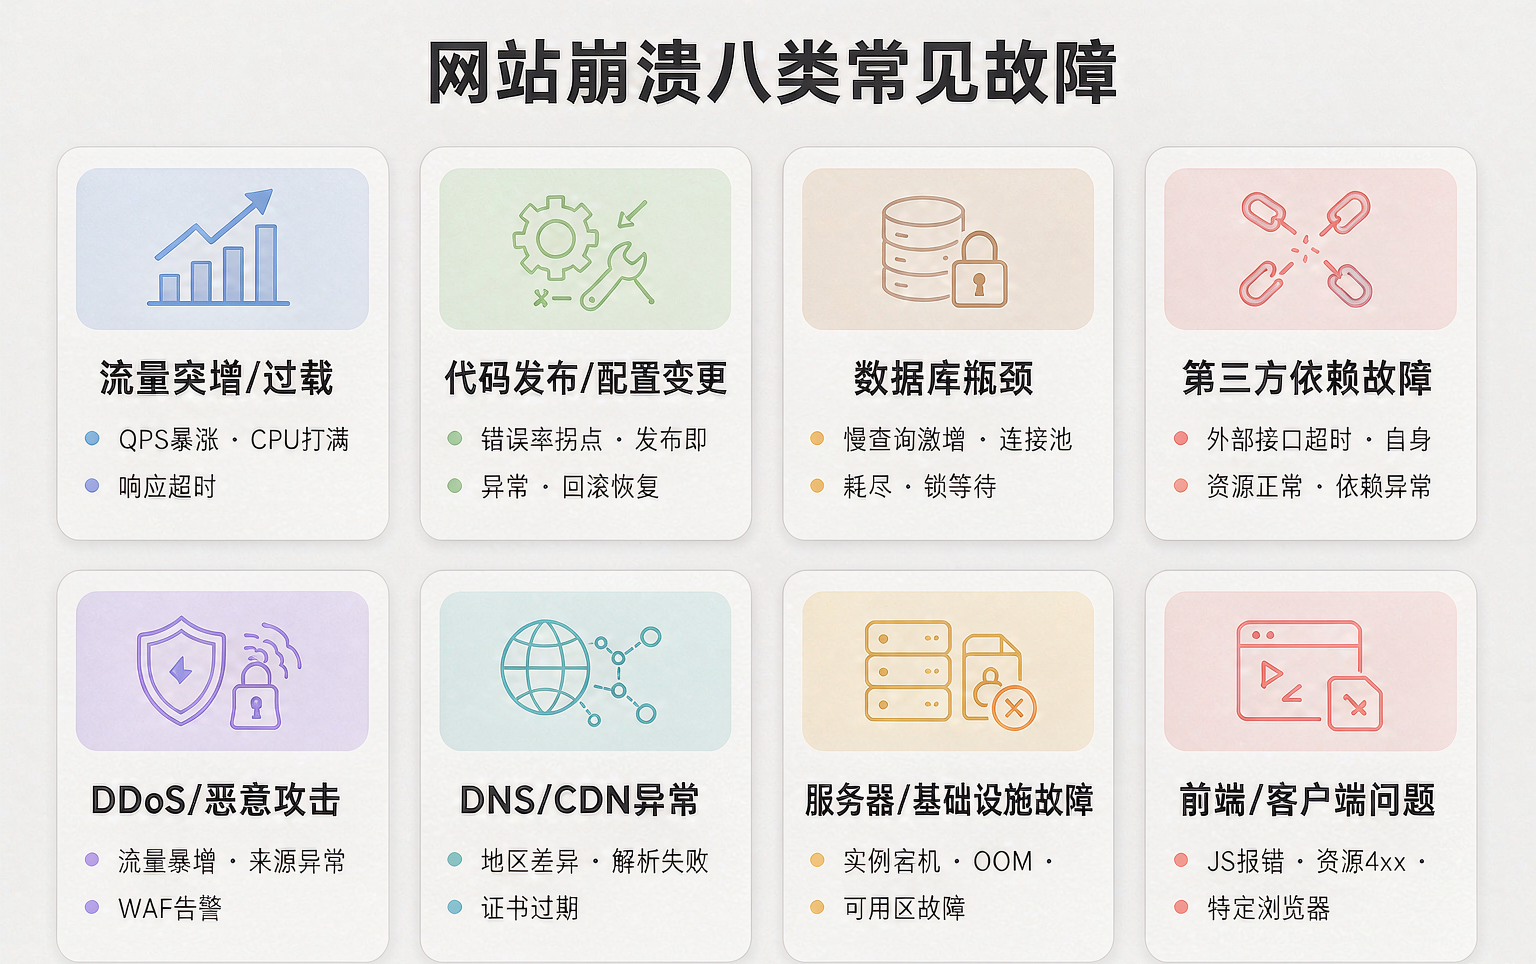
下面八类故障覆盖了绝大多数线上事故。每一类都给出了“典型现象 + 关键指标 + 数据特征”,方便你结合监控快速判断。
1. 流量突增 / 系统过载
典型现象:访问正常,突然请求量暴涨,响应变慢直至超时,随后部分服务无响应。
关键指标与数据特征:
- QPS/TPS 在短时间内上升至平时的 3~10 倍甚至更高
- CPU、内存、网络带宽接近或达到 100%
- 响应时间 P99 从数百毫秒激增至数秒或超时
- 错误率(5xx)在达到容量上限后陡增
- 连接数、线程池、队列长度持续堆积
常见触发:营销活动、热点事件、秒杀、社交媒体引流、爬虫或异常抓取。
排查经验:先看 QPS 曲线和 CPU/内存曲线是否同步上涨。如果只是 QPS 涨而资源没涨,可能是某条链路阻塞;如果资源先打满,说明是容量不足。
2. 代码发布 / 配置变更
典型现象:发布后不久出现错误率上升,或者部分功能不可用。
关键指标与数据特征:
- 错误率在发布时间点前后出现明显拐点
- 特定接口或页面的 5xx/4xx 错误集中爆发
- 应用日志中出现新类型的异常堆栈
- 如果配置变更出错,可能出现参数解析失败、路由异常、限流策略突变
- 回滚后指标迅速恢复是最直接的验证信号
注意:根据 Cockroach Labs《State of Resilience 2025》对 1000 名技术高管的调研,58% 的故障是因为员工没有遵循既定变更流程,比去年上升了 10 个百分点。变更管理仍然是事故高发区。
3. 数据库瓶颈
典型现象:网站能打开,但涉及查询、登录、下单等操作极慢或直接失败。
关键指标与数据特征:
- 数据库 CPU 或 IOPS 打满
- 慢查询数量激增,SQL 执行时间 P99 明显拉长
- 连接池耗尽,应用出现“too many connections”类错误
- 锁等待、死锁数量上升
- 主从延迟增大(读写分离架构下)
常见触发:缺少索引的慢 SQL、大表扫描、突发写入、未做读写分离、长事务未提交。
4. 第三方依赖故障
典型现象:自家服务正常,但调用外部接口时失败,导致页面缺数据或流程中断。
关键指标与数据特征:
- 外部接口调用超时率、错误率上升
- 自家服务响应时间被拉长,但 CPU/内存正常
- 下游依赖的状态码或响应体异常
- 多个依赖同时受影响时,可能是中间网络或公网问题
风险提示:Catchpoint《2025 互联网弹性报告》显示,74% 的企业将第三方服务视为韧性策略中的关键依赖,但仍有大量团队对这些外部依赖缺乏有效监控。这是现代架构中最大的盲点之一。
5. DDoS / 恶意攻击
典型现象:网站突然变慢或完全不可用,流量来源异常分散。
关键指标与数据特征:
- 入站流量在短时间内达到平时的数倍甚至数十倍
- 大量请求来自相同 User-Agent、相同 IP 段或异常地理分布
- 请求路径集中在少数接口,或全是静态资源
- 正常用户转化率、登录成功率急剧下降
- WAF/防火墙拦截日志数量陡增
根据绿盟科技《2025 DDoS 攻击威胁报告》,2025 年超 500Gbps 的 DDoS 攻击事件数量较 2024 年增长 115.72%,单次攻击最高峰值达到 2.6Tbps。Cloudflare 也在 2025 年报告了峰值为 29.7Tbps 的 DDoS 攻击缓解记录。
6. DNS / CDN 异常
典型现象:部分地区用户访问不了,或者解析到错误 IP;全球用户同时受影响通常是 DNS 或 CDN 问题。
关键指标与数据特征:
- DNS 解析失败率、解析超时率上升
- 不同地区/运营商的可用性出现明显差异
- CDN 缓存命中率异常下降,回源流量激增
- 证书过期会导致 HTTPS 握手失败,错误集中在 TLS 层
- dig / nslookup 等工具可复现解析异常
2021 年 Facebook 长达 6 小时的大规模宕机,根因就是一次 BGP 维护命令误操作导致 DNS 路由被撤销。当 DNS 失效时,依赖它的所有服务都会连锁失败。
7. 服务器 / 基础设施故障
典型现象:服务直接不可用,错误率 100%,日志停止输出或出现硬件级告警。
关键指标与数据特征:
- 实例状态变为 unhealthy 或 terminated
- 磁盘 I/O 异常、内存 OOM、CPU 突然归零
- 云厂商控制台出现可用区故障公告
- 容器或 Pod 频繁重启(CrashLoopBackOff)
- 网络丢包率、延迟异常
8. 前端 / 客户端问题
典型现象:接口返回正常,但页面白屏、按钮点不动、资源加载失败。
关键指标与数据特征:
- JS 报错量激增,特别是 SyntaxError、TypeError
- 静态资源 4xx 错误上升(通常是路径或构建问题)
- 页面加载时间(FCP/LCP)显著变长
- 特定浏览器或设备版本报错集中
- API 响应正常,但前端未正确处理
前端问题容易被后端同学忽略,但对用户体验的伤害同样直接。Catchpoint 在 2025 年报告中发现,73% 的企业认为快速、高性能的网站对业务成功至关重要,42% 认为慢服务“基本等同于宕机”。
三、如何通过数据快速定位故障?
事故发生后,最宝贵的不是工具,而是“先看什么、后看什么”的判断顺序。推荐一个四层定位法:
| 层级 | 先看什么 | 判断什么 |
|---|---|---|
| 第一层:用户侧 | 可用性探测、RUM 数据、错误页面截图 | 是真崩了,还是部分用户/地区异常? |
| 第二层:入口层 | DNS、CDN、负载均衡、WAF | 流量有没有进来?有没有被拦截? |
| 第三层:应用层 | QPS、错误率、响应时间、JVM/容器指标 | 服务本身是否正常处理请求? |
| 第四层:依赖层 | 数据库、缓存、消息队列、第三方接口 | 问题是不是出在外部依赖? |
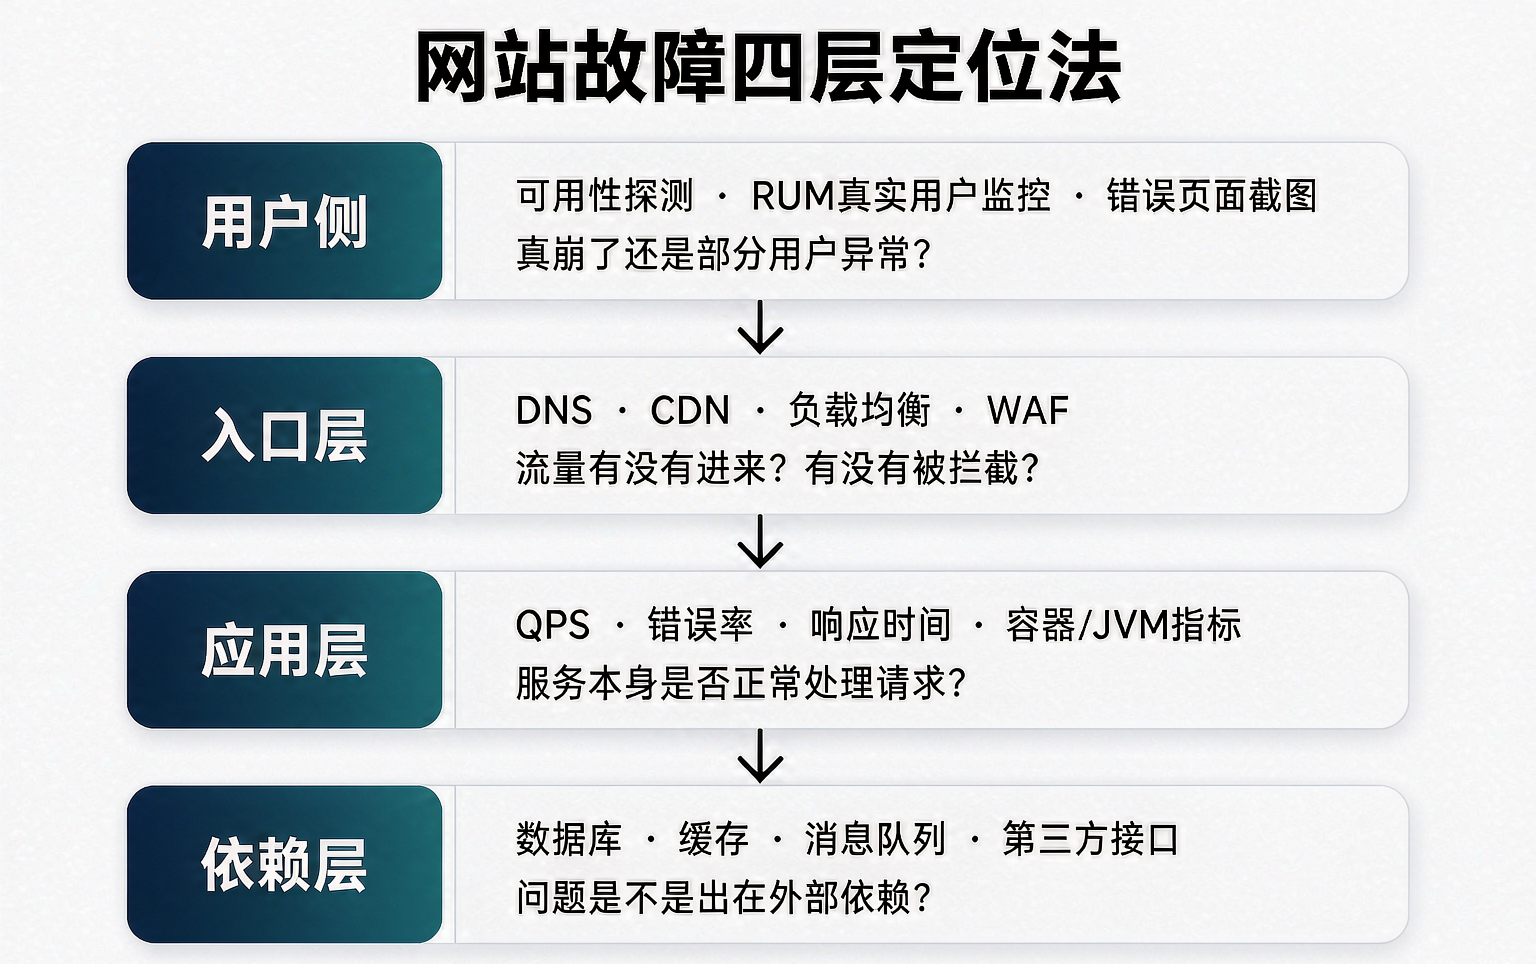
一个实用原则:如果“入口层正常、应用层异常”,先看发布和配置变更;如果“入口层正常、应用层也正常、依赖层异常”,先查数据库和第三方接口;如果“入口层就异常”,先看 DNS 和 CDN。
四、监控体系建设与工具选型
想要快速定位问题,前提是监控覆盖到位。一个完整的网站监控体系至少应包括:
- 可用性监控:从多地域、多运营商定时探测站点可用性
- 性能监控(RUM):采集真实用户的页面加载、交互、卡顿数据
- 应用监控(APM):追踪接口响应时间、错误率、调用链
- 基础设施监控:CPU、内存、磁盘、网络、容器状态
- 日志与事件:应用日志、访问日志、变更事件统一关联
在选型时,可以优先考虑能够将“业务数据”与“性能数据”打通的平台。例如 456 数据提供的前端性能监控能力,就是从用户端进行体验性能分析,帮助定位卡顿、报错、接口超时等问题;其网站分析能力则可统计访客来源、页面访问和转化数据。对于中小团队,免费版提供 100 万 PV/年的基础额度,可以作为入门方案评估。
选型提醒:没有一款工具能覆盖所有场景。建议先补齐“用户侧可用性探测 + 应用层错误率/响应时间 + 数据库/第三方依赖监控”这三块,再逐步扩展前端性能和链路追踪。
三个常见踩坑记录
坑 1:只看平均响应时间
平均响应时间很容易被长尾请求拉平。真正反映用户体验的是 P95/P99 分位数。一次事故中,P99 可能已经从 200ms 涨到 8s,但平均值只从 150ms 涨到 300ms,看起来“一切正常”。
坑 2:过度依赖云厂商自带的监控
云厂商监控通常从基础设施视角出发,看不到用户真实体验和第三方依赖。建议同时部署独立的可用性探测和 RUM 监控,作为外部验证。
坑 3:把“能访问”等同于“正常”
页面能打开,但核心按钮点不了、支付流程走不通,对业务来说同样是故障。监控必须覆盖关键业务流程,而不仅是首页 HTTP 200。
六、FAQ
Q1:网站崩了第一时间应该看什么指标?
A:先看可用性探测是否报警,确认影响范围;然后看 QPS、错误率、响应时间三条曲线,判断是入口层、应用层还是依赖层问题。
Q2:为什么有时候流量没涨,网站也崩了?
A:流量只是过载的一种诱因。代码 Bug、数据库慢查询、第三方接口异常、配置错误都可能在正常流量下触发故障。
Q3:如何区分 DDoS 攻击和正常流量突增?
A:DDoS 通常表现为来源 IP 异常集中或异常分散、User-Agent 雷同、请求路径异常、转化率骤降;正常流量突增则伴随业务转化上升,来源分布符合渠道特征。
Q4:小团队需要买专业监控工具吗?
A:可以先从开源方案(如 Prometheus + Grafana)和云厂商基础监控做起,重点覆盖错误率、响应时间和可用性。业务复杂后再引入 APM 和 RUM。
Q5:Error Budget 对中小企业有意义吗?
A:有意义。它把“可靠性”变成可量化的指标,帮助团队决定什么时候该停发新功能、什么时候可以承担风险。即使目标是 99.9%,也比没有目标强。
Q6:前端报错多了,算不算网站崩了?
A:算。现代网站大量逻辑跑在前端,JS 报错、资源加载失败、白屏对用户体验的影响不亚于后端 5xx。建议把前端错误率和核心流程可用性纳入事故定义。
七、总结
网站崩溃的根因可以归为八类:流量过载、代码/配置变更、数据库瓶颈、第三方依赖、DDoS 攻击、DNS/CDN 异常、基础设施故障和前端问题。每一类都有独特的数据特征,掌握这些特征,就能把排查变成有迹可循的流程。
更重要的是,不要等到事故发生才去熟悉监控。提前建立“用户侧—入口层—应用层—依赖层”的分层监控体系,并定期用真实数据校准 SLO 和告警阈值,才是降低 MTTR 的根本方法。


 扫一扫


 379

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


