


前面每个机制都是单独演示的,最后用一个真实生产架构把它们全部串进同一张图——企业知识库问答流水线。读案例时对照左侧目录,每个编号都能找到对应的正文小节。
场景背景
- 业务:内部知识库问答。短问题(FAQ 命中型)直接查缓存答案;长问题走「检索 → 分块摘要 → 生成」流水线。
- 约束:文档长度不定 → 摘要任务数量运行时才知道(MapReduce);上游 LLM 服务偶发 5xx 与慢查询;答案置信度低需重新生成,但必须防死循环。
- 涉及机制:条件入口点 、Send MapReduce 、defer 汇聚 、运行时感知重试 、RetryPolicy + TimeoutPolicy + error_handler 、Command 循环 + 主动退出 、recursion_limit 兜底 、节点缓存 。
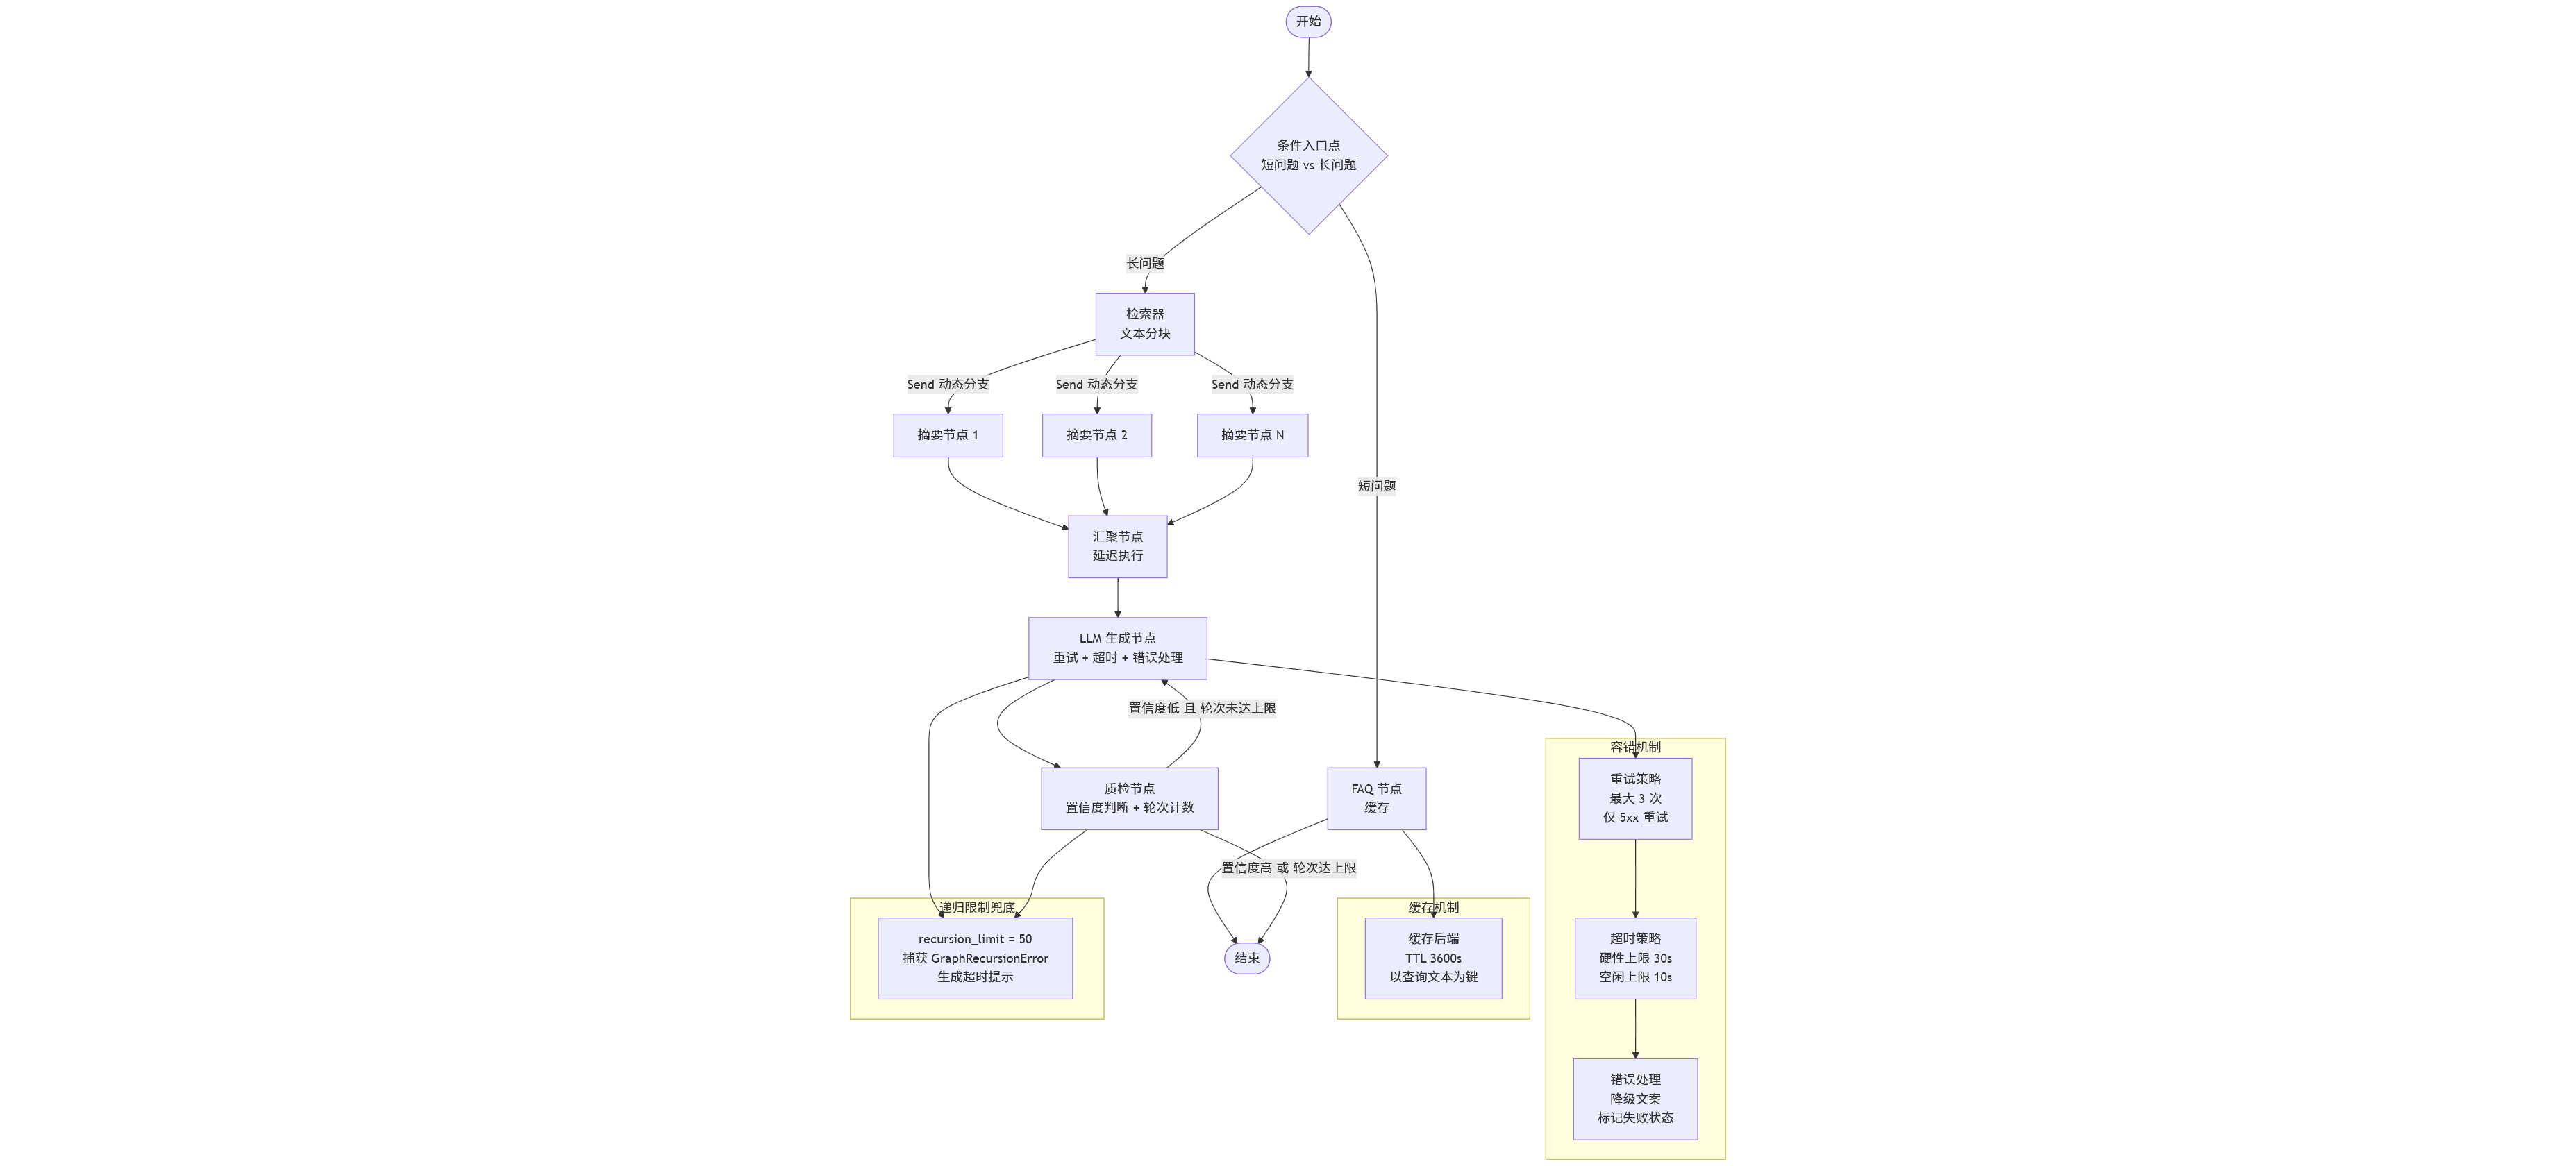
完整代码(可直接复用,替换 stub 即可上线)
import operator
from typing import Literal
from typing_extensions import Annotated, TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.runtime import Runtime
from langgraph.types import Command, RetryPolicy, TimeoutPolicy, CachePolicy, Send
from langgraph.errors import NodeError, GraphRecursionError
from langgraph.cache.memory import InMemoryCache

# ---------- 外部服务封装(示意,替换为真实实现) ----------
def faq_lookup(query: str) -> str: return "FAQ 标准答案"
def split_and_retrieve(query: str) -> list[str]: return ["片段1", "片段2", "片段3"]
async def llm_summarize(chunk: str) -> str: return f"《{chunk}》摘要"
async def llm_generate(prompt: str, model: str = "primary") -> str: return "生成的答案"

def retry_on_5xx(exc: BaseException) -> bool:
    if isinstance(exc, httpx.HTTPStatusError):
        return exc.response.status_code >= 500   # 只重试服务端错误
    return False                                   # 4xx / 其他错误不重试

# ---------- 状态定义 --------



 扫一扫


 3433

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


