



一、前言
不知道大家在大模型应用过程中,是不是也会遇到模型碎片化、接口不统一、生产不稳定。早期为了快速落地,我们直接对接OpenAI系列模型的API,业务跑通后,出于数据安全、国产化合规、成本管控等需求,又需要接入各类国产大模型。不同模型的接口协议、请求参数、返回格式、错误码规则完全不同,每接入一个新模型,都要重复开发对接代码、适配异常逻辑、调试兼容问题,不仅开发效率极低,还会造成代码冗余、维护成本飙升。
更关键的是,原生大模型接口不具备生产级容错能力。线上调用经常出现接口超时、触发平台限流、服务临时不可用、响应异常等问题。如果没有统一的处理机制,很容易导致业务功能卡顿、报错、瘫痪,严重影响用户体验。同时,当某款模型负载过高、故障宕机时,无法自动切换备用模型,业务稳定性完全依赖单一模型服务,风险极高。
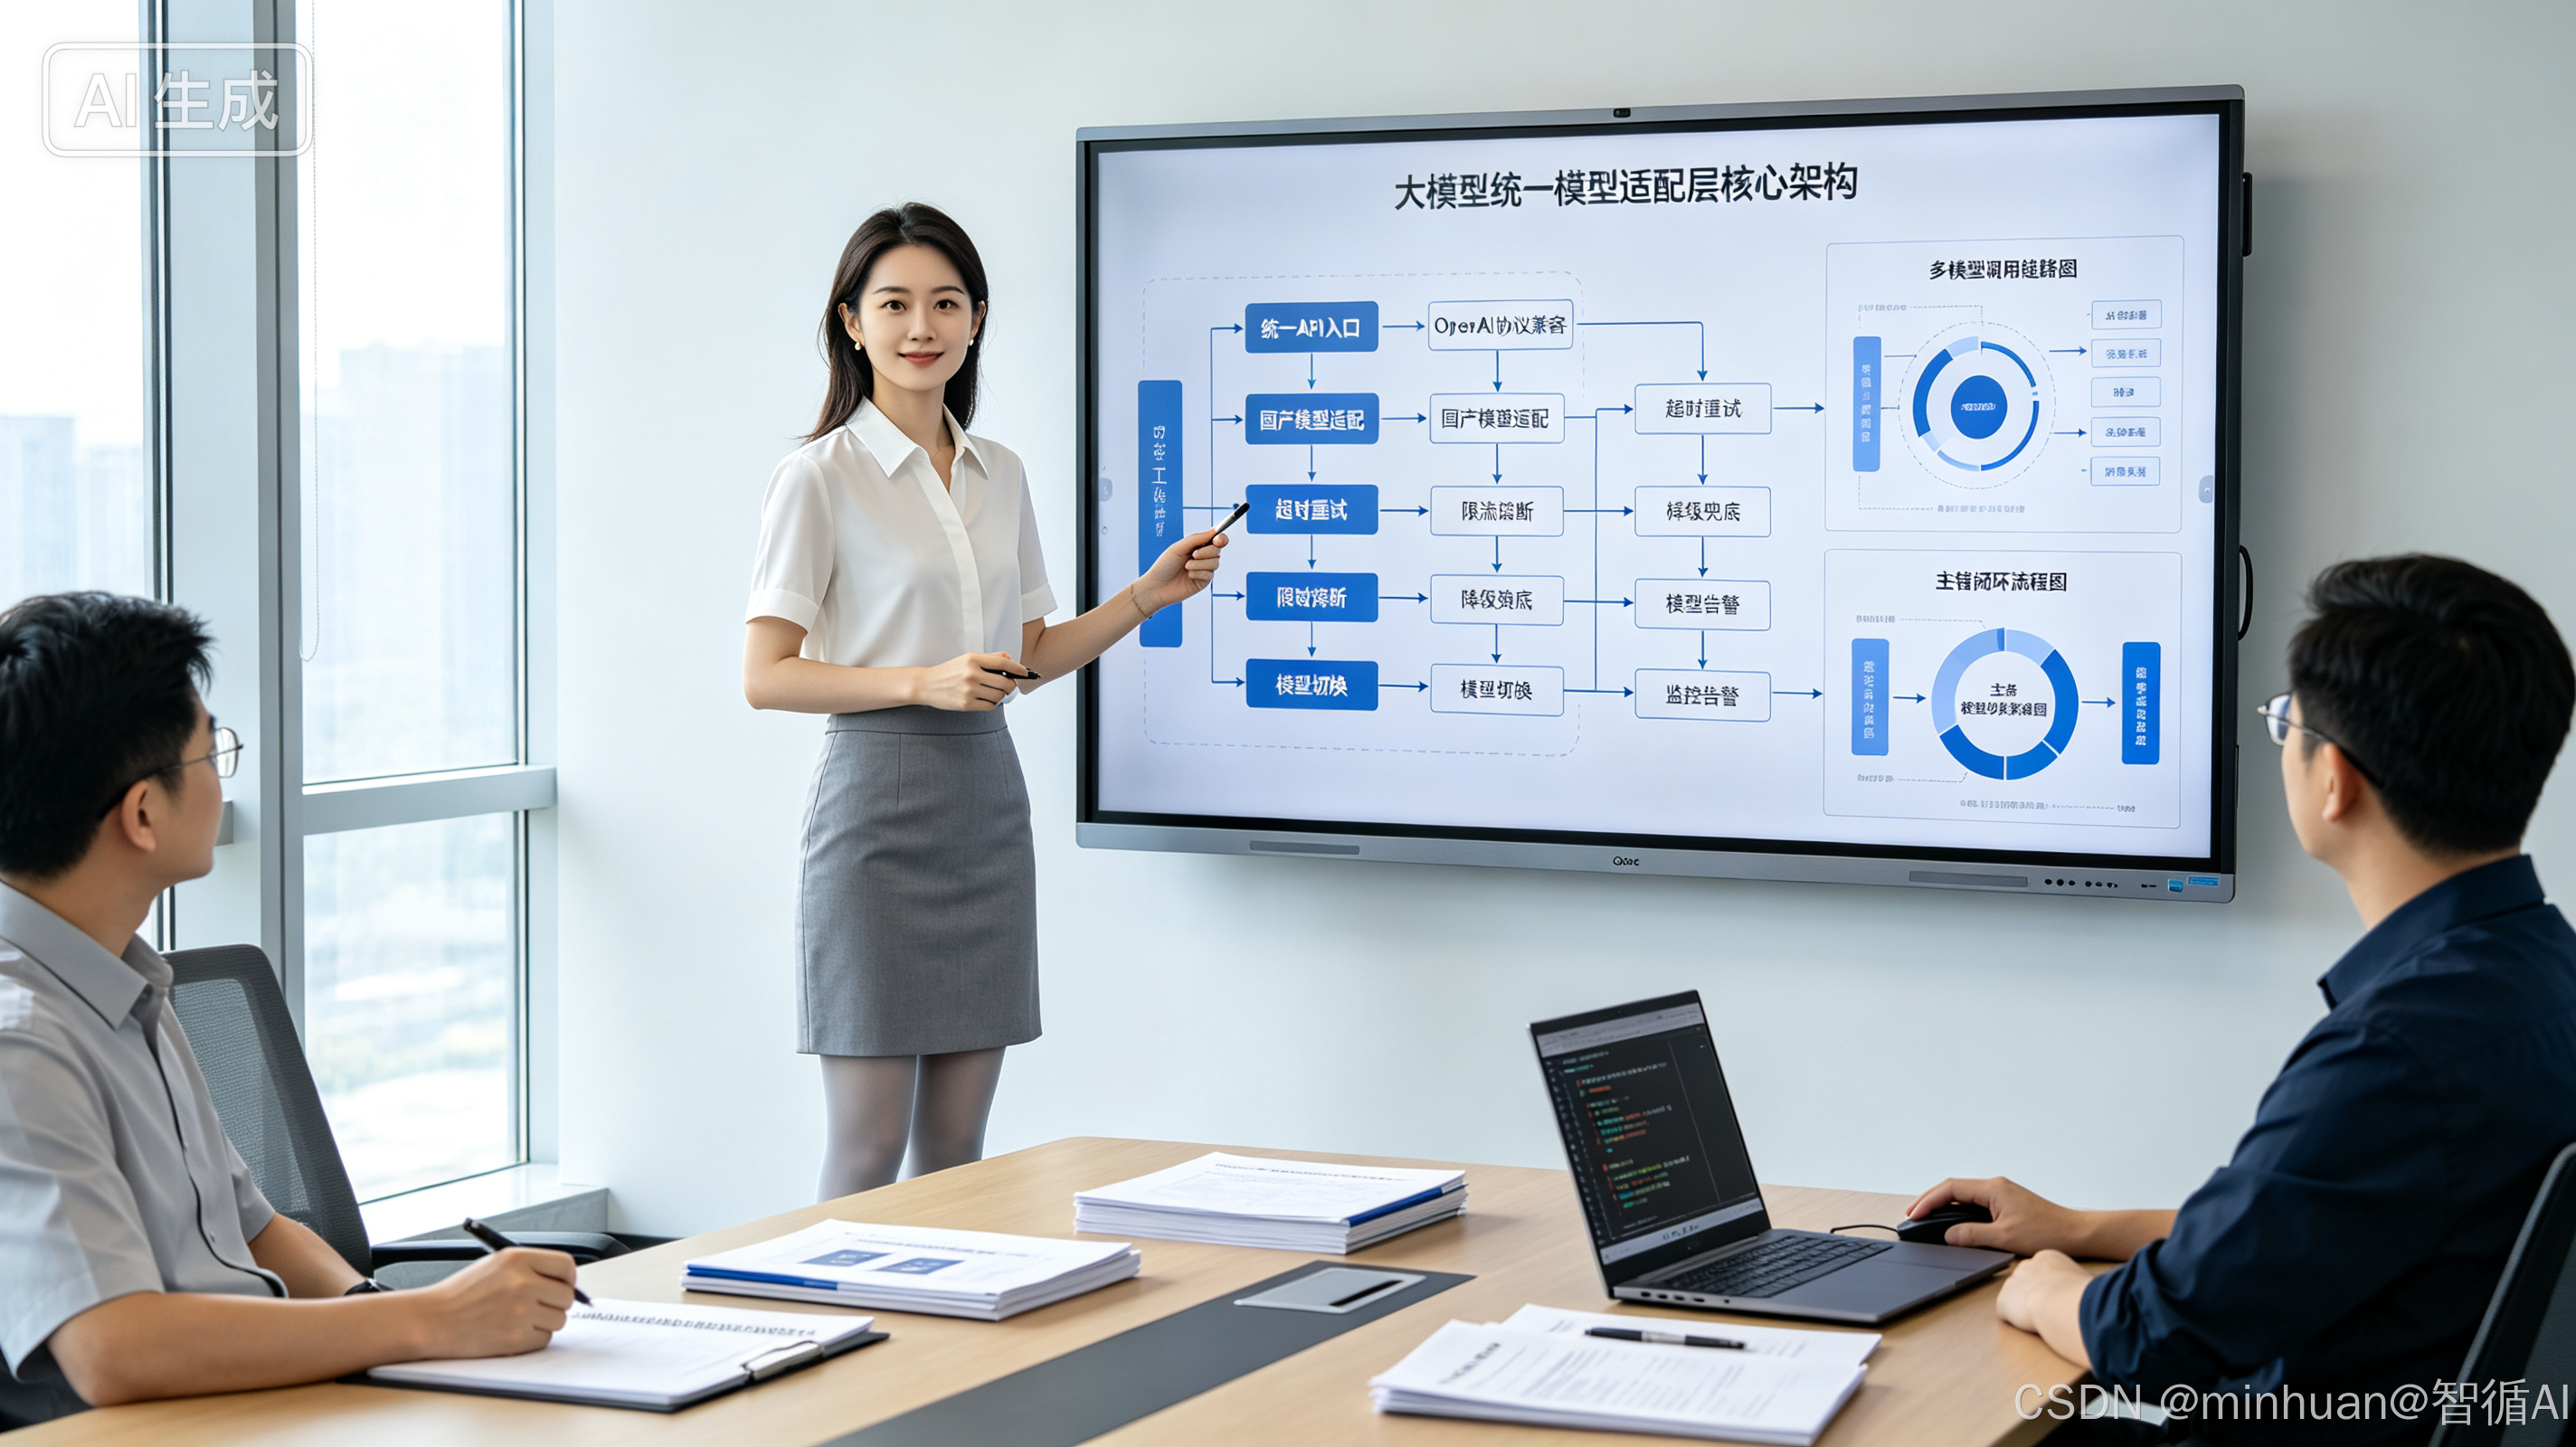
正是为了解决这些问题,统一模型适配层应运而生。简单来说,它是搭建在业务系统与各类大模型服务之间的中间适配架构,核心作用就是统一接口标准、统一异常处理、统一流量管控、统一模型调度。上层业务无需关注底层模型差异,只需对接一套标准化API,即可无缝使用所有兼容的大模型服务,同时自带超时、限流、重试、降级、模型切换等生产级能力。
二、核心架构
1. 整体架构分层
统一模型适配层并非复杂的重型框架,而是一套轻量化、高解耦的中间层架构,整体遵循“上层统一、下层适配、能力内嵌”的设计思路,整体架构分为三层,层层解耦、各司其职,完全适配企业生产环境。
1.1 业务接入层
- 这一层是面向前端业务、后端业务服务的统一入口,只对外暴露一套标准化的OpenAI兼容API。
- 不管业务场景是对话生成、文本续写、向量嵌入、图片理解,还是工具调用,全部通过统一接口请求,业务侧无需感知底层任何模型信息、接口差异和容错逻辑。
1.2 核心适配层
- 这是整个架构的核心枢纽,也是本文重点讲解的部分。
- 主要包含协议适配、参数转换、异常拦截、流量管控、容错处理、模型调度六大核心模块。
- 所有的格式兼容、异常处理、高可用能力,全部在这一层闭环实现,不侵入业务代码。
1.3 模型服务层
- 底层对接所有合规的大模型服务,包含OpenAI全系模型、开源部署私有模型、各类商用国产大模型。
- 适配层会根据预设规则,自动匹配、调度对应模型服务,实现多模型无缝混用。
这种三层架构最大的优势就是解耦彻底、扩展性极强。后续新增任何一款大模型,无需修改业务代码,仅需在适配层新增对应模型的适配规则即可,分钟级完成接入,极大降低迭代成本。
2. 核心设计理念
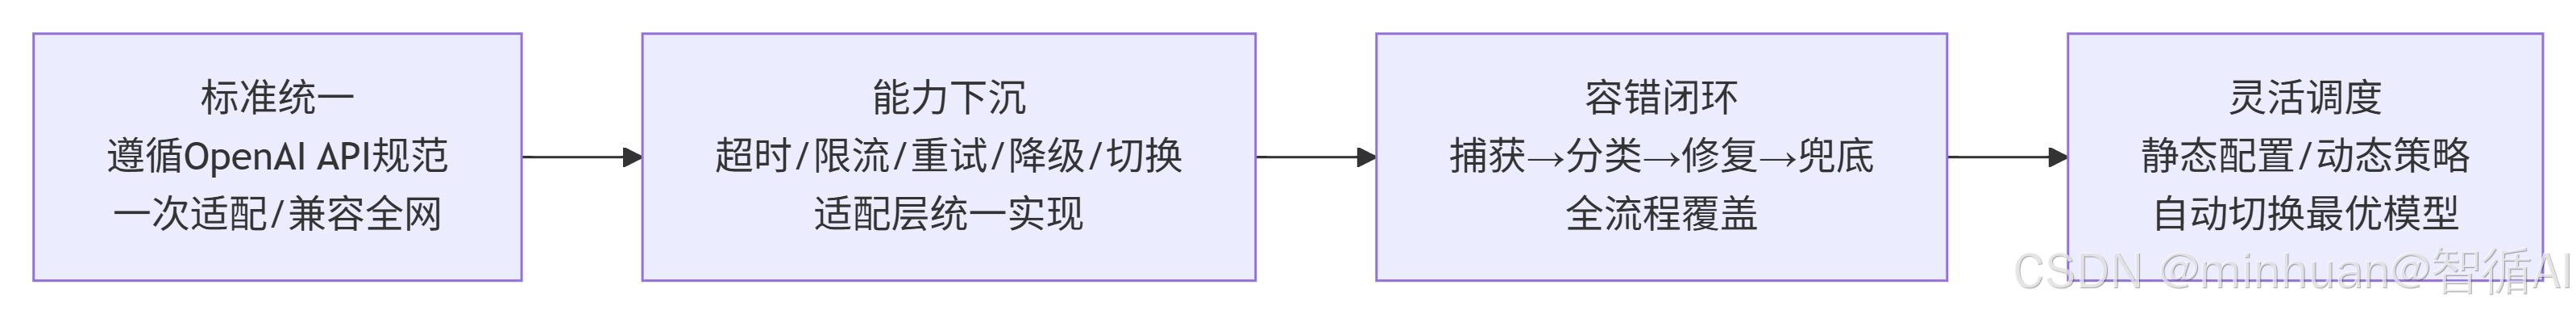
统一模型适配层的设计核心可以总结为四句话:标准统一、能力下沉、容错闭环、灵活调度。所有功能设计都围绕生产落地需求,拒绝过度设计,兼顾实用性与稳定性。
2.1 标准统一
- 全网统一遵循OpenAI API规范,这是目前行业最通用、最成熟的大模型接口标准。
- 实现一次适配,兼容全网绝大多数大模型,无论是海外模型还是国产模型,全部收敛为统一请求、统一响应格式。
2.2 能力下沉
- 所有生产级容错能力,包括超时控制、限流熔断、失败重试、服务降级、模型切换,全部下沉到适配层统一实现。
- 业务侧完全无感,无需重复编写容错代码,彻底告别每个业务接口单独处理异常的冗余开发模式。
2.3 容错闭环
- 针对大模型调用的各类异常场景,建立完整的闭环处理机制,从异常捕获、分类判断、自动修复、兜底响应、日志上报全流程覆盖,最大程度避免线上故障。
2.4 灵活调度
- 支持静态配置和动态策略两种模型调度方式,可根据模型负载、可用性、业务优先级、成本策略,自动切换最优模型,保障业务持续可用。
3. 基础架构示例
统一大模型接入基础架构示例:业务侧按OpenAI格式发起请求,经"参数校验→策略匹配底层模型→统一容错执行(超时/限流/重试/降级)→OpenAI兼容响应封装"四层标准流程处理,通过模型注册表(qwen-plus/deepseek-v3/hy3-preview)实现多模型统一路由接入,上层业务无需感知底层差异,一套入口灵活切换任意模型。
# 统一大模型接入基础架构示例:业务侧按OpenAI格式发起请求,经"参数校验→策略匹配底层模型→统一容错执行(超时/限流/重试/降级)→OpenAI兼容响应封装"四层标准流程处理,通过模型注册表(qwen-plus/deepseek-v3/hy3-preview)实现多模型统一路由接入,上层业务无需感知底层差异,一套入口灵活切换任意模型。
import time
from dataclasses import dataclass, field
from typing import List, Dict

# ===================== 基础类型定义(OpenAI兼容请求体) =====================
@dataclass
class OpenAIChatRequest:
    model_name: str
    messages: List[Dict] = field(default_factory=list)
    temperature: float = 0.7

# ===================== 模型服务注册表(策略:model_name -> 接入端点) =====================
MODEL_ENDPOINTS = {
    "qwen-plus":   "https://dashscope.aliyuncs.com/compatible-mode/v1",
    "deepseek-v3": "https://api.deepseek.com/v1",
    "hy3-preview": "https://tokenhub.tencentmaas.com/v1",
}

# ===================== 1.适配层统一参数校验 =====================
def validate_request(request: OpenAIChatRequest):
    if request.model_name not in MODEL_ENDPOINTS:
        raise ValueError(f"不支持的模型:{request.model_name}")
    if not request.messages:
        raise ValueError("messages不能为空")

# ===================== 2.根据策略匹配底层模型 =====================
def get_available_model_service(model_name: str) -> dict:
    # 简单策略:直连注册端点(生产环境可扩展模型路由、负载均衡)
    return {"model": model_name, "endpoint": MODEL_ENDPOINTS[model_name]}

# ===================== 3.统一执行容错逻辑:超时、限流、重试、降级 =====================
def execute_with_fuse_control(model_service: dict, request: OpenAIChatRequest) -> dict:
    # 模拟底层调用(真实环境替换为模型SDK/HTTP),失败自动重试
    for attempt in range(3):
        try:
            content = f"模拟[{model_service['model']}]基于{len(request.messages)}条消息生成的内容"
            return {"service": model_service, "content": content, "attempt": attempt + 1}
        except Exception:
            time.sleep(0.1)
    # 降级:重试耗尽返回兜底回复
    return {"service": model_service, "content": "【降级】模型服务暂不可用,已返回兜底回复。", "attempt": 3}

# ===================== 4.统一封装响应格式(OpenAI兼容) =====================
def wrap_openai_response(result: dict) -> Dict:
    return {
        "id": "chatcmpl-demo",
        "object": "chat.completion",
        "model": result["service"]["model"],
        "choices": [{"index": 0, "message": {"role": "assistant", "content": result["content"]}}],
    }

# 业务侧统一请求(完全遵循OpenAI格式)
def llm_chat(request: OpenAIChatRequest):
    print("-" * 40)
    print("[步骤1] 参数校验:模型支持性 / messages非空")
    # 1.适配层统一参数校验
    validate_request(request)
    print(f"  ✓ 校验通过 | 请求模型:{request.model_name} | 消息数:{len(request.messages)}")

    print("-" * 40)
    print("[步骤2] 策略匹配:选择底层模型服务")
    # 2.根据策略匹配底层模型
    model_service = get_available_model_service(request.model_name)
    print(f"  ✓ 匹配服务:{model_service['model']} -> {model_service['endpoint']}")

    print("-" * 40)
    print("[步骤3] 统一容错执行:超时 / 限流 / 重试 / 降级")
    # 3.统一执行容错逻辑:超时、限流、重试、降级
    result = execute_with_fuse_control(model_service, request)
    print(f"  ✓ 执行成功(第{result['attempt']}次尝试)")

    print("-" * 40)
    print("[步骤4] 统一封装:转为OpenAI兼容响应格式")
    # 4.统一封装响应格式
    return wrap_openai_response(result)

# ===================== 演示 =====================
if __name__ == "__main__":
    resp = llm_chat(OpenAIChatRequest(model_name="qwen-plus", messages=[{"role": "user", "content": "你好"}]))
    print("-" * 40)
    print("[输出结果] OpenAI兼容格式响应")
    print(f"  ID:{resp['id']} | object:{resp['object']} | model:{resp['model']}")
    print(f"  role:{resp['choices'][0]['message']['role']}")
    print(f"  content:{resp['choices'][0]['message']['content']}")
输出结果:
----------------------------------------
[步骤1] 参数校验:模型支持性 / messages非空
✓ 校验通过 | 请求模型:qwen-plus | 消息数:1
----------------------------------------
[步骤2] 策略匹配:选择底层模型服务
✓ 匹配服务:qwen-plus -> https://dashscope.aliyuncs.com/compatible-mode/v1
----------------------------------------
[步骤3] 统一容错执行:超时 / 限流 / 重试 / 降级
✓ 执行成功(第1次尝试)
----------------------------------------
[步骤4] 统一封装:转为OpenAI兼容响应格式
----------------------------------------
[输出结果] OpenAI兼容格式响应
ID:chatcmpl-demo | object:chat.completion | model:qwen-plus
role:assistant
content:模拟[qwen-plus]基于1条消息生成的内容
三、协议适配
1. 兼容OpenAI协议
OpenAI API是目前大模型领域的行业通用标准,具备格式规范、参数清晰、生态完善的特点,绝大多数开源模型、商用模型都提供OpenAI兼容接口。适配层以该协议为统一基准,是实现多模型统一接入的最优方案。
适配层完整兼容OpenAI核心接口,包括对话补全、文本补全、向量嵌入、模型列表查询、流式响应等核心能力。统一定义请求头、请求参数、响应字段、错误返回格式,让所有底层模型对外表现出完全一致的调用形态。
针对OpenAI核心参数,如model、messages、temperature、max_tokens、stream等,适配层做统一标准化定义。无论底层调用的是GPT-4、GPT-3.5,还是通义千问、讯飞星火,业务侧传参逻辑完全一致,无需区分模型差异。同时适配层支持流式、非流式两种响应模式,完美适配实时对话、批量生成等不同业务场景,兼容前端流式渲染、后端批量处理的各类需求。
2. 国产模型适配转换
国产大模型大多拥有自身专属的接口协议,和OpenAI标准存在一定差异,这也是企业多模型适配的核心难点。适配层核心能力之一,就是完成国产模型与OpenAI标准的双向格式转换,实现无感兼容。
在请求侧,适配层会将标准化的OpenAI请求参数,自动转换为对应国产模型的专属参数。适配层会根据模型类型,自动完成参数映射、格式转换、缺省参数补充,比如:
- 通义千问需要适配prompt格式、角色参数;
- 讯飞星火需要适配会话参数、温度系数区间;
- 百川模型需要适配上下文拼接规则。。
在响应侧,会将国产模型的自定义返回格式,统一收敛为OpenAI标准响应体。统一整理返回文本、token消耗、结束原因、流式分片格式,保证业务侧接收的响应数据完全统一,无需针对不同模型做解析适配。
3. 协议适配代码示例
以下是OpenAI格式转国产通义千问格式的极简适配示例,直观展示协议转换逻辑:
# 统一OpenAI请求转通义千问请求适配
def openai_to_qwen_adapter(openai_req):
    # 统一参数映射
    qwen_req = {
        "model": openai_req.model,
        "input": {
            "messages": openai_req.messages
        },
        "parameters": {
            "temperature": openai_req.temperature,
            "max_tokens": openai_req.max_tokens
        }
    }
    return qwen_req

# 通义千问响应转回OpenAI标准格式
def qwen_to_openai_response(qwen_resp):
    return {
        "id": qwen_resp.get("request_id"),
        "object": "chat.completion",
        "created": int(time.time()),
        "model": qwen_resp.get("model"),
        "choices": [{
            "message": qwen_resp.get("output", {}).get("choices", [])[0].get("message"),
            "finish_reason": "stop"
        }]
    }
通过这套双向适配逻辑,彻底屏蔽不同模型的协议差异。新增国产模型时,仅需编写简短的参数映射规则,即可快速完成接入,极大提升多模型适配效率,这也是适配层最核心的基础能力。
四、容错能力
1. 超时机制设计
大模型推理存在天然的延迟不确定性,文本越长、模型参数越大,推理耗时越久,线上极易出现接口超时问题。如果没有统一的超时管控,会直接导致业务请求阻塞、接口超时报错、用户等待超时退出等问题。适配层针对大模型场景,设计了精细化、可配置的超时控制机制。
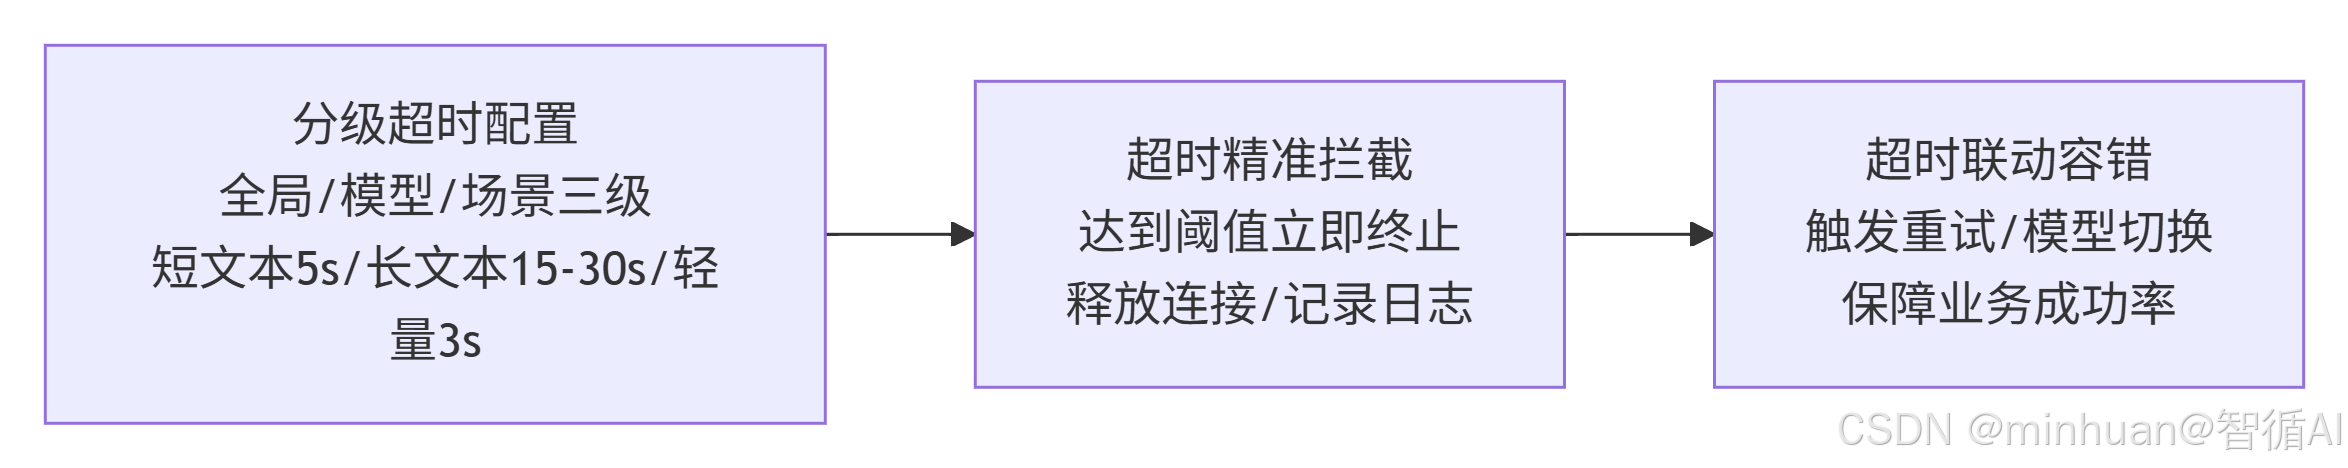
首先是分级超时配置,支持全局默认超时、模型单独超时、业务场景自定义超时三种配置模式。普通短文本对话默认5秒超时,长文本生成、文档总结配置15-30秒超时,向量嵌入等轻量任务配置3秒超时,精准适配不同推理场景。
其次是超时精准拦截,适配层在请求发起时启动计时,一旦达到超时阈值,立即主动终止请求,释放连接资源,避免无效占用服务线程。同时记录超时日志,标注模型名称、请求时长、请求内容长度,用于后续模型性能优化。
最后是超时联动容错,超时不会直接返回失败,而是触发后续的重试、模型切换逻辑,最大程度保障业务成功率,避免单次超时导致业务失败。
2. 限流机制设计
所有大模型服务都存在调用频次限制,OpenAI、国产商用模型均有QPS、每日调用量限制,私有化部署模型也受服务器算力限制,存在最大并发上限。高频调用极易触发平台限流,导致请求被拦截、业务报错。适配层实现了多层限流防护机制,兼顾合规性与稳定性:
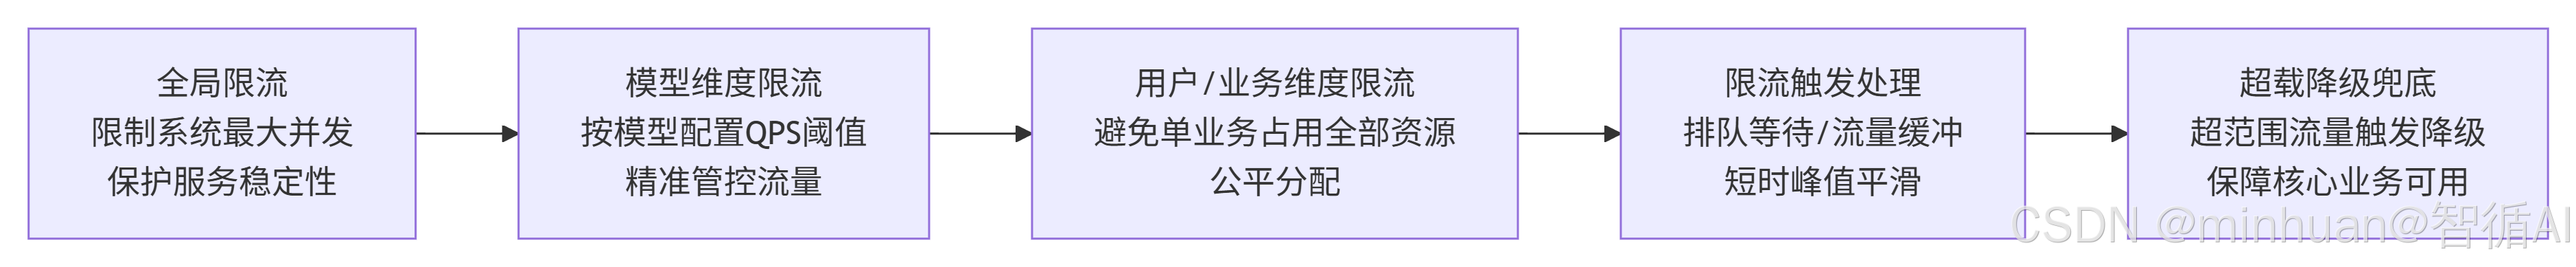
- 第一层是全局限流,限制整个系统的大模型最大并发请求数,避免瞬时流量打爆底层模型服务,保护服务整体稳定性。
- 第二层是模型维度限流,针对不同模型单独配置QPS阈值,热门模型调高阈值,算力较弱的国产模型调低阈值,精准管控流量。
- 第三层是用户/业务维度限流,避免单一业务、单一用户占用全部模型资源,实现流量公平分配。
当触发限流时,适配层不会直接抛出错误,而是执行排队等待、流量缓冲策略,短时流量峰值自动缓冲平滑,超出承载范围的流量则触发降级兜底,保障核心业务可用。
3. 重试机制设计
大模型调用的网络抖动、服务临时过载、瞬时超时都是高频偶发问题,这类问题无需人工干预,通过自动重试即可解决。适配层设计了智能重试机制,区分可重试异常与不可重试异常,避免无效重试浪费资源。
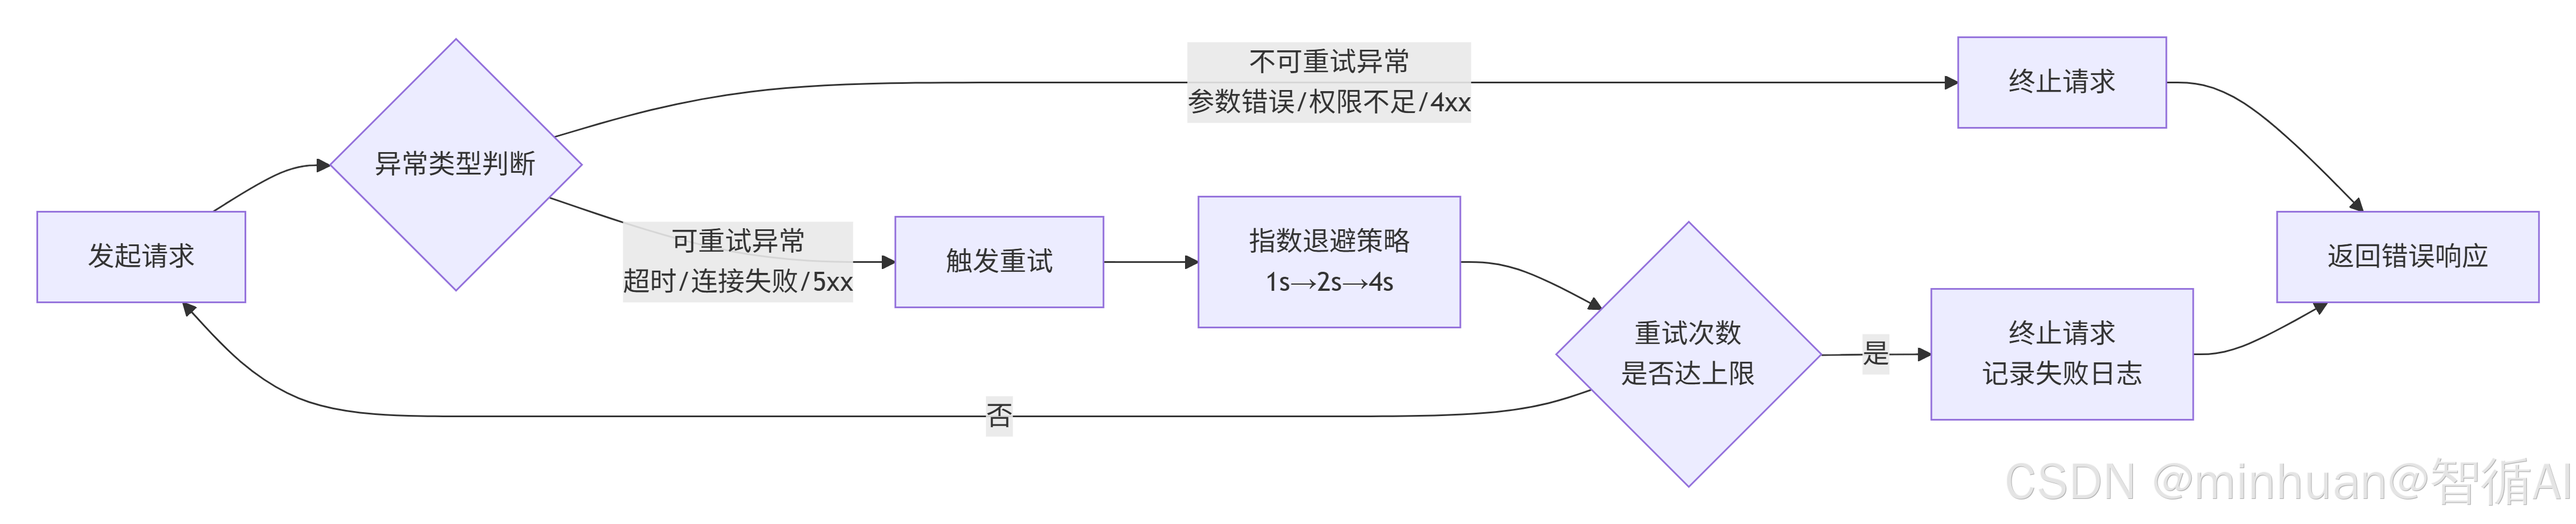
首先是异常分类重试,仅针对网络超时、连接失败、服务临时不可用、5xx服务错误等可恢复异常触发重试。对于参数错误、权限不足、余额不足等4xx不可恢复异常,直接终止请求,不做无效重试。
其次是重试策略可控,支持自定义重试次数、重试间隔,默认采用指数退避策略,第一次间隔1秒,第二次2秒,第三次4秒,避免密集重试压垮模型服务。同时设置最大重试上限,防止无限重试导致资源耗尽。
4. 降级机制设计
当模型服务持续故障、流量远超承载上限、重试多次全部失败时,继续请求只会消耗资源、阻塞业务,此时需要触发降级机制,保障业务不瘫痪。适配层提供精细化的分级降级能力,分为轻度降级、中度降级、重度降级三个等级:
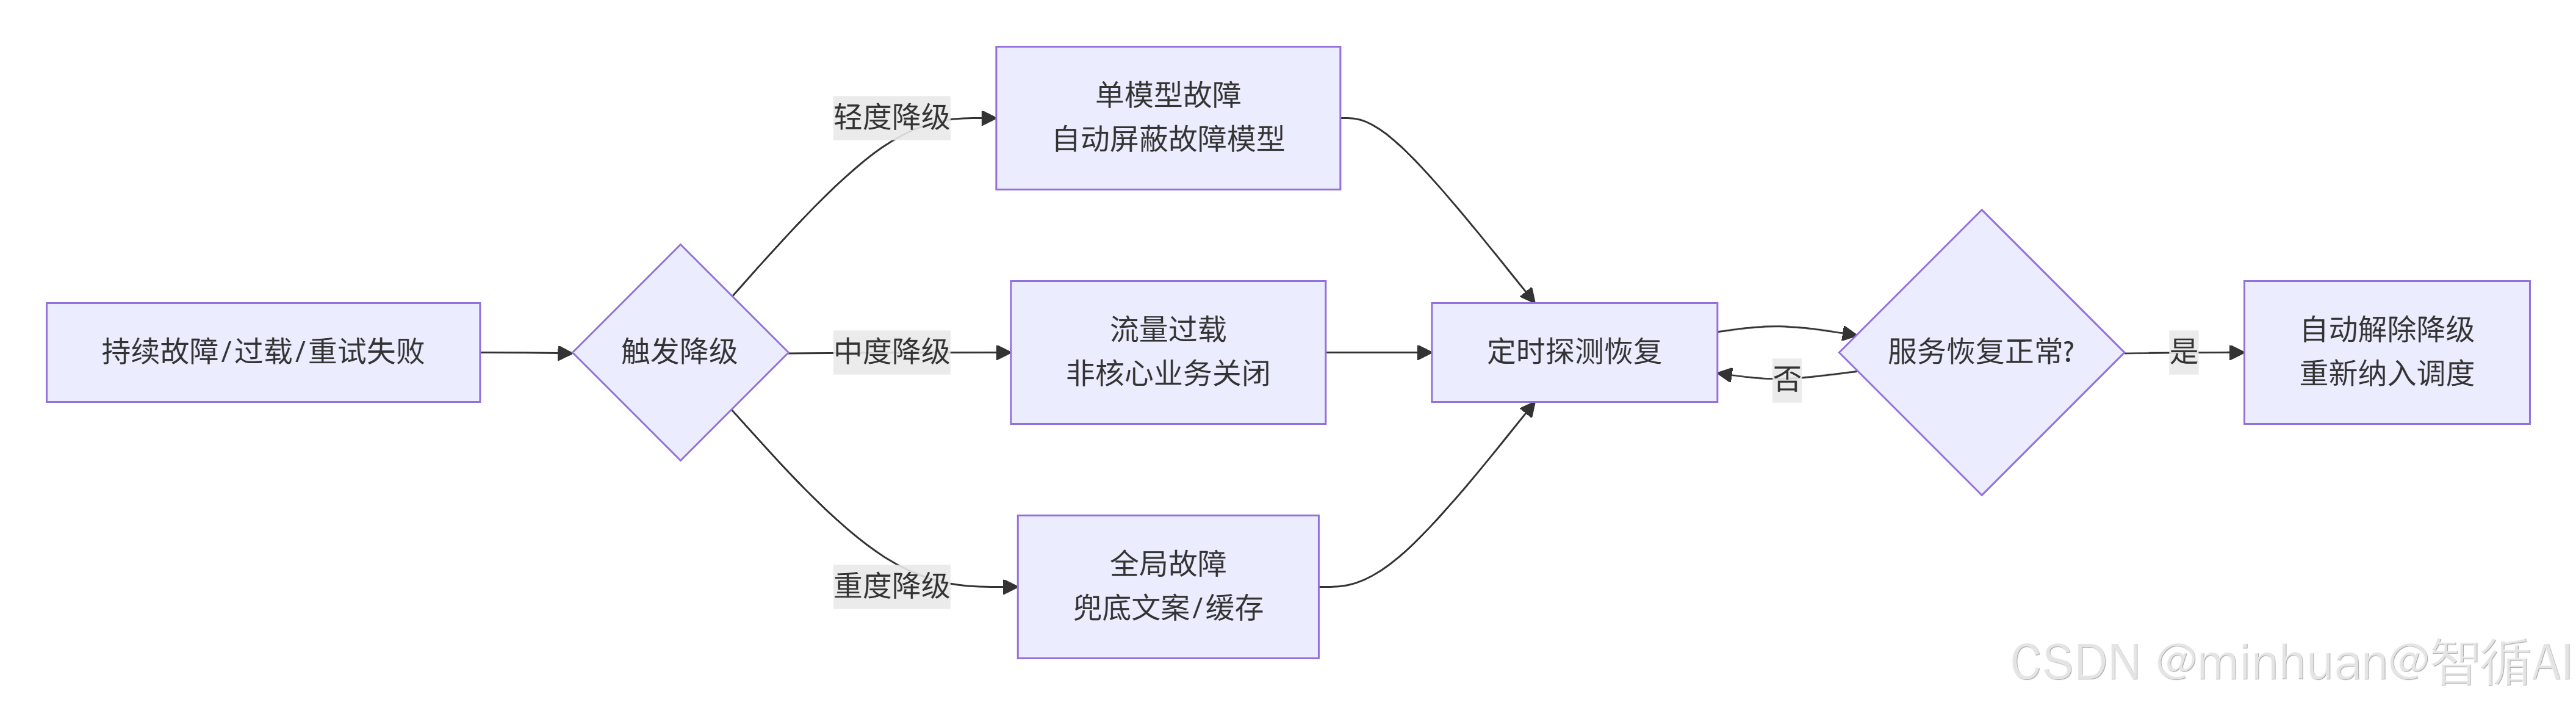
- 轻度降级针对单模型故障,自动屏蔽故障模型,不再调度该模型;
- 中度降级针对流量过载,关闭非核心业务的大模型调用权限,优先保障核心业务;
- 重度降级针对全局模型故障,返回预设兜底文案、缓存数据,实现业务无损兜底。
同时降级支持自动恢复,适配层会定时探测故障模型的服务状态,当服务恢复正常后,自动解除降级策略,重新纳入模型调度队列,无需人工介入操作。
5. 容错能力代码示例
以下示例包含完整的容错逻辑,覆盖了超时、限流、重试、降级全场景,彻底解决大模型线上调用不稳定的核心问题,让大模型业务具备生产级稳定性。
# 适配层统一容错执行逻辑示例
import time
from functools import wraps

# 重试配置
MAX_RETRY = 3
RETRY_INTERVAL = 1
# 超时配置
TIMEOUT = 10

def llm_fuse_control(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        retry_count = 0
        while retry_count < MAX_RETRY:
            try:
                # 执行模型调用,携带超时控制
                return func(*args, **kwargs, timeout=TIMEOUT)
            except (TimeoutError, ConnectionError, ServerError):
                retry_count += 1
                if retry_count == MAX_RETRY:
                    # 重试失败,触发降级兜底
                    return get_fallback_response()
                # 指数退避重试
                time.sleep(RETRY_INTERVAL * (2 ** (retry_count - 1)))
            except Exception:
                # 不可重试异常,直接抛出降级
                return get_fallback_response()
    return wrapper
五、模型切换
1. 切换核心场景
模型自动切换是适配层的核心高可用能力,也是区别于普通接口适配的关键特性。在企业生产中,单一模型服务永远存在故障风险,模型切换能力可以实现业务无感知容灾,核心适用场景分为四类:
- 第一,模型服务故障。当目标模型出现宕机、持续超时、高频报错、限流封禁等问题时,自动切换至备用模型,保障业务持续可用。
- 第二,流量峰值过载。当主模型QPS打满、算力耗尽、响应速度急剧下降时,自动分流至负载较低的备用模型,平滑流量压力。
- 第三,业务场景适配。根据业务需求自动匹配最优模型,简单对话使用轻量国产模型降本,复杂推理、专业分析使用高精度模型提质。
- 第四,合规与成本调度。根据数据合规要求,涉密数据自动切换国产私有化模型,普通业务使用通用模型,实现合规与成本平衡。
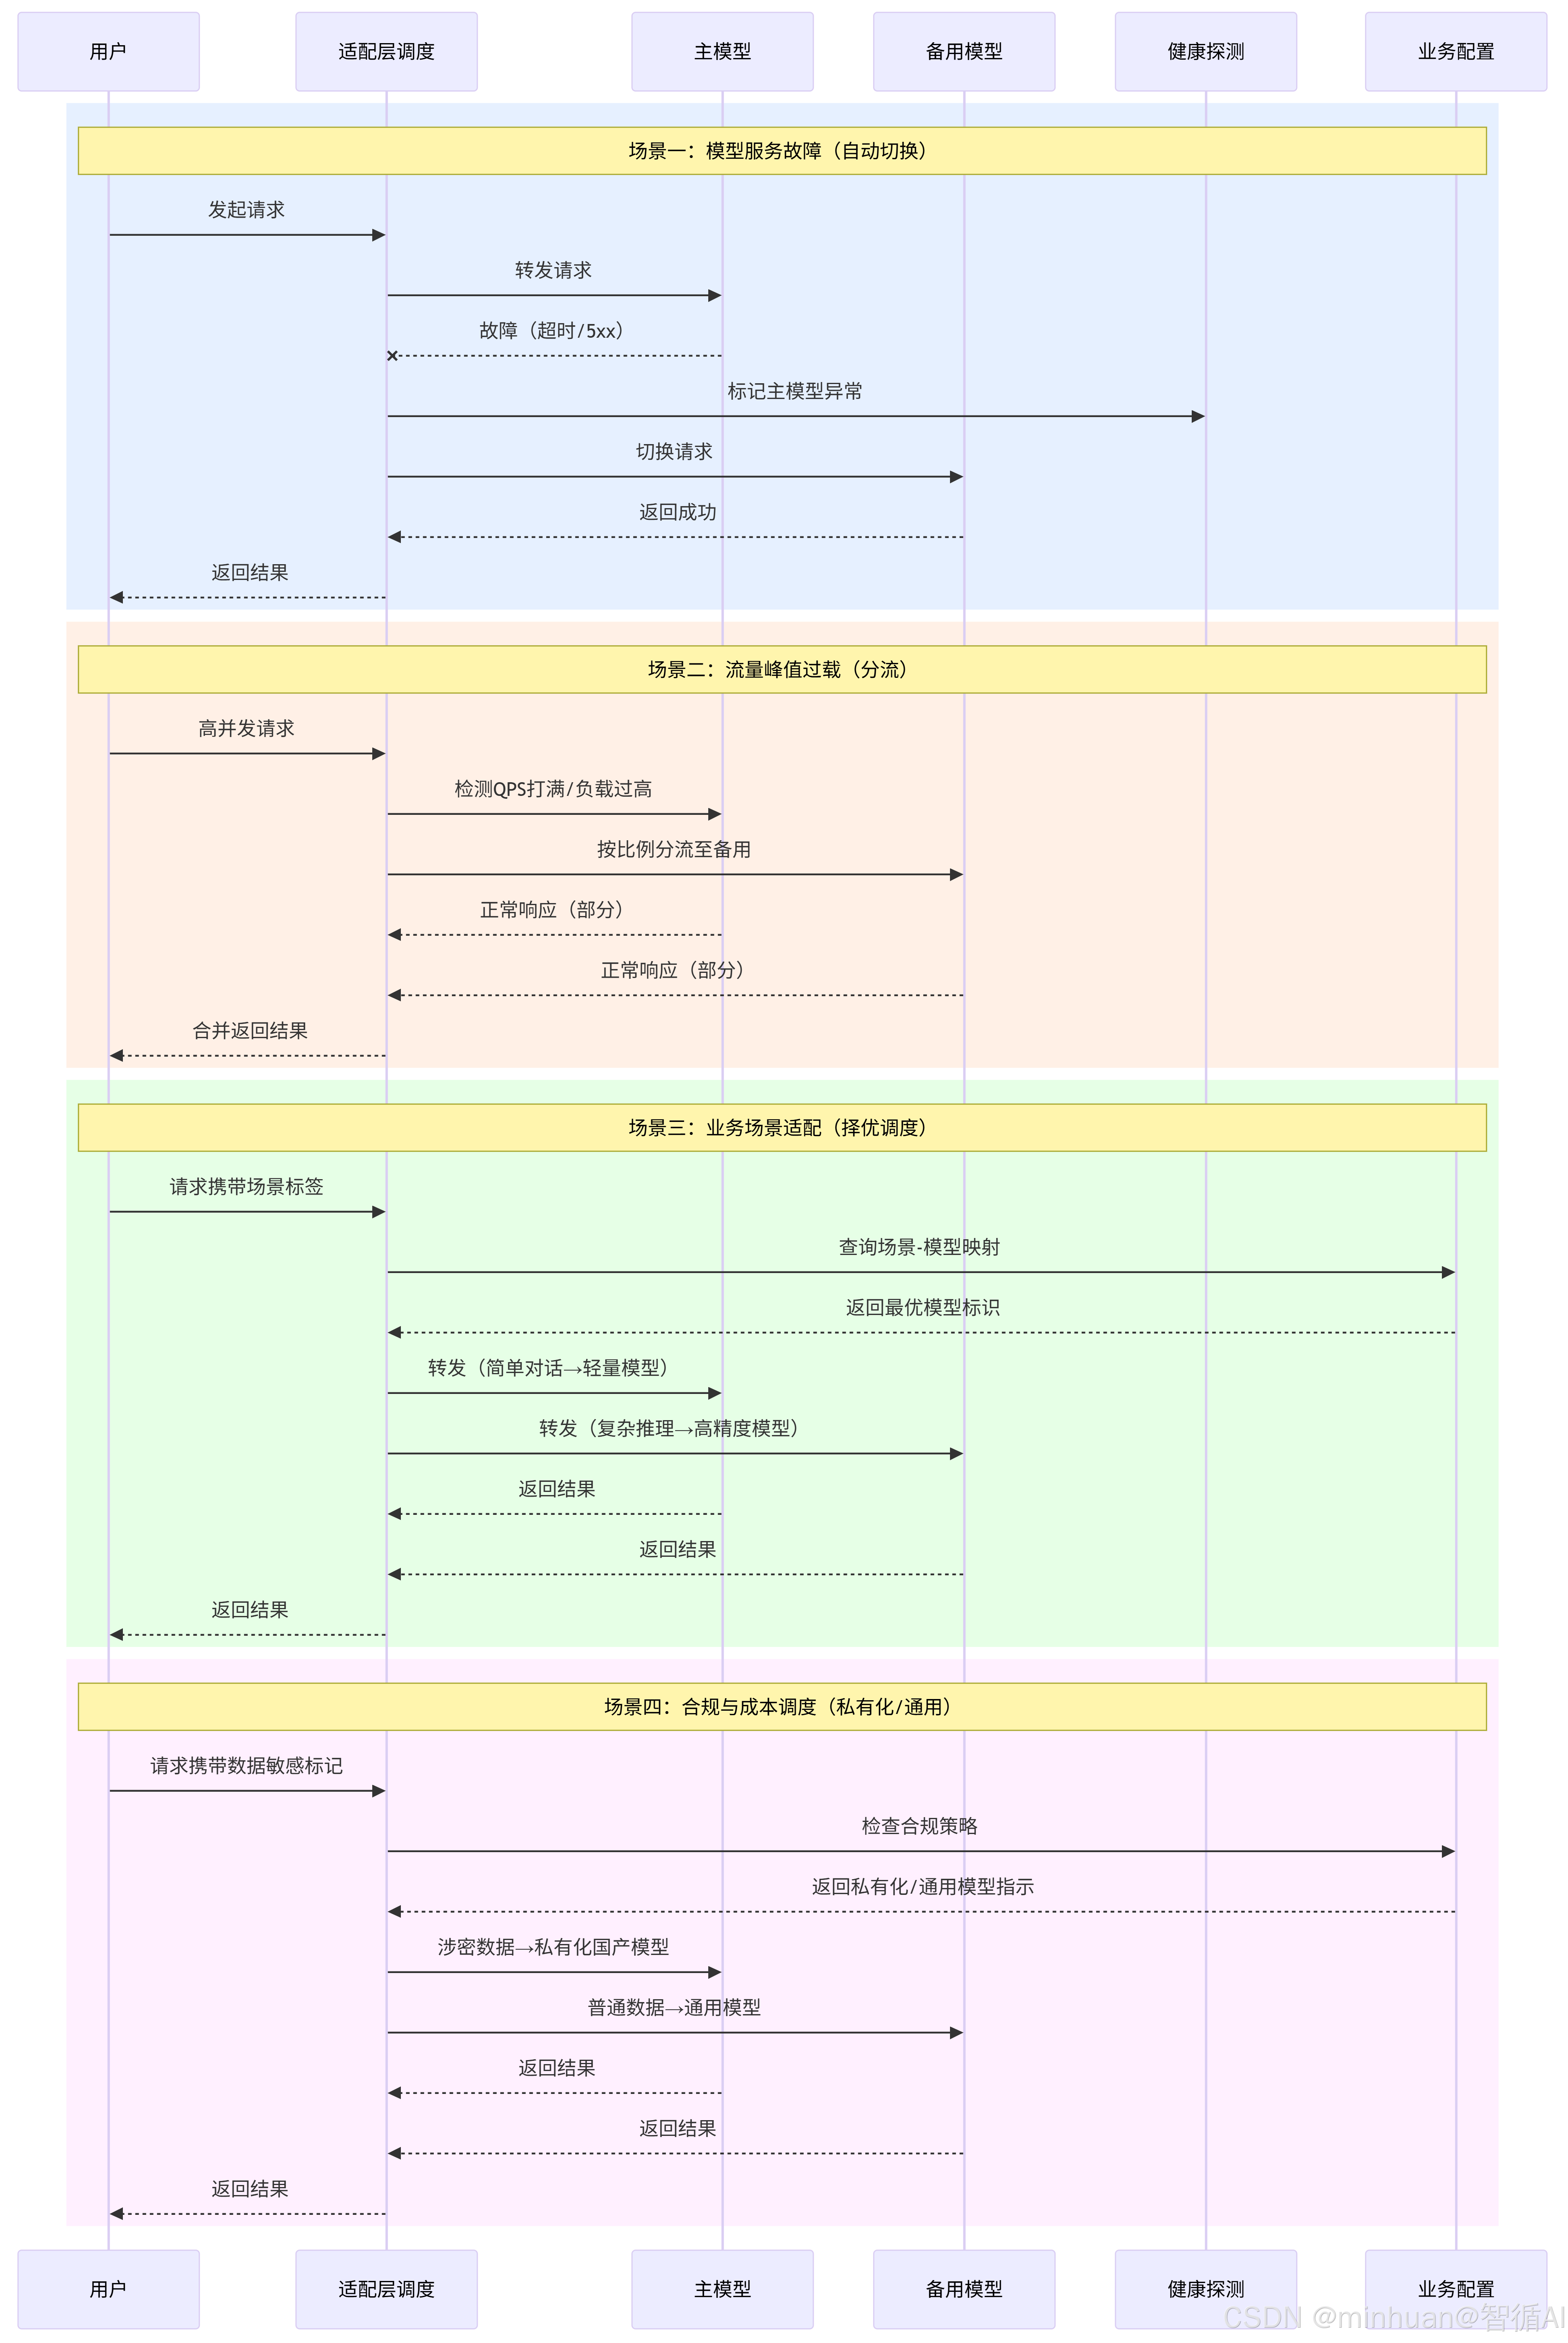
流程说明:
| 场景 | 触发条件 | 调度策略 |
|---|---|---|
| 模型服务故障 | 宕机/持续超时/高频报错/限流封禁 | 自动切换至备用模型 |
| 流量峰值过载 | 主模型QPS打满/算力耗尽/响应下降 | 分流至低负载备用模型 |
| 业务场景适配 | 不同业务对精度/成本要求不同 | 简单对话→轻量模型;复杂推理→高精度模型 |
| 合规与成本调度 | 数据合规要求/涉密场景 | 涉密数据→国产私有化模型;普通业务→通用模型 |
2. 切换策略设计
适配层设计了三种落地性极强的模型切换策略,支持灵活配置,适配不同企业业务架构,全部支持动态生效,无需重启服务:
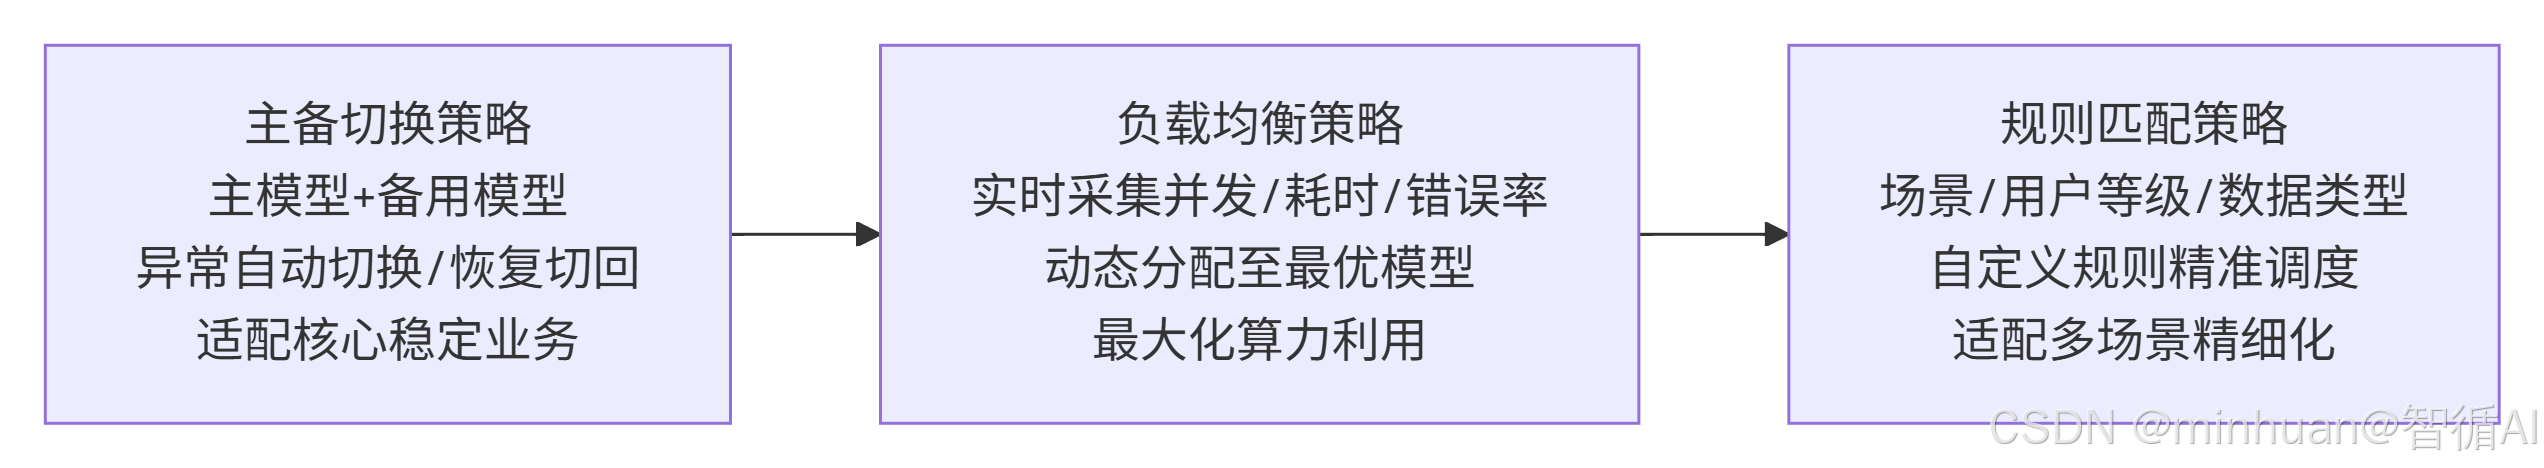
- 一是主备切换策略,最常用的容灾策略。为每类业务配置一个主模型、多个备用模型,正常情况下全部流量走主模型,主模型触发异常阈值后,自动切换备用模型,主模型恢复后可自动切回,适合核心稳定业务。
- 二是负载均衡策略,适合多模型集群部署场景。实时采集各模型的并发量、响应耗时、错误率,动态将流量分配给负载最低、状态最优的模型,最大化利用算力资源,避免单模型过载。
- 三是规则匹配策略,精细化场景调度。支持根据业务场景、用户等级、请求参数、数据类型自定义切换规则,比如企业内部公文场景强制使用国产模型,C端用户简单问答使用低成本模型,实现精准调度。
3. 切换执行流程
完整的模型切换执行流程分为四步,全程自动化、无人工干预、业务无感知:
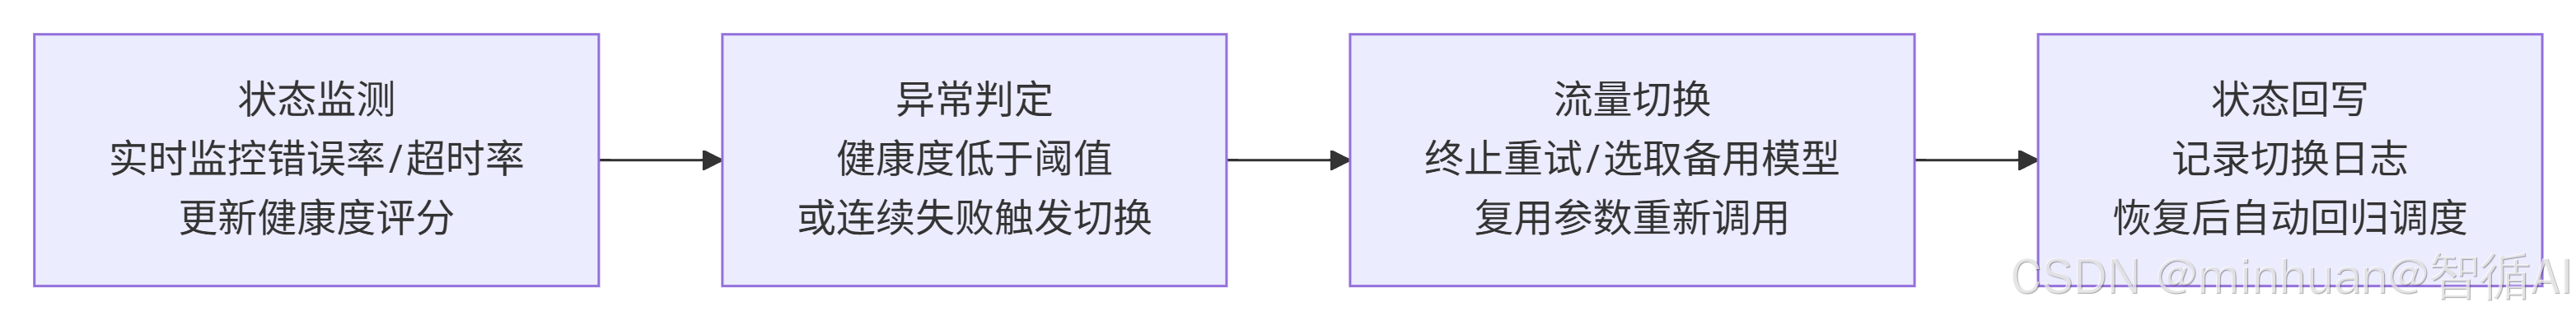
- 第一步,状态监测,适配层实时监控各模型的错误率、超时率、响应耗时、限流状态,实时更新模型健康度评分。
- 第二步,异常判定,当主模型健康度低于预设阈值,或连续多次请求失败、超时,判定为模型不可用,触发切换机制。
- 第三步,流量切换,立即终止当前失败重试流程,自动选取最优备用模型,复用原有业务请求参数,重新发起调用。
- 第四步,状态回写,记录切换日志,持续监测原主模型状态,恢复健康后自动回归调度队列。
4. 模型切换代码示例
通过智能模型切换机制,彻底解决单一模型服务的可用性风险,实现多模型资源的高效调度,大幅提升大模型业务的线上稳定性,是企业生产落地的必备能力。
# 模型自动切换核心逻辑示例
def get_best_model_service(model_key):
    # 获取模型配置列表(主备模型)
    model_list = get_model_config(model_key)
    # 遍历模型,筛选健康可用模型
    for model in model_list:
        if model.is_healthy() and not model.is_limited():
            return model
    # 无可用模型,触发全局降级
    return None

def model_switch_execute(request):
    model_service = get_best_model_service(request.model)
    if not model_service:
        return get_fallback_response()
    try:
        return model_service.call(request)
    except Exception:
        # 调用失败,切换下一个备用模型
        switch_model = get_next_backup_model(request.model)
        if switch_model:
            return switch_model.call(request)
        return get_fallback_response()
六、实践价值
1. 降低开发成本
在没有统一适配层的情况下,每新增一款大模型,开发团队需要重复完成接口对接、参数适配、异常处理、格式解析、容错开发等工作,单模型接入开发耗时通常在1-3天,多模型接入会产生大量重复代码,后期维护难度极大。
统一适配层实现一次搭建、全域复用,后续新增OpenAI兼容模型、国产模型,仅需配置参数映射和基础信息,无需开发业务适配代码,单模型接入耗时缩短至分钟级。同时统一收敛所有容错逻辑,无需每个业务单独处理超时、限流、重试问题,大幅节省人力开发和迭代成本。
2. 统一运维管控
多模型分散对接的模式下,运维难度极高,不同模型的日志格式、报错信息、监控指标完全不同,线上问题排查需要逐个核对接口日志,耗时费力。适配层实现所有模型调用的统一运维管控,统一日志格式、统一异常分类、统一监控指标、统一告警机制。
运维人员可以通过统一控制台,查看所有模型的调用量、成功率、超时率、限流次数、错误分布,快速定位模型故障、接口异常、流量问题。同时支持流量统计、成本统计、模型性能分析,为后续模型选型、算力扩容、成本优化提供数据支撑。
3. 提升业务稳定性
适配层内置的超时、限流、重试、降级、模型切换全套高可用能力,从架构层面彻底解决大模型调用的不稳定性问题。通过智能容错,大幅降低单次请求失败率;通过模型容灾切换,彻底避免单一模型故障导致的业务瘫痪;通过限流管控,避免流量峰值冲垮服务。
经过大量生产落地验证,搭建统一模型适配层后,大模型业务线上报错率可降低90%以上,服务可用性从原有95%提升至99.9%以上,完全满足企业核心业务的生产稳定性要求。
4. 适配国产化合规
当前企业数字化、政务、金融、国企等场景,对数据安全、国产化替代有严格合规要求,核心业务数据禁止出境、禁止使用境外模型存储。统一适配层可以实现模型灵活调度,核心涉密业务自动切换国产私有化大模型,普通业务兼容通用模型,完美适配国产化合规政策。
同时适配层支持私有化部署、内网隔离部署,所有模型调用数据可内网闭环,不经过第三方平台,彻底保障数据安全,满足各类行业合规审计要求。
七、总结
大模型技术发展至今,早已脱离尝鲜测试阶段,正式进入规模化、工业化的生产落地周期。很多企业的大模型落地痛点,从来不是模型能力不够强,而是落地架构不规范、适配体系不统一、生产能力不健全。如果跳过统一适配层建设,直接裸连各类大模型接口,短期可以快速跑通业务,但长期一定会陷入模型适配混乱、代码冗余臃肿、线上故障频发、运维成本高昂的困境,后续重构改造成本极高。而统一模型适配层的核心价值,就是为企业大模型落地搭建一套标准化、高可用、可扩展的底层基础设施。
对于技术团队而言,搭建统一模型适配层,不是多余的架构设计,而是大模型业务规模化落地的必经之路。一次架构搭建,永久受益,后续所有大模型业务都能实现快速迭代、稳定运行、低成本维护。未来随着更多国产大模型、行业专属模型不断迭代更新,统一适配层的价值会持续放大,成为企业大模型技术体系中不可或缺的核心底座。


 扫一扫


 869

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


