



一、前言
相信我们在落地大模型应用时,都会遇到一个共性痛点:模型输出效果极其不稳定,且出了问题无从溯源、无法复盘、难以优化迭代。大家应该都有过这样的经历:同样的业务问题,昨天大模型输出的结果精准合规,今天就出现话术混乱、答案偏离、逻辑漏洞;优化了提示词、更换了模型版本、更新了知识库素材后,无法精准对比新旧效果差异;线上出现生成内容错误、合规风险、精度不达标的问题时,找不到问题根源,分不清是提示词设计缺陷、模型参数配置不当、知识库数据老旧,还是模型本身迭代导致的效果漂移。
归根结底,这些问题的核心症结,就是需要体系化的提示词模板和模型参数管理机制。传统大模型应用开发中,提示词大多硬编码在业务代码中,参数配置零散存放在本地配置文件,知识库更新无记录,生成结果无存档,整个链路处于黑盒状态。没有版本管控、没有变更记录、没有回溯能力,导致大模型应用只能盲目迭代,无法精细化运营和持续优化。想要彻底解决大模型应用效果不可控、问题难溯源、迭代无依据的痛点,就必须搭建一套完整的版本化、可回溯管理体系,覆盖提示词、模型参数、知识库数据、最终生成结果四大核心要素。
二、核心痛点
1. 提示词管理混乱
在常规大模型业务开发流程中,提示词的管理方式普遍非常随意,没有标准化规范,这也是AI应用效果不稳定的首要原因,具体问题:
- 存储零散无统一入口:开发过程中容易直接将提示词文本写在代码接口、脚本文件中,分散无归集。随着业务场景增多、提示词频繁微调,会出现多版本提示词混杂使用的情况,新旧版本交替上线,且无任何变更记录,无法追溯修改内容、时间与目的。
- 无法复用且难以回退:硬编码形式的提示词复用性极差,同类业务场景需要重复编写,大幅增加开发工作量。线上出现输出异常时,无法快速定位当前生效提示词版本,也不能一键回退至稳定可用版本,问题处置效率极低。临时文档记录的提示词与线上业务脱节,更新不同步,无法起到管控作用。
- 无权限与审批约束:提示词修改无审批、无留痕机制,任意开发人员均可随意改动。同一业务场景的生成效果频繁波动,输出合规性、服务稳定性无法保障,存在极大企业业务风险,无法满足商业化落地标准。
2. 模型参数无管控
大模型的输出效果,除了受提示词影响,核心依赖温度系数、最大生成长度、top_p、top_k、重复惩罚值等核心参数。不同参数组合,会让同一提示词、同一输入生成完全不同的结果,各参数核心作用:
- 温度系数:数值越高,模型生成内容随机性、灵活性越强,适合创意类场景;数值越低,内容越严谨、规整、贴合事实,适合精准问答场景。
- 最大生成长度:直接决定模型单次输出内容的完整性,参数过小会出现内容截断,参数过大会造成冗余输出。
- 重复惩罚值:主要用于抑制模型重复输出相同语句、句式,解决长文本生成中的内容冗余、重复问题。
而当前行业普遍存在参数管理乱象,核心痛点分:
- 参数配置零散无记录:多数项目将模型参数固定配置在代码配置项中,无独立版本台账。开发人员调试时随意改参,调试后不留存记录,后续出现效果问题,无法追溯配置逻辑、复现最优效果。
- 通用参数不适配差异化场景:不同业务场景对参数精度、创意度、文本长度需求不同,统一通用参数无法适配各类场景,直接导致部分业务生成效果极差。
- 模型迭代参数适配脱节:大模型厂商持续迭代底座版本,新旧模型的参数适配逻辑存在差异。无参数版本管理机制,会导致旧参数适配新模型,引发输出异常、响应超时、质量下滑等问题,持续积累技术债务。
3. 知识库无版本追溯
知识库是检索增强生成RAG大模型应用的核心数据支撑,模型问答精准度完全依赖知识库数据质量,但目前企业知识库管理普遍缺失版本追溯能力,核心问题:
- 数据更新无版本记录:企业知识库会常态化更新,包含新增业务素材、修正错误数据、淘汰过期信息、更新规章制度等。但绝大多数团队无任何版本留存机制,更新全程无迹可寻。
- 异常问题无法定位、无法回退:知识库更新后,若出现模型回答错误、信息滞后、内容冲突等问题,无法区分问题源于数据更新失误、数据清洗不彻底还是检索逻辑异常。同时无版本回溯能力,出错后无法快速还原稳定版本,直接影响线上业务。
- 配套规则无管控引发效果波动:知识库切片规则、向量存储配置、检索阈值等配套参数无版本管控。不同批次知识库处理规则不一致,导致向量检索效果波动,进一步加剧大模型输出不稳定问题,且全程无法溯源。
4. 生成结果无存档复盘
大模型线上交互的提问内容、检索数据、生成结果,是应用迭代优化的核心数据,但多数业务系统仅实现基础功能,未做数据存档复盘设计,核心弊端:
- 异常问题无法链路复盘:用户反馈答案错误、话术不当、信息遗漏等问题时,因无交互链路数据存档,研发人员无法完整复盘单次调用全流程,难以精准定位问题根源,排查效率极低。
- 迭代优化无数据支撑:缺少历史交互数据沉淀,无法批量统计不同提示词、参数、知识库版本的输出准确率、合规率、用户满意度。大模型优化迭代只能依靠人工经验判断,没有数据依据,迭代效率低,无法实现精细化调优。
三、整体架构
1. 四层整体架构
要实现提示词、模型参数、知识库、生成结果的全链路版本化、可回溯管理,需搭建分层解耦、标准化、可落地、可扩展的四层技术架构,从底层存储到上层业务层层递进,各司其职:
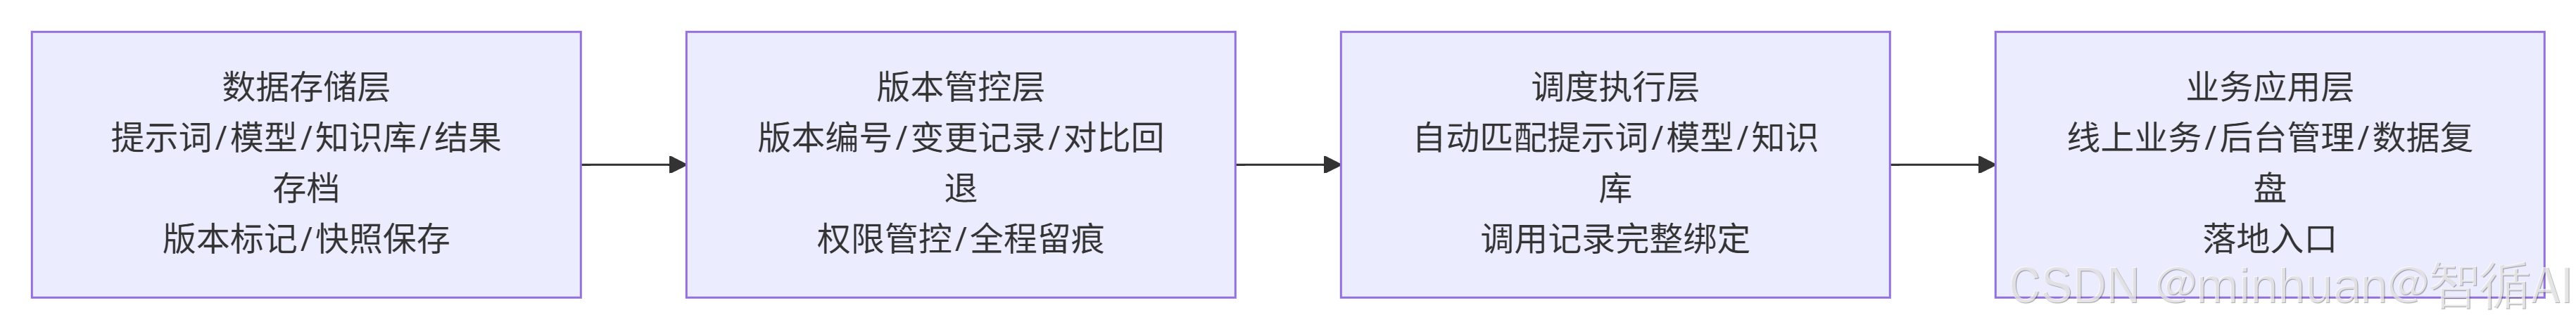
数据存储层(架构底座):
- 负责所有核心资源的持久化存储与版本记录,包含提示词模板库、模型参数配置库、知识库向量库、交互结果存档库四大模块。
- 所有数据支持版本标记、变更记录、快照保存,为上层回溯、迭代、复盘提供核心数据支撑。
版本管控层(核心中枢):
- 承接所有底层资源,实现统一标准化版本管理。
- 核心能力涵盖版本编号生成、变更日志记录、版本对比、一键回退、版本冻结、权限管控,对提示词修改、参数调整、知识库更新、模型切换等所有操作全程留痕、可追溯。
调度执行层(调度中枢):
- 承接前端业务请求,根据业务场景自动匹配对应版本的提示词、模型参数、知识库资源,完成模型调用、检索匹配、内容生成全流程。
- 同时实时记录每次调用的资源版本、入参、出参、耗时、状态,打通资源与生成结果的绑定关系。
业务应用层(落地入口):
- 面向终端用户与运维人员,包含线上业务场景、后台管理平台、数据复盘平台。
- 分别负责实现AI交互能力、人工配置与资源管控、线上效果分析与问题迭代复盘。
2. 全链路关联逻辑
整个架构的核心逻辑为一次调用,全链路绑定版本,彻底打破各类资源孤立管理的痛点,实现每一次AI交互全程可溯,具体绑定规则:
- 绑定当前业务场景生效的提示词模板版本;
- 绑定场景专属适配的模型参数版本;
- 绑定本次调用对应的知识库快照版本;
- 绑定本次交互最终的生成结果存档记录。
3. 架构落地优势
该四层分层架构适配企业级大模型全场景落地,实用性、稳定性、扩展性优势突出,核心价值:
- 高解耦性:提示词、模型参数、知识库资源独立管控、互不干扰,可单独迭代升级,无需整体改造业务系统,改造成本低。
- 高兼容性:适配主流大模型底座、RAG架构、各类AI业务场景,无需额外适配改造即可快速落地部署。
- 强可扩展性:架构预留拓展空间,后续新增模型、新增业务场景、新增管控规则,均可在现有架构基础上迭代升级。
- 高稳定性:内置版本冻结、一键回退机制,可有效规避线上资源变更风险,保障业务持续平稳运行。
四、提示词模板管理
1. 模板标准化设计
提示词模板是大模型生成内容的核心指引,标准化结构化设计是实现版本管控、可复用、可回溯的基础。需杜绝零散自由文本,统一采用固定框架+可变参数标准化模板,适配绝大多数业务场景,四大固定模块:
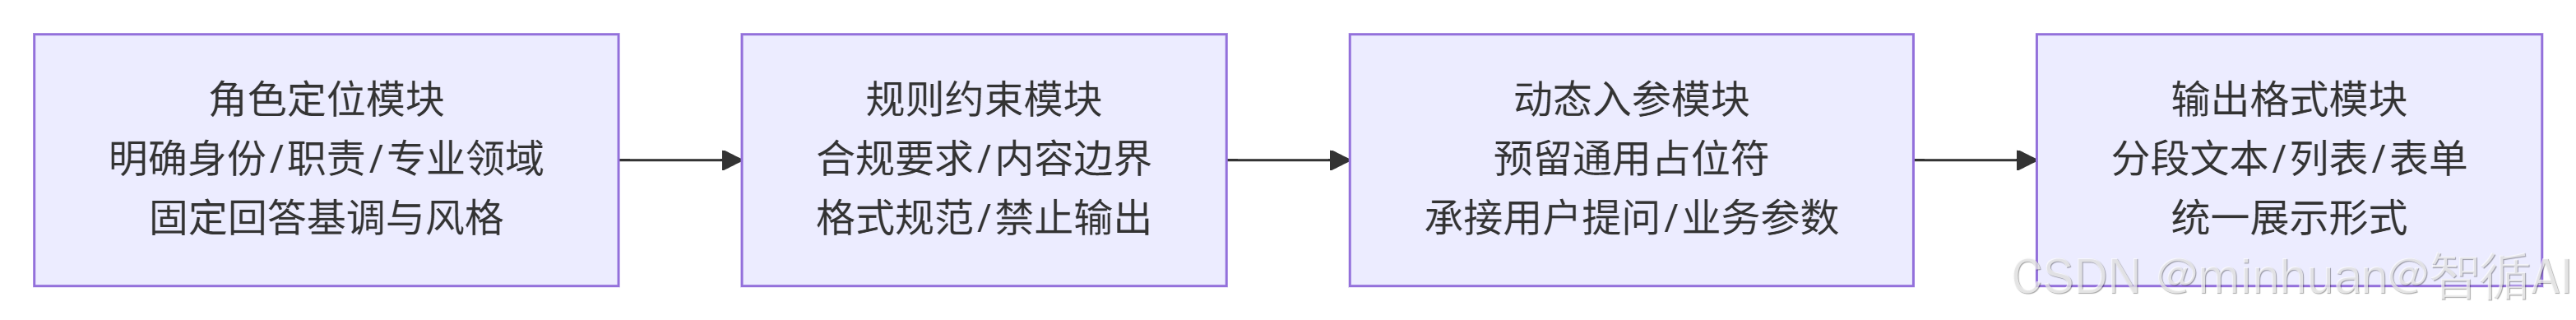
- 角色定位模块:明确大模型身份、岗位职责、专业领域,固定回答基调,规范模型输出风格,避免角色混乱。示例:“你是企业智能客服,专注解答员工考勤、薪资、办公流程相关问题,回答简洁、精准、贴合企业制度”。
- 规则约束模块:明确输出合规要求、内容边界、格式规范、禁止输出内容,限制模型自由发挥,规避冗余、违规、偏离场景的输出结果。
- 动态入参模块:预留通用可变占位符,承接用户提问、知识库检索内容、业务参数等动态数据,实现一套模板适配多组不同输入,提升复用性。
- 输出格式模块:统一规定生成结果展示形式,包含分段文本、列表输出、结构化表单等,保障同场景输出效果统一、规整。
基础示例:企业考勤问答提示词模板
【角色定位】你是企业内部考勤智能问答助手,熟悉公司考勤管理制度,专业解答员工考勤相关咨询。
【约束规则】1. 所有回答严格依据公司考勤制度,无制度依据的如实告知用户;2. 回答简洁通俗,不使用专业晦涩术语;3. 禁止输出无关内容,不随意编造信息。
【动态入参】用户问题:{{user_question}};参考制度:{{knowledge_content}}
【输出格式】分点清晰作答,先明确答案,再补充对应制度依据。
2. 版本化管控规则
针对标准化提示词模板,搭建全流程版本管控体系,实现变更可记录、可追溯、可回退,核心管控规则:
- 标准化版本编号规则:
- 统一采用"主版本.次版本.修订版本"格式(如V1.0.0)。
- 主版本:模板整体框架、核心规则重大变更;
- 次版本:局部话术、约束规则优化调整;
- 修订版本:错别字、标点、格式等微小微调。
- 全量变更台账记录:
- 每次模板修改后,系统自动留存完整日志,包含版本号、操作人、操作时间、变更前后内容、变更原因、适配业务场景,所有日志永久存档、不可篡改。
- 同时设置草稿、测试、上线、冻结四种状态标签,精准管控模板使用状态。
- 版本对比与回退能力:
- 支持任意两个版本模板差异化对比,直观展示优化细节,便于效果分析。
- 新版本上线若出现效果下滑、业务异常,可一键回退至历史稳定版本,保障线上业务无风险运行。
3. 场景化复用机制
为规避提示词重复开发、迭代效率低的问题,搭建场景化模板复用库,实现标准化模板快速复用、个性化迭代,核心机制如下:
- 分类归档沉淀通用模板:按照业务领域对提示词分类整理,划分为智能客服、内容创作、数据问答、代码辅助、制度解读等类目,每个类目沉淀可直接复用的标准化通用模板。
- 快速复用、小幅微调适配:新业务场景落地时,直接复用对应类目通用模板,仅微调动态参数、约束规则、输出格式即可快速上线,大幅缩短开发周期。
- 复用关联版本溯源:复用模板自动关联原始版本记录,微调后的模板会生成独立子版本,既保留原始模板的稳定性,又满足个性化场景适配需求,全程可追溯。
五、模型参数管理
1. 核心参数梳理
大模型可调参数是调控输出效果的核心,不同业务场景需匹配差异化参数组合。梳理五大核心可调参数,明确其功能与适配场景,为版本化管控奠定基础:

- 温度系数(temperature):取值0-1。低值适配制度问答、合规咨询、数据解读等精准严谨场景;高值适配文案创作、创意策划、脚本生成等灵活创意场景。
- Top-P采样:取值0-1,控制模型候选词汇筛选范围。数值越小,输出越规整精准;数值越大,内容多样性越强,通常与温度系数搭配使用。
- 最大生成长度(max_tokens):限制模型单次输出字符数。简短问答配置小数值,长文报告、批量内容生成配置大数值,避免内容截断或冗余。
- 重复惩罚系数(frequency_penalty):抑制模型重复语句、冗余内容,数值越高去重效果越好,主要适配长文本生成场景。
- 运维调用参数:包含超时时间、最大重试次数,用于保障模型调用稳定性,规避超时、报错、中断等线上异常问题。
2. 参数版本管控
摒弃传统代码硬编码的零散配置模式,搭建独立可视化模型参数版本管理平台,实现参数场景化、版本化、可追溯管控,核心落地规则:
- 场景专属参数配置:按业务场景独立创建参数配置组,每个场景匹配专属最优参数组合,彻底解决通用参数适配所有场景导致的效果不佳问题。
- 参数调整全程留痕:所有参数修改均生成新版本,自动记录调整前后数值、调整原因、调试效果、操作人及操作时间,参数版本与业务场景强绑定,精准留存历史配置记录。
- 测试上线闭环管控:新参数版本必须经过测试环境验证,确认输出效果优于旧版本后方可灰度上线。线上实时监控参数适配效果,出现精度下滑、响应异常等问题可一键回退历史稳定版本。
基础示例:双场景参数配置版本对比
场景1:企业制度精准问答(V1.0稳定版):temperature=0.1,top_p=0.3,max_tokens=2000,frequency_penalty=1.0
场景2:营销文案创意生成(V1.0稳定版):temperature=0.8,top_p=0.9,max_tokens=5000,frequency_penalty=1.2
3. 模型适配联动
模型参数无法脱离模型底座独立使用,必须实现参数版本与模型版本的联动绑定适配,规避模型迭代带来的适配风险,核心联动机制如下:
- 版本绑定预警:系统自动记录每套参数适配的模型名称、模型版本。当底层模型升级、切换、下线时,自动识别并预警不匹配的参数配置,提醒运维人员及时调优。
- 版本绑定预警:系统自动记录每套参数适配的模型名称、模型版本。当底层模型升级、切换、下线时,自动识别并预警不匹配的参数配置,提醒运维人员及时调优。
- 模型参数适配台账:针对不同类型模型沉淀专属适配方案,形成标准化映射台账。轻量化模型适配小长度、低随机参数;千亿级通用模型适配高灵活、长文本参数,从根源解决模型迭代引发的效果漂移问题。
4. 应用实践示例
基于大模型参数+提示词版本化调度、结果存档全流程,以版本化资源配置库为核心,将提示词模板(QA_V1.0.0)、场景化模型参数(问答/创作)、知识库快照版本统一注册管理,运行时通过LLMRuntimeVersionManager按场景绑定指定版本并渲染调用,每次调用生成全局唯一溯源ID,全链路留存提示词、参数、知识库版本及结果日志,实现可回滚、可追溯的版本化大模型工程管理。
import uuid
import json
from datetime import datetime
from typing import Dict, Optional

# ====================== 1. 版本化资源配置库(模拟后台版本管理中心) ======================
# 提示词模板版本库
PROMPT_VERSION_LIB = {
    "QA_V1.0.0": {
        "role": "你是企业内部考勤智能问答助手,熟悉公司考勤管理制度,专业解答员工考勤相关咨询。",
        "rule": "1. 所有回答严格依据公司考勤制度,无制度依据的如实告知用户;2. 回答简洁通俗,不使用专业晦涩术语;3. 禁止输出无关内容,不随意编造信息。",
        "template": "用户问题:{{user_question}};参考制度:{{knowledge_content}}",
        "output_format": "分点清晰作答,先明确答案,再补充对应制度依据。"
    }
}

# 场景化模型参数版本库
MODEL_PARAM_VERSION_LIB = {
    "QA_SCENE_V1.0": {
        "temperature": 0.1,
        "top_p": 0.3,
        "max_tokens": 2000,
        "frequency_penalty": 1.0
    },
    "CREATIVE_SCENE_V1.0": {
        "temperature": 0.8,
        "top_p": 0.9,
        "max_tokens": 5000,
        "frequency_penalty": 1.2
    }
}

# 知识库快照版本绑定
KB_VERSION_SNAPSHOT = {
    "20260901_STABLE": "企业考勤制度全量知识库快照(稳定版)"
}

# ====================== 2. 全链路版本调度核心工具类 ======================
class LLMRuntimeVersionManager:
    def __init__(self, scene: str, prompt_version: str, param_version: str, kb_version: str):
        self.scene = scene
        self.prompt_version = prompt_version
        self.param_version = param_version
        self.kb_version = kb_version
        self.call_id = str(uuid.uuid4())  # 全局唯一溯源ID
        self.call_time = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
        self.result = None

    def load_prompt_template(self, user_query: str, knowledge_text: str) -> str:
        # 加载指定版本提示词并渲染动态参数
        prompt_conf = PROMPT_VERSION_LIB.get(self.prompt_version)
        prompt = f"【角色】{prompt_conf['role']}\n【规则】{prompt_conf['rule']}\n【要求】{prompt_conf['output_format']}\n【输入】{prompt_conf['template']}"
        prompt = prompt.replace("{{user_question}}", user_query).replace("{{knowledge_content}}", knowledge_text)
        return prompt

    def load_model_params(self) -> Dict:
        # 加载场景专属版本参数
        return MODEL_PARAM_VERSION_LIB.get(self.param_version)

    def llm_invoke(self, user_query: str, knowledge_text: str) -> str:
        # 模拟大模型调用,串联所有版本资源
        prompt = self.load_prompt_template(user_query, knowledge_text)
        params = self.load_model_params()

        # 此处可替换为真实大模型SDK调用
        self.result = f"【版本化生成结果】基于{self.prompt_version}提示词、{self.param_version}参数、{self.kb_version}知识库生成:{user_query}已依据考勤制度完成解答。"
        return self.result

    def save_trace_log(self) -> Dict:
        # 全链路存档:一次调用,留存所有版本信息,可回溯
        trace_data = {
            "call_id": self.call_id,
            "call_time": self.call_time,
            "scene": self.scene,
            "prompt_version": self.prompt_version,
            "model_param_version": self.param_version,
            "kb_snapshot_version": self.kb_version,
            "user_input": self.load_prompt_template("", ""),
            "model_params": self.load_model_params(),
            "generate_result": self.result
        }
        # 可落地:写入数据库/日志文件持久化
        print(json.dumps(trace_data, ensure_ascii=False, indent=2))
        return trace_data

# ====================== 3. 业务调用示例 ======================
if __name__ == "__main__":
    # 1. 初始化本次调用绑定的所有资源版本
    runtime = LLMRuntimeVersionManager(
        scene="企业考勤问答",
        prompt_version="QA_V1.0.0",
        param_version="QA_SCENE_V1.0",
        kb_version="20260901_STABLE"
    )

    # 2. 业务请求执行
    user_question = "员工工作日加班如何申请调休?"
    kb_reference = "公司规定:工作日加班可在1个月内申请等额调休,需提前在OA提交申请并审批。"
    res = runtime.llm_invoke(user_question, kb_reference)

    # 3. 全链路日志存档(可用于问题溯源、版本复盘)
    runtime.save_trace_log()
重点说明:
- 版本强绑定:单次调用唯一ID串联提示词版本、模型参数版本、知识库快照版本,彻底解决资源混乱问题。
- 可回溯可复盘:自动存档全链路数据,通过call_id可精准复现每一次生成的配置与结果,支撑问题排查。
- 工程化适配:配置与代码解耦,新增版本仅需更新配置字典,无需改动业务逻辑,适配迭代规范。
输出结果:
{
"call_id": "ed1897b0-c149-4b28-90fe-ed8c9de248aa",
"call_time": "2026-09-01 21:21:54",
"scene": "企业考勤问答",
"prompt_version": "QA_V1.0.0",
"model_param_version": "QA_SCENE_V1.0",
"kb_snapshot_version": "20260901_STABLE",
"user_input": "【角色】你是企业内部考勤智能问答助手,熟悉公司考勤管理制度,专业解答员工考勤相关咨询。\n【规则】1. 所有回答严格依据公司考勤制度,无制度依据的如实告知用户;2. 回答简洁通俗,不使用专业晦涩术语;3. 禁止输出无关内容,不随意编造信息。\n【要求】分点清晰作答,先明确答案,再补充对应制度依据。\n【输入】用户问题:;参考制度:",
"model_params": {
"temperature": 0.1,
"top_p": 0.3,
"max_tokens": 2000,
"frequency_penalty": 1.0
},
"generate_result": "【版本化生成结果】基于QA_V1.0.0提示词、QA_SCENE_V1.0参数、20260901_STABLE知识库生成:员工工作日加班如何申请调休?已依据考勤制度完成解答。"
}
六、知识库版本管理
1. 知识库版本快照
RAG架构下,知识库数据稳定性直接决定问答准确率,通过快照机制实现知识库全量版本回溯,保障数据可还原、可追溯,核心能力说明:
- 双模式快照备份:支持定时快照与手动快照。定时快照可配置每日、每周自动备份全量知识库数据、切片规则、向量索引;手动快照用于重大更新、批量修改前的人工备份,提前留存稳定版本。
- 全维度版本留存:每轮快照生成唯一版本号,完整记录快照时间、数据总量、切片参数、更新内容,完整复刻当前知识库全量状态。
- 一键回退与分层存储:知识库更新出错、检索效果下滑时,可通过快照一键还原稳定版本。同时采用分层存储策略,长期留存稳定版本、短期留存测试版本,兼顾数据安全与存储成本。
2. 增量更新追溯
企业知识库日常以少量增量更新为主,无需频繁全量快照,配套搭建增量更新追溯机制,精准细化记录每一条数据变更,核心能力说明:
- 逐条变更记录:系统自动识别知识库新增、修改、删除数据,逐条留存数据ID、变更内容、变更时间、操作人、变更类型,实现精细化溯源。
- 问题精准定位:模型出现信息滞后、答案错误等问题时,可通过交互绑定的版本信息,追溯对应时段的增量变更记录,快速判定问题是否由数据更新失误导致。
- 增量版本对比:支持新旧增量数据差异化对比,直观查看内容变动细节,精准定位问题数据,高效完成修复优化。
3. 检索规则管控
知识库效果波动不仅源于原始数据,切片、检索等配套规则的变动也是核心诱因,需将所有规则纳入版本管控,具体管控范围:
- 核心规则版本留存:对切片大小、文本重叠度、检索置信阈值、召回数量、重排规则等核心参数统一版本记录,每次调整均生成独立版本。
- 数据与规则版本绑定:检索规则版本与知识库数据快照版本强绑定,确保同一批次数据始终搭配统一检索规则,避免规则混乱导致效果波动。
- 隐性问题快速排查:通过规则版本回溯,可快速排查切片过碎、重叠不足、召回量过少等隐性问题,全方位覆盖知识库链路溯源场景。
七、生成结果回溯
1. 全量结果存档
实现全链路复盘溯源的核心,是完成线上交互结果全量存档,不留数据死角,系统自动留存每次交互的完整核心数据,具体包含:
- 唯一调用ID、用户原始提问内容;
- 本次检索获取的知识库参考内容;
- 本次生效的提示词、模型参数、知识库版本;
- 模型最终生成结果、接口调用耗时、调用状态;
- 调用异常信息、报错日志等全维度数据。
2. 问题溯源流程
搭建标准化反向问题溯源流程,实现从异常结果到根源的快速排查,流程清晰、落地性强,完整四步闭环流程:
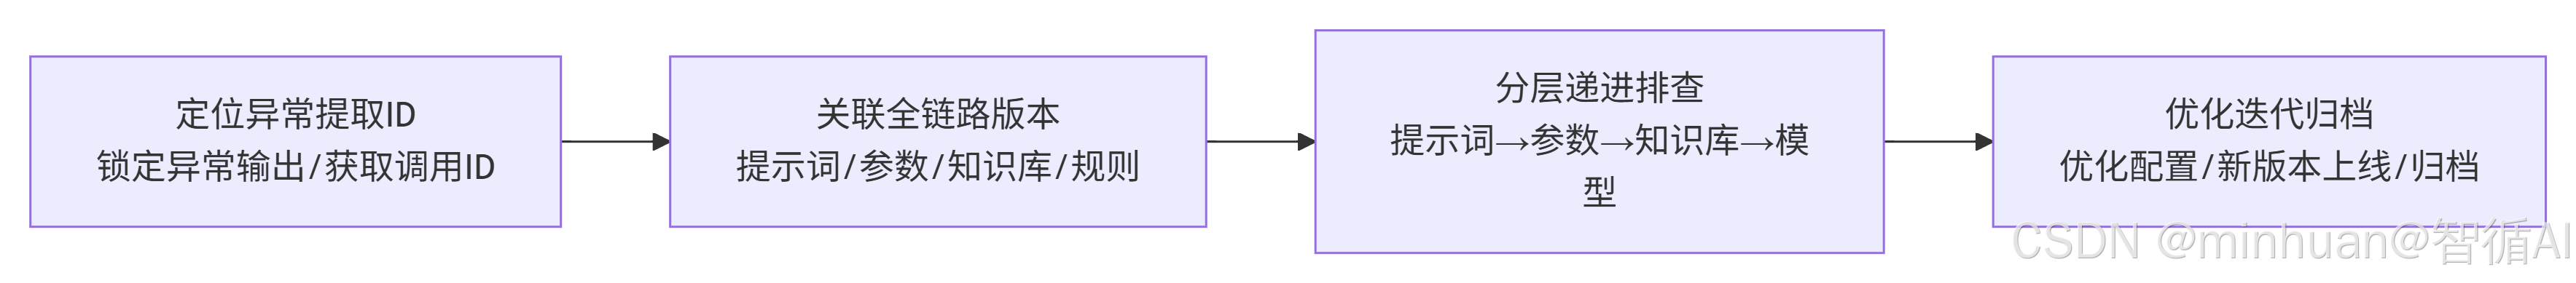
- 第一步:定位异常、提取标识:根据用户反馈或系统监控,锁定异常模型输出内容,提取本次交互唯一调用ID。
- 第二步:关联全链路资源版本:通过调用ID,一键调取本次交互生效的所有资源配置,包含提示词版本、模型参数版本、知识库快照版本、检索规则版本。
- 第三步:分层递进排查问题:按优先级逐层排查,先校验提示词规则漏洞,再核查模型参数场景适配性,随后验证知识库数据与检索内容准确性,最后排查模型本身输出异常。
- 第四步:优化迭代、闭环归档:针对定位的问题优化对应资源配置,生成新版本并测试上线,同时将问题原因、优化方案、迭代效果完整归档,形成复盘闭环。
3. 数据复盘迭代
依托全量存档的交互数据,可实现大模型应用常态化精细化复盘与迭代优化,核心落地方式:
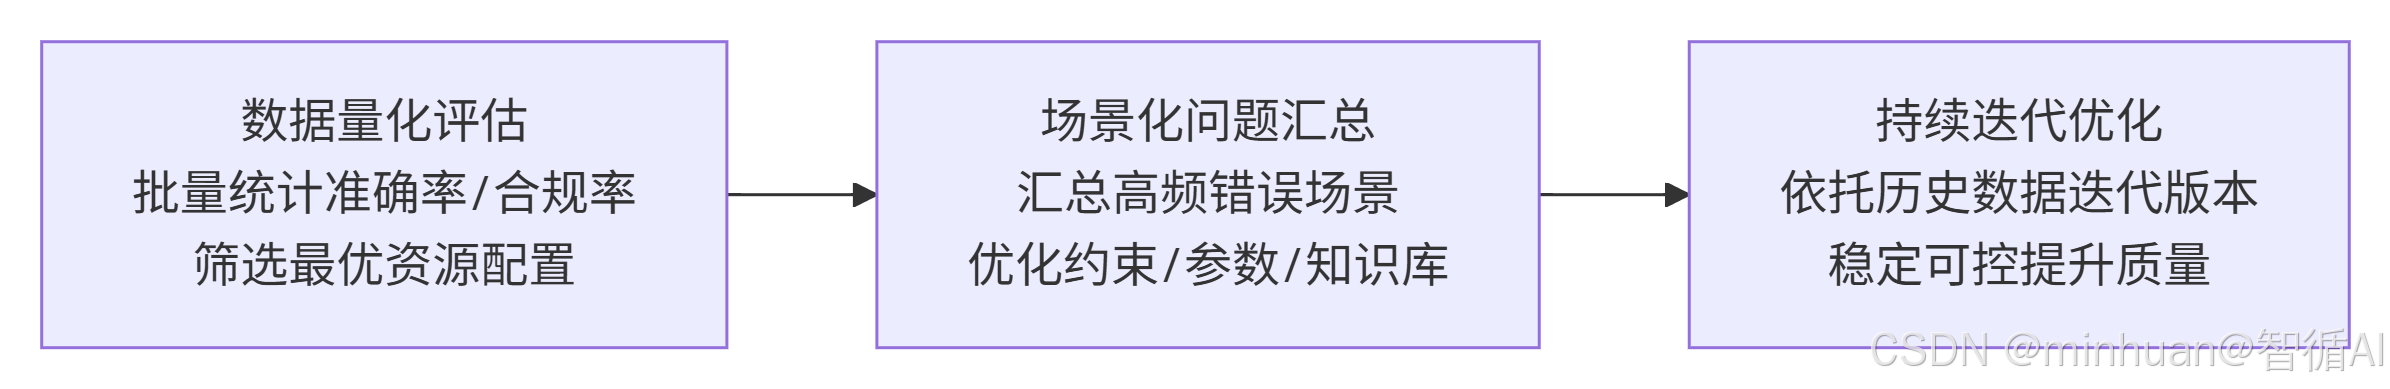
- 数据量化评估:批量统计不同版本提示词、参数、知识库的输出准确率、合规率、错误率、用户差评率,以数据量化筛选最优资源配置方案。
- 场景化问题汇总:汇总线上高频错误场景、高频问答问题,针对性优化提示词约束规则、微调模型参数、补充修正知识库数据。
- 持续迭代优化:依托历史数据持续迭代资源版本,逐步降低错误率、提升输出质量,实现AI应用效果的稳步优化、稳定可控。
八、落地流程
1. 资源初始化
机制落地第一步为全量资源初始化,统一归集零散资源、搭建标准化管控底座,完整操作流程:
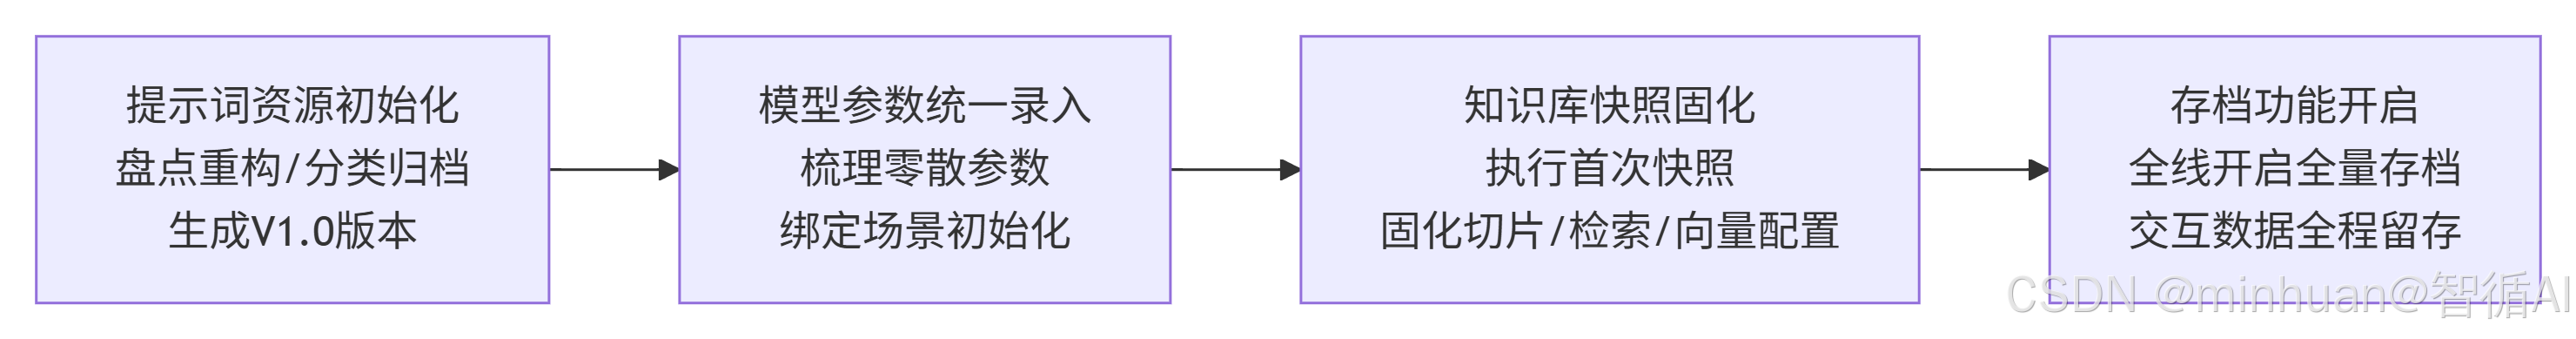
- 提示词资源梳理初始化:盘点所有业务提示词,剔除无效、冗余模板,按照标准化框架重构优化,分类归档并生成初始稳定版本V1.0。
- 模型参数统一录入:梳理各业务场景原有零散参数,统一录入版本管理平台,与对应场景绑定,完成参数版本初始化。
- 知识库快照固化:对现有全量知识库执行首次快照,生成初始稳定版本,固化当前切片规则、检索参数、向量索引配置。
- 存档功能开启配置:全线开启模型交互结果全量存档功能,确保后续所有用户交互、模型调用数据全程留存、可追溯。
2. 版本迭代规范
为避免资源随意变更、迭代混乱,制定标准化版本迭代规范,所有资源更新严格遵循触发条件与流程要求:
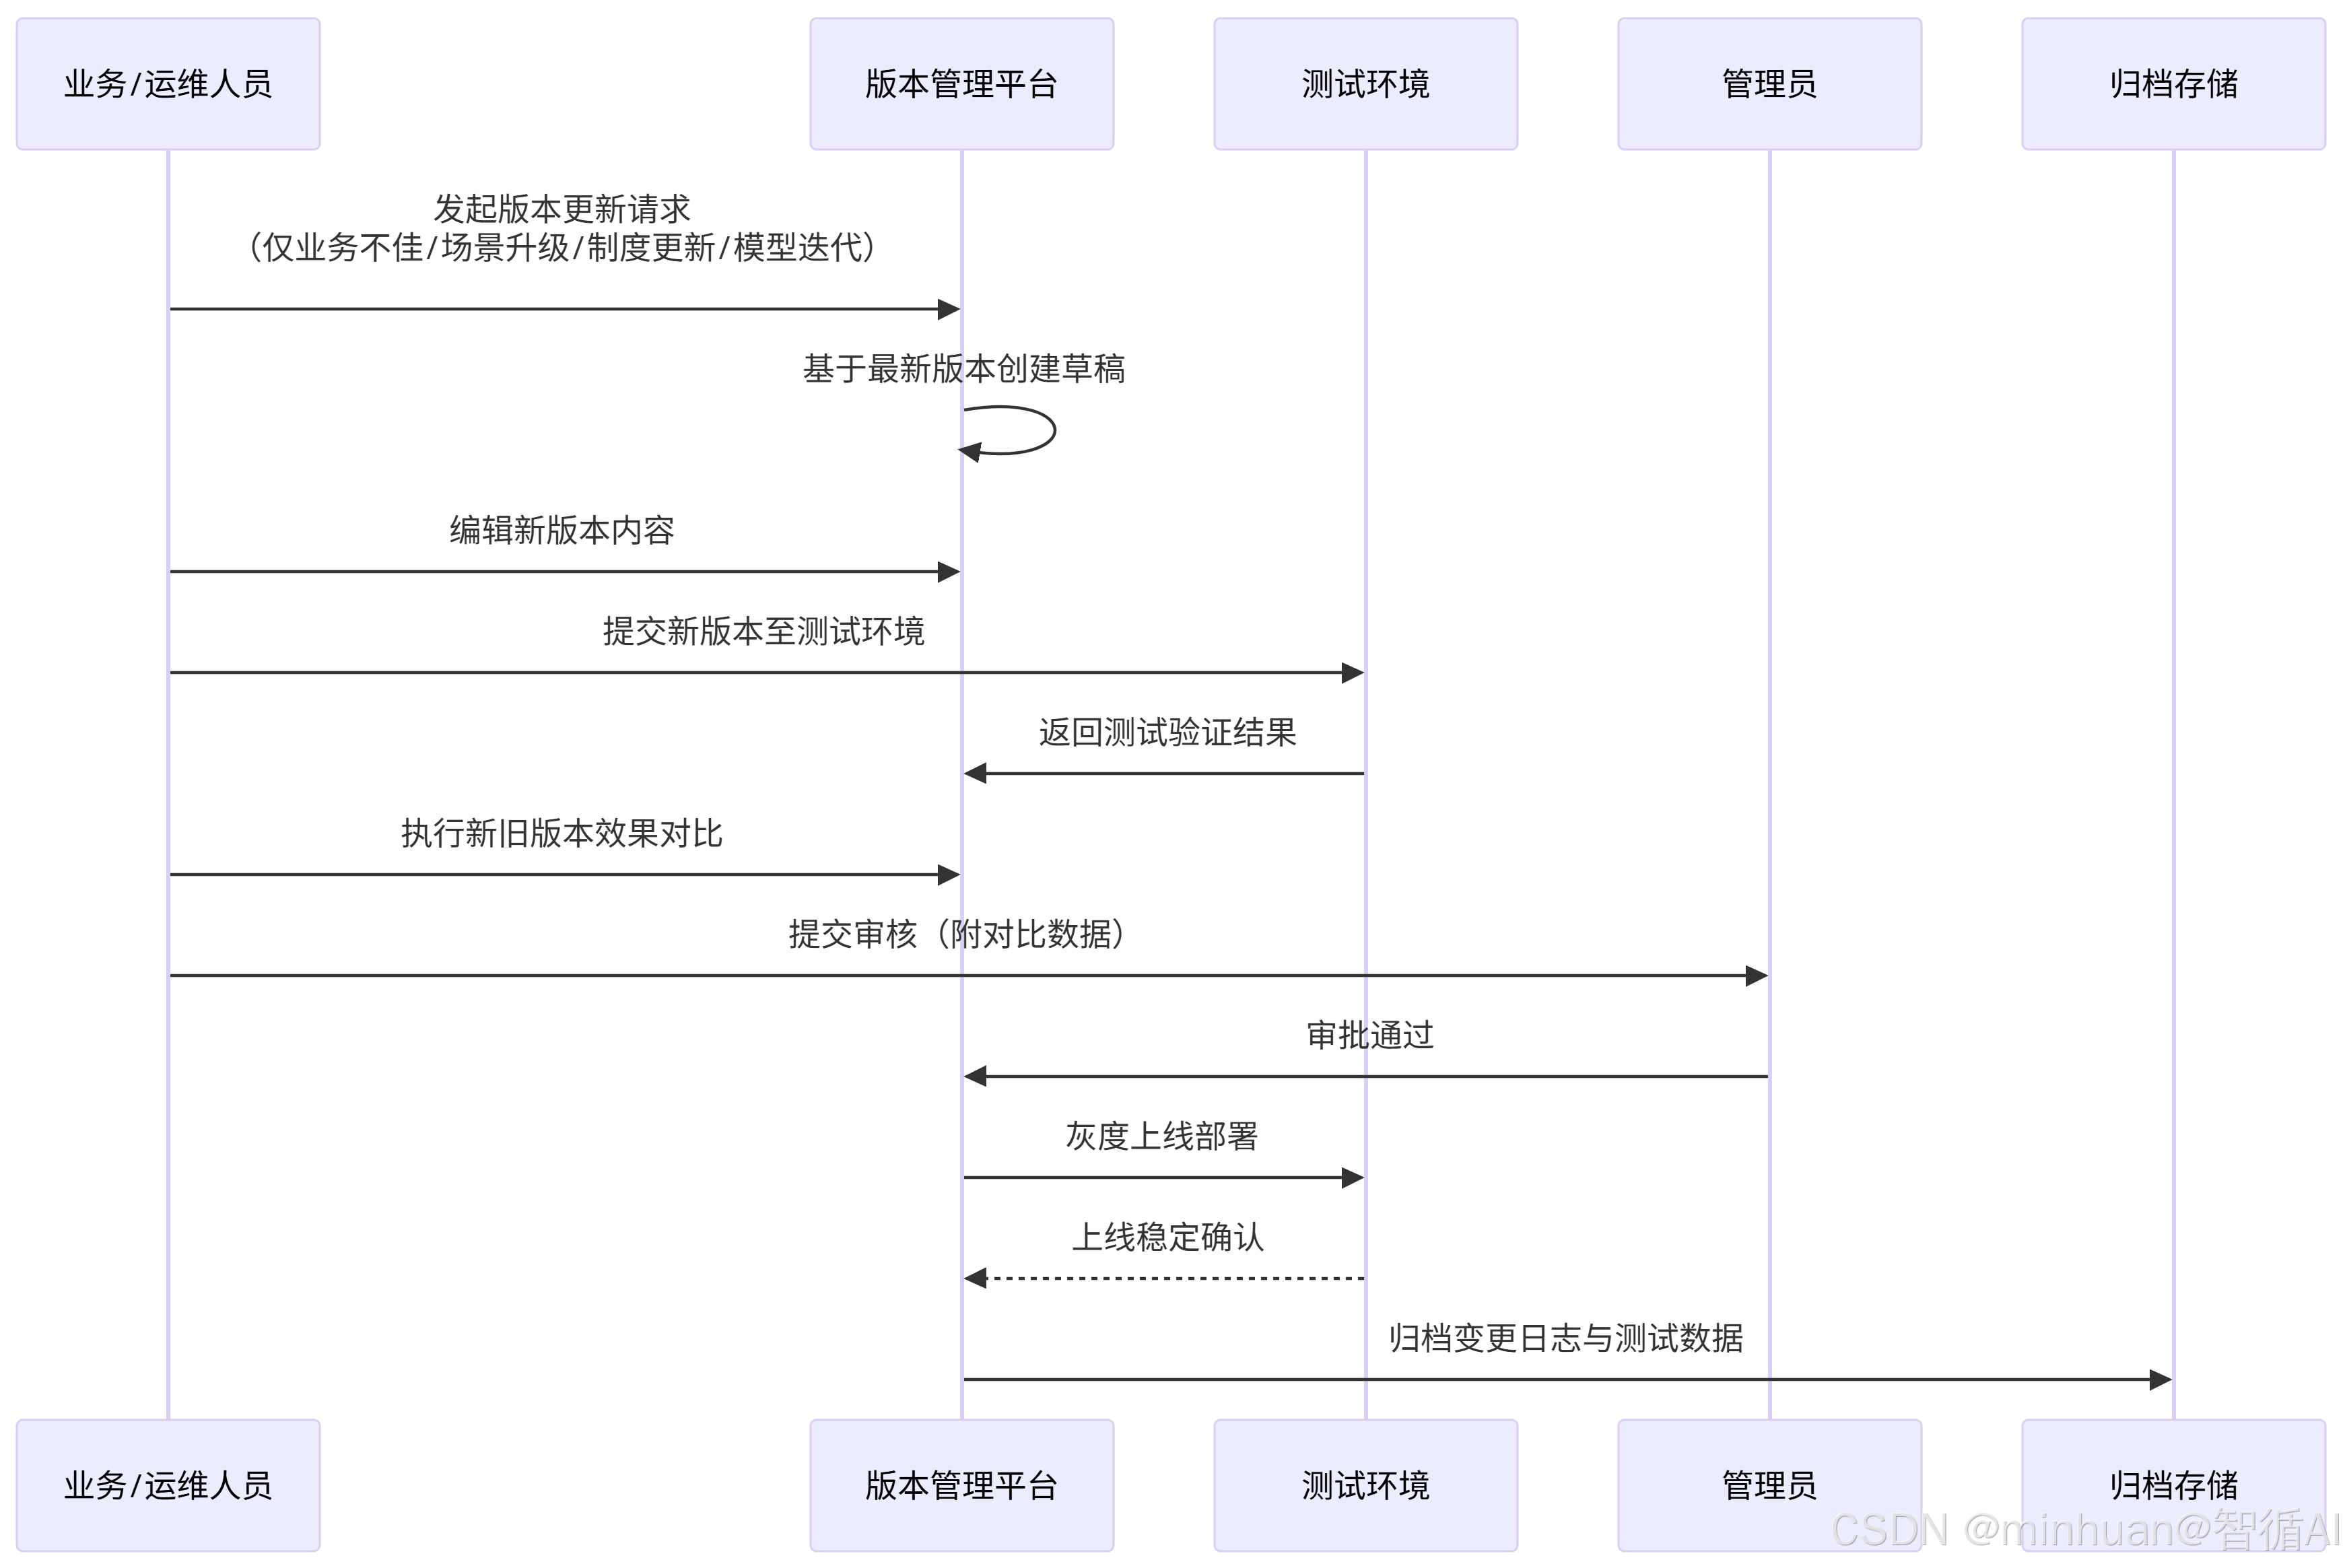
- 迭代触发条件:仅在业务效果不佳、业务场景升级、企业制度更新、底层模型迭代四种场景下,可发起资源版本更新,杜绝无意义、无价值的随意修改。
- 标准化迭代五步法:严格按照「编辑新版本→测试环境验证→新旧效果对比→管理员审核→灰度上线归档」流程执行。
- 迭代质量管控:所有新版本必须完成效果测试,确认优化升级后方可上线;上线稳定后完整归档变更日志、测试数据,形成迭代闭环,保障版本质量。
流程说明:
- 触发条件:仅在四种场景(效果不佳、场景升级、制度更新、模型迭代)下发起版本更新。
- 五步迭代:编辑新版本 → 测试验证 → 新旧效果对比 → 管理员审核 → 灰度上线归档。
- 质量管控:新版本必须通过效果测试,稳定后归档完整变更日志,形成闭环。
3. 日常运维复盘
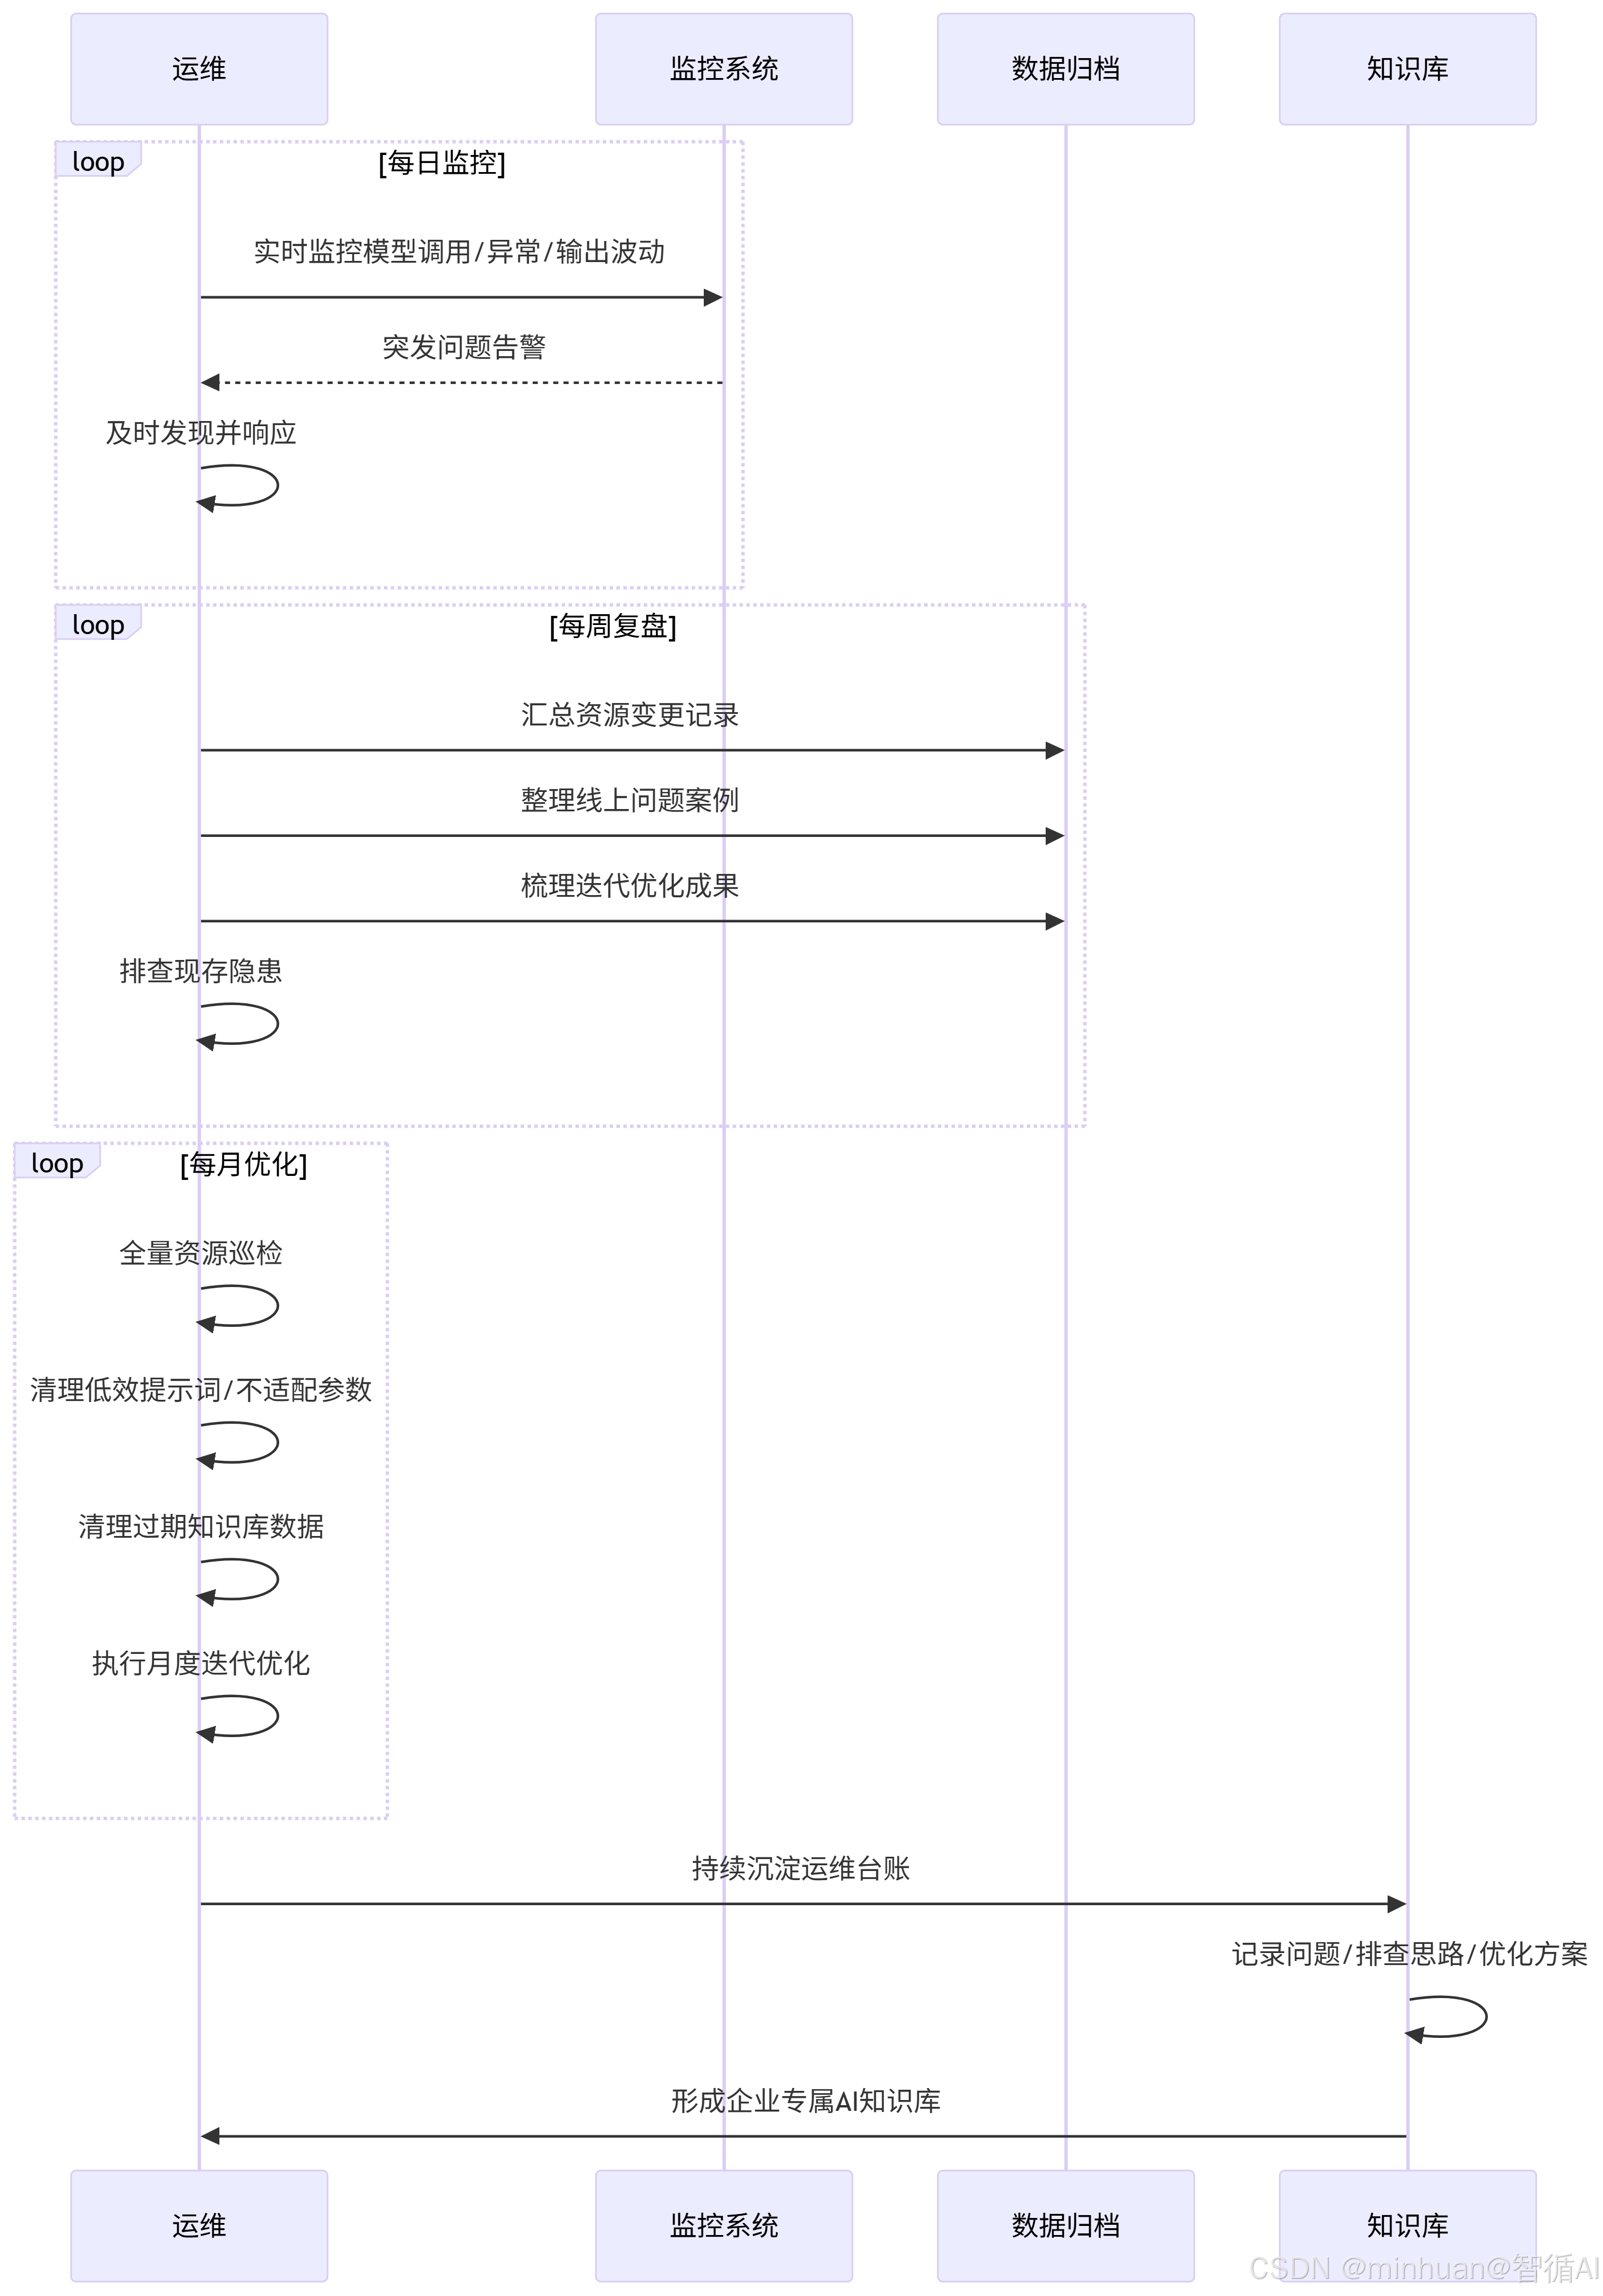
建立常态化运维复盘机制,保障版本管控体系长效稳定运行,持续优化AI应用效果,核心运维节奏:
- 每日监控:实时监控线上模型调用状态、异常报错、输出效果波动,及时发现突发业务问题。
- 每周复盘:汇总本周资源变更记录、线上问题案例、迭代优化成果,梳理现存隐患。
- 每月优化:开展全量资源巡检,清理低效提示词模板、不适配参数、过期知识库数据,完成月度迭代优化。
- 台账沉淀:持续沉淀运维台账,记录所有线上问题、排查思路、优化方案,形成企业专属大模型落地知识库。
运维体系说明:
| 频率 | 核心动作 | 目标 |
|---|---|---|
| 每日监控 | 实时监控调用状态、异常报错、效果波动 | 及时发现突发业务问题 |
| 每周复盘 | 汇总资源变更、问题案例、优化成果 | 梳理现存隐患 |
| 每月优化 | 全量资源巡检,清理低效模板/参数/数据 | 月度迭代优化 |
| 台账沉淀 | 持续记录问题、思路、方案 | 沉淀企业专属知识库 |
九、总结
大模型应用的工程化落地,核心不在于模型调用功能的实现,而在于效果的稳定可控、可持续迭代。绝大多数AI应用落地后的瓶颈,并非模型能力不足,而是缺少标准化的资源管控体系,导致提示词混乱、参数失控、知识库漂移、结果无法复盘,让AI应用陷入“效果不稳定、迭代无依据、问题难解决”的恶性循环。
通过拆解的提示词模板与模型参数版本化管理机制,实现分层架构设计,从提示词标准化、模型参数场景化、知识库快照化、生成结果全链路回溯四个核心维度,彻底解决大模型应用落地的核心痛点。对于企业大模型落地而言,版本化、可回溯的管理机制是AI应用从能用走向好用、稳定、可商业化的关键基石。只有搭建完善的资源管控体系,才能让大模型应用摆脱经验化、随意化的开发模式,走向标准化、工程化、精细化的运营迭代,真正释放大模型的业务价值。


 扫一扫


 390


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


