



一、前言
不知道大家有没有在使用智能客服、语音导航、外卖点单AI、智能家居语音助手时,好奇一个问题:为什么AI能听懂我们随口说的杂乱语句,精准抓取关键信息,还能自动完成对应操作?比如我们说“明天上午十点帮我预约市中心的牙科门诊”,AI不会纠结语句语序、口语化语病,直接锁定时间、地点、服务类型三大核心信息,完成预约指令。
也曾有过好奇,了解其中的思路,后来逐步发现,支持这一切的核心底层技术,原来是Slot Filling槽位填充。在大模型普及之前,这项技术是传统NLP自然语言处理的核心模块;在大模型落地各行各业的当下,它更是AI实现语义理解、指令落地、场景化服务的关键基石。刚接触时,在疑惑中总会把Slot Filling和语义识别、文本分类混为一谈,深入了解后发现三者有着本质区别。文本分类是给整句话贴标签,语义识别是听懂语句核心意图,而Slot Filling是在听懂意图的基础上,精准抓取、补全、校验场景所需的关键信息。今天我们就深入拆解一下Slot Filling的核心原理、技术演进、大模型适配升级、实践应用与优化方案。
二、核心基础认知
1. 了解槽位填充
Slot Filling,中文标准释义为槽位填充,是自然语言处理中意图理解+信息抽取的核心技术,核心作用是从用户的自然口语、文本语句中,精准提取场景所需的关键结构化信息,补全任务所需的信息缺口,让非结构化的人类语言,转化为AI可识别、可执行的结构化数据。

通俗理解,我们可以把AI的每一项服务任务,想象成一张固定格式的空白表单。比如预约挂号任务,系统预设的空白表单包含三个必填槽位:就诊时间、就诊科室、就诊人。用户的口语化语句,就是填充表单的素材,而槽位填充技术,就是自动识别素材中的有效信息,精准填入对应表单空位的过程。
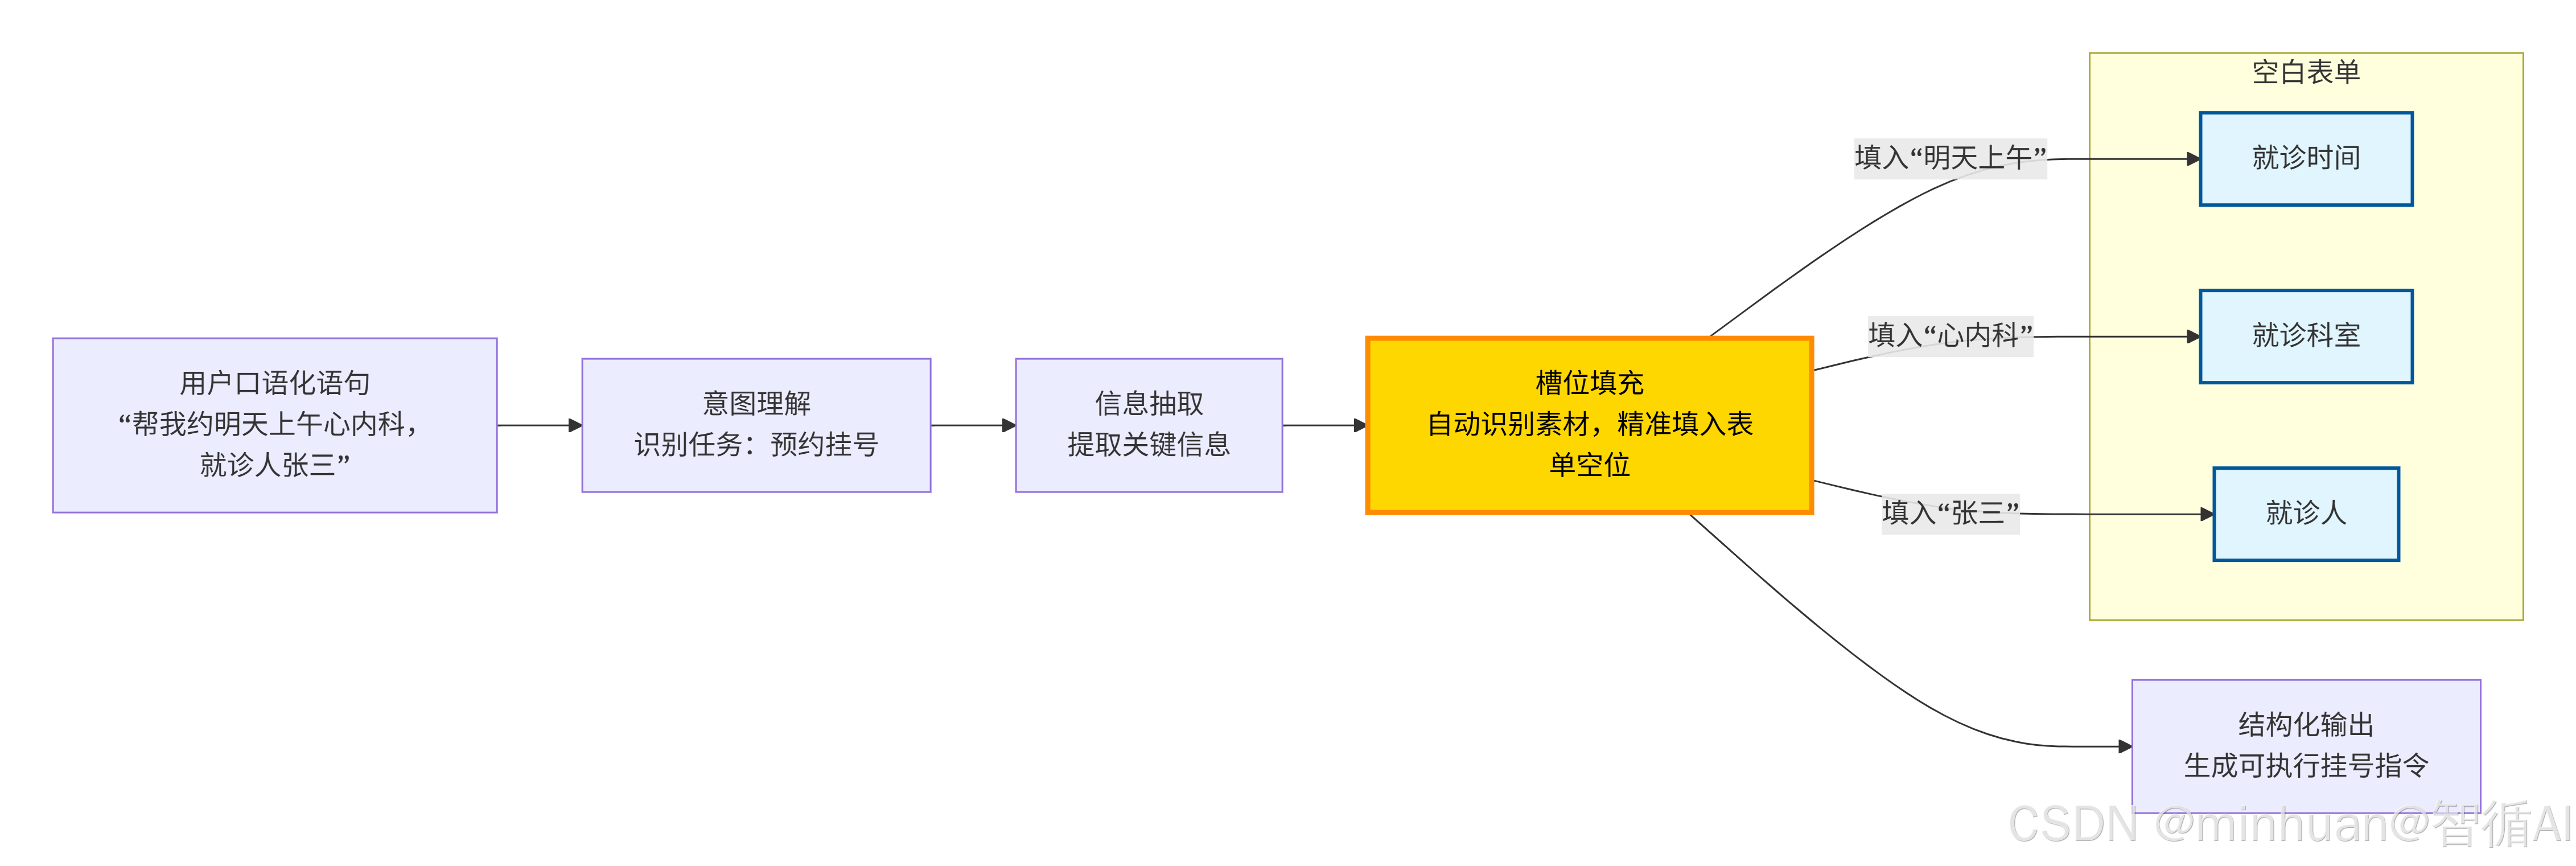
这里要区分两个核心基础概念,也是初学者必须掌握的核心知识点:
- 意图(Intent):指用户的核心需求、核心动作,是整个任务的核心方向。比如用户说“取消明天的机票”,核心意图就是“机票退订”;用户说“打开客厅空调”,核心意图就是“设备控制”。意图决定了AI要执行什么类型的任务。
- 槽位(Slot):指完成对应意图任务,必须具备的关键参数、关键信息字段,是任务落地的必要条件。不同的意图,对应完全不同的槽位体系,槽位的字段、数量、属性均由业务场景决定。
简单总结二者关系:意图定方向,槽位定细节。先通过语义识别判定用户想做什么(意图),再通过槽位填充抓取做这件事需要的所有关键信息(细节),二者结合,AI才能完整执行用户指令。
举一个完整的落地案例,帮助大家彻底理解:
- 用户输入“下周三下午三点,帮我从北京飞往上海订一张经济舱机票”。
- 首先AI识别核心意图为“机票预订”,随后激活机票预订场景的所有预设槽位,分别抓取对应信息:出行时间(下周三下午三点)、出发地(北京)、目的地(上海)、舱位等级(经济舱)。
- 所有必填槽位全部填充完成后,AI即可触发订票流程,完成用户需求。
如果用户语句缺失关键信息,比如只说“帮我订一张去上海的机票”,此时出发地、出行时间、舱位槽位为空,槽位填充技术会主动识别信息缺口,驱动AI主动追问用户,补全缺失槽位,这也是智能对话主动提问的核心原理。
2. 槽位核心分类
在大模型应用体系中,根据填充规则、必填属性、取值范围,槽位可分为四大核心类型,不同类型的槽位,对应完全不同的填充逻辑和模型处理方式。
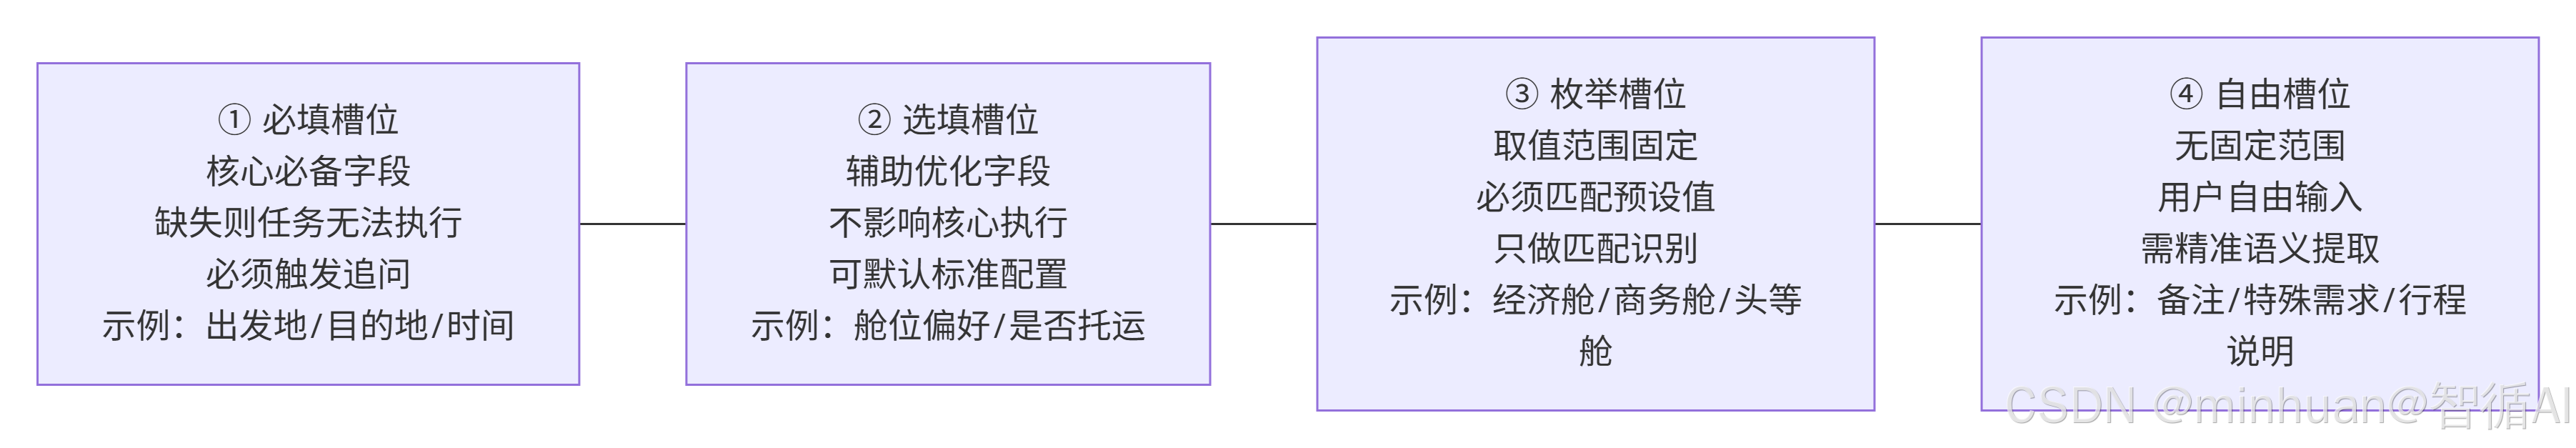
- 必填槽位:场景任务落地的核心必备字段,缺失则任务无法执行。比如机票预订的出发地、目的地、出行时间,外卖点单的收货地址、联系方式、菜品名称,均为必填槽位。模型检测到必填槽位为空时,必须触发追问机制。
- 选填槽位:不影响核心任务执行,仅用于优化服务细节、提升体验的辅助字段。比如机票预订的舱位偏好、是否托运、乘客类型,属于选填槽位,用户未说明时,系统可默认标准配置,无需追问。
- 枚举槽位:取值范围固定、有限定选项的槽位,用户输入内容必须匹配预设枚举值。比如舱位等级仅包含经济舱、商务舱、头等舱,科室仅包含内科、外科、牙科等预设选项,模型只需做匹配识别,无需自主生成内容。
-
自由槽位:无固定取值范围,用户可自由输入文本内容的槽位,对模型语义理解能力要求更高。比如用户备注、特殊需求、行程说明等,属于自由槽位,需要模型精准提取任意文本信息。
传统小模型时代,自由槽位的填充准确率极低,容易出现信息漏提、错提的问题,而大模型凭借超强的语义理解、上下文关联能力,大幅提升了自由槽位的填充精度,这也是大模型赋能Slot Filling技术的核心优势之一。
三、技术发展演进
1. 传统填充技术
在大模型诞生之前,Slot Filling技术经历了规则模板、传统机器学习、浅层预训练模型三个发展阶段,这三类传统技术方案至今仍在部分简单场景使用,但整体存在明显的局限性,无法适配复杂口语化场景。
第一阶段:规则模板法,是最早、最基础的槽位填充方案,核心逻辑是人工编写大量正则表达式、关键词匹配规则,通过关键词命中、语句匹配完成槽位填充。比如预设“从XX到XX”匹配出发地和目的地,“周X+上/下午+时间”匹配出行时间。
- 这种方案的优势是开发成本低、响应速度快、零训练成本,适合极其简单的固定场景,比如基础的智能家居指令识别。
- 但缺点极其致命,完全无法适配口语化、语序颠倒、存在语病、多信息混杂的语句,用户只要改变表达方式,规则就会失效,泛化能力几乎为零。
第二阶段:传统机器学习法,为了解决规则模板的僵化问题,行业引入CRF条件随机场、SVM支持向量机等传统机器学习模型。核心逻辑是人工提取文本词性、句法、语义等特征,输入模型进行训练,让模型自动学习槽位对应特征,完成信息抽取。
- 相比规则模板,该方案具备一定的泛化能力,能够适配常规语序的不同表达方式,准确率大幅提升,曾广泛应用于早期智能客服、票务系统。
- 但缺陷依然明显,需要大量人工特征工程,依赖专业算法人员调优,无法理解上下文语义,面对歧义语句、省略语句、复杂口语场景,识别错误率极高。
第三阶段:浅层预训练模型法,以BERT、RoBERTa等小型预训练模型为核心,彻底摆脱人工特征工程,模型可自动提取文本深层语义特征,结合上下文信息完成槽位填充。这一阶段的技术准确率、泛化能力达到传统技术天花板,成为大模型落地前的主流方案。
- 但该方案仍存在核心短板:上下文窗口有限,无法处理长文本、多轮对话场景;
- 无法自主纠错,面对用户模糊表述、语义歧义时,容错率低;
- 不具备推理能力,只能机械抽取显性信息,无法推导隐性槽位信息。
2. 大模型填充技术
大模型LLM的出现,彻底重构了Slot Filling的技术体系,将槽位填充从“机械信息抽取”升级为“语义理解+逻辑推理+动态适配”的智能填充模式,解决了传统技术的所有核心痛点,也是目前主流的落地方案。
大模型槽位填充的核心优势,主要体现在四个维度:
- 超强口语适配能力:传统模型极度依赖规范语句,而大模型可完美适配口语化、语序颠倒、重复啰嗦、存在语病、网络用语等各类非规范文本。比如用户说“后天好像早上八点吧,我要从广州去成都坐飞机”,大模型可自动过滤冗余词汇,精准提取有效槽位信息,无需人工规则适配。
- 上下文多轮关联:大模型具备超长上下文窗口,可记忆多轮对话信息,实现跨轮次槽位补全。比如第一轮用户说“我要订机票”,第二轮说“明天走”,第三轮说“去杭州”,大模型可整合三轮对话信息,完整填充所有槽位,这是传统模型完全无法实现的能力。
- 隐性信息推理能力:传统模型只能抽取文本中显性存在的信息,大模型可通过语义逻辑、常识推理,补全隐性槽位信息。比如用户说“我明天要从深圳去北京出差,订一张最快的机票”,模型可自主推理“最快”对应早班直飞机票,补全用户未明说的隐性需求槽位。
- 动态槽位适配:传统模型槽位体系固定,无法灵活调整,大模型可通过Prompt指令,动态适配不同场景的槽位规则,无需重新训练模型,快速适配新业务、新场景,落地效率大幅提升。
目前大模型槽位填充主要分为两种落地模式,分别适配不同业务场景:
- 一是Prompt零样本/少样本填充,无需微调模型,通过清晰的指令提示,让通用大模型直接完成槽位抽取,适合快速落地、低频场景;
- 二是微调专项填充,基于业务专属数据微调大模型,优化特定场景的槽位准确率,适合高频、高精度需求的核心业务。
四、核心运行流程
1. 前置准备阶段
槽位填充的完整落地流程分为前置准备、实时推理、后置优化三个核心阶段,其中前置准备是基础,直接决定最终填充准确率,很多落地项目效果差,核心问题都出在前置配置不完善。
前置准备阶段的核心工作,是搭建标准化的场景槽位体系,主要包含三个关键步骤,所有大模型Slot Filling落地项目都必须完成:
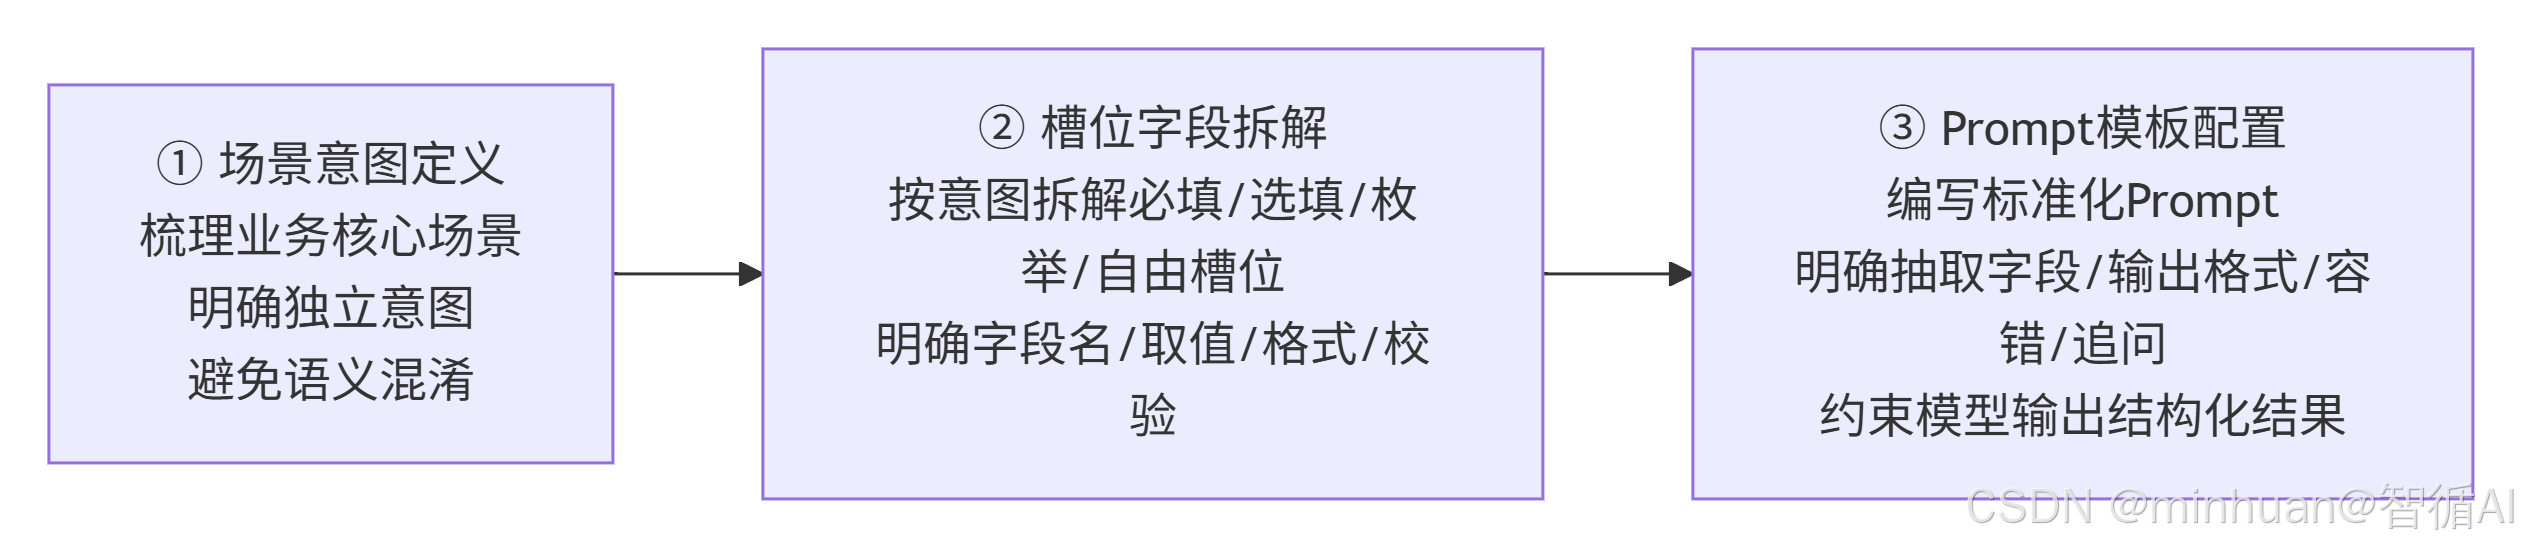
- 场景意图定义:梳理业务所有核心场景,明确每个场景对应的独立意图。比如智能客服场景,可拆分出订单查询、退款申请、物流咨询、售后投诉等多个独立意图,每个意图相互独立,避免语义混淆,确保模型精准判定用户需求方向。
- 槽位字段拆解:针对每一个意图,拆解对应的必填、选填、枚举、自由槽位,明确每个槽位的字段名称、取值规则、数据格式、校验标准。以“退款申请”意图为例,必填槽位包含订单编号、退款原因、退款金额,选填槽位包含用户备注、凭证图片,枚举槽位包含退款类型(全额/部分退款)。
- Prompt模板配置:针对场景槽位规则,编写标准化Prompt指令,明确告知大模型需要抽取的槽位字段、输出格式、容错规则、追问逻辑。规范的Prompt是零样本槽位填充的核心,能够约束大模型输出结构化结果,避免自由生成导致的格式混乱。
前置准备的核心原则是“精细化、标准化”,槽位拆分过粗会导致信息缺失,拆分过细会增加模型推理压力,需要结合业务实际需求平衡精度与效率。
2. 实时推理阶段
实时推理阶段是用户交互的核心过程,也是槽位填充的执行核心,从用户输入文本/语音,到完成槽位填充、触发任务执行,全程分为五个连贯步骤,流程清晰、层层递进。
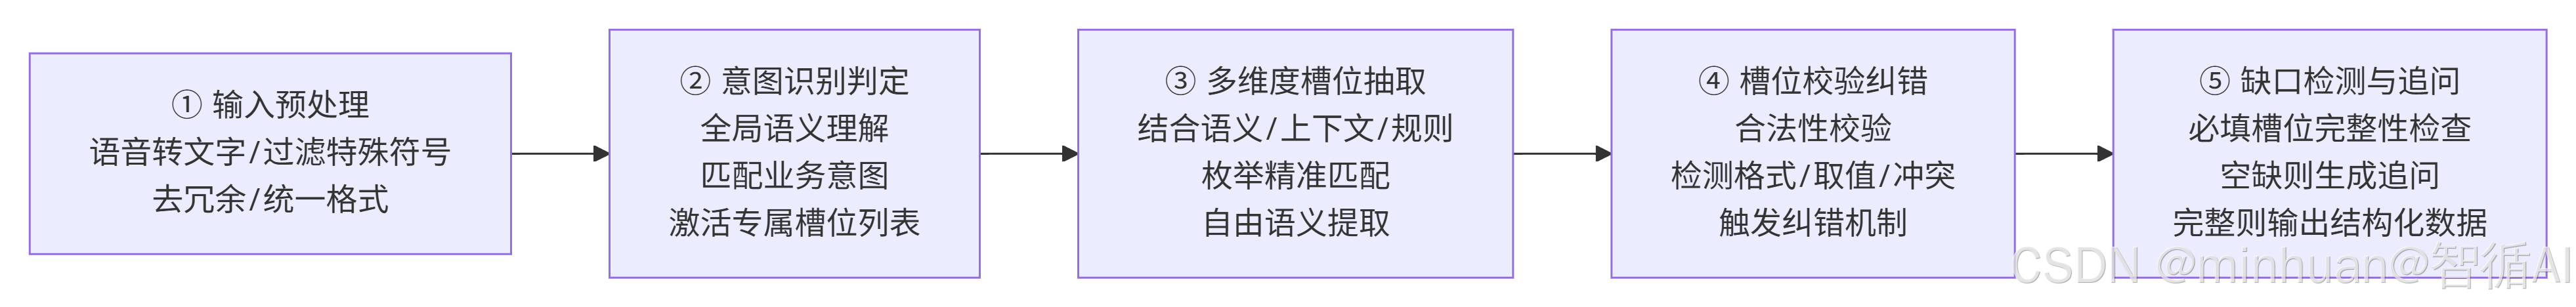
- 第一步:输入预处理:首先对用户输入内容进行清洗处理,语音输入先完成语音转文字,文本输入过滤特殊符号、无效冗余词汇、重复内容、表情符号,统一文本格式,去除干扰信息,为后续语义理解做铺垫。
- 第二步:意图识别判定:大模型对预处理后的文本进行全局语义理解,精准匹配预设业务意图,锁定当前用户的核心需求场景,激活该场景对应的专属槽位列表,关闭无关场景槽位,避免无效抽取。
- 第三步:多维度槽位抽取:模型结合单句语义、上下文对话历史、场景规则,逐一抽取、匹配、填充对应槽位信息。针对枚举槽位做精准匹配,针对自由槽位做语义提取,针对隐性需求做逻辑推理,完成初步信息填充。
- 第四步:槽位校验纠错:模型对填充完成的槽位数据进行合法性校验,检测是否存在格式错误、取值超标、信息冲突、内容歧义等问题。比如检测到时间槽位为过去时间、金额槽位为负数,自动判定为无效数据,触发纠错机制。
- 第五步:缺口检测与追问:校验完成后,系统检测所有必填槽位是否全部填充完整,若存在空缺,按照优先级自动生成自然追问语句,引导用户补充信息;若全部填充完整,输出结构化槽位数据,触发后续业务流程。
整个实时推理过程耗时极短,大模型轻量化推理可实现毫秒级响应,完全满足人机实时交互的体验需求,这也是智能对话流畅度的核心保障。
3. 后置优化阶段
后置优化是保障槽位填充长期稳定、持续提效的关键环节,很多上线项目初期效果良好,后期准确率持续下降,就是缺少常态化后置优化机制。该阶段核心包含数据沉淀、模型迭代、规则优化三项工作。
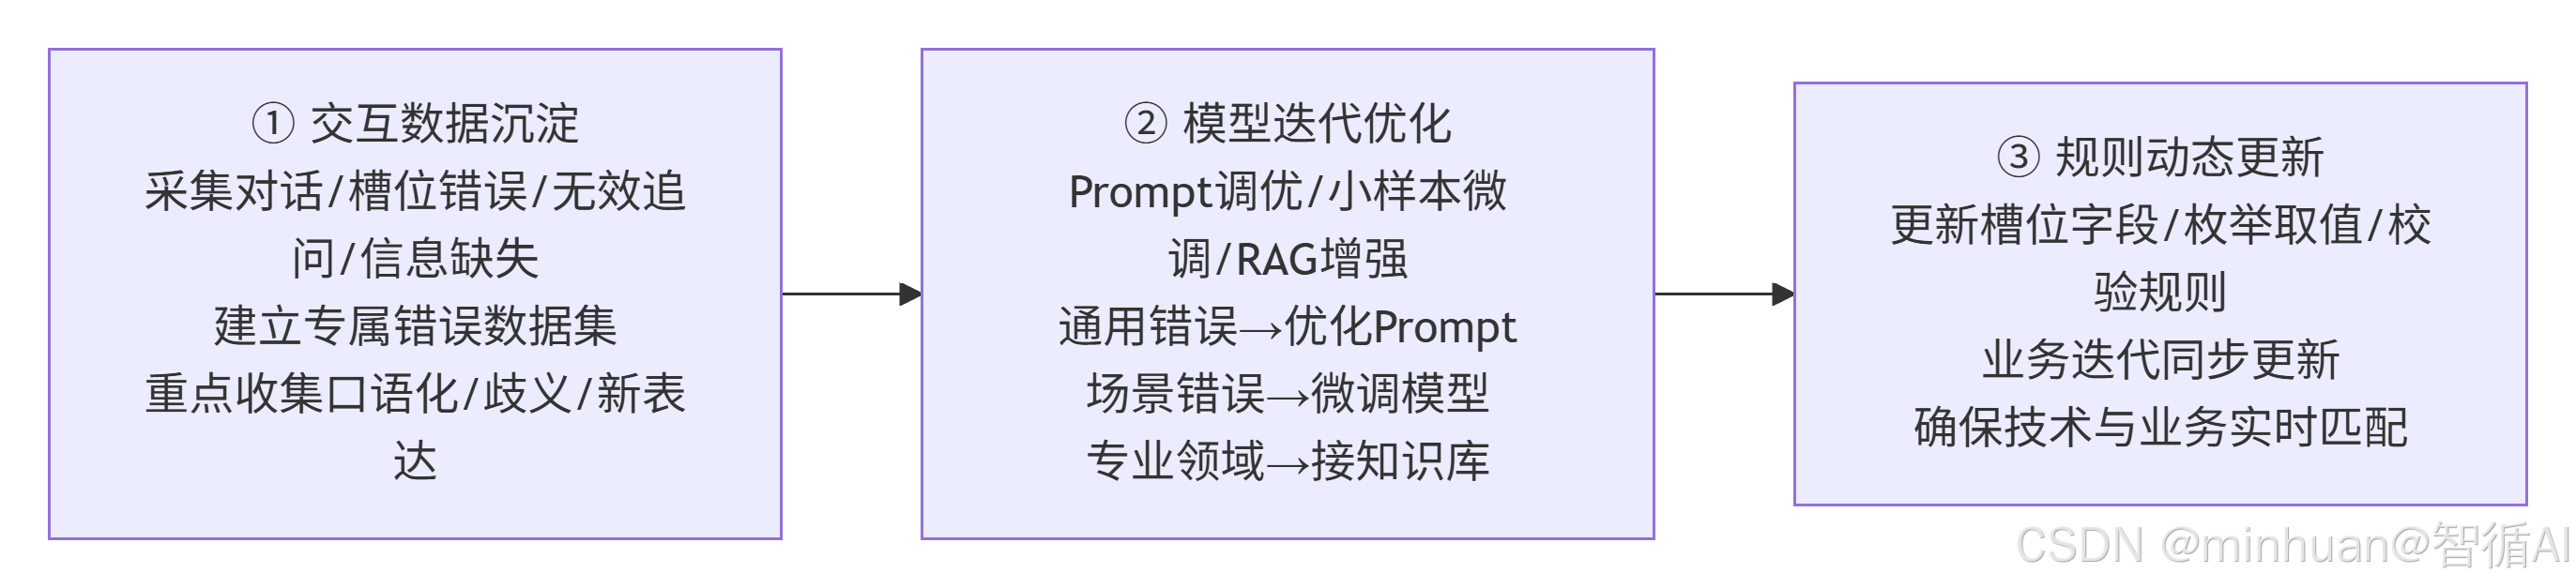
- 首先是交互数据沉淀,实时采集用户对话数据、槽位填充错误案例、无效追问案例、信息缺失案例,建立专属业务错误数据集。重点收集口语化复杂语句、歧义语句、新型用户表达方式,为模型迭代提供真实场景数据支撑。
- 其次是模型迭代优化,针对高频错误案例,通过Prompt调优、小样本微调、RAG检索增强等方式优化模型能力。对于通用错误,优化Prompt指令规则;对于场景专属错误,用业务数据微调模型;对于专业领域信息,接入知识库检索,提升槽位填充精度。
- 最后是规则动态更新,结合业务迭代需求,实时更新槽位字段、枚举取值、校验规则。比如新增业务类型、调整服务范围时,同步更新对应槽位规则,确保技术能力与业务需求实时匹配,避免规则滞后导致的填充失效。
五、应用实践示例
1. 零样本Prompt实现槽位填充
本示例演示基于混元hy3-preview的机票预订Slot Filling:LLM零样抽取出发地、目的地、时间、舱位、人数五槽位,流式输出严格JSON,缺失必填槽时生成追问话术,实现多轮对话式信息收集。
import os
import json
import requests

# 配置混元模型API信息
API_KEY = os.environ.get('TENCENT_API_KEY')
API_URL = "https://tokenhub.tencentmaas.com/v1/chat/completions"

def stream_chat(prompt: str):
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json"
    }
    payload = {
        "model": "hy3-preview",
        "messages": [{"role": "user", "content": prompt}],
        "stream": True,  # 开启流式输出
        "max_tokens": 1024
    }

    try:
        response = requests.post(API_URL, headers=headers, json=payload, stream=True, timeout=60)
        response.raise_for_status()
        response.encoding = "utf-8"  # 服务端未返回charset时requests默认ISO-8859-1,强制UTF-8防止中文乱码
        # 逐行读取SSE流,拼接增量内容
        result = ""
        for line in response.iter_lines(decode_unicode=True):
            if not line or not line.startswith("data:"):
                continue
            data = line[len("data:"):].strip()
            if data == "[DONE]":
                break
            try:
                chunk = json.loads(data)
                delta = chunk["choices"][0]["delta"].get("content", "")
                if delta:
                    result += delta
                    print(delta, end="", flush=True)  # 实时打印流式输出
            except (json.JSONDecodeError, KeyError, IndexError):
                continue
        print()  # 流式输出结束后换行
        return result
    except requests.RequestException as e:
        print(f"\n[API请求失败] {e}")
        return ""


def _extract_json(raw: str) -> dict:
    """容错解析:剥离markdown代码块等干扰,仅取JSON部分"""
    raw = raw.strip()
    if raw.startswith("```"):
        raw = raw.split("```")[1]
        if raw.startswith("json"):
            raw = raw[4:]
    start, end = raw.find("{"), raw.rfind("}")
    if start != -1 and end != -1:
        raw = raw[start:end + 1]
    return json.loads(raw)


def slot_filling_llm(user_query: str) -> dict:
    """
    大模型零样本槽位填充 Slot Filling
    意图:机票预订
    槽位定义:
        departure: 出发地(必填)
        destination: 目的地(必填)
        travel_time: 出行时间(必填)
        cabin: 舱位,枚举:经济舱/商务舱/头等舱(选填,无则null)
        passenger_count: 乘客人数(选填,无则null)
    规则:
    1. 只提取文本中明确信息;没有则返回null
    2. 输出严格JSON,不要额外解释、不要markdown
    3. 检测必填槽位缺失时,need_ask=true,并给出追问话术ask_content
    """
    prompt = f"""
你是槽位抽取专家,执行机票预订场景Slot Filling。
槽位清单:
departure:出发地,destination:目的地,travel_time:出行时间,
cabin:舱位[经济舱/商务舱/头等舱],passenger_count:乘客人数。

输出JSON结构:
{{
  "intent": "机票预订",
  "slots": {{
    "departure": "xxx or null",
    "destination": "xxx or null",
    "travel_time": "xxx or null",
    "cabin": "xxx or null",
    "passenger_count": "xxx or null"
  }},
  "need_ask": true/false,
  "ask_content": "缺失信息的追问语句,无需缺失则为空字符串"
}}

用户输入:{user_query}
只返回JSON,禁止多余文字。
"""
    raw = stream_chat(prompt)
    return _extract_json(raw)


if __name__ == "__main__":
    # 测试样例1:信息完整
    print("====测试1:信息齐全语句====")
    res1 = slot_filling_llm("下周三下午三点,帮我从杭州飞往西安订一张经济舱机票,2个人")
    print(json.dumps(res1, ensure_ascii=False, indent=2))

    # 测试样例2:缺少必填槽位,需要追问
    print("\n====测试2:信息不全,触发追问====")
    res2 = slot_filling_llm("帮我订去上海的机票")
    print(json.dumps(res2, ensure_ascii=False, indent=2))

    # 测试样例3:口语化语序混乱
    print("\n====测试3:口语杂乱句子====")
    res3 = slot_filling_llm("后天早上吧,我从成都飞北京,商务舱")
    print(json.dumps(res3, ensure_ascii=False, indent=2))
输出结果:
====测试1:信息齐全语句====
{
"intent": "机票预订",
"slots": {
"departure": "杭州",
"destination": "西安",
"travel_time": "下周三下午三点",
"cabin": "经济舱",
"passenger_count": "2"
},
"need_ask": false,
"ask_content": ""
}
{
"intent": "机票预订",
"slots": {
"departure": "杭州",
"destination": "西安",
"travel_time": "下周三下午三点",
"cabin": "经济舱",
"passenger_count": "2"
},
"need_ask": false,
"ask_content": ""
}====测试2:信息不全,触发追问====
{
"intent": "机票预订",
"slots": {
"departure": null,
"destination": "上海",
"travel_time": null,
"cabin": null,
"passenger_count": null
},
"need_ask": true,
"ask_content": "请问您的出发地是哪里?出行时间是什么时候?需要订什么舱位?有几位乘客?"
}
{
"intent": "机票预订",
"slots": {
"departure": null,
"destination": "上海",
"travel_time": null,
"cabin": null,
"passenger_count": null
},
"need_ask": true,
"ask_content": "请问您的出发地是哪里?出行时间是什么时候?需要订什么舱位?有几位乘客?"
}====测试3:口语杂乱句子====
{
"intent": "机票预订",
"slots": {
"departure": "成都",
"destination": "北京",
"travel_time": "后天早上",
"cabin": "商务舱",
"passenger_count": null
},
"need_ask": true,
"ask_content": "请问您预订商务舱的乘客人数是多少?"
}
{
"intent": "机票预订",
"slots": {
"departure": "成都",
"destination": "北京",
"travel_time": "后天早上",
"cabin": "商务舱",
"passenger_count": null
},
"need_ask": true,
"ask_content": "请问您预订商务舱的乘客人数是多少?"
}
2. 多轮对话记忆槽位填充
本示例演示基于混元hy3-preview的多轮对话记忆Slot Filling:对话历史与已抽取槽位注入Prompt,模型增量更新槽位而非每次重抽,实现跨轮次信息累积;
import os
import json
import requests

# 配置混元模型API信息
API_KEY = os.environ.get('TENCENT_API_KEY')
API_URL = "https://tokenhub.tencentmaas.com/v1/chat/completions"

def stream_chat(prompt: str):
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json"
    }
    payload = {
        "model": "hy3-preview",
        "messages": [{"role": "user", "content": prompt}],
        "stream": True,  # 开启流式输出
        "max_tokens": 1024
    }

    try:
        response = requests.post(API_URL, headers=headers, json=payload, stream=True, timeout=60)
        response.raise_for_status()
        response.encoding = "utf-8"  # 服务端未返回charset时requests默认ISO-8859-1,强制UTF-8防止中文乱码
        # 逐行读取SSE流,拼接增量内容
        result = ""
        for line in response.iter_lines(decode_unicode=True):
            if not line or not line.startswith("data:"):
                continue
            data = line[len("data:"):].strip()
            if data == "[DONE]":
                break
            try:
                chunk = json.loads(data)
                delta = chunk["choices"][0]["delta"].get("content", "")
                if delta:
                    result += delta
                    print(delta, end="", flush=True)  # 实时打印流式输出
            except (json.JSONDecodeError, KeyError, IndexError):
                continue
        print()  # 流式输出结束后换行
        return result
    except requests.RequestException as e:
        print(f"\n[API请求失败] {e}")
        return ""


def _extract_json(raw: str) -> dict:
    """容错解析:剥离markdown代码块等干扰,仅取JSON部分"""
    raw = raw.strip()
    if raw.startswith("```"):
        raw = raw.split("```")[1]
        if raw.startswith("json"):
            raw = raw[4:]
    start, end = raw.find("{"), raw.rfind("}")
    if start != -1 and end != -1:
        raw = raw[start:end + 1]
    return json.loads(raw)


class MultiTurnSlotFilling:
    def __init__(self):
        self.history = []
        self.current_slots = {
            "departure": None,
            "destination": None,
            "travel_time": None,
            "cabin": None,
            "passenger_count": None
        }

    def predict(self, user_text: str):
        self.history.append({"role": "user", "content": user_text})
        prompt = f"""
【多轮槽位填充,机票预订场景】
已有槽位信息:{json.dumps(self.current_slots, ensure_ascii=False)}
对话历史:{json.dumps(self.history, ensure_ascii=False)}

规则:
1. 根据用户最新一句话更新槽位,旧信息保留,新信息覆盖旧值
2. 槽位:departure出发地,destination目的地,travel_time出行时间,cabin舱位,passenger_count人数
3. 输出JSON:updated_slots、need_ask、ask_content
只返回JSON,不要解释。
"""
        raw = stream_chat(prompt)
        data = _extract_json(raw)
        # 更新内存槽位
        self.current_slots = data["updated_slots"]
        return data

if __name__ == "__main__":
    bot = MultiTurnSlotFilling()
    print(bot.predict("我想订机票"))
    print(bot.predict("目的地上海"))
    print(bot.predict("后天上午出发,两个人"))
输出结果:
{
"updated_slots": {
"departure": null,
"destination": null,
"travel_time": null,
"cabin": null,
"passenger_count": null
},
"need_ask": true,
"ask_content": "请问您的出发地、目的地、出行时间、舱位和乘车人数分别是什么?"
}
{'updated_slots': {'departure': None, 'destination': None, 'travel_time': None, 'cabin': None, 'passenger_count': None}, 'need_ask': True, 'ask_content': '请问您的出发地、目的地、出行时间、舱位和乘车人数分别是什么?'}
{
"updated_slots": {
"departure": null,
"destination": "上海",
"travel_time": null,
"cabin": null,
"passenger_count": null
},
"need_ask": true,
"ask_content": "请问您的出发地、出行时间、舱位和乘机人数分别是什么?"
}
{'updated_slots': {'departure': None, 'destination': '上海', 'travel_time': None, 'cabin': None, 'passenger_count': None}, 'need_ask': True, 'ask_content': '请问您的出发地、出行时间、舱位和乘机人数分别是什么?'}
{
"updated_slots": {
"departure": null,
"destination": "上海",
"travel_time": "后天上午",
"cabin": null,
"passenger_count": 2
},
"need_ask": true,
"ask_content": "请问您的出发地是哪里?需要什么舱位?"
}
{'updated_slots': {'departure': None, 'destination': '上海', 'travel_time': '后天上午', 'cabin': None, 'passenger_count': 2}, 'need_ask': True, 'ask_content': '请问您的出发地是哪里?需要什么舱位?'}
六、应用场景分析
1. 智能对话客服
智能客服是Slot Filling技术最成熟、应用最广泛的场景,几乎所有电商、金融、政务、互联网平台的AI客服,核心底层都是基于槽位填充技术实现需求解析与问题处理。传统人工客服依赖人工识别用户问题、录入信息、查询数据,效率极低,而大模型槽位填充可实现用户需求全自动结构化解析。
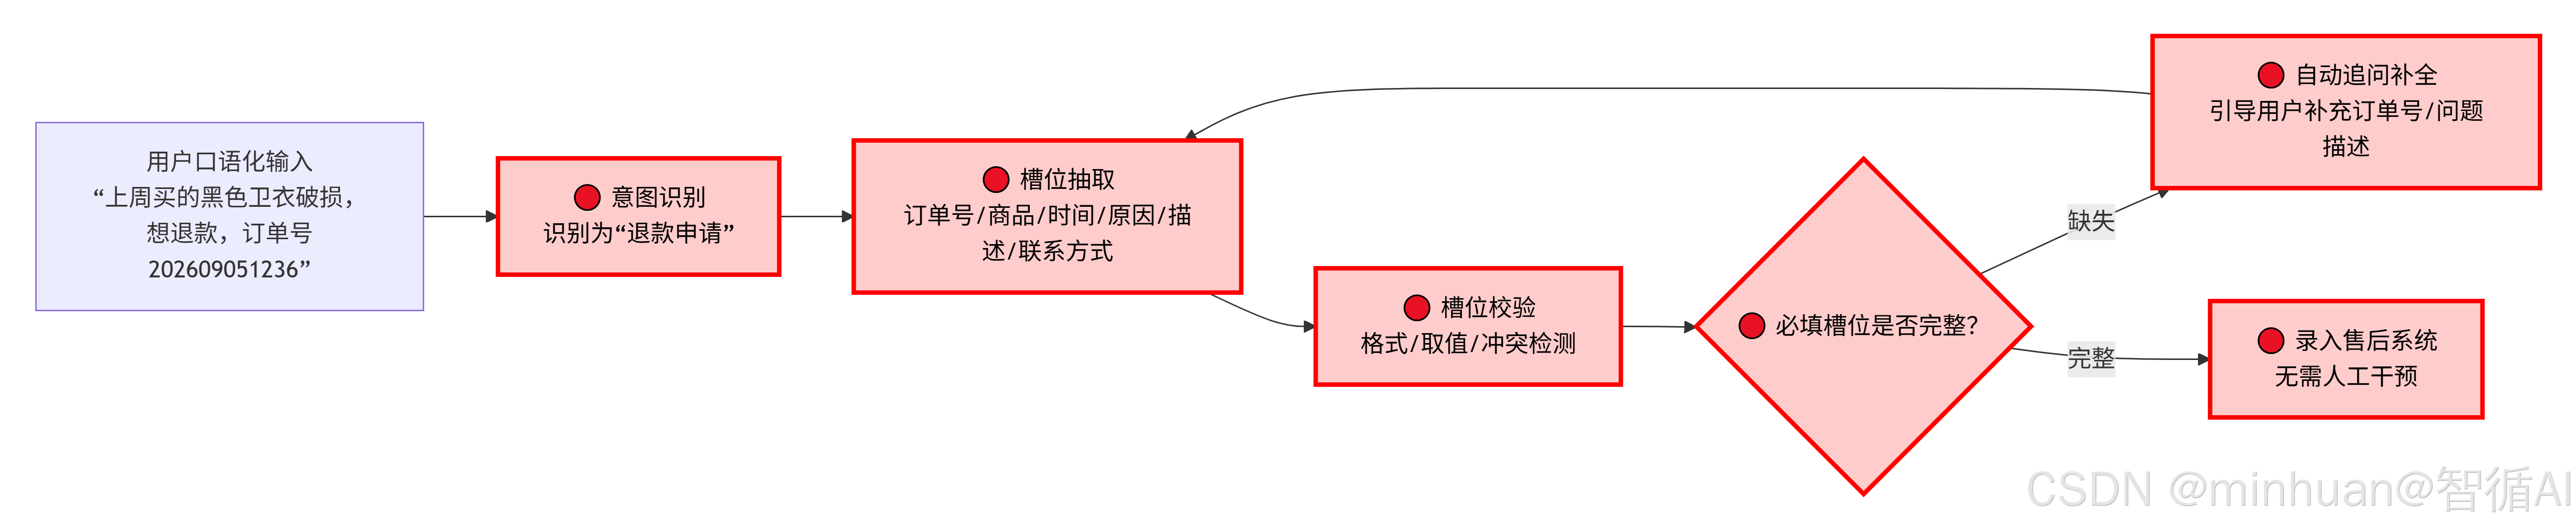
在客服场景中,核心意图包含订单查询、退款售后、物流咨询、发票开具、投诉建议等,每个意图对应专属槽位体系。以退款售后场景为例,槽位体系包含订单号、商品名称、购买时间、退款原因、问题描述、联系方式等核心字段。
用户输入一段杂乱的口语化内容,比如“我上周买的黑色卫衣,收到货有破损,想退款,订单号是202609051236”,大模型可快速识别意图为“退款申请”,精准提取所有槽位信息,自动录入售后系统,无需人工干预。若用户缺失订单号、问题描述等关键信息,AI会自动追问补全。
依托大模型的上下文能力,多轮对话场景下的槽位填充体验大幅优化。比如用户先问“衣服怎么退款”,后续补充“就是昨天买的那件白色T恤”,模型可跨轮次整合信息,完整填充槽位,彻底解决传统客服AI断片、重复提问的问题。目前该技术已帮助企业降低人工客服压力,大幅提升用户咨询响应效率。
2. 智能出行服务
智能出行是槽位填充技术的核心高频场景,涵盖机票、高铁、酒店、打车、景区预约等各类生活服务,也是普通用户感知最明显的应用场景。这类场景的核心特点是槽位规则固定、必填字段清晰、容错要求高,完美适配大模型槽位填充的技术特性。
以智能打车场景为例,核心意图为“呼叫打车服务”,对应必填槽位包含上车地点、下车地点、出行时间、车型偏好,选填槽位包含乘车人数、备注需求。用户任意口语化表述,都能被模型精准解析,比如用户说“五分钟后到公司楼下接我,去高铁站,要一辆专车”,模型可快速填充所有槽位,自动下单。
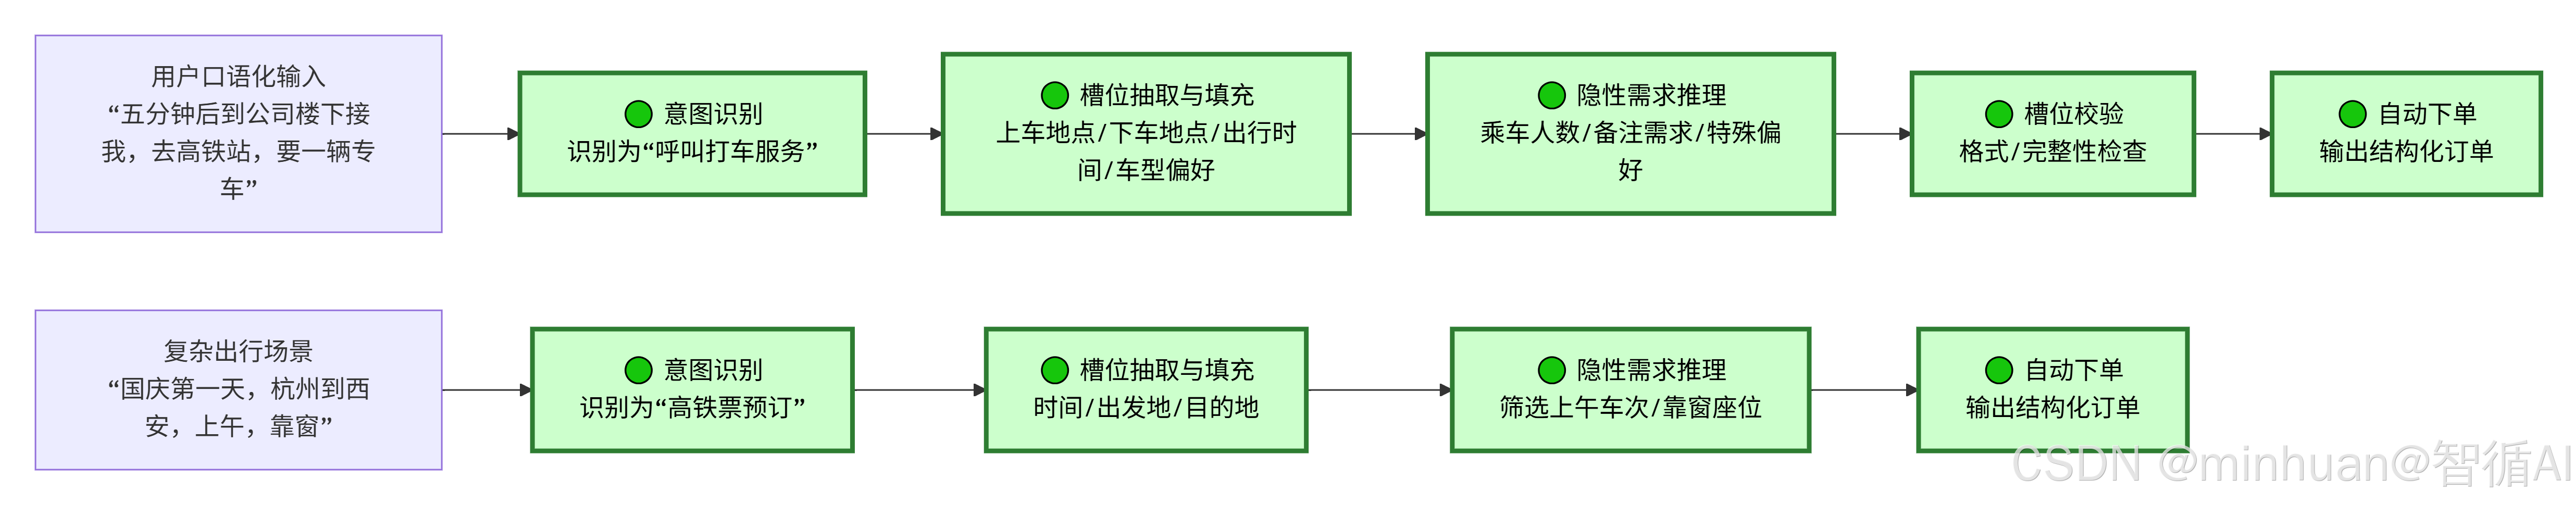
在跨场景复杂出行需求中,大模型的推理填充优势更加突出。比如用户说“国庆第一天,帮我订从杭州到西安的高铁票,尽量上午的,靠窗座位”,模型不仅能提取时间、出发地、目的地,还能解析用户隐性需求,筛选上午车次、靠窗座位,完成精细化槽位填充。
除此之外,出行场景的异常需求处理也依赖该项技术。面对用户改签、退票、行程变更等动态需求,模型可快速识别变更意图,更新对应槽位信息,替换原有订单参数,实现出行服务全流程智能化。
3. 智能家居控制
随着全屋智能普及,Slot Filling技术成为智能家居语音交互的核心支撑,解决了传统语音指令死板、必须固定话术的痛点。传统智能家居只能识别固定关键词指令,用户语序稍有变动就无法响应,大模型槽位填充实现了自然口语化自由控制。
智能家居场景的核心意图为设备控制、场景切换、参数调节,对应槽位包含设备名称、操作动作、调节参数、执行时间。比如用户说“晚上八点自动关掉卧室的台灯,把客厅的灯光调到暖光模式”,模型可拆分多设备、多操作需求,分别填充对应槽位,精准执行多项控制指令。

该场景下,大模型的上下文记忆能力尤为重要。用户先说“有点冷”,模型可结合场景推理用户需求,默认调节空调温度;后续补充“调高两度”,可延续上文语境,精准完成参数调节,无需用户重复说明设备名称。这种人性化交互,核心就是跨轮次槽位信息继承与补全。
4. 医疗政务办公
医疗、政务、办公等专业严谨场景,对槽位填充的准确率、规范性、安全性要求极高,也是大模型Slot Filling技术的高端落地场景,主要用于信息录入、表单填报、业务办理等工作,大幅降低人工录入成本。

在医疗场景中,智能问诊、预约挂号、病历录入均依赖槽位填充。智能问诊可自动提取患者的症状、发病时间、身体状态、过往病史等关键信息,结构化录入病历系统;预约挂号可精准抓取就诊时间、科室、医生、患者信息,完成挂号流程办理。
在政务场景中,市民语音或文本提交的办事需求,可通过槽位填充自动提取办事事项、办理人信息、办理地址、材料清单等关键信息,自动填报政务表单,实现“语音办业务”,解决传统政务填报流程繁琐、操作复杂的问题。
办公场景中,可用于会议纪要提取、日程预约、公文信息梳理,自动抓取会议时间、参会人员、会议主题、待办事项、截止时间等槽位信息,快速生成结构化办公文档,大幅提升办公效率。
七、实践优化方案
1. Prompt工程优化
对于无模型微调的场景,Prompt工程是提升大模型槽位填充准确率、性价比最高、落地最快的优化方案,核心是通过标准化、精细化的指令约束,规范模型的抽取逻辑、输出格式和容错机制。
优质的槽位填充Prompt需要包含四大核心要素:场景说明、槽位规则、输出格式、异常处理机制:
- 首先明确当前业务场景与对应意图;
- 其次清晰定义所有槽位的字段含义、取值范围、必填属性;
- 然后指定结构化输出格式,通常以JSON格式为主;
- 最后明确缺失信息、歧义信息、无效信息的处理方式。
同时可以采用少样本Prompt优化,在指令中带入3-5个真实场景案例,展示标准的输入输出示例,让模型快速学习场景填充规则,大幅降低理解偏差。实测优化后的Prompt,可将通用大模型的槽位填充准确率提升15%-25%,完全满足多数常规业务场景需求。
2. 模型微调优化
针对金融、医疗、政务等高精度核心场景,Prompt优化无法满足极致准确率需求,需要采用小样本专项微调的方式优化模型能力,让通用大模型适配专属业务槽位规则,解决复杂歧义、小众场景、专业术语的填充问题。
微调优化的核心流程分为数据构建、模型训练、效果验证三步:
- 首先筛选真实业务交互数据,清洗标注高质量槽位填充数据集,包含正常样本、歧义样本、缺失样本、口语化样本;
- 其次基于大模型底座,采用LoRA轻量化微调方案,低成本、高效率训练专属槽位填充模型;
- 最后通过测试集验证效果,迭代优化模型参数。
微调后的模型,对业务专属术语、特殊规则、隐性需求的理解能力大幅提升,槽位填充准确率可达到95%以上,同时推理速度更快、稳定性更强,适合高频、高并发、高精准的落地场景。
3. RAG检索增强优化
面对专业领域知识更新快、槽位取值动态变化的场景,单纯的Prompt和微调无法解决信息滞后问题,此时需要结合RAG检索增强技术,构建动态知识库,辅助槽位填充,提升信息准确性。
核心原理是将业务最新规则、专业术语、枚举取值、场景标准等信息构建向量知识库,用户发起请求时,模型先检索最新的业务标准和规则,再结合用户语句完成槽位填充,确保填充内容贴合最新业务规范,避免模型固有知识滞后导致的错误。
比如电商平台活动规则、票价政策、科室排班等动态变化的信息,通过RAG实时检索更新,可保证槽位填充的实时性和准确性,完美解决动态场景下的技术适配问题。
八、总结
Slot Filling看似是一项基础NLP技术,却是大模型产业落地的核心刚需能力。如果说大模型的语义理解是AI的大脑,那么槽位填充就是AI的手脚,负责将抽象的语言理解,转化为可落地、可执行、可量化的结构化业务动作,是连接自然语言与机器执行的核心桥梁。
Slot Filling已经从传统规则匹配、机械信息抽取,迭代为大模型驱动的智能语义填充、逻辑推理填充、动态适配填充。彻底摆脱了人工规则束缚、固定句式限制、上下文断层等痛点,具备了拟人化的信息理解、补全、纠错、推理能力,让人机交互从“刻板响应”升级为“自然对话”。
随着大模型技术持续迭代,未来的槽位填充将不再局限于文本、语音信息抽取,还能结合图片、视频多模态信息完成信息补全;同时具备更强的复杂逻辑推理能力,可处理多任务、多条件、嵌套式用户需求;并且能够根据用户使用习惯个性化适配填充规则,实现千人千面的智能服务;轻量化模型的落地,也会让这项技术在终端设备上实现更低延迟、更高适配性的应用。


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


