



一、前言
接触大模型应用开发,相信我们都遇到过大模型“知识过时”和“编造信息”的痛点。哪怕是最强的基础大模型,它的知识都被冻结在某个时间节点里,问到最新新闻、实时数据、行业新规,模型很容易一本正经地胡说八道。现在我们解决这个问题,最主流的方案就是RAG检索增强生成:让大模型先去外部工具检索真实资料,再基于检索到的内容回答问题。
但传统搜索引擎并不适配大模型。网页搜索返回一大堆原始HTML、冗余广告、导航栏内容,大模型要自己清洗、筛选,浪费大量token,还容易拿到无效信息。于是在带着问题探索出路,发现Tavily专门为大模型设计的检索引擎,它不是给人看的搜索引擎,而是给AI看的搜索API。Tavily不是一个简单的网页爬虫。实际上,Tavily在底层做了检索、网页提取、信息精简、可信度过滤整套链路,直接输出大模型能直接喂入prompt的结构化文本。
二、Tavily基础介绍
1. 设计定位
Tavily是一款面向大语言模型的AI原生搜索API服务,核心目标就是解决大模型联网检索的难题。普通搜索引擎的目标用户是人,返回的是网页链接、摘要snippet,我们需要点开链接自己阅读判断。而Tavily的目标用户是大模型,它的整套流程都是为AI服务:接收自然语言查询,自动执行搜索、网页内容抽取、信息降噪、内容压缩,返回精简干净的文本片段,直接丢给LLM做回答。简单一句话概括:谷歌给人看网页,Tavily给AI喂素材。
它属于RAG体系里外部联网检索组件,和向量数据库检索不是一回事。向量数据库检索,检索的是你自己提前上传、离线入库的私有文档;而Tavily是实时互联网检索,查询互联网上公开的最新信息,两者经常搭配使用。
Tavily提供两种检索模式:基础搜索和深度搜索。
- 基础搜索速度快,适合简单事实查询;
- 深度搜索会自动打开网页,抽取全文,适合需要长文本详细资料的场景。返回结果自带来源链接、简短摘要、提取的网页内容,还自带可信度评分,方便大模型判断信息是否可靠。
2. 解决核心痛点
在Tavily出现之前,开发者想让大模型联网,一般有两种方案,各自都有明显短板。
第一种:调用谷歌等搜索API,拿到链接,再自己写爬虫去抓取网页。
- 这里坑非常多,很多网站有反爬,抓取失败;
- 网页里混杂广告、侧边栏、导航、弹窗,原始HTML噪音巨大;
- 抓取出来的全文很长,直接丢进LLM会消耗巨额token;
- 开发者还需要自己写清洗、截断、去重逻辑,代码工作量很大,稳定性差。
第二种:直接调用内置联网能力的大模型,比如自带搜索的GPT。
- 缺点是搜索逻辑黑盒,无法自定义检索策略,无法单独拿到检索原文,也不方便接入自己的RAG流水线,成本不可控,私有化部署完全做不了。
而Tavily一次性解决这些痛点:
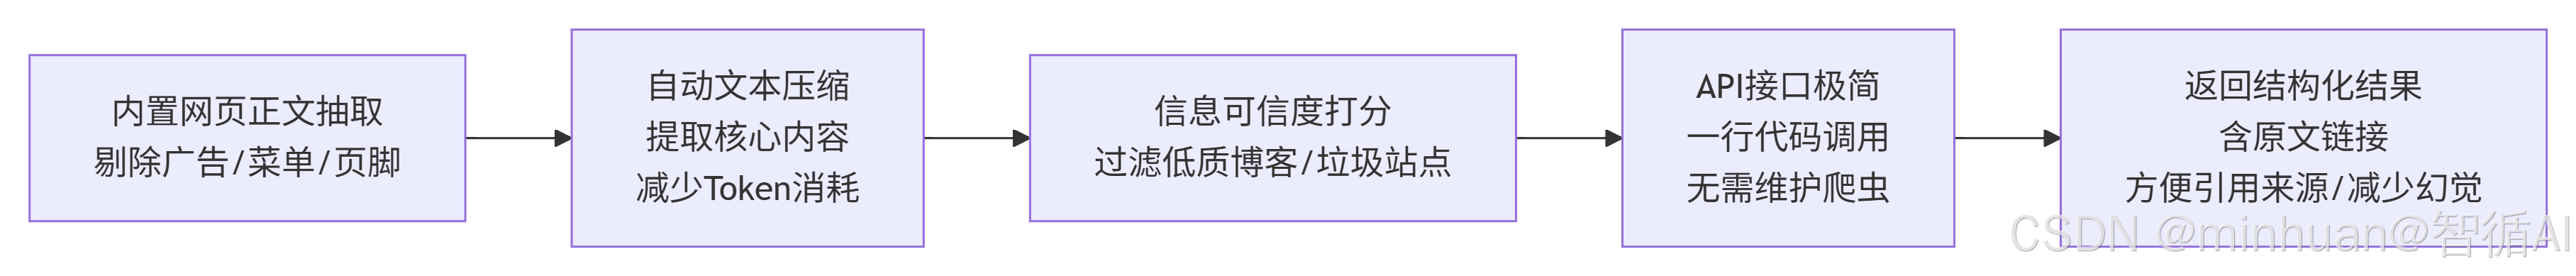
- 内置网页正文抽取,自动剔除广告、菜单、页脚等无关内容;
- 自动文本压缩,提取核心内容,减少token消耗;
- 自带信息可信度打分,过滤低质量博客、垃圾站点;
- API接口极简,一行代码调用,不用维护爬虫;
- 返回结构化结果,包含原文链接,方便回答的时候引用来源,减少幻觉。
但这里也要客观说明,Tavily本身是SaaS云服务,不是开源框架。我们需要调用它的云端API,有额度和计费,无法直接私有化部署。这一点是后面选择中文替代方案时,最关键的考量点。
3. 典型适用场景
- 实时信息查询:最新新闻、赛事、股价、政策动态、行业最新事件;
- 事实校验:让大模型回答之后,调用Tavily联网核验答案真假,降低幻觉;
- 学术/技术资料检索:查询最新论文、技术文档、官方更新;
- 智能Agent:AI智能体执行任务,需要自主上网查找资料;
- 知识库补充:私有向量库查不到的内容,自动兜底联网检索。
不适合的场景:内网私有文档检索、大规模离线文档库查询、需要极高并发且不能走公网API的私有化项目。这类场景就不能用Tavily,要选择国内自研检索框架。
二、Tavily核心技术原理
1. 整体工作流程
Tavily的整套检索链路,分为5个步骤,我们一步步拆解。
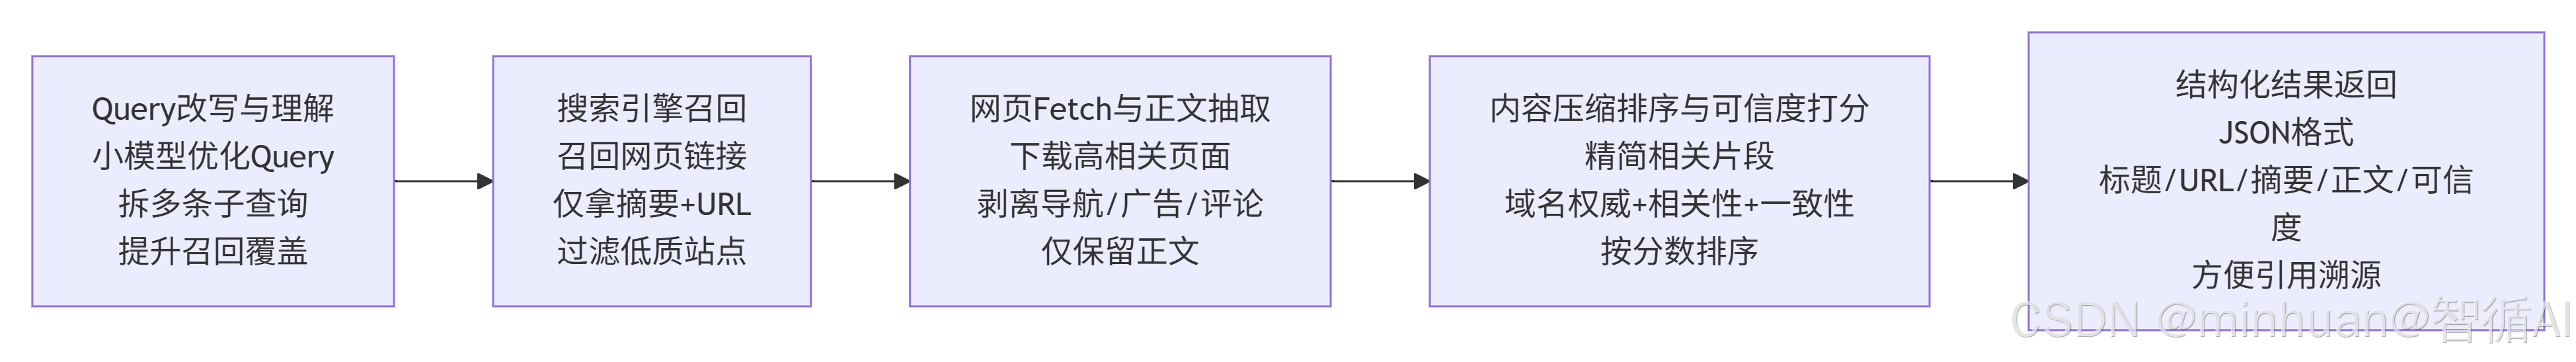
1.1 Query改写与理解
- 收到用户原始问题之后,内部小模型会先对query做优化。
- 比如用户问“2026大模型Agent最新进展”,模型会把这个自然语言问题,改写成适合搜索引擎的关键词,自动拆成多条子查询,提升召回覆盖率。
- 这一步类似RAG里的查询改写、多查询检索。
1.2 搜索引擎召回
- 使用底层通用搜索引擎,根据改写后的关键词,召回一批相关网页链接。
- 这一步只拿到摘要和url,不会立刻读取完整网页,保障速度。
- 同时会过滤掉明显不可信、恶意、低质量站点。
1.3 网页Fetch与正文抽取
- 根据策略选择部分高相关链接,发起网页请求,下载页面。
- 内置专用抽取器,不是简单的HTML解析,会区分页面主体文章和噪声内容,剥离导航、评论区、广告弹窗,只保留正文文本。
- 这一步是Tavily最核心的能力,也是和普通搜索API最大的区别。
1.4 内容压缩、排序与可信度打分
- 拿到干净正文后,Tavily会对文本做精简提炼,保留和原始query相关的片段,剔除无关段落。
- 同时给每一条结果打分,综合域名权威度、内容相关性、信息一致性,生成可信度分数。
- 最后按照相关性从高到低排序。
1.5 结构化结果返回
- 最终返回JSON格式数据,包含原始query、检索结果列表。
- 每条结果包含标题、网页url、简短摘要、提取的正文内容、可信度分数。
- 大模型可以直接读取这些字段,引用来源链接,生成带引用的回答。
2. 两种检索模式差异
Tavily提供基础搜索(Search)和深度搜索(Search Deep)。
基础搜索:
- 不会批量打开网页,依赖搜索引擎自带摘要,响应快,token消耗低。
- 适合简单事实类问题,比如查询某个名词定义、简短数据。
- 缺点是信息有限,遇到摘要不全的网页,信息会缺失。
深度搜索:
- 会访问多个网页,拉取完整正文再提取内容。
- 信息更全面,适合复杂问题、深度调研。
- 代价是耗时更长,消耗更多API额度。
我们可以根据问题复杂度动态切换两种模式,简单问题用基础搜索,复杂调研自动切深度搜索。
3. 局限与短板
Tavily优势很突出,但也有无法忽略的短板,做项目选型一定要考虑。
第一,它是海外SaaS服务,服务器在境外。
- 访问速度不稳定,网络延迟高,国内网络环境下经常超时。
- 对于中文网页的检索能力弱于中文搜索引擎,对国内资讯、中文社区、国内政策文档召回效果一般。
第二,不能私有化部署。
- 所有检索请求都要走Tavily的云端API,敏感业务、企业内网数据绝对不能使用,数据会经过第三方服务。
第三,计费按检索次数收费,高并发场景成本会快速上涨。
第四,对中文网页的正文抽取效果一般。
- 网页结构复杂的中文站点,容易抽取失败,出现内容截断或者漏内容。
正是因为这些短板,在国内做中文大模型应用,如果不是特别匹配一般不会直接用Tavily,转而使用国内同类检索框架。
三、Tavily快速上手方式
1. API调用与Python示例
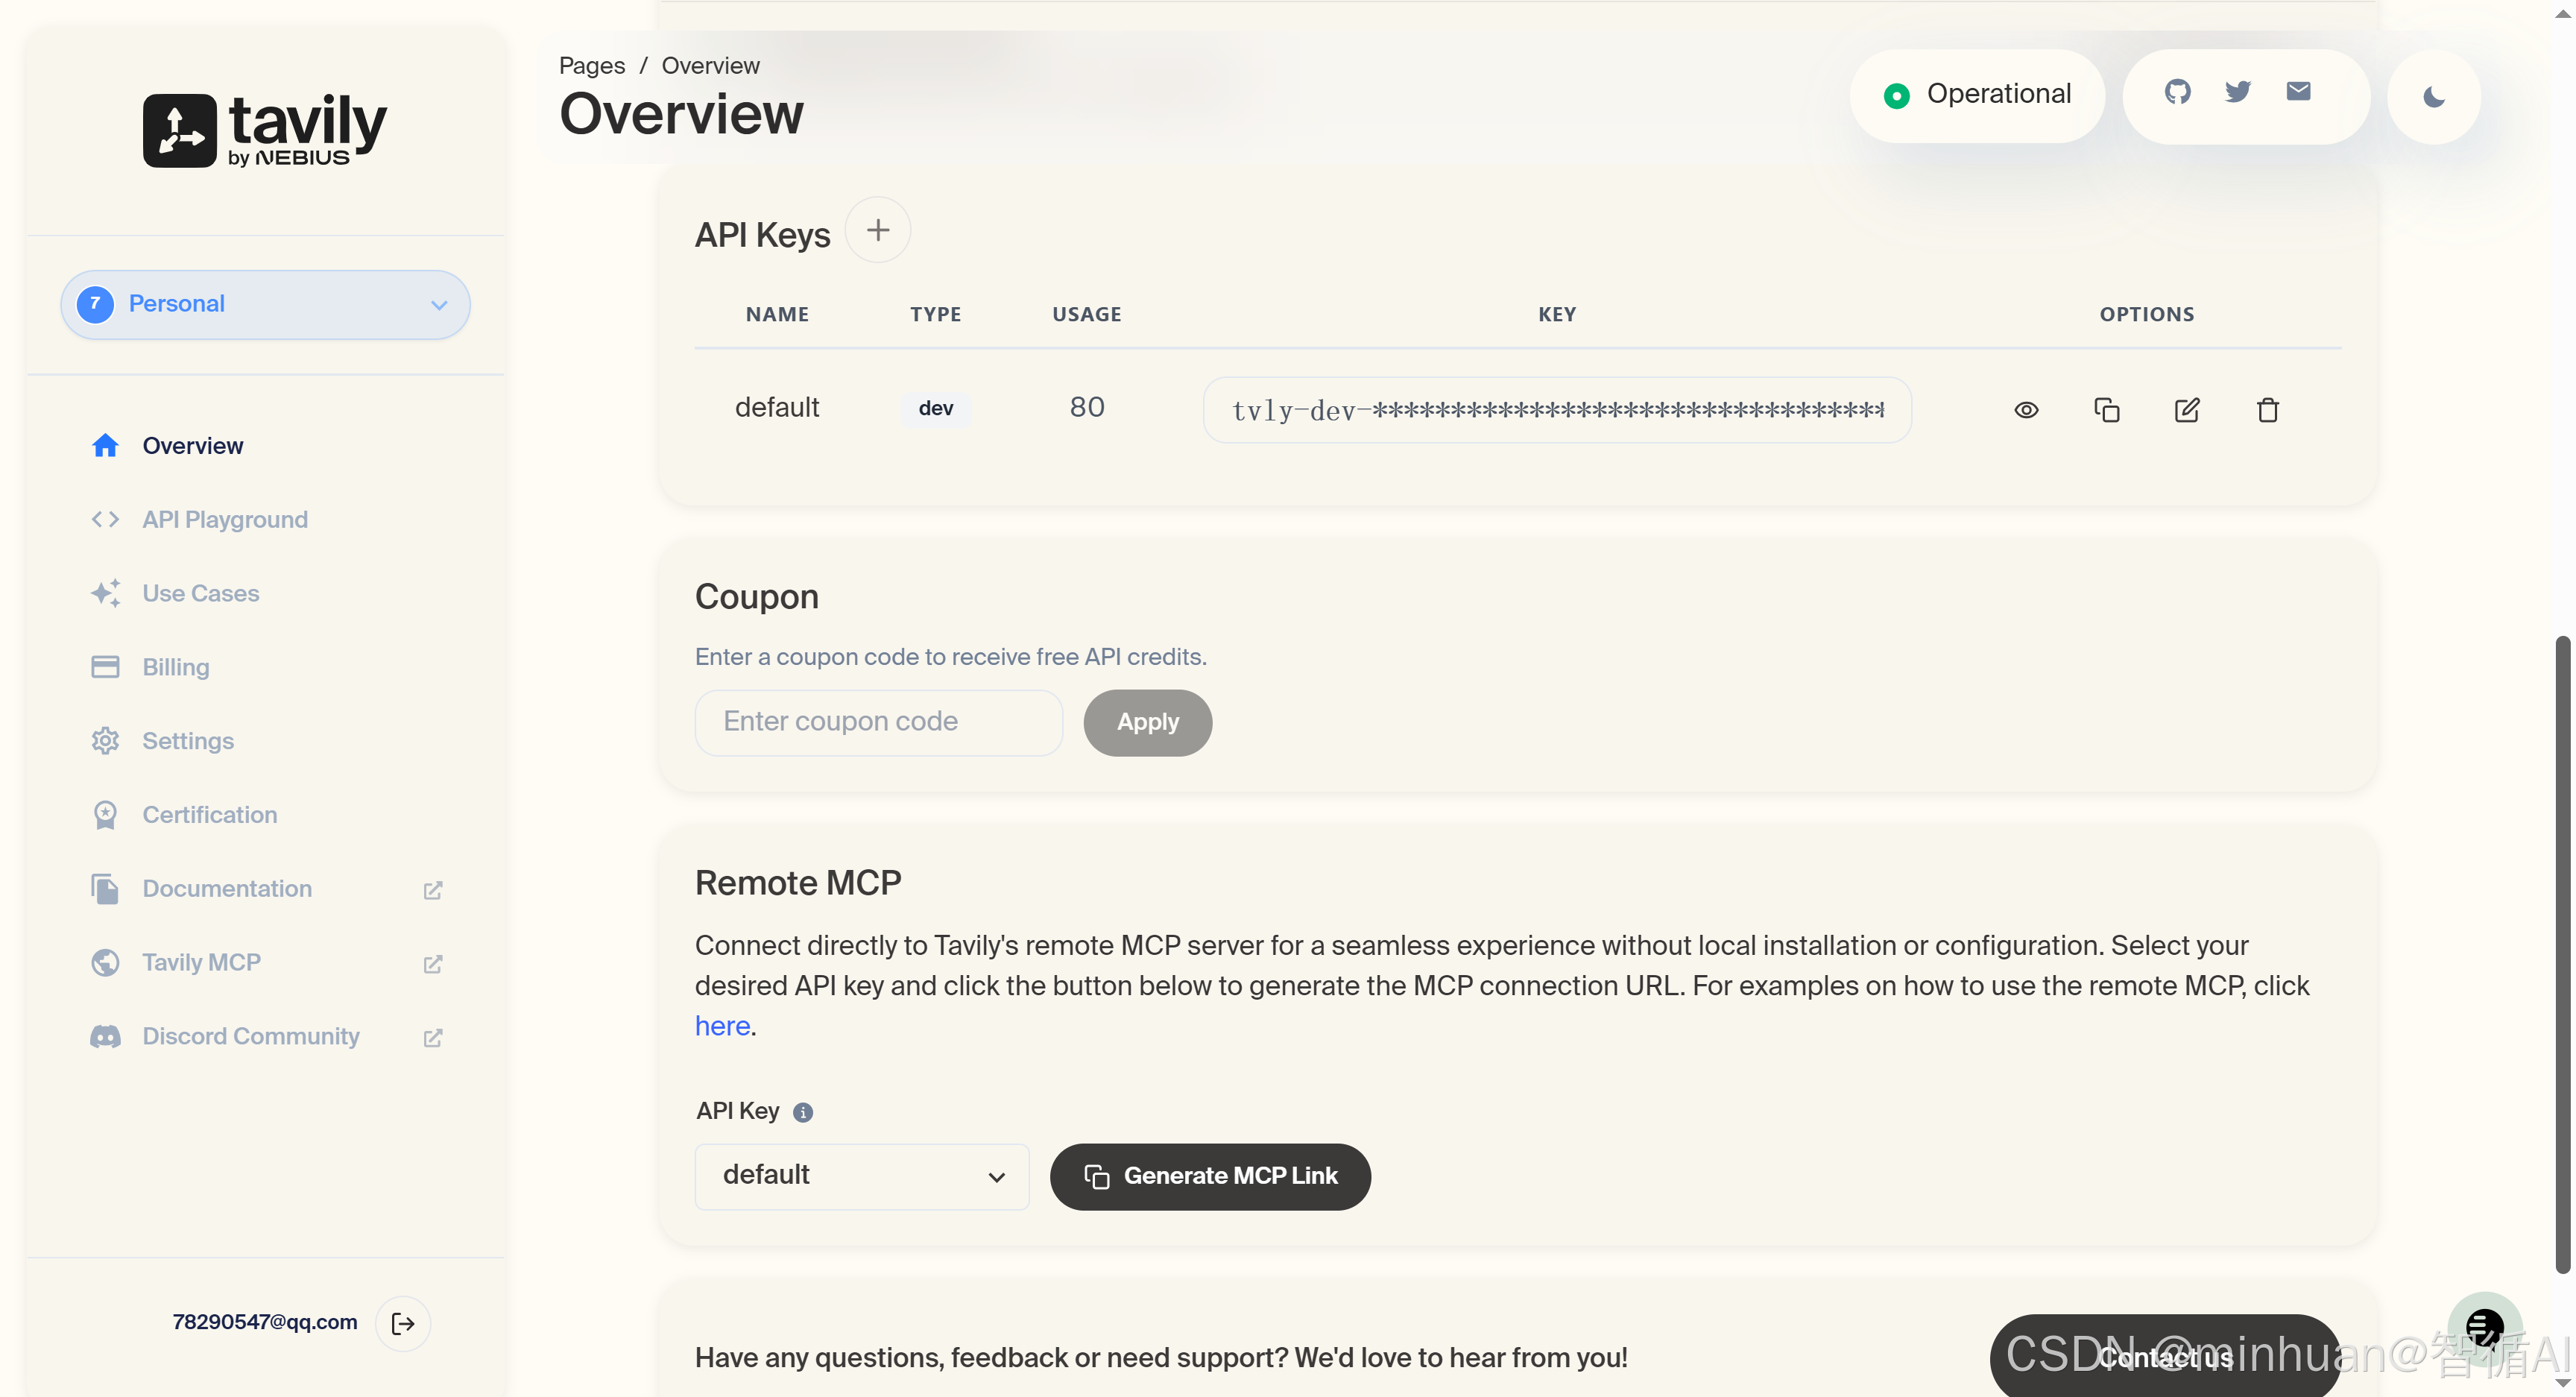
Tavily提供官方Python SDK,安装之后只需要简单几行代码就能调用。
from tavily import TavilyClient
import os

client = TavilyClient(
    api_key=os.environ.get("TAVILY_API_KEY", "tvly-dev-LdaOJ-***")
)


def show(resp, label):
    """精简输出:只展示 AI 总结 + 每条的 url / 标题 / 内容前 200 字"""
    print(f"\n===== {label} =====")
    if resp.get("answer"):
        print(f"【AI 总结】{resp['answer'][:300]}")
    for i, item in enumerate(resp.get("results", []), 1):
        print(f"\n[{i}] {item.get('title', '')}")
        print(f"    {item.get('url', '')}")
        print(f"    {item.get('content', '')[:200]}")


# 基础搜索(basic)
basic = client.search(
    query="RAG检索增强生成最新技术进展",
    max_results=3,
    include_answer=True,
)
show(basic, "基础搜索")

# 深度搜索(advanced)
deep = client.search(
    query="大模型Agent落地难点",
    search_depth="advanced",
    max_results=3,
    include_answer=True,
)
show(deep, "深度搜索")
返回的response里包含results数组,每一条result都有url、content、title字段,content就是清洗后的正文片段,直接拼入大模型prompt即可。
2. 与LangChain、LlamaIndex集成
Tavily原生支持主流大模型应用框架LangChain、LlamaIndex。我们可以直接把Tavily作为工具接入Agent,Agent可以自主判断什么时候需要调用联网搜索。
在LangChain里,可以直接作为内置工具:
import os
from langchain_openai import ChatOpenAI
from langchain_community.tools.tavily_search import TavilySearchResults
from langchain.agents import AgentExecutor, create_tool_calling_agent
from langchain_core.prompts import ChatPromptTemplate

# 1) 初始化大模型(这里用 OpenAI 兼容接口,换成豆包/通义也行)
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# 2) 把 Tavily 封装成 Agent 工具
tools = [
    TavilySearchResults(
        max_results=3,
        search_depth="advanced",
        include_answer="advanced",
    )
]

# 3) 写一个最精简的 Agent 提示词
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个助手,不知道的事实就调用搜索工具查证后再回答。"),
    ("human", "{input}"),
    ("placeholder", "{agent_scratchpad}"),
])

# 4) 组装并运行
agent = create_tool_calling_agent(llm, tools, prompt)
executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

# 问一个实时问题,Agent 会自动调 Tavily
ans = executor.invoke({"input": "今天 OpenAI 又发布了什么新模型?"})
print(ans["output"])
LlamaIndex里Tavily 是一个QueryEngine,可以和本地向量库拼起来一起检索:
from llama_index.core import VectorStoreIndex, Document
from llama_index.tools.tavily_reasoning.base import TavilyToolSpec
from llama_index.core.agent import FunctionCallingAgent
from llama_index.llms.openai import OpenAI

# 1) 本地私有知识库(这里用内存里的示例,实际换成你自己的文档)
local_docs = [Document(text="我们公司 2026 年报销制度:出差住宿上限 500 元/晚……")]
local_index = VectorStoreIndex.from_documents(local_docs)
local_query_engine = local_index.as_query_engine()

# 2) 联网搜索工具
tavily_tool = TavilyToolSpec(api_key=os.getenv("TAVILY_API_KEY")).to_tool_list()

# 3) 同时挂上本地 + 联网
agent = FunctionCallingAgent.from_tools(
    [*tavily_tool, local_query_engine.as_tool()],
    llm=OpenAI(model="gpt-4o-mini"),
    verbose=True,
)

# 问一个跨"私有+公网"的问题
agent.chat("我们公司出差住宿标准是多少?和北京市 2026 年酒店均价相比呢?")
Agent遇到无法依靠内部知识回答的问题,就自动调用Tavily获取互联网信息。这也是Tavily最主流的使用场景:作为AI Agent的联网工具。
四、中文场景类似检索框架
1. 分类说明
和Tavily对标,国内中文场景的工具可以分成两大类:
- 一类是检索API服务,类似Tavily SaaS;
- 一类是开源检索框架,可以本地私有化部署,包含网页抓取、正文抽取、RAG联网检索全套能力。
Tavily核心能力 = 搜索召回 + 网页正文抽取 + 内容降噪 + 结构化输出。我们挑选的同类工具,都具备这整套能力,适配中文网页。
2. 国内SaaS检索API
火山引擎 搜搜API/百度文心搜索API
百度、火山都提供面向大模型的搜索增强API,专门为LLM设计。
- 底层是国内搜索引擎,中文网页召回能力很强,自动做网页内容提取,直接返回干净文本,适配中文资讯、国内官网、政策文档。
- 优势:国内网络稳定,中文理解强,域名权威度针对国内站点优化,可以直接对接文心一言、豆包等国产大模型。
- 短板:属于闭源SaaS,无法私有化,有调用费用,数据要上云。适合企业快速开发原型,不适合高度敏感业务。
阿里云通义搜索API
通义搜索API同样是LLM原生检索接口,输入自然语言,召回中文网页并提取正文。
- 和Tavily定位一致,主打给大模型做联网增强,支持结果引用溯源。
- 适合基于通义大模型搭建RAG、Agent应用。
3. 开源检索框架
这一类是最值得关注的,也是国内很多企业项目替代Tavily的首选,可以部署在自己服务器,数据不出内网。
SearXNG + 自研抽取器
SearXNG是开源元搜索引擎,可以聚合百度、必应、搜狗等多个搜索引擎结果。
- 它本身只做召回,不自带正文提取。一般搭配Trafilatura、Newspaper3k中文网页抽取库,就可以复刻Tavily完整链路。
- 优点:完全开源免费,可私有化部署,可自由切换底层搜索引擎。
- 缺点:需要自己维护爬虫、反爬、内容清洗、打分排序逻辑,开发工作量大,需要一定后端能力。
LlamaIndex + Trafilatura/BeautifulSoup
LlamaIndex本身是RAG应用框架,内置网页加载器,搭配Trafilatura网页正文抽取库。
- 能够实现:搜索召回→抓取网页→提取干净正文→切片向量化,可以用这套组合自建本地版Tavily。
- Trafilatura对中文网页抽取效果优秀,能很好剔除广告和导航栏。
- 适合中小型项目自建检索能力。
BGE + 检索流水线(BGE-M3)
BGE是智谱开源的向量模型,BGE-M3支持多语言,同时支持稀疏检索+稠密检索。
- 基于BGE,搭建整套检索系统:搜索引擎召回网页,抽取正文,再用BGE做二次重排,筛选最相关片段。
- 这套方案更偏向混合检索,适合中文深度调研场景。
国内开源项目:OpenWebSearch、SoWSearch
OpenWebSearch是国内开源的大模型联网检索系统,目标就是做中文版本Tavily。
- 整套包含query改写、多源网页召回、中文正文抽取、结果重排、可信度过滤,一键部署,原生适配中文。
- 可以本地部署,请求公网搜索,全部流程在自己服务器执行,API返回结构化结果,直接接入LLM。
- 对于不想重复造轮子、想要私有化的开发者,是目前最贴合Tavily定位的开源替代方案。
4. 选型对比总结
| 工具 | 部署方式 | 中文能力 | 适用场景 |
|---|---|---|---|
| Tavily | 海外SaaS | 弱 | 海外资料、英文检索,原型快速验证 |
| 百度/火山搜索API | 国内SaaS | 强 | 中文业务,快速开发,接受数据上云 |
| OpenWebSearch | 开源私有化 | 强 | 企业内网、敏感业务,自建中文联网检索 |
| SearXNG+Trafilatura | 开源私有化 | 中等 | 有开发团队,需要高度自定义检索逻辑 |
选型简单建议:
- 做英文、海外资料调研,快速写Demo:Tavily;
- 国内业务、中文资料,不想运维服务:百度/火山搜索API;
- 敏感业务、数据不能出内网,想要复刻Tavily能力:OpenWebSearch;
- 有后端团队,需要深度定制检索逻辑:SearXNG + Trafilatura。
五、Tavily在RAG实践应用
1. 混合检索架构
工程上最成熟的方案是:私有知识库向量检索 + Tavily(或中文替代检索引擎)互联网检索。 当用户提问,优先检索本地向量数据库,如果检索分数低于阈值,自动触发联网搜索。
完整执行流程:
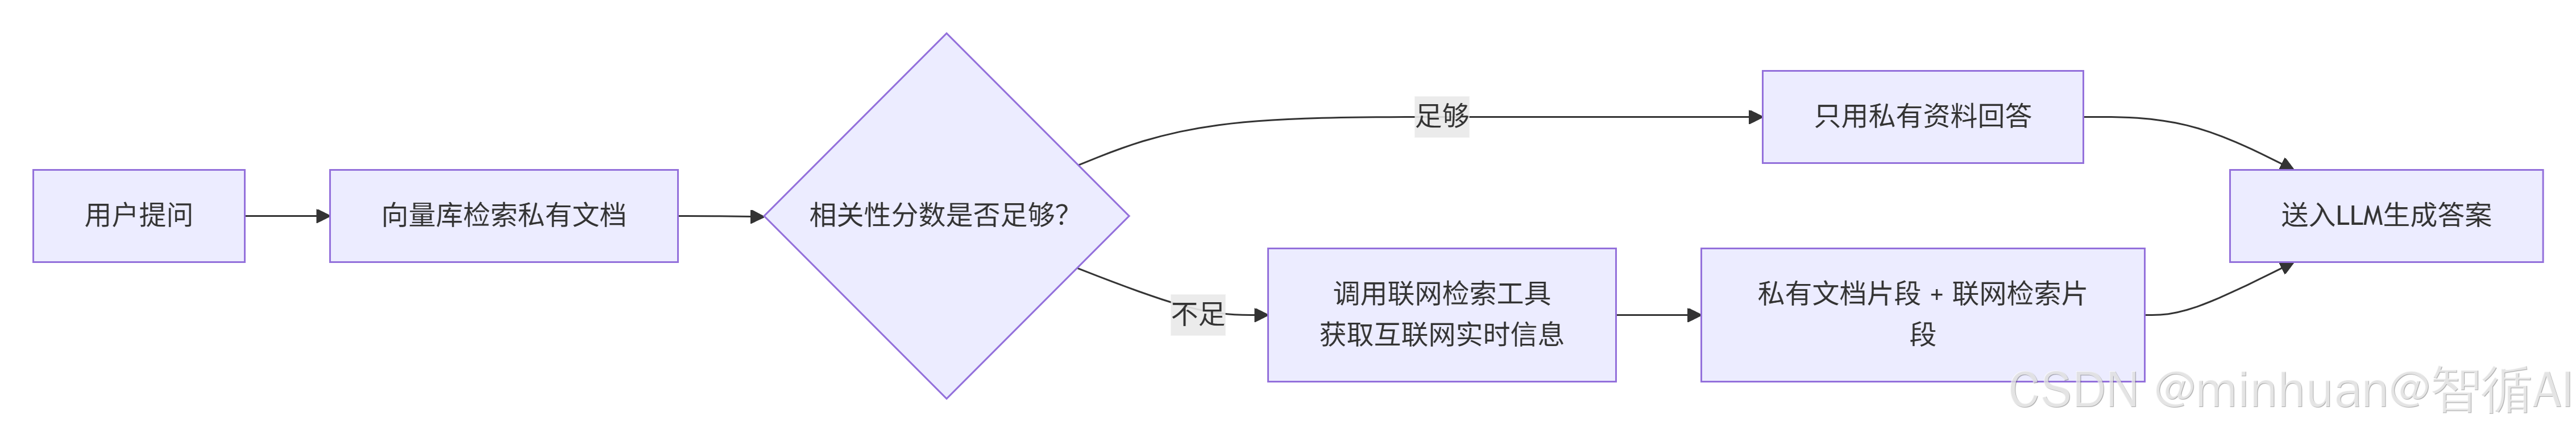
- 1. 用户提问;
- 2. 向量库检索私有文档;
- 3. 判断相关性分数:分数足够 → 只用私有资料回答;
- 4. 分数不足 → 调用联网检索工具,获取互联网实时信息;
- 5. 将私有文档片段 + 联网检索片段一起送入LLM生成答案。
这套混合检索,兼顾私有资料和互联网实时信息,也是现在的主流方案。Tavily在这里充当“互联网兜底检索”模块。换成中文项目,就替换成OpenWebSearch或者国内搜索API。
2. 减少幻觉的技巧
使用Tavily这类检索工具,并不是接入之后就完全消除幻觉,依然有工程细节需要处理。
- 强制引用来源:Prompt要求大模型回答时标注检索来源url;
- 结果过滤:利用可信度分数,直接丢弃低分网页;
- 限制检索数量:不要一次性召回过多网页,控制token总量;
- 二次校验:复杂问题,拿到回答后,再次调用检索工具核验关键事实。
3. 成本与性能优化
- 区分问题类型:静态知识直接走向量库,只有需要实时信息才调用联网搜索,减少API调用次数;
- 动态切换检索深度:简单问题基础搜索,复杂调研开启深度搜索;
- 缓存检索结果:短时间内重复查询,直接使用缓存,减少调用次数。
六、总结
Tavily的本质不是搜索引擎,而是一套面向大模型的检索增强服务。它抓住了传统搜索不适合AI的核心痛点:网页噪声高、抽取麻烦、token消耗大,把网页抓取、清洗、摘要、打分全部封装成API,让开发者一行代码就能给大模型插上联网能力。
但是它有明显水土不服的问题:境外服务、中文网页效果一般、无法私有化部署。所以在国内中文业务落地时,很少直接生产环境使用Tavily。我们可以选择国内云厂商的搜索API快速开发原型,或者使用OpenWebSearch这类开源项目,搭建私有化的中文检索系统,实现和Tavily一样的能力。RAG和Agent的落地,检索是根基。检索质量直接决定大模型回答的准确性,Tavily给我们展示了“AI原生检索”该是什么样子,而国内中文检索框架,则让这套思路可以稳定落地在中文业务场景。


 扫一扫


 424

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


