


文章目录
水务署每双周发布一次香港 18 个水塘的存水量,一期一个独立 CSV,从 2019 年 1 月到 2026 年 9 月共 183 期。这张表只有三列:水塘名、存水量(百万立方米)、蓄水百分比——但正是这三列,藏着一个不用任何外部基准就能做完的数据自检实验。
我抓了全部 183 期、3,294 个数据格,用「同一行里两个冗余列互相校验」的方法,精确定位出 1 个错值、1 条类型污染、1 期表头异常、2 期缺失。整个过程没有对照源,全靠表自己。
一、这张表为什么能自检
关键在于:存水量和蓄水百分比是冗余的。只要知道水塘容量,两者可以互相推出:
def capacity_audit(dates: list[str]) -> dict:
    """用冗余列反推容量:存水量 ÷ (百分比/100)。容量应当恒定。"""
    cap: dict[str, list[tuple[str, float]]] = {}
    for d in dates:
        for r in load(d)[1:]:
            if len(r) < 3:
                continue
            try:
                v = float(r[1].strip())
                p = float(r[2].strip().rstrip("%"))
            except ValueError:
                continue
            if p <= 0.5 or v <= 0:
                continue
            cap.setdefault(r[0].strip(), []).append((d, v / (p / 100)))
    rows = []
    for name, seq in cap.items():
        vals = [c for _, c in seq]
        med = st.median(vals)
        rows.append({"name": name, "median": med,
                     "lo": min(vals), "hi": max(vals),
                     "spread_pct": (max(vals) - min(vals)) / med * 100,
                     "n": len(vals)})
    rows.sort(key=lambda r: -r["spread_pct"])
    return rows
水塘的物理容量不可能一期一变。所以对每个水塘,把 183 期的「存水量 ÷ 百分比」摆在一起看——它应该是一条平线。跳出来的那一点,就说明这一行里至少有一格不对。
这个「反推恒定量」的思路建议收藏——它的妙处是不需要任何对照源:两列冗余本身就够。
二、先逐格体检:类型污染藏在第一期
183 期 × 18 个水塘 = 3,294 格。逐格做类型检查(存水量列必须是纯数字,百分比列必须是 xx% 格式),结果:
- 3,293 格干净,只有 1 格类型不对;
- 藏在第一期(2019-01-16):Aberdeen Lower Reservoir 的存水量列写的是
25.90%——一个带百分号的字符串混进了数字列,而它的蓄水百分比列是53.29%。
用 float() 直接转这一列会在第一期就抛异常;如果解析时悄悄跳过,这条污染又会静默消失。先逐格体检,再谈口径——顺序反了,后面的统计全是在漏数据的基础上算的。
这段逐格体检的写法值得收藏——两类检查各一个正则,三千多个格子一遍扫完。
三、反推容量:17 个水塘是一条平线,1 个跳出来
对 18 个水塘分别做「反推容量」的离散度统计:
| 结果 | 水塘数 |
|---|---|
| 极差 < 2%(基本不动) | 16 |
| 极差 2%–5% | 1(Pok Fu Lam,2.6%) |
| 极差 > 5% | 1(Lower Shing Mun,126.4%) |
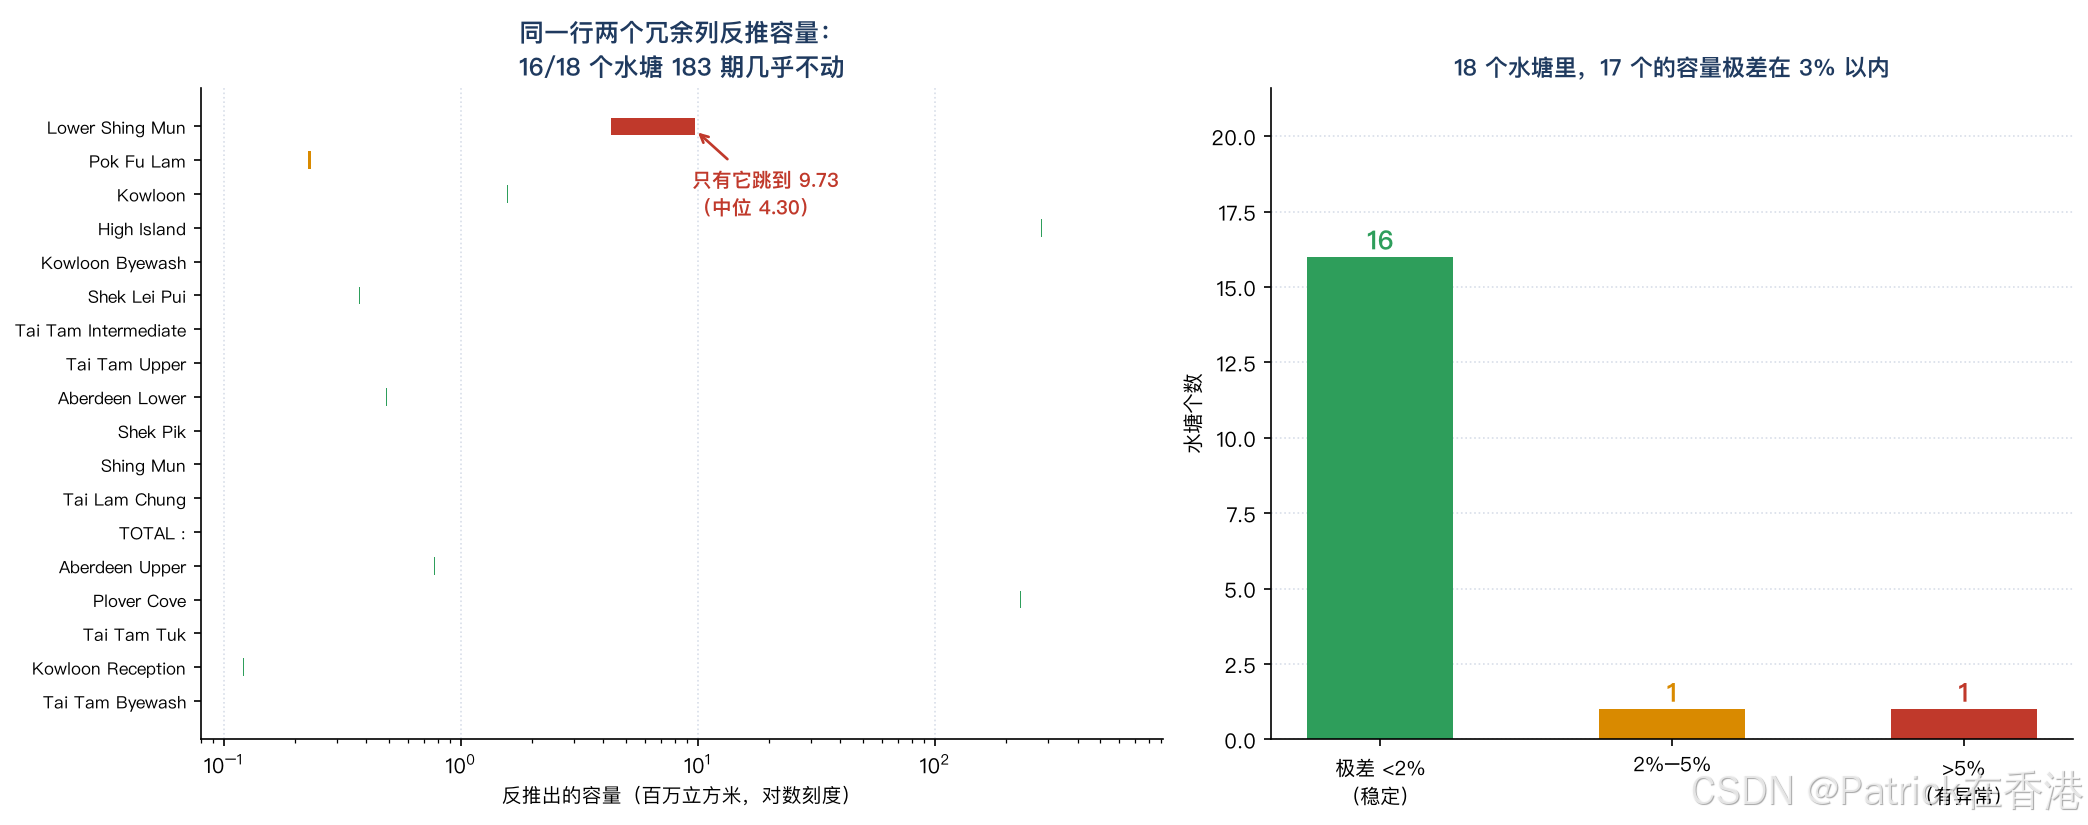
17 个水塘的容量在 183 期里几乎是一条平线——比如 High Island Reservoir 反推出的容量稳定在 281.124,离散度 0.0%。这同时说明官方的存水量和百分比两列彼此是自洽的:随便哪一期,用一列都能精确复原另一列。
def locate_outlier(dates: list[str], name: str) -> list[dict]:
    """在指定水塘上,逐期标出偏离中位容量超过 5% 的期。"""
    seq = []
    for d in dates:
        for r in load(d)[1:]:
            if len(r) >= 3 and r[0].strip() == name:
                try:
                    v = float(r[1].strip())
                    p = float(r[2].strip().rstrip("%"))
                except ValueError:
                    continue
                if p > 0.5 and v > 0:
                    seq.append({"date": d, "storage": v, "pct": p,
                                "cap": v / (p / 100)})
    if not seq:
        return []
    med = st.median([s["cap"] for s in seq])
    return [s for s in seq if abs(s["cap"] - med) / med > 0.05]
唯一的例外是 Lower Shing Mun Reservoir,把它的 183 期拉出来看:
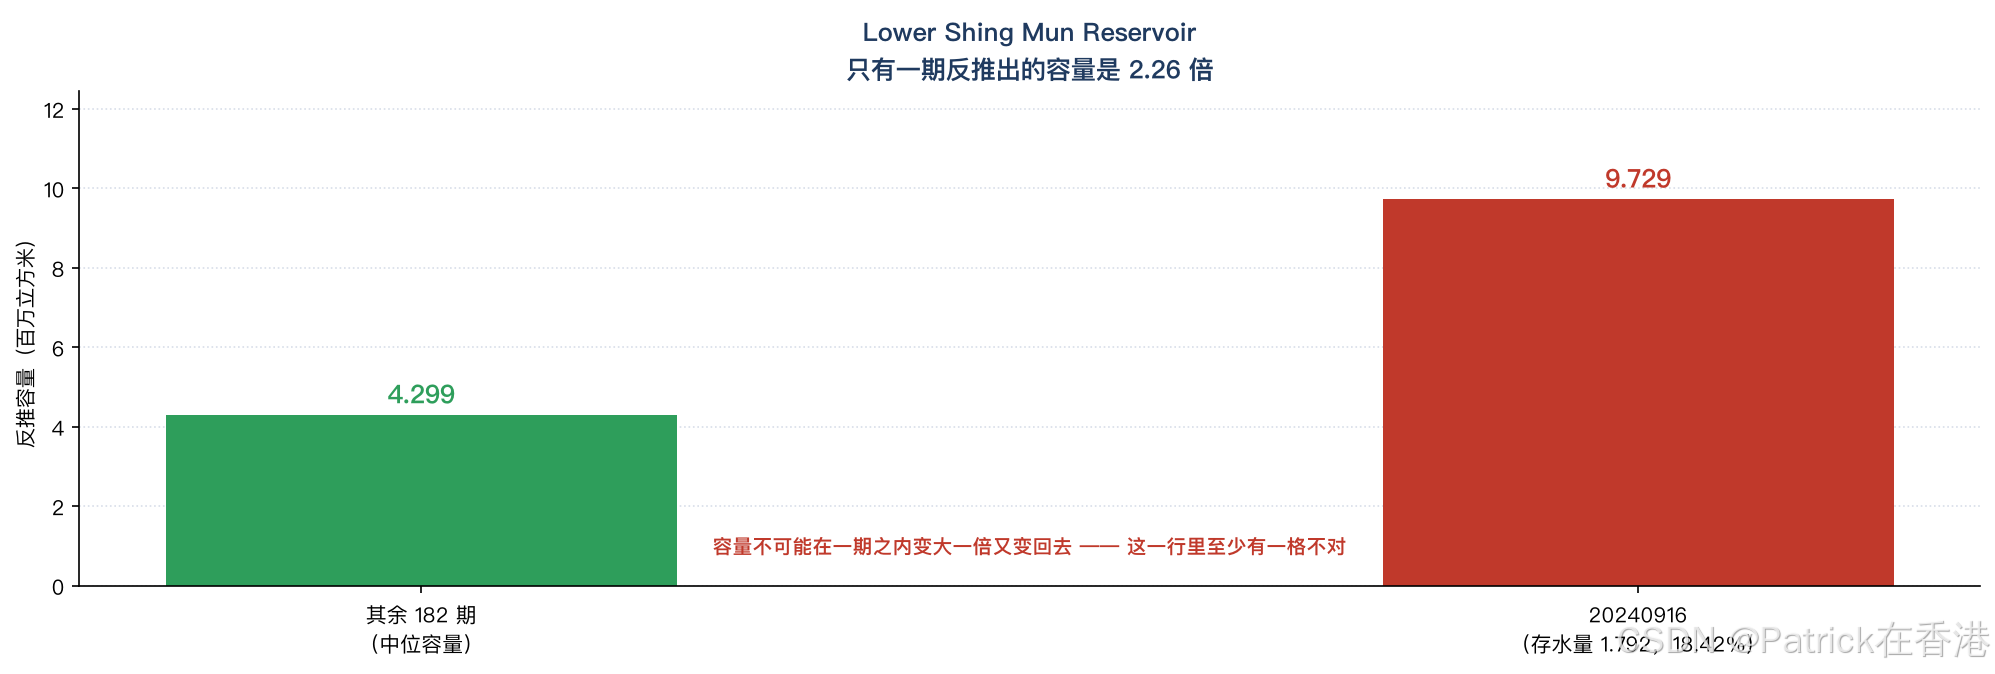
只有一期不对:2024-09-16 那期,存水量 1.792、蓄水 18.42%,反推容量 9.729——是其余 182 期中位值 4.299 的 2.26 倍。下一期立刻恢复到 4.3。
4.299 和 9.729 哪个是真的?把同期其他水塘的总存水量摆出来对比,再对照该水塘的官方公开容量,答案很清楚:9.729 是假的。大概率是那一期某个数字填错了——至于是存水量写错还是百分比写错,仅凭这张表分不出来(这正是冗余列的边界:它能告诉你哪一行有错,但不能告诉你哪一格错)。但定位到「期 + 行」已经够了:这一期这个水塘的数字不能用。
四、发布节奏:名义双周,缺了 2 期
183 期覆盖 2,800 天,相邻期间隔分布:15 天 120 次、16 天 53 次(这是正常的双周节奏,2 月短所以偶尔 13/14 天),但还有 28 天 1 次、31 天 1 次——多出来的天数对应缺失的期:
- 2022-02-01 → 2022-03-01:缺 1 期(本应有 20220216);
- 2025-03-01 → 2025-04-01:缺 1 期(本应有 20250316)。
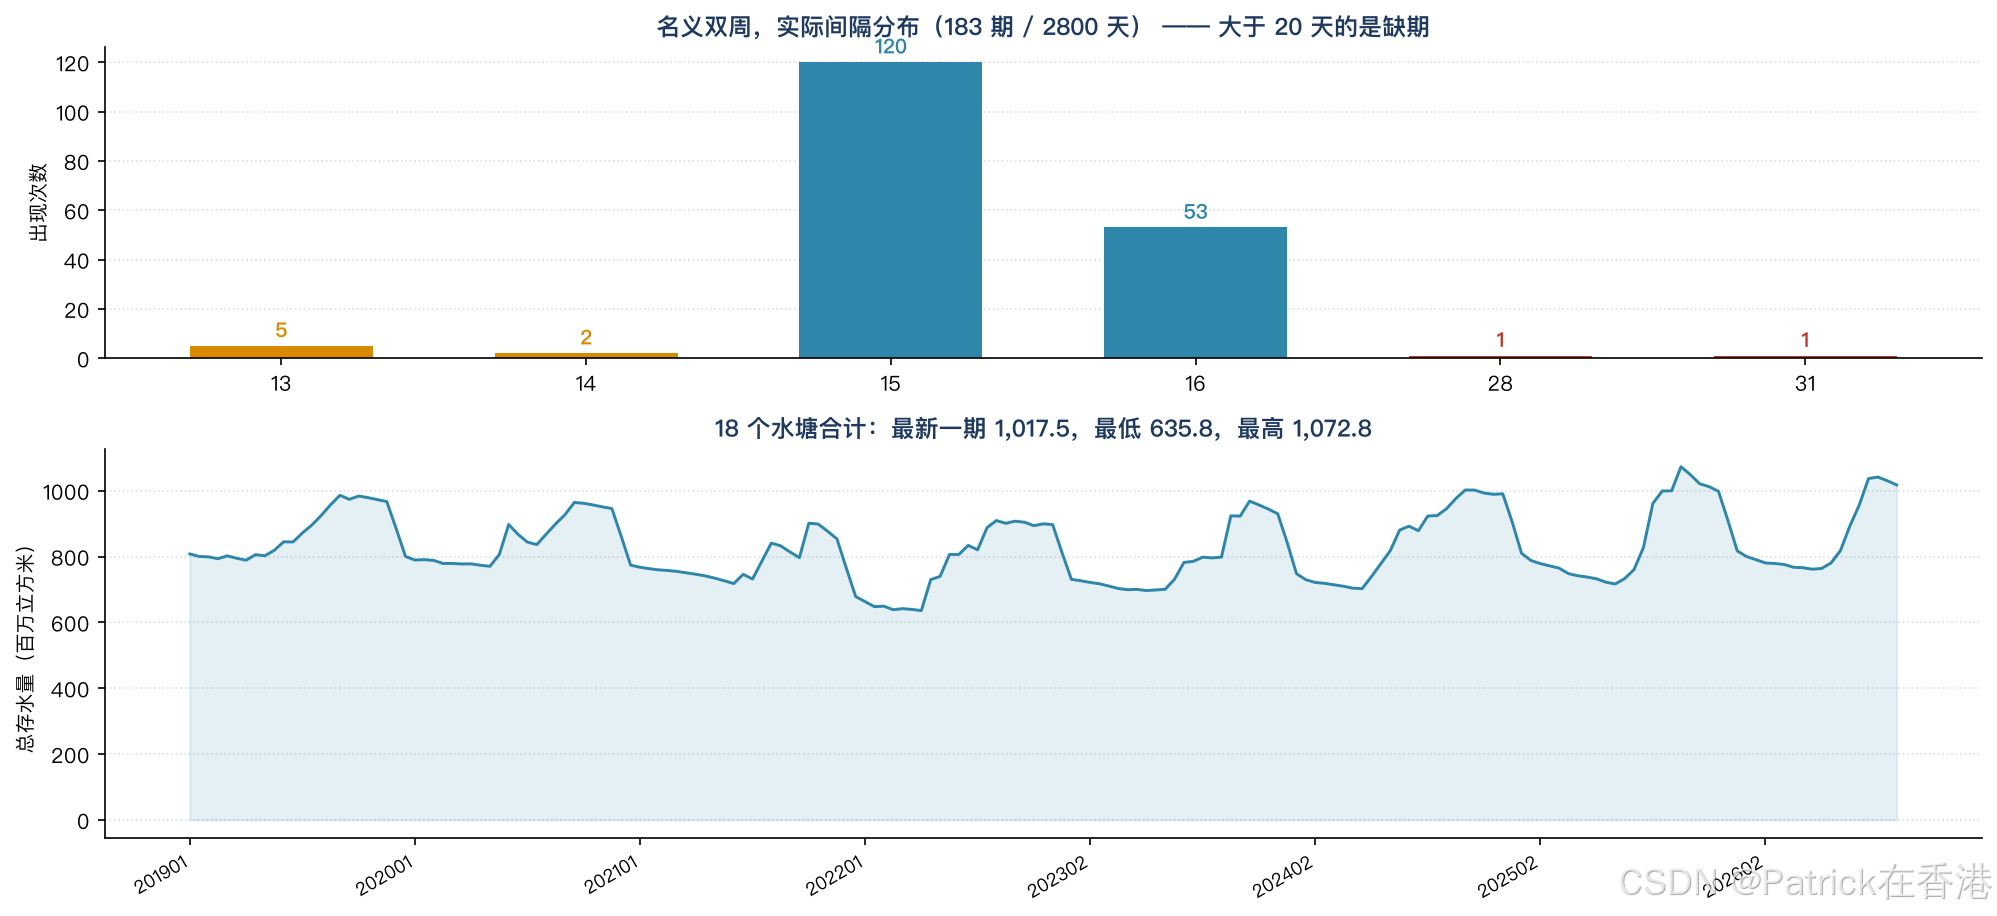
做时间序列的人要注意:这两段间隔会被自动当成「双月没有变化」,而真相是那一期的数据从来没发过。缺期不补,趋势图上就是一个不存在的平台。
这段间隔是怎么算的:
def cadence_audit(dates: list[str]) -> dict:
    """发布节奏:名义双周,实际间隔分布,以及缺期。"""
    dd = [dt.date(int(x[:4]), int(x[4:6]), int(x[6:])) for x in dates]
    gaps = [(dd[i + 1] - dd[i]).days for i in range(len(dd) - 1)]
    missing = []
    for i, g in enumerate(gaps):
        if g > 20:                       # 名义 15/16 天,超过 20 即缺期
            missing.append({"from": dates[i], "to": dates[i + 1],
                            "days": g,
                            "missing_issues": max(round(g / 15) - 1, 1)})
    return {"n": len(dates), "gaps": gaps, "missing": missing,
            "span_days": (dd[-1] - dd[0]).days}
顺带一提,间隔分布本身还能反过来校验「发布日历」:15 天与 16 天交替出现,是双周节奏撞上月份天数差异的正常表现;而 13 天和 14 天的 7 次,全部集中在 2 月→3 月的交界——月份长度会伪装成发布异常,看间隔分布时要把日历因素先剥掉。
五、双快照与总存水量
2026-09-16 这期(最新一期)抓了两次,745 字节,SHA-1 指纹完全一致——双周频的数据在两期内不会变,这符合它的发布契约。总存水量序列:最新 1,017.5 百万立方米,七年里最低 635.8(2022 年 5 月,大旱)、最高 1,072.8(2025 年 10 月),雨旱季的锯齿清晰可见。
另外两个结构层的小发现:2026-08-16 期的表头行尾多出 3 个空列(;,, 尾巴,用 csv 读会多出三列空字段);183 期里 18 个水塘的名字一个都没变过——没有新增、没有停用、没有改名。
六、结论
| 问题 | 实测结果 |
|---|---|
| 3,294 个格子干净吗 | 1 格类型污染(25.90% 混进数字列) |
| 两列冗余能互检吗 | 能:17/18 个水塘反推容量恒定 |
| 抓到几个错值 | 1 个:2024-09-16 Lower Shing Mun,2.26× |
| 发布节奏 | 名义双周,缺 2 期(20220216、20250316) |
三条:
- 表里有两列互相冗余,就是白送的自检器——不需要对照源,
数值 ÷ 百分比一除,异常自己跳出来。前提是其中一列在物理上应当恒定(容量、单价、汇率锚点都算)。 - 类型检查放在口径检查之前。一个
%混进数字列,轻则少一行数据,重则让后面的求和整体翻车。 - 缺的期不会自己出现在图上。时间序列要先算相邻间隔的分布,间隔突然翻倍的地方就是数据从未存在过的地方。
这套「冗余列互检 + 逐格类型 + 间隔分布」的三步自检建议收藏——任何「数量 + 百分比」结构的周期性数据(库存、占比、水位、磁盘使用率)都能直接套。
七、边界与声明
- 2024-09-16 那一期错在哪一格(存水量还是百分比),仅凭该表无法判定,本文只做「定位到期与行」,不做成因推断;该期数值是否已被官方修正,以水务署最新发布为准;
- 数据为香港水务署公开数据,2026-09-20 当天实抓全部 183 期(2019-01-16 → 2026-09-16)并两次快照比对确认一致,脚本可原样复跑;
- 本文只讨论数据质量,不构成任何用水或投资建议。
参考链接
- https://www.wsd.gov.hk/datagovhk/en-data/storage_position_of_individual_impounding_reservoirs_20260916_en.csv
- https://data.gov.hk/en-data/dataset/hk-wsd-wsd2-storage-position-individual-reservoir-bi-weekly
- https://www.wsd.gov.hk/en/core-businesses/water-resources/index.html
原创声明:本文全部数据来自 2026-09-20 当天对香港水务署公开数据的实抓(183 期全量 + 双快照),脚本可原样复跑。觉得有用点个关注不迷路,下一篇拆一个新数据源。


 扫一扫


 1887

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


