


目录
环境信息
- Python 3.12.13
- pandas 2.2.3
- matplotlib 3.10.8
urllib.request为标准库;其余依赖可用pip install pandas matplotlib安装。
2026年香港中学文凭考试(DSE)结果公布后,网上很容易看到两类数字:报名人数、达标人数、JUPAS录取人数,以及各科的等级分布。
这些数字单独看都是真的,放在一起却未必能直接相除。
我今天想拆的不是“哪一科最好”,而是一个做公开数据分析时非常常见、也很容易被忽略的问题:同一张表里,候选人范围、统计年份和指标定义不一致,Python代码却照样能跑完。
这类错误最危险的地方在于,它通常不会报错,只会生成一张看起来很专业的图。
本文使用香港考试及评核局公开的2025年DSE逐科统计CSV,演示如何完成四件事:
- 识别官方CSV的真实结构;
- 把“人数”和“百分比”拆成可计算的长表;
- 正确处理数学延伸部分等同名子科目;
- 在明确分母后,再生成一张可复现的比较图。
1. 先把三个口径钉死
2026年官方结果资料显示,DSE报名人数为58,487。这个数字适合做当年的背景说明,但它不是本文代码的输入数据。
本文代码固定使用2025年官方逐科CSV,原因很简单:数据目录已经提供了稳定的下载地址,字段也足够完整。新闻年份是2026年,演示数据年份是2025年,不能混写。
另外,DSE成绩统计和大学录取也不是同一个指标。JUPAS公布的2026年Main Round数据显示,45,545名申请人中有15,619人获得Main Round offer,比例为34.29%。这个比例不能拿来和DSE某个科目的Level 4+比例直接比较,因为前者是录取结果,后者是考试等级分布。
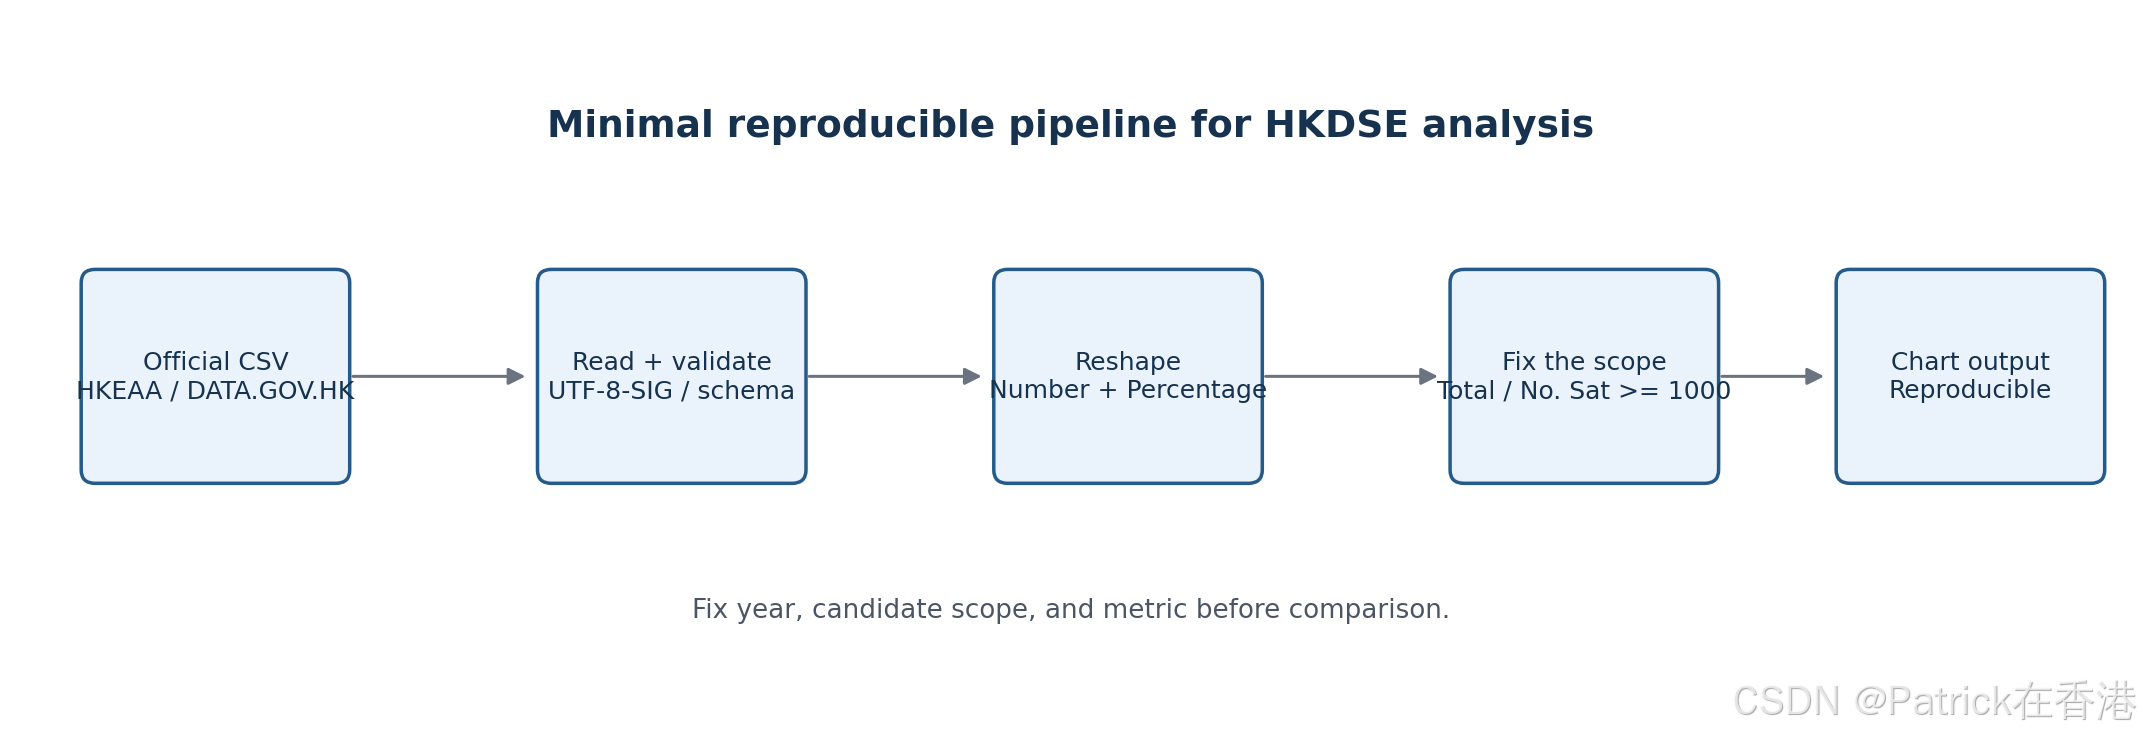
这篇文章先固定三个口径:
- 年份:2025;
- 候选人范围:
Total,即该CSV中的总计行; - 指标:
Performance - 4+,即达到Level 4或以上的比例。
少一个限定词,最后的图就可能换了含义。
2. 官方CSV长什么样
下载文件后,前几列大致是:
Subject, Subject_2, Gender, Type, No. Entered, No. Sat,
Chinese Version %, Performance - 5**, ..., Performance - 4+, ...
它不是一行一个科目,而是同一个科目拆成多行:
Gender有Male、Female和Total;Type有Number和Percentage;Mathematics下面还会通过Subject_2区分Compulsory Part、Algebra and Calculus、Calculus and Statistics。
因此,下面这种写法虽然不会报错,但统计含义是错的:
df.groupby("Subject")["Performance - 4+"].mean()
它把男性、女性、总计,以及不同类型的行混在一起了;如果直接把Subject_2丢掉,数学的几个子项还会被压成同一个名称。
3. 读取数据:先处理BOM,再做字段检查
from io import BytesIO
from urllib.request import Request, urlopen

import matplotlib.pyplot as plt
import pandas as pd


URL = (
    "https://www.hkeaa.edu.hk/DocLibrary/HKDSE/Exam_Report/"
    "Examination_Statistics/"
    "2025_HKDSE_analysis_of_results_of_candidates_table5a_1_en.csv"
)


def load_hkdse_csv(url: str = URL) -> pd.DataFrame:
    request = Request(url, headers={"User-Agent": "Mozilla/5.0"})
    with urlopen(request, timeout=20) as response:
        content = response.read()

    # utf-8-sig 可以吞掉文件开头的 BOM,避免第一列变成 \ufeffNo.
    frame = pd.read_csv(BytesIO(content), encoding="utf-8-sig")

    required = {
        "Subject", "Subject_2", "Gender", "Type",
        "No. Sat", "Performance - 4+",
    }
    missing = required.difference(frame.columns)
    if missing:
        raise ValueError(f"字段发生变化,缺少:{sorted(missing)}")

    if not {"Number", "Percentage"}.issubset(set(frame["Type"].dropna())):
        raise ValueError("没有同时找到 Number 和 Percentage 行")

    return frame


df = load_hkdse_csv()
print(df.shape)
print(df[["Subject", "Subject_2", "Gender", "Type"]].head())
这里有两个值得保留的细节。
第一,utf-8-sig不是为了“让中文显示正常”这么简单,而是为了兼容带BOM的UTF-8文件。第二,字段检查必须放在分析之前。官方数据每年更新,列名或表结构发生变化时,程序应该尽早失败,而不是悄悄给出一张旧逻辑下的图。
4. 把Number和Percentage重新拼起来
人数在Number行,比例在Percentage行。正确做法是按“科目 + 子科目”合并,而不是只按Subject合并。
def build_subject_summary(frame: pd.DataFrame) -> pd.DataFrame:
    keys = ["Subject", "Subject_2"]

    number_rows = frame[
        (frame["Gender"] == "Total")
        & (frame["Type"] == "Number")
    ][keys + ["No. Sat"]].rename(columns={"No. Sat": "sat"})

    percentage_rows = frame[
        (frame["Gender"] == "Total")
        & (frame["Type"] == "Percentage")
    ][keys + ["Performance - 4+"]]

    summary = percentage_rows.merge(
        number_rows,
        on=keys,
        how="left",
        validate="one_to_one",
    )

    summary["sat"] = pd.to_numeric(summary["sat"], errors="coerce")
    summary["level4plus"] = (
        summary["Performance - 4+"]
        .astype("string")
        .str.rstrip("%")
        .astype(float)
    )

    summary["label"] = summary["Subject"]
    has_subsubject = summary["Subject_2"].notna() & summary["Subject_2"].ne("")
    summary.loc[has_subsubject, "label"] = (
        summary.loc[has_subsubject, "Subject"]
        + " - "
        + summary.loc[has_subsubject, "Subject_2"]
    )

    # 小样本科目很容易制造“高比例”的错觉;这里仅作为演示筛掉小于1000人的科目。
    summary = summary[summary["sat"] >= 1000].copy()

    # 合计行不是单独科目,排除后再做科目比较。
    summary = summary[
        ~summary["label"].str.startswith("All Category", na=False)
    ]

    if not summary["level4plus"].between(0, 100).all():
        raise ValueError("百分比不在 0 到 100 之间")

    return summary.sort_values("level4plus", ascending=False)


summary = build_subject_summary(df)
print(summary[["label", "sat", "level4plus"]].head(10).to_string(index=False))
这里的validate="one_to_one"很重要。它会把重复键直接暴露出来。如果把Subject_2删掉,数学相关行就可能出现一对多合并;代码不应该把这种问题吞掉。
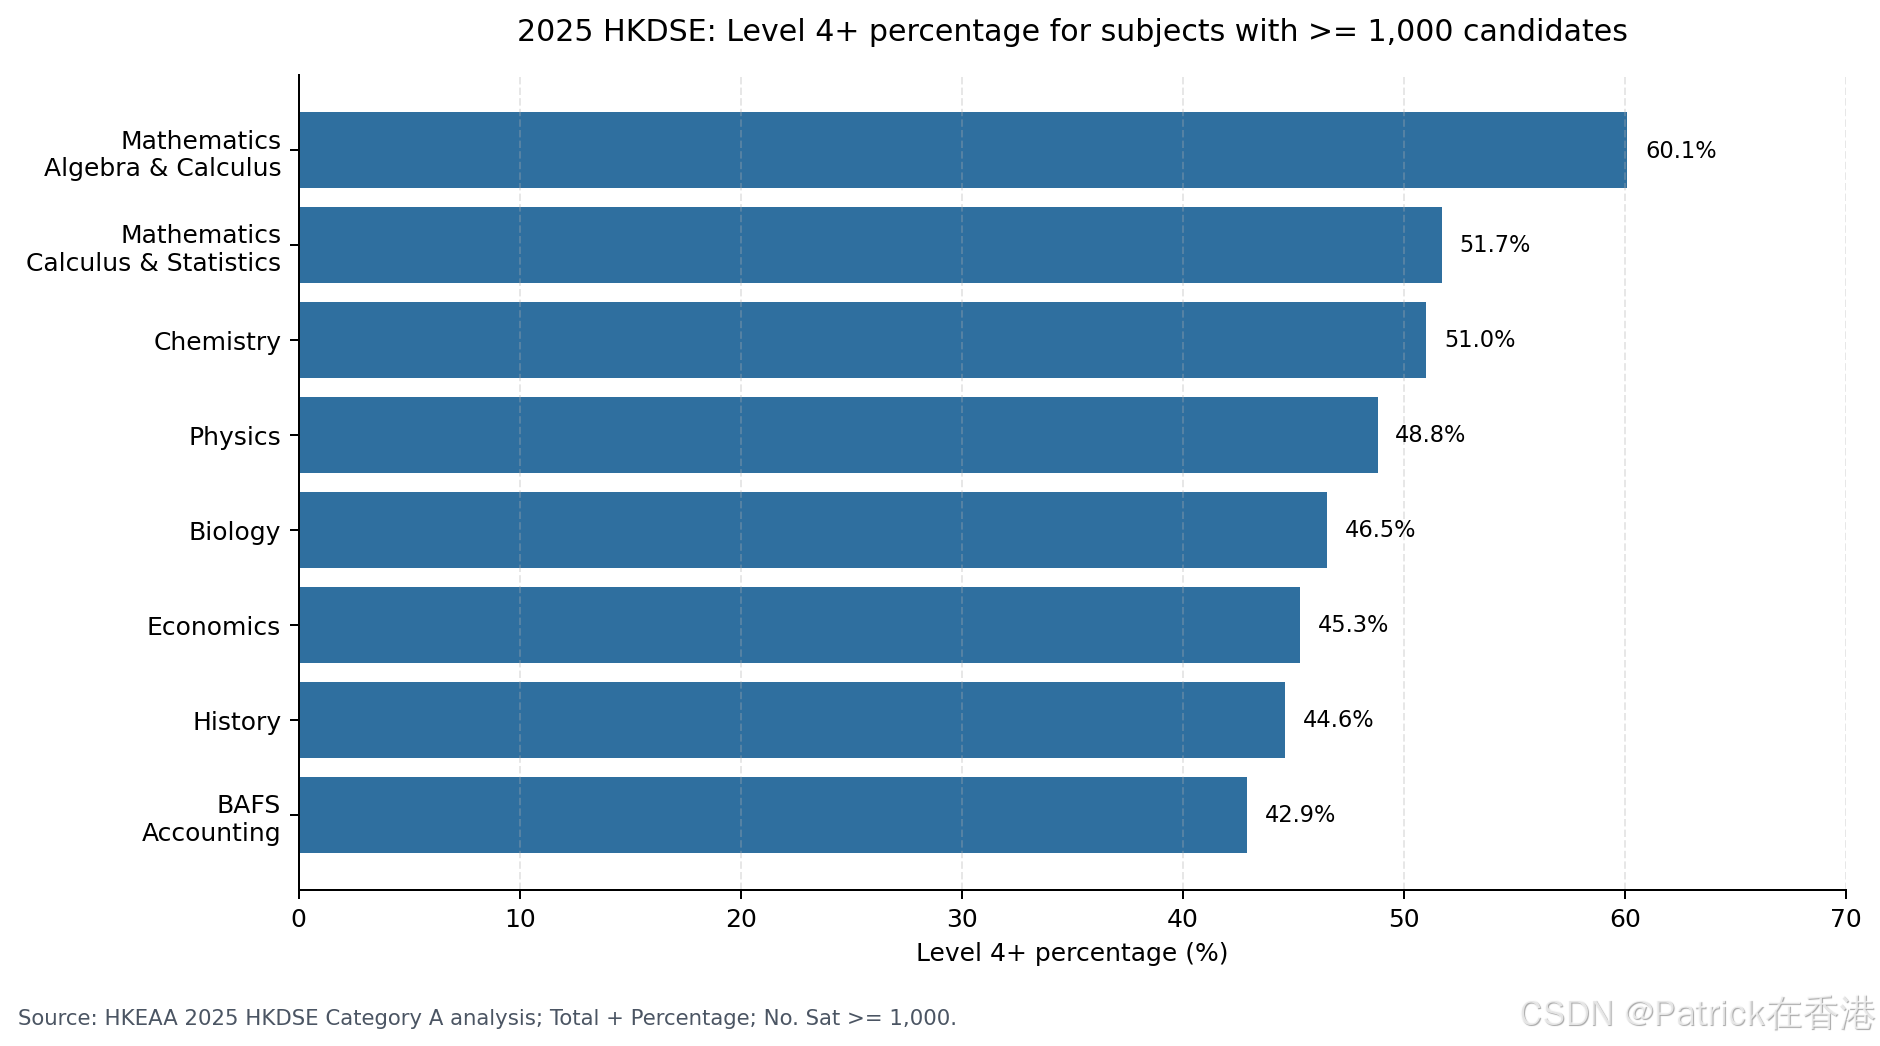
按上述口径,样本量不少于1,000的科目中,Level 4+比例靠前的几项是:数学延伸部分(代数与微积分)60.1%、数学延伸部分(微积分与统计)51.7%、化学51.0%、物理48.8%。这只是该统计口径下的结果,不等于“某科更容易”,更不能推出教学质量或学生能力的因果关系。
5. 画图前再加一道防错检查
top = summary.head(8).sort_values("level4plus")

fig, ax = plt.subplots(figsize=(10, 6))
ax.barh(top["label"], top["level4plus"], color="#2f6f9f")
ax.set_xlabel("Level 4+ percentage (%)")
ax.set_title("2025 HKDSE: Level 4+ by subject")
ax.set_xlim(0, 70)
ax.grid(axis="x", linestyle="--", alpha=0.3)
fig.tight_layout()
plt.show()
绘图前的最后检查建议保留在脚本里:
assert (summary["sat"] >= 1000).all()
assert summary["level4plus"].between(0, 100).all()
assert summary["label"].is_unique
数据分析中,assert不是多余的“新手保护”。它是在数据源更新后,帮你尽快发现字段漂移、合并重复和百分比解析失败。
6. 这张图不能说明什么
这一步比画图本身更重要。
第一,Level 4+比例不是大学录取率。DSE考试统计回答的是“考生在某科达到什么等级”,JUPAS统计回答的是“申请人有没有获得录取”。两者的分子、分母、流程都不同。
第二,科目之间不能简单排“难易榜”。不同科目的报考人群、选科门槛、样本数量和课程结构都不一样。即使某一科的Level 4+比例更高,也只能说明在这份官方统计表、这个候选人范围和这个指标下比例更高。
第三,不能把2025逐科数据和2026放榜数字拼成一张“趋势图”。要做年度趋势,必须下载多个年份、确认字段定义相同,再统一清洗;不能因为列名相似就直接concat。
7. 如果要扩展成年度分析
下一步可以把年份参数化:
def make_url(year: int) -> str:
    return (
        "https://www.hkeaa.edu.hk/DocLibrary/HKDSE/Exam_Report/"
        "Examination_Statistics/"
        f"{year}_HKDSE_analysis_of_results_of_candidates_table5a_1_en.csv"
    )
但在真正拼接前,至少要做三件事:
- 对每个年份记录官方文件的发布日期和数据字典;
- 检查
Subject_2、Performance - 4+等字段是否仍然存在; - 确认考试制度调整没有改变指标含义。
如果只想做“今年的数据看起来怎样”,一张官方CSV就够了;如果要做“这几年发生了什么变化”,那就必须把版本、字段和口径都写进数据表,而不是只在图标题上写一个年份范围。
总结
这次真正值得复用的不是某个DSE数字,而是一套处理公开统计表的习惯:
- 先区分新闻背景和代码数据的年份;
- 先固定候选人范围、指标和分母;
Number和Percentage分开处理;- 合并时保留子科目字段,并让重复键主动报错;
- 小样本只做提示,不拿来制造结论;
- 图表发布前,明确写出“这张图不能说明什么”。
如果你平时也在处理政府CSV、学校统计或业务报表,这段清洗逻辑可以直接收藏备用。真正难的往往不是把图画出来,而是确保图表没有把不同口径悄悄揉成一个结论。
参考资料
- 香港考试及评核局:2026 HKDSE Results Released
- DATA.GOV.HK:2025 HKDSE Analysis of results of candidates in each subject
- JUPAS:2026 Main Round Offer Statistics
数据说明:本文仅对公开统计数据做技术演示,不对学校、科目或个人成绩作评价;具体含义以官方文件和数据字典为准。


 扫一扫


 243


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


