


文章目录
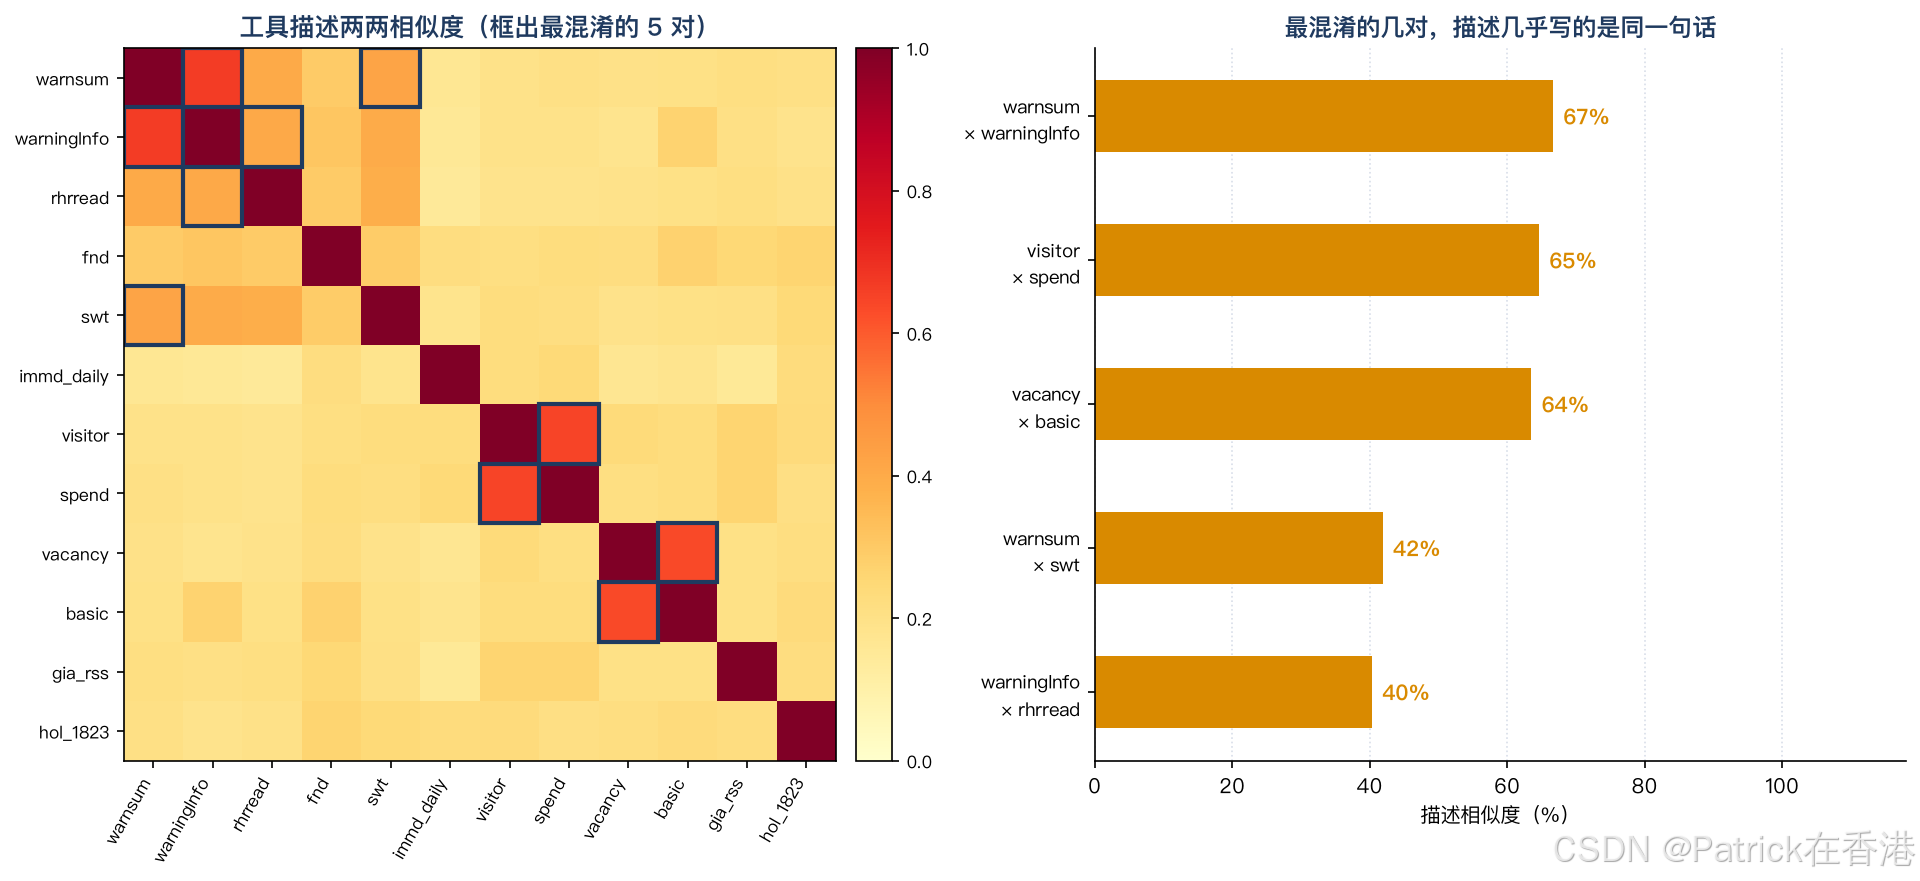
给 Claude 接工具,多数人的直觉是多多益善:能把公司里所有接口都塞进去,模型总能挑到对的那个。我此前也是这么想的,直到我把 12 个香港公开数据接口注册成一套工具,然后发现模型选工具时唯一能看到的依据——工具名和描述——有 3 对的文本相似度超过了 60%。最混淆的一对,描述几乎写的是同一句话。
这篇文章用真实接口做实验:量化歧义有多大、选错的代价是多少、以及不改代码只改描述能修复多少。所有数据当天实抓,文末代码可以原样跑。
一、实验对象:12 个真实接口
不是我编的 12 个假工具,是我这个系列一直在用的香港官方开放数据,当天 13:1x 实抓全部 200:
| 工具 | 数据源 | 响应大小 |
|---|---|---|
hko_warnsum | 天文台警告摘要 | 326 B |
hko_warningInfo | 天文台警告详情 | 1,774 B |
hko_rhrread | 天文台本港天气报告 | 2,951 B |
hko_fnd | 天文台九天预报 | 4,313 B |
hko_swt | 天文台特别天气提示 | 10 B |
immd_daily | 入境处每日通关 | 3,329,302 B |
csd_visitor | 统计处访港旅客 | 985,862 B |
csd_spend | 统计处旅客人均消费 | 191,073 B |
td_vacancy | 运输署停车场空位 | 119,595 B |
td_basic | 运输署停车场资料 | 677,492 B |
gia_rss | 政府新闻公报 | 503,568 B |
hol_1823 | 公众假期表 | 14,954 B |
注意几个刻意的组合:天文台 5 个接口都和「天气/警告」沾边;两个统计处表都是「旅客数字」;两个运输署接口都是「停车场」。这不是我故意刁难——真实项目里的工具箱就是长这个样子,因为同一件事官方本来就给好几个口径。
二、量化歧义:模型看到的只是描述
模型选工具时看不到接口实现,只看得到 name 和 description。所以歧义要在这两段文本上量。我用字符级 bigram 的 Jaccard 相似度:
def bigrams(s: str) -> set:
    """中文没有现成分词,字符级 bigram 足够刻画描述的相似度。"""
    s = re.sub(r"\s+", "", s)
    return {s[i:i + 2] for i in range(len(s) - 1)} | set(s)


def jaccard(a: set, b: set) -> float:
    if not a or not b:
        return 0.0
    return len(a & b) / len(a | b)
12 个工具 66 对组合,结果比预想的严重:
- 3 对相似度 ≥ 60%:警告摘要 × 警告详情 66.7%、访港旅客 × 旅客消费 64.6%、停车场空位 × 停车场资料 63.5%;
- 相似度 ≥ 40% 的有 6 对,其中 4 对落在天文台 5 件套自己身上;
- 全表平均相似度 24.9%——低分的大多是「天气 × 停车场」这种无关对,把平均值稀释了,真正的雷埋在高分对里
这个相似度矩阵的做法建议收藏——纯文本计算,工具箱上线前一分钟就能扫完一遍。。
三、歧义的代价:不是报错,是给你一个像样的错答案
描述相似只是「容易选错」,选错了会怎样?我拿当天数据算了三笔账。
第一笔:时间。 同一时刻(13:1x)抓的四个天气口径,各自报出的更新时间是:警告摘要 13:00、警告详情 13:00、天气报告 13:02、九天预报 11:30。跨了 92 分钟。问「现在有警告吗」选中九天预报,你拿到的是 92 分钟前的世界观,而且接口不报错、数据格式完全合法。
第二笔:结构。 警告摘要这个接口最阴——顶层键就是警告代码,今天返回 {"WHOT": {...}, "WFIRE": {...}}。但 WFIRE 这个键下面的 code 字段是 WFIREY(黄色火灾警告)。按键名做匹配会漏掉级别信息,按 code 做匹配又会发现键对不上。同一个工具,两个「天然的」解析姿势,一个必然丢数据。
第三笔:单位。 三个口径都自称「旅客数字」:2025 年访港旅客 49,894,832 人次、过夜旅客人均消费 5,503 港元、入境处某日合计到达 444,240 人(其中真正的旅客只有 131,345,比值 3.38——合计列含香港居民)。把人均消费当人次用,或者把合计当旅客用,数就完全不可比,而且每一个数字单独看都像是对的。
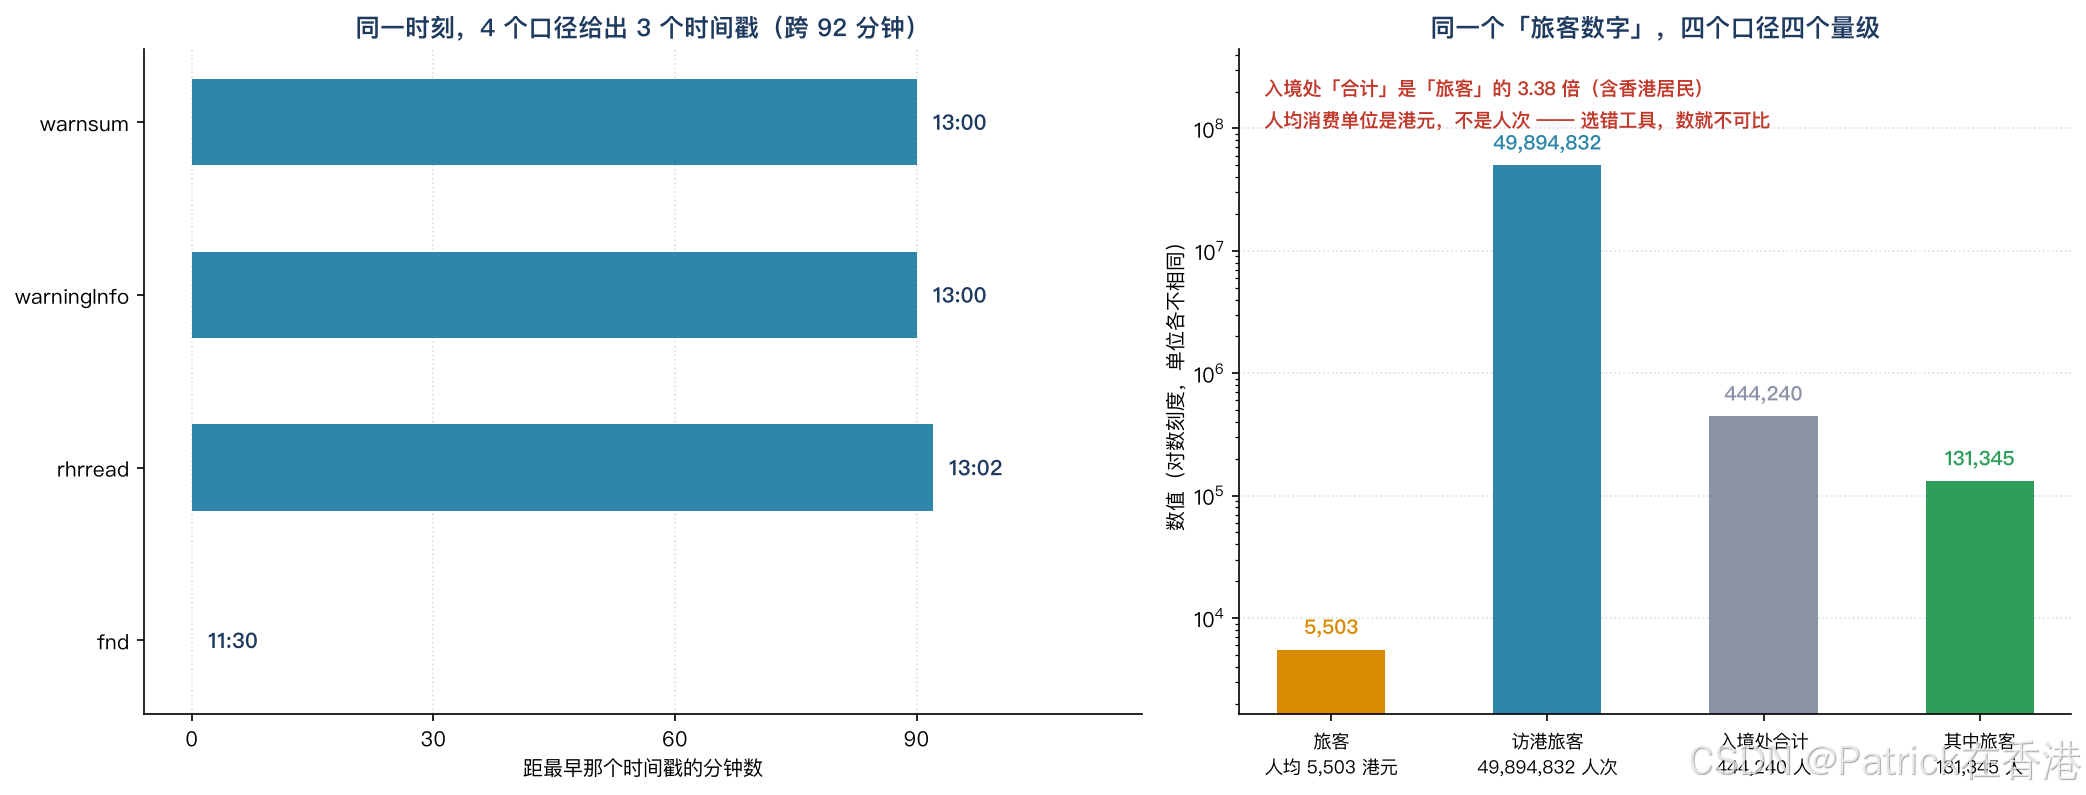
这三笔账值得收藏——它们是判断「工具选没选对」的三个检查点。
这就是工具选择歧义的真实代价:它不抛异常,它给你一个格式正确、数值真实、口径错误的答案。
四、消歧实验:只改描述,不动代码
修复方式出乎意料地便宜。我给每个工具的描述补了两样东西:它不负责什么,以及判别的依据。比如警告摘要:
DISAMBIG = {
    "hko_warnsum": "香港天文台警告摘要。只回答「现在有没有警告、什么级别」;"
                   "不给气温、不给预报、不给人类可读文案。判字段用 code 而非顶层键。",
    "hko_warningInfo": "香港天文台警告详情。只给人读的中文文案,没有结构化级别;"
                       "要做判断请用 get_weather_warning_summary。",
    # …… 其余 10 个同构,完整版在文末脚本
}
改写后全表平均相似度 24.9% → 16.8%,原来 3 对 ≥60% 的组合分别降到 39.9% / 45.2% / 37.3%,降幅最小的也降了 19 个百分点。
五、用 10 个真实问题复检
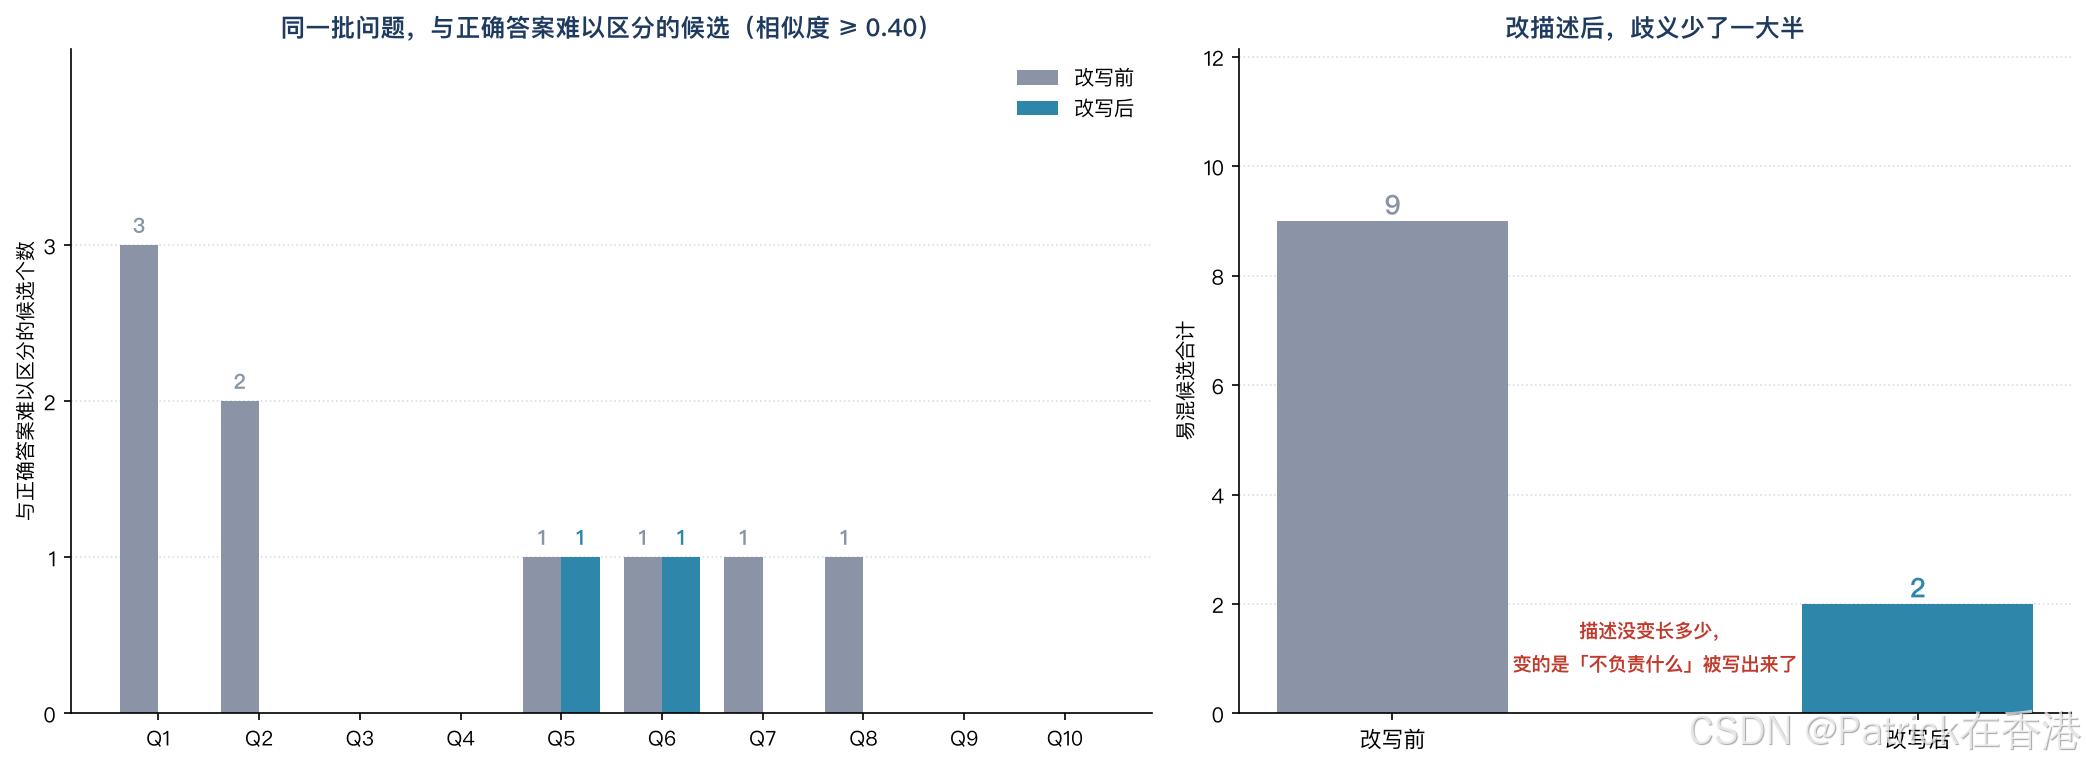
光看相似度不够,我用 10 个真实会问的问题(「现在有警告吗」「附近有没有车位」「下一个假期是什么时候」……)复检:先按关键词命中候选工具,再看候选里有多少个与正确答案的描述相似度 ≥ 0.40——这些就是真正会互相冒充的选项。
def candidate_sets(desc: dict, sim: dict, thresh: float = 0.40) -> list[dict]:
    """n = 命中关键词的候选数;confuse = 其中与期望工具难以区分的个数。"""
    def s(a, b):
        return sim.get(f"{a}|{b}", sim.get(f"{b}|{a}", 0.0))

    rows = []
    for q, expect, kws in QUESTIONS:
        hits = [k for k, d in desc.items() if any(w in d for w in kws)]
        conf = [k for k in hits if k != expect and s(k, expect) >= thresh]
        rows.append({"q": q, "expect": expect, "n": len(hits),
                     "confuse": len(conf), "hits": hits,
                     "confuse_list": conf, "ok": expect in hits})
    return rows
结果:易混候选合计 9 → 2。「现在有警告吗」这一题从 3 个互相冒充的候选降到 0——改写后,警告摘要的描述里写明了「不给气温、不给预报」,它和天气报告、九天预报就再也搅不到一起了。
我还检查了阈值敏感性:把判别线放到 0.35 和 0.45,改写后的易混候选数同样显著下降,结论不依赖某一个魔法阈值。同样重要的是反方向:10 个问题的正确工具始终留在候选集里,消歧没有把正确答案挤出去。
六、两个描述里藏不住的坑
改描述能解决「选错工具」,解决不了「选对工具之后的坑」。这两个坑描述写得再好也在:
swt 返回空数组不代表没有警告。 今天它的返回是 {"swt": []}——10 字节。特别天气提示是临时通道,没有提示时就是空的;同一个时刻警告摘要里躺着两条生效中的警告。「接口空了」和「事件没了」是两句话,这条我此前实测过一次:警告都延期了,这个通道照样是空的。
rhrread 的 warningMessage 是给人看的。 今天它返回两条文案,包括「天文台在下午1時正發出酷熱天氣警告,市民應慎防中暑」——文案里带着完整的时刻和劝告,但它是自然语言,且整份报告的 updateTime 是 13:02(报告刷新时间,不是警告的更新时间)。要做判断用警告摘要,要展示给人看才用它。
七、结论
| 问题 | 实测结果 |
|---|---|
| 工具描述会混淆到什么程度 | 66 对里 3 对 ≥60%,最高 66.7% |
| 选错的代价 | 时间差 92 分钟 / 键名≠code / 单位差 3.38 倍 |
| 只改描述能修复多少 | 平均相似度 24.9%→16.8%,易混候选 9→2 |
| 有没有副作用 | 正确工具始终留在候选集,无召回损失 |
三条建议:
- 工具箱上线前先跑一遍相似度矩阵——它是纯文本计算,一分钟出结果,专挑 ≥60% 的对子下手。
- 描述里写「不负责什么」比写「负责什么」更管用。「查询天气警告」人人都写;「不给气温、不给预报」只有消歧时才会写,而这恰恰是模型区分两个工具的依据。
- 工具的解析陷阱要写进描述。「判字段用 code 而非顶层键」「-1 表示没有数据」这类事实,写进描述等于把踩坑经验变成了运行时知识。
八、完整的消歧对照表
12 个工具的改写前后描述、相似度矩阵和全部实测数字都在这个脚本里,换你自己的工具清单,改 TOOLS 和 DISAMBIG 两个字典就能复用:
python claude_tool_choice_ambiguity.py report—— 出全部数字与三张图python claude_tool_choice_ambiguity.py assert—— 离线断言,不联网
这套「先量化歧义、再改描述、再用问题集复检」的流程建议收藏,工具箱每加一个新工具都值得重跑一次——因为歧义是新工具和老工具之间的关系,加的时候永远看不出来。
九、边界与声明
- 描述文本由我按「开发时最自然的写法」撰写,相似度结论描述的是这类写法的风险,不代表任何特定模型的真实选择准确率——后者需要真实调用才能统计,本文未做;
- 代价部分的数字(时间戳跨度、口径比值)来自 2026-09-19 当天实抓,会随日期变动,方法比数字更值得带走;
- 数据均为香港政府公开数据,仅作数据工程讨论,不构成任何消费或投资建议。
参考链接
- https://data.weather.gov.hk/weatherAPI/opendata/weather.php?dataType=warnsum&lang=tc
- https://www.immd.gov.hk/opendata/eng/transport/immigration_clearance/statistics_on_daily_passenger_traffic.csv
- https://www.censtatd.gov.hk/tc/web_table.html?id=650-80001
原创声明:本文全部实测数据来自 2026-09-19 当天对香港官方开放接口的实抓,代码可原样复跑。觉得有用点个关注不迷路,下一篇拆一个新数据源。


 扫一扫


 506

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


