


文章目录
香港的失业率每个月都会出现在新闻里,看起来是一个数。但政府统计处的开放数据接口里,它同时是两列:「失业率」和「经季节性调整的失业率」,同一个期号,两个官方数字。我把劳动人口表 210-06101 整包拉了下来——13,475 行、3.2 MB、零鉴权,一次 GET 就能拿到 1985 年至今的完整序列。
真正费劲的不是抓,是读。这张表埋了四个坑,每一个都不报错,每一个都会让结论悄悄变形。这篇文章把它们逐个拆开,全部数字来自 2026-09-21 当天实抓,脚本可原样复跑。
一、表的骨架:13,475 行,8 个字段代码
接口返回的结构很朴素,一行一条记录:
SEX / SEXDesc / freq / period / sv / svDesc / figure / sd_value
sv 是字段代码,一共 8 个:LF(劳动人口)、EM(就业人数)、UE(失业人数)、UDE(就业不足人数)、UR(失业率)、SAUR(经季节性调整失业率)、UDR(就业不足率)、LFPR(劳动人口参与率)。时间覆盖 539 期——498 个三个月移动期(198503→202608)加 41 个年度(1985→2025),每期再拆 Total / Male / Female 三组。
但把 (sv, svDesc) 拼起来数一下,是 9 种,不是 8 种。多出来的那一种,就是第一个坑。
二、第一个坑:sv 不是唯一键
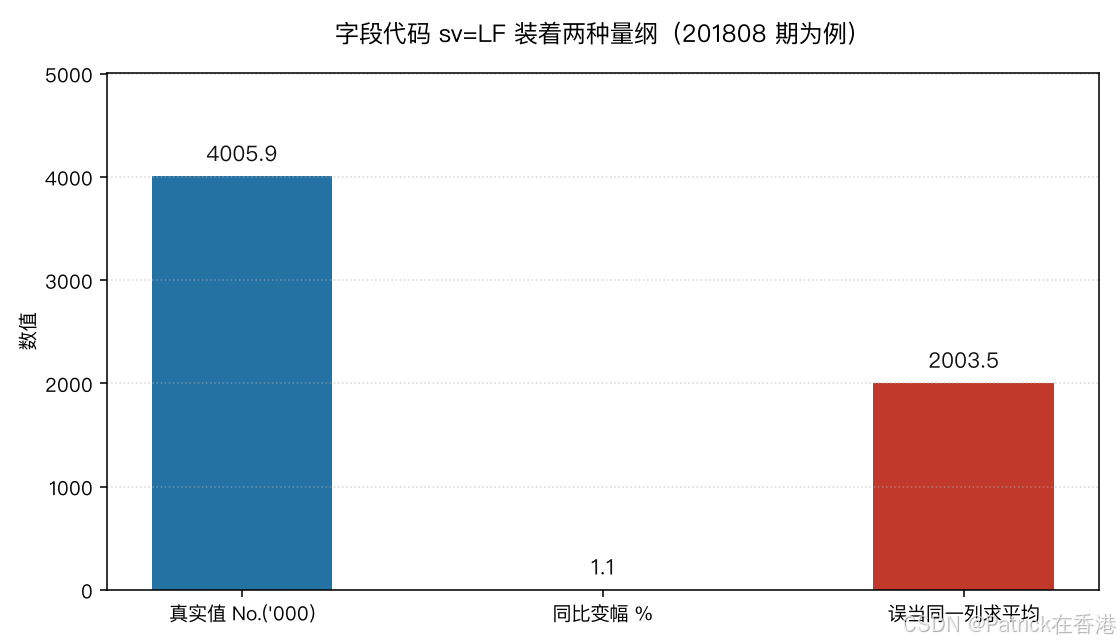
LF 的 3,234 行里,一半的 svDesc 是 No. ('000)(千人),另一半是 Year-on-year % change(同比变幅)。同一个字段代码,装着两种完全不同的量纲。
后果取决于你怎么读它:
- 用
{r["sv"]: r["figure"]}建字典:13,475 行最后只剩 8 个键,13,467 行被静默覆盖; - 用
pivot_table(columns="sv"):pandas 默认aggfunc="mean",两种量纲被平均。
第二种更隐蔽。以 201808 期 Total 为例:
{"true": 4005.9, "yoy": 1.1, "wrong_mean": 2003.5, "wrong_over_true_pct": 50.01}
真值 4,005.9 千人,同比 +1.1%,取平均得 2,003.5——恰好是真值的一半。因为它是个小量,平均下来永远落在真值的一半附近,既不会溢出也不会异常,图上就是一条平滑的、错了一半的曲线。查这张表第一件事,是把键从 sv 换成 (sv, svDesc)。
三、freq 列里藏着两种日历
freq 只有两个取值:M3M(三个月移动期,12,450 行)和 Y(年度,1,025 行)。两件事会出问题。
第一,period 的长度不一样:月期是 6 位(202608),年度是 4 位(2025)。如果直接把 period 当字符串排序画折线,41 个年度行全部会插在当年 1 月之前——每一年平白多出一个数据点,一年一次的假跳变。
第二,相邻 M3M 期共享三分之二的样本。202607 是 5–7 月,202608 是 6–8 月,中间重叠两个月。498 期不是 498 个独立样本,做环比、做相关性检验、算转折点,自由度都会被高估;拿它跟某个「某月发生的事件」对齐时,比的其实是以该月结尾的三个月平均。
四、sd_value:名字像标准差,装的是脚注
我最先犯的错就是把 sd_value 当成 standard deviation。它不是。全表 13,475 行,这一列只有 4 种取值:
| sd_value | 行数 | 含义 | figure |
|---|---|---|---|
| 空字符串 | 11,709 | 无脚注,终值 | 数值 |
N.A. | 1,719 | 不适用 | 空字符串 |
p | 25 | 临时数字,仍会被修订 | 数值 |
[§3] | 22 | 增减少于 0.05% | 空字符串 |
两个细节值得单独说:
- 缺失值不是
null,是空字符串。1,741 行的figure是"",float()直接抛异常,用 pandas 读整列会退化成 object 类型,后续所有数值运算都得先过一遍类型过滤。 p只出现在最新一期(202608)的 25 行里,覆盖全部 8 个指标。也就是说官方用这一个字符告诉你:这一期所有数字都还是临时的,下一期可能改。拿它跟终值拼在同一条序列里做长期拟合,等于把「估计值」和「终值」当成同一种东西。
把这两条修完,再叠加第二节和第三节的教训,读取函数至少要长这样:
import json
from collections import defaultdict

def load_table(path):
    """把 13,475 行原始记录读成可分析的干净序列。"""
    doc = json.load(open(path, encoding="utf-8-sig"))
    clean, dropped = [], []
    for r in doc["dataSet"]:
        r = dict(r)
        if not isinstance(r["figure"], (int, float)):   # 1,741 行空字符串
            dropped.append(r)
            continue
        r["status"] = r.pop("sd_value")                 # 脚注列改名,防误用
        clean.append(r)
    by_freq = defaultdict(list)                         # M3M 与 Y 分开装
    for r in clean:
        by_freq[r["freq"]].append(r)
    key = lambda r: (r["sv"], r["svDesc"])              # sv 不是唯一键
    return by_freq, dropped, len(doc["dataSet"])
五、缺期不是随机的:早年只有季末有数
把 UR 的 498 个月期里标着 N.A. 的挑出来,是 64 期,集中在 198504–199302。第一眼看像数据损坏,其实形状极其规整:
def na_pattern(rows):
    """缺的 64 期不是随机缺失:1985-1993 只给季末。"""
    quarter_end = ("03", "06", "09", "12")
    ur = [r for r in rows if r["freq"] == "M3M"
          and r["SEXDesc"] == "Total" and r["sv"] == "UR"]
    na = sorted(r["period"] for r in ur if r["sd_value"] == "N.A.")
    ok = sorted(r["period"] for r in ur if isinstance(r["figure"], (int, float)))
    first_full = next(p for p in ok if p > na[-1])
    return {
        "n_missing": len(na),                                  # 64
        "range": (na[0], na[-1]),                              # (198504, 199302)
        "all_non_quarter_end": all(p[4:] not in quarter_end
                                   for p in na),               # True
        "first_full_monthly": first_full,                      # 199303
    }
64 期全部不是季末月(3/6/9/12 月),而这段区间里的 36 个季末月一个不缺。也就是说前八年名义上是月度期号,实际节奏是季度——直到 199303 起才转成真正的逐月。如果直接对整条序列做「月度环比」,前八年三分之二的月份会以 NaN 形式参与计算,很多库会静默把它们丢掉或填零。
六、同一期两个官方数:175 期差 0.2 个百分点以上
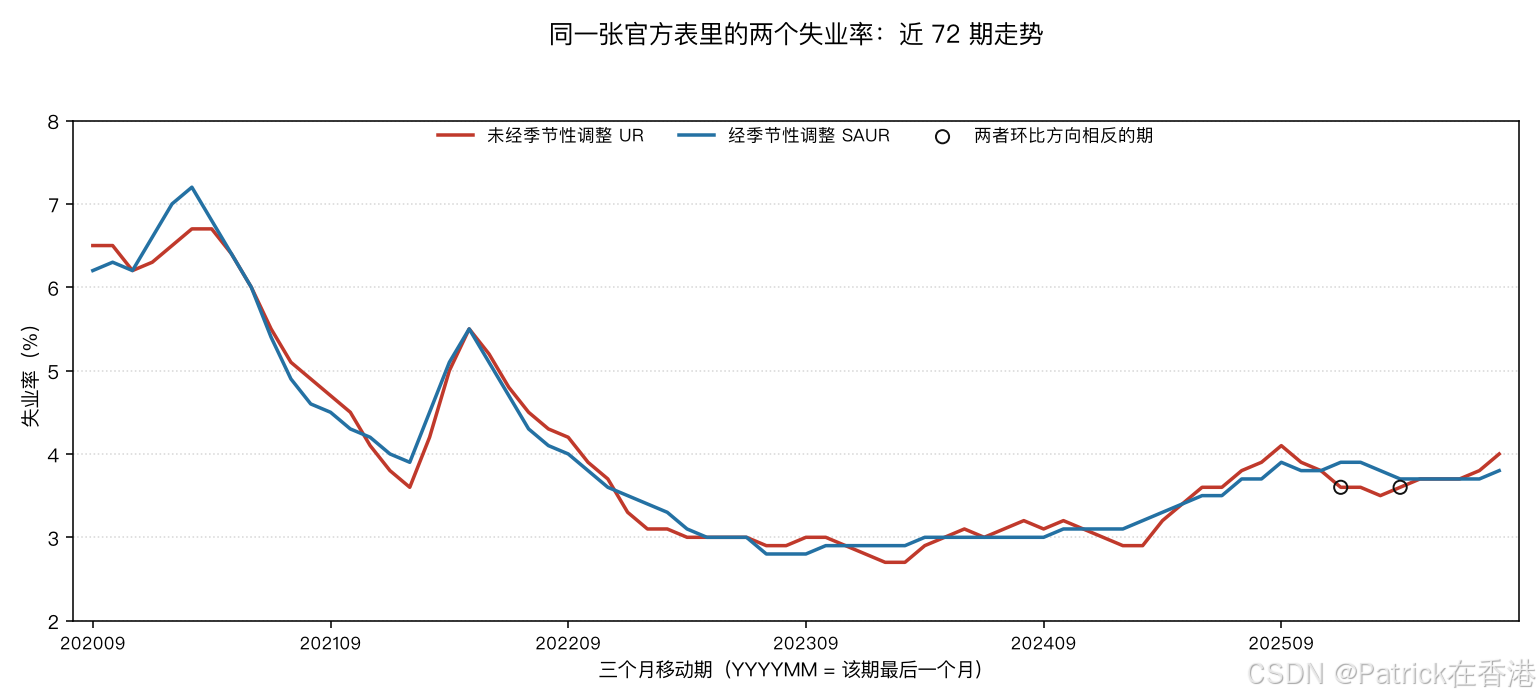
把 UR 和 SAUR 的 Total 序列对齐,两者都有数的共 434 期。差距比直觉大:
| 对照项 | 实测 |
|---|---|
| 差 ≥0.2 个百分点 | 175 期(40.3%) |
| 平均绝对差 | 0.139 个百分点 |
| 最大差 | 0.5(199901:UR 5.9 / SAUR 6.4) |
| 环比方向相反 | 27 期 / 433 步(6.2%) |
| 环比幅度差 ≥0.1 个百分点 | 115 期(26.6%) |
| 方向反转次数 | UR 99 次 vs SAUR 80 次 |
最近三期是最直观的样本:202606 期两个口径同为 3.7;202607 期 UR 3.8、SAUR 3.7;最新一期 202608(整期标 p)UR 4.0、SAUR 3.8。两个数都出自官方,选哪个决定了你在图上看到「续升」还是「走平」。
更麻烦的是季节性调整不是稳定方法。表注写明:2008 年 5 月起由 X-11 ARIMA 换成 X-12 ARIMA,且 2006 年 11 月–2007 年 1 月之后的序列已用新方法重订——这条序列上有一个官方承认的断点,跨 2007 年前后的长序列拟合要格外小心。
def dual_gauge(clean):
    """同一期两个官方失业率:差多少,方向反过几次。"""
    pick = lambda sv: {r["period"]: r["figure"] for r in clean
                       if r["freq"] == "M3M" and r["SEXDesc"] == "Total"
                       and r["sv"] == sv}
    ur, sa = pick("UR"), pick("SAUR")
    both = sorted(set(ur) & set(sa))
    gaps = [round(abs(ur[p] - sa[p]), 4) for p in both]     # 抹平浮点误差
    steps = [(round(ur[b] - ur[a], 4), round(sa[b] - sa[a], 4))
             for a, b in zip(both, both[1:])]
    return {
        "n": len(both),
        "ge_0p2": sum(g >= 0.2 for g in gaps),
        "pct_ge_0p2": round(sum(g >= 0.2 for g in gaps) / len(gaps) * 100, 1),
        "max_gap": max(zip(both, gaps), key=lambda x: x[1]),
        "opposite": sum((d1 > 0) != (d2 > 0) for d1, d2 in steps
                        if d1 != 0 and d2 != 0),
        "latest": [(p, ur[p], sa[p]) for p in both[-3:]],
    }
七、表自己也「对不上」:四舍五入的痕迹
不用对照源,表自己就能验两件事。
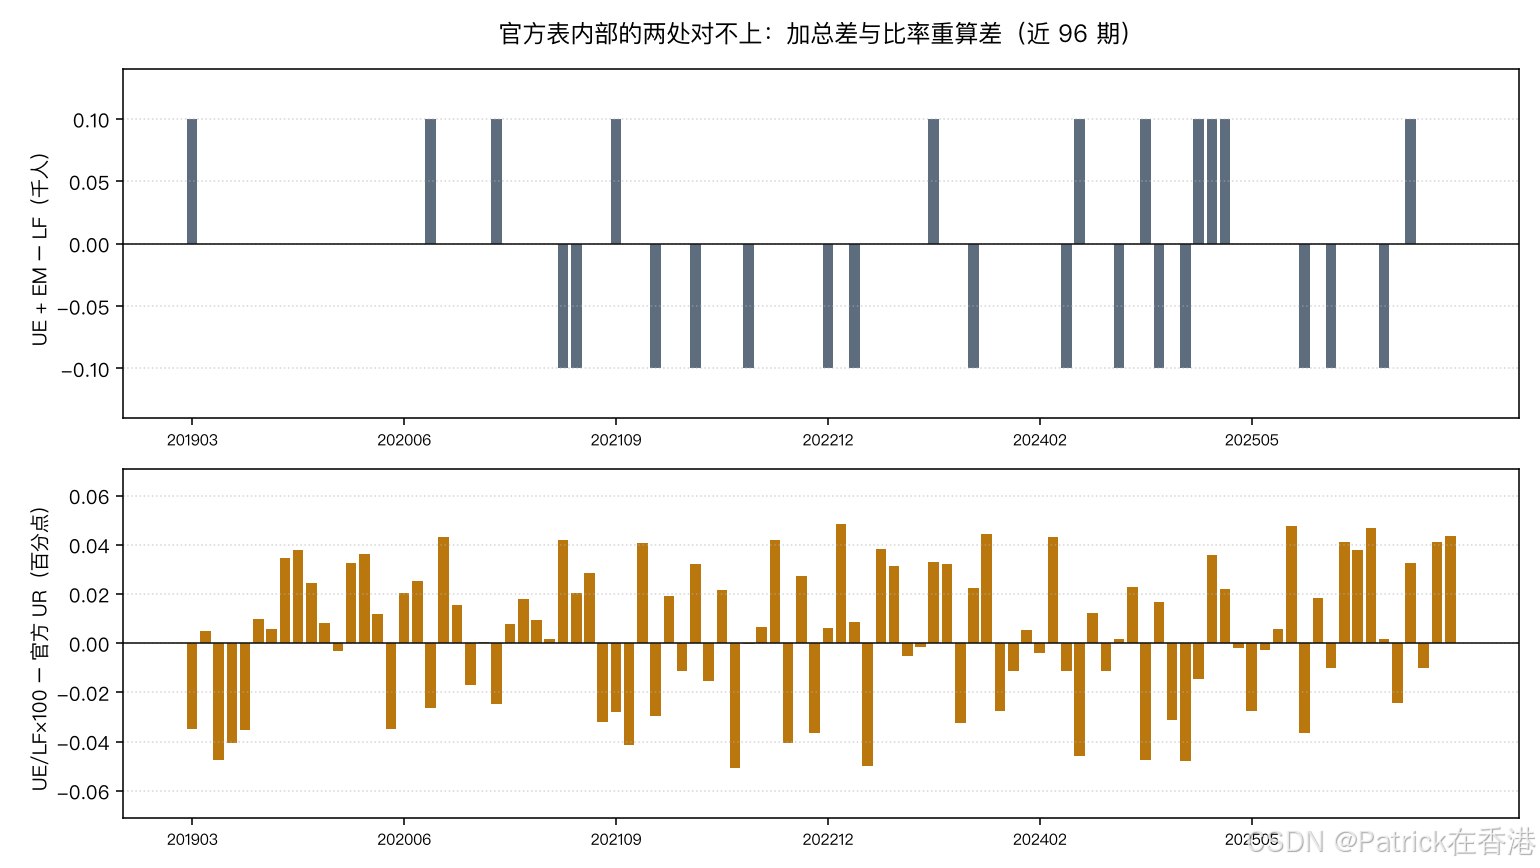
加总:UE + EM 应该等于 LF。1,425 次校验里 357 次(25.1%)对不上,最大差 0.1 千人——正好是表注「人数四舍五入到最接近的百位」允许的误差。
比率:UE ÷ LF × 100 应该等于 UR。1,425 次重算里 16 次偏差超过 0.05 个百分点,最大 0.0514(199702 期 Female:官方 1.9,重算 1.8486)。方向完全随机,这就是四舍五入的指纹,不是错误。
这个检查的价值在于反向使用:如果你重算出来的差是系统性的(恒为正或恒为负),那才说明你把口径读错了——比如拿年度对月度,或者把就业不足人数混进了失业人数。
八、结论
| 问题 | 实测结果 |
|---|---|
| sv 能当唯一键吗 | 不能:LF 一个代码装两种量纲,平均后恰好错一半 |
| period 能直接排序吗 | 不能:41 个年度行全部插进当年 1 月之前 |
| sd_value 是什么 | 脚注状态列:p=临时数字 / N.A.=不适用 / [§3]=变动小于 0.05% |
| 缺的 64 期是什么 | 1985–1993 只发季末,199303 起才是逐月 |
| 两个官方失业率差多少 | 434 期里 175 期差 ≥0.2 个百分点,27 期方向相反 |
三条可以带走的:
- 字段名会撒谎。
sd_value、figure、sv这类缩写必须先读表注再动手,这张表的表注一共 12 条,把 p、N.A.、[§3] 和四舍五入规则全写清楚了——官方文档比任何猜测都便宜。 - 一个代码列两种量纲时,聚合函数就是结论。
mean、sum、first会给你三个完全不同的答案,而且都不报错。 - 缺失的形状本身就是信息。64 期缺失全部落在非季末月,这一条规律比任何缺失值填充方法都更接近真相。
九、边界与声明
- 最新一期 202608 官方标记为临时数字(p),后续可能修订,本文引用时均已注明;
- 「经季节性调整」的方法在 2008 年 5 月切换并回溯重订,跨 2007 年前后的对比仅列示官方声明,本文不做该区间的趋势判断;
- 本文只讨论数据读取与口径,不构成任何就业市场或投资判断。
参考链接
- https://www.censtatd.gov.hk/api/get.php?id=210-06101&lang=en&full_series=1
- https://www.censtatd.gov.hk/en/web_table.html?id=210-06101
- https://www.censtatd.gov.hk/en/s/index/110010
原创声明:本文全部数字来自 2026-09-21 当天对香港政府统计处开放数据接口的实抓(13,475 行全量),脚本可原样复跑。觉得有用点个关注不迷路,下一篇拆一个新数据源。


 扫一扫


 1888

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


