





2026年9月来自美国Rice大学和Nvidia的论文“RoboTok: An Internet-scale Data Engine for Human Demonstration Retrieval and Dexterous Manipulation Learning”。
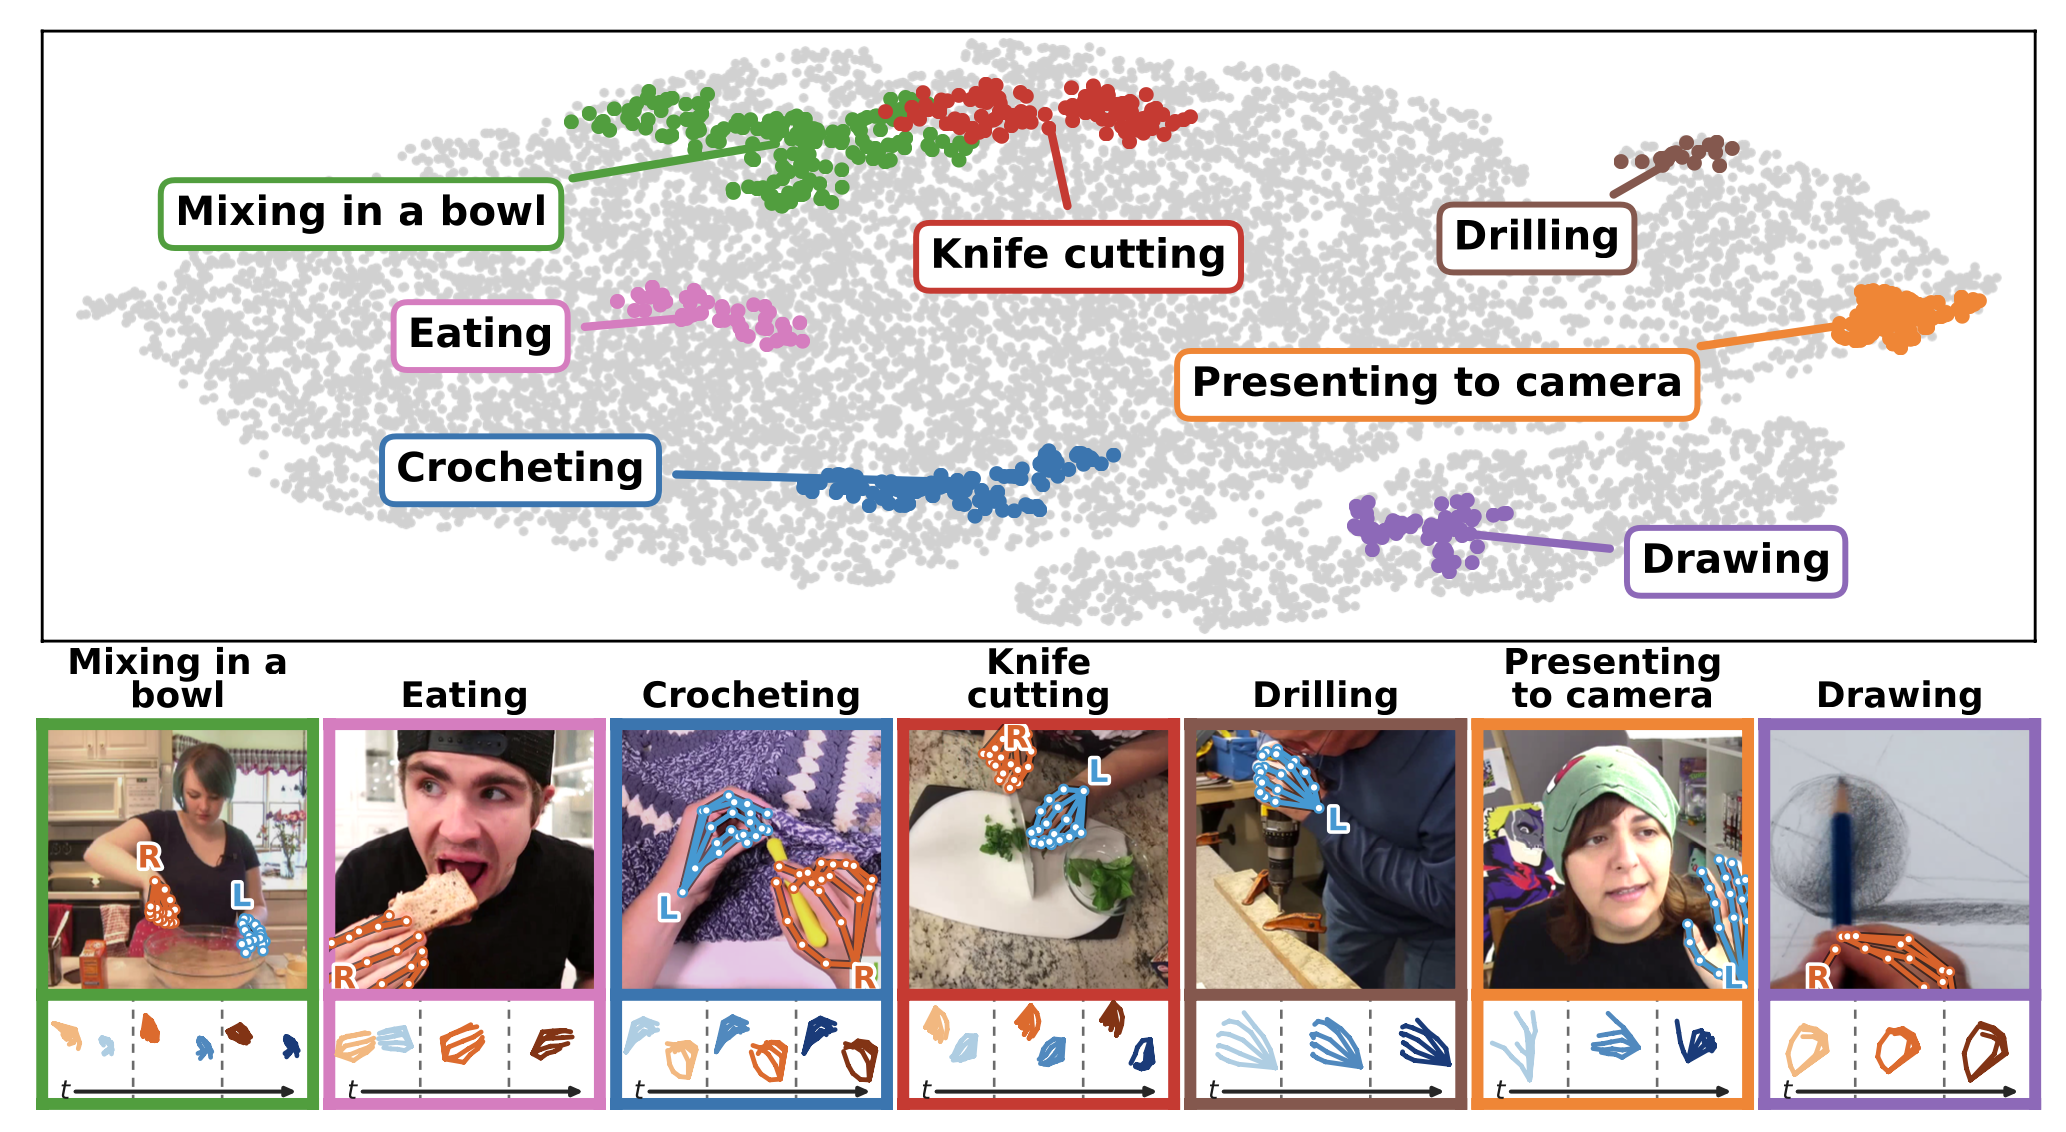
如图 1 所示:RoboTok 是一个互联网规模的数据引擎,它根据人类操作演示片段中的 3D 自我中心(egocentric)手部轨迹对这些片段进行索引。图中展示 RoboTok 嵌入(embeddings)的 t-SNE 可视化结果;这些嵌入是通过一种时空运动对齐度量学习得到的,旨在组织各种操作轨迹。在可视化时,展示的是 2D 相机坐标系下的手部姿态,而检索过程则基于底层的 3D 自我中心表征进行。这种潜运动空间支持高效检索演示数据,从而服务于下游灵巧操作策略的训练。尽管在数据筛选或检索过程中未使用语义标签,但学习的嵌入依然呈现出条理清晰的类别结构。
一、 核心观点与总结 (Summary & Core Claims)
核心观点:传统的机器人训练严重依赖昂贵、难以扩展的离线数据集或人工采集数据。虽然互联网上有海量的真实人类操作视频,但这些视频充满噪音、视角多变且缺少标记。论文认为,灵巧手操作的核心在于手部相对于人体或物体的运动轨迹。通过将视频转化为自我中心(Egocentric/Actor-centered)的3D手部轨迹,可以消除相机视角、外观和背景的干扰,从而实现跨视频的“运动行为检索”,并为机器人强化学习提供高效的姿态跟踪引导。
概要总结:论文提出了一个名为 RoboTok 的互联网级数据引擎。它能够从海量无标注的网络视频(如 Action100M)中,根据给定的演示视频查询,检索出在运动模式上高度相似的人类手部操作片段。检索到的视频可用于引导下手机器人(如灵巧手)通过强化学习(PPO)进行策略训练。
二、 主要创新点 (Innovations)
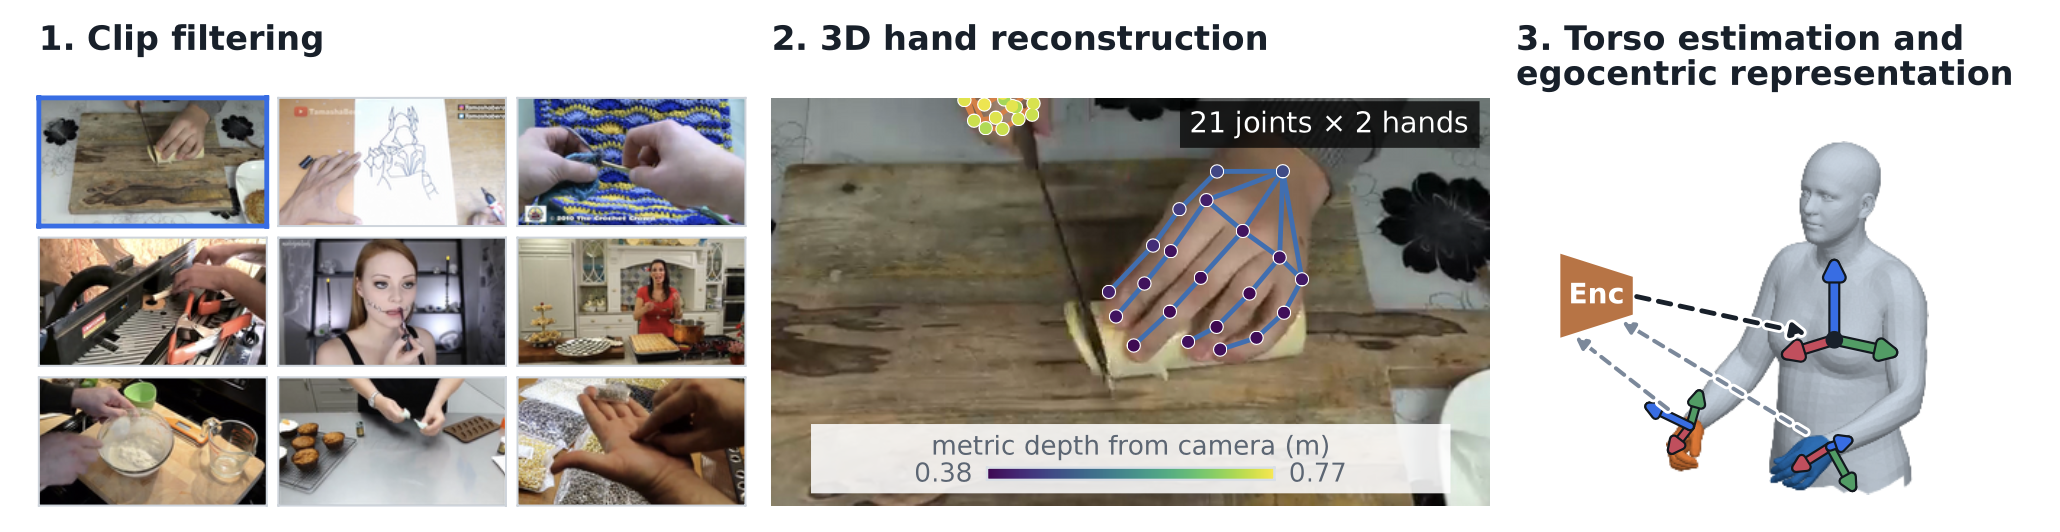
如图2所示:对互联网视频进行筛选,保留那些包含可见手部动作且摄像机相对静止的片段。从每个片段中提取手部运动轨迹,并将其重建为度量级三维轨迹。为了实现与视角无关的动作比较,将轨迹表示在以自我为中心的坐标系中。训练一个轻量级模型,仅根据观测的手腕坐标系即可直接估计静止的躯干坐标系,而无需人体全身可见。
1 躯干中心坐标系估计(Actor-centered 3D Canonicalization)
创新机制:针对网络视频中演示者身体常被遮挡的问题,RoboTok 训练了一个轻量化模型,仅凭手腕的 3D 轨迹就能直接推断 Demonstrator 的静态躯干坐标系(Torso Frame)。
作用:将相机坐标系下的手部姿态转换到以演示者躯干为参考的自我中心空间中,极大提升了对比操作行为时的视角不变性(View-invariant)。
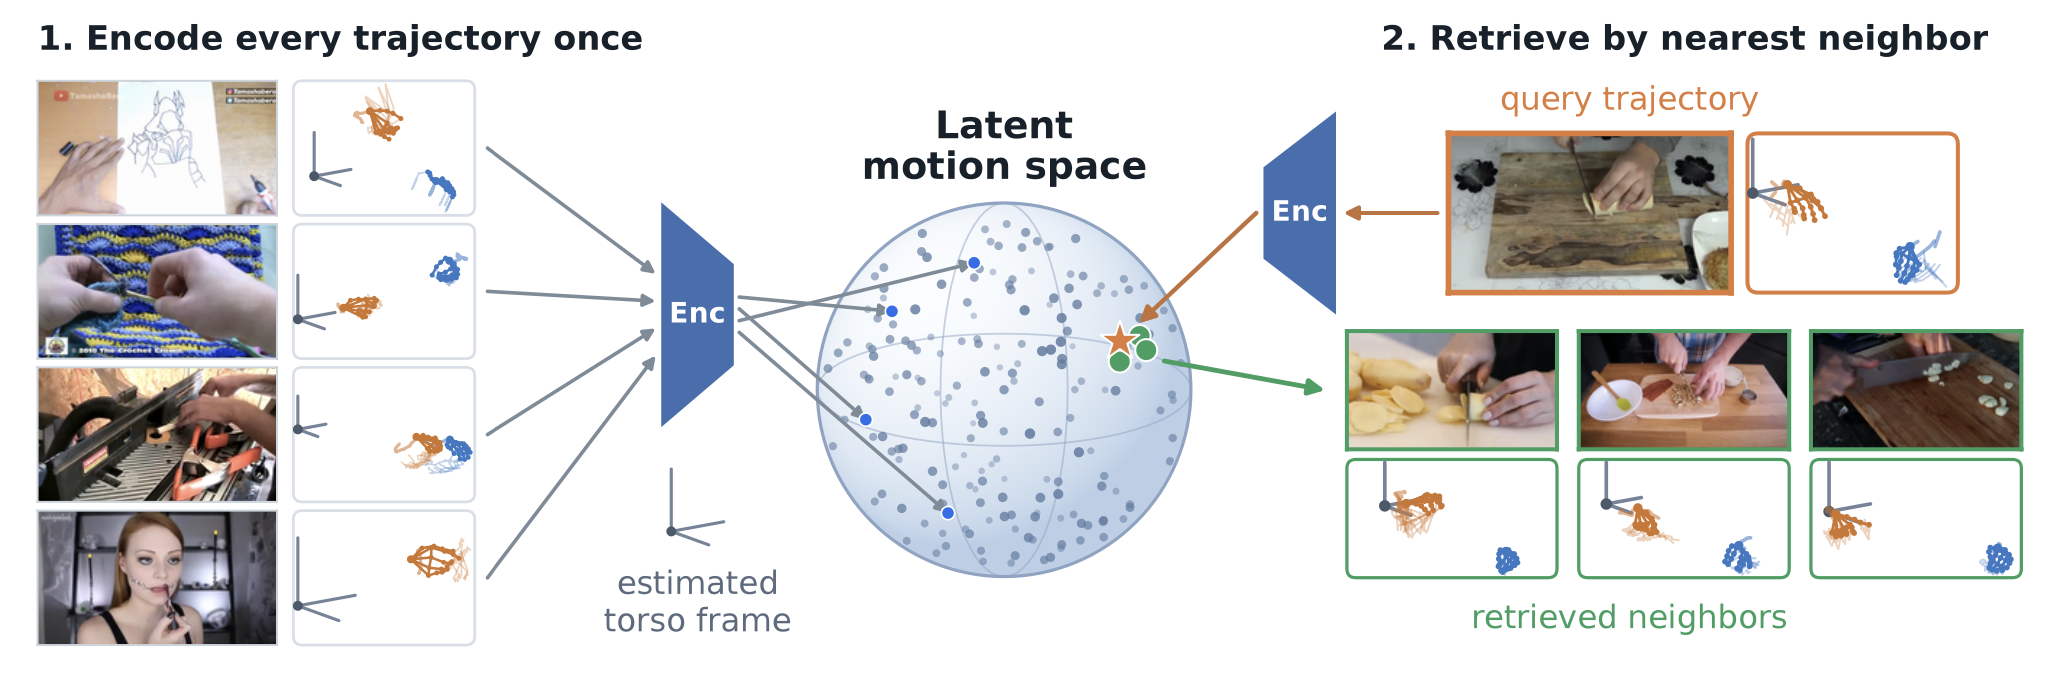
如图 3 所示每一条以自我为中心的轨迹都会被编码一次,映射到 RoboTok 学习的运动嵌入空间中。RoboTok 编码器是在结合集合(set)与排序(rank)目标的框架下,利用基于 DTW(动态时间规整)生成的正样本及难负样本进行训练。在查询阶段,输入片段会被编码至同一空间,并通过余弦相似度搜索高效检索出其最近邻。
2 DTW 驱动的动态时间规整代理与轻量化表征学习(DTW-Supervised Latent Embedding)
创新机制:在时序对齐上,利用动态时间规整(Dynamic Time Warping, DTW)计算轨迹间的运动相似度作为 Pseudo-GT(伪标签)。
轻量编码与检索:训练了一个轻量级的 Spatiotemporal Trajectory Encoder,结合 Set Loss 和 Rank Loss,将复杂时序轨迹映射到超球面向量空间。检索时只需做一次向量余弦相似度搜索,极大地提高了检索效率(支持百万级扩展)。
3 面向灵巧手强化学习的跨模态轨迹引导机制(Downstream Retargeting & Reward Shaping)
创新机制:不依赖任何机器人历史演示数据或文本标签。检索出的视频转换为手部轨迹后,直接通过基于潜力的奖励塑造(Potential-based Reward Shaping)和距离约束,引导 PPO 策略训练,在无重度 Reward Engineering 的情况下攻克了复杂灵巧手操作。
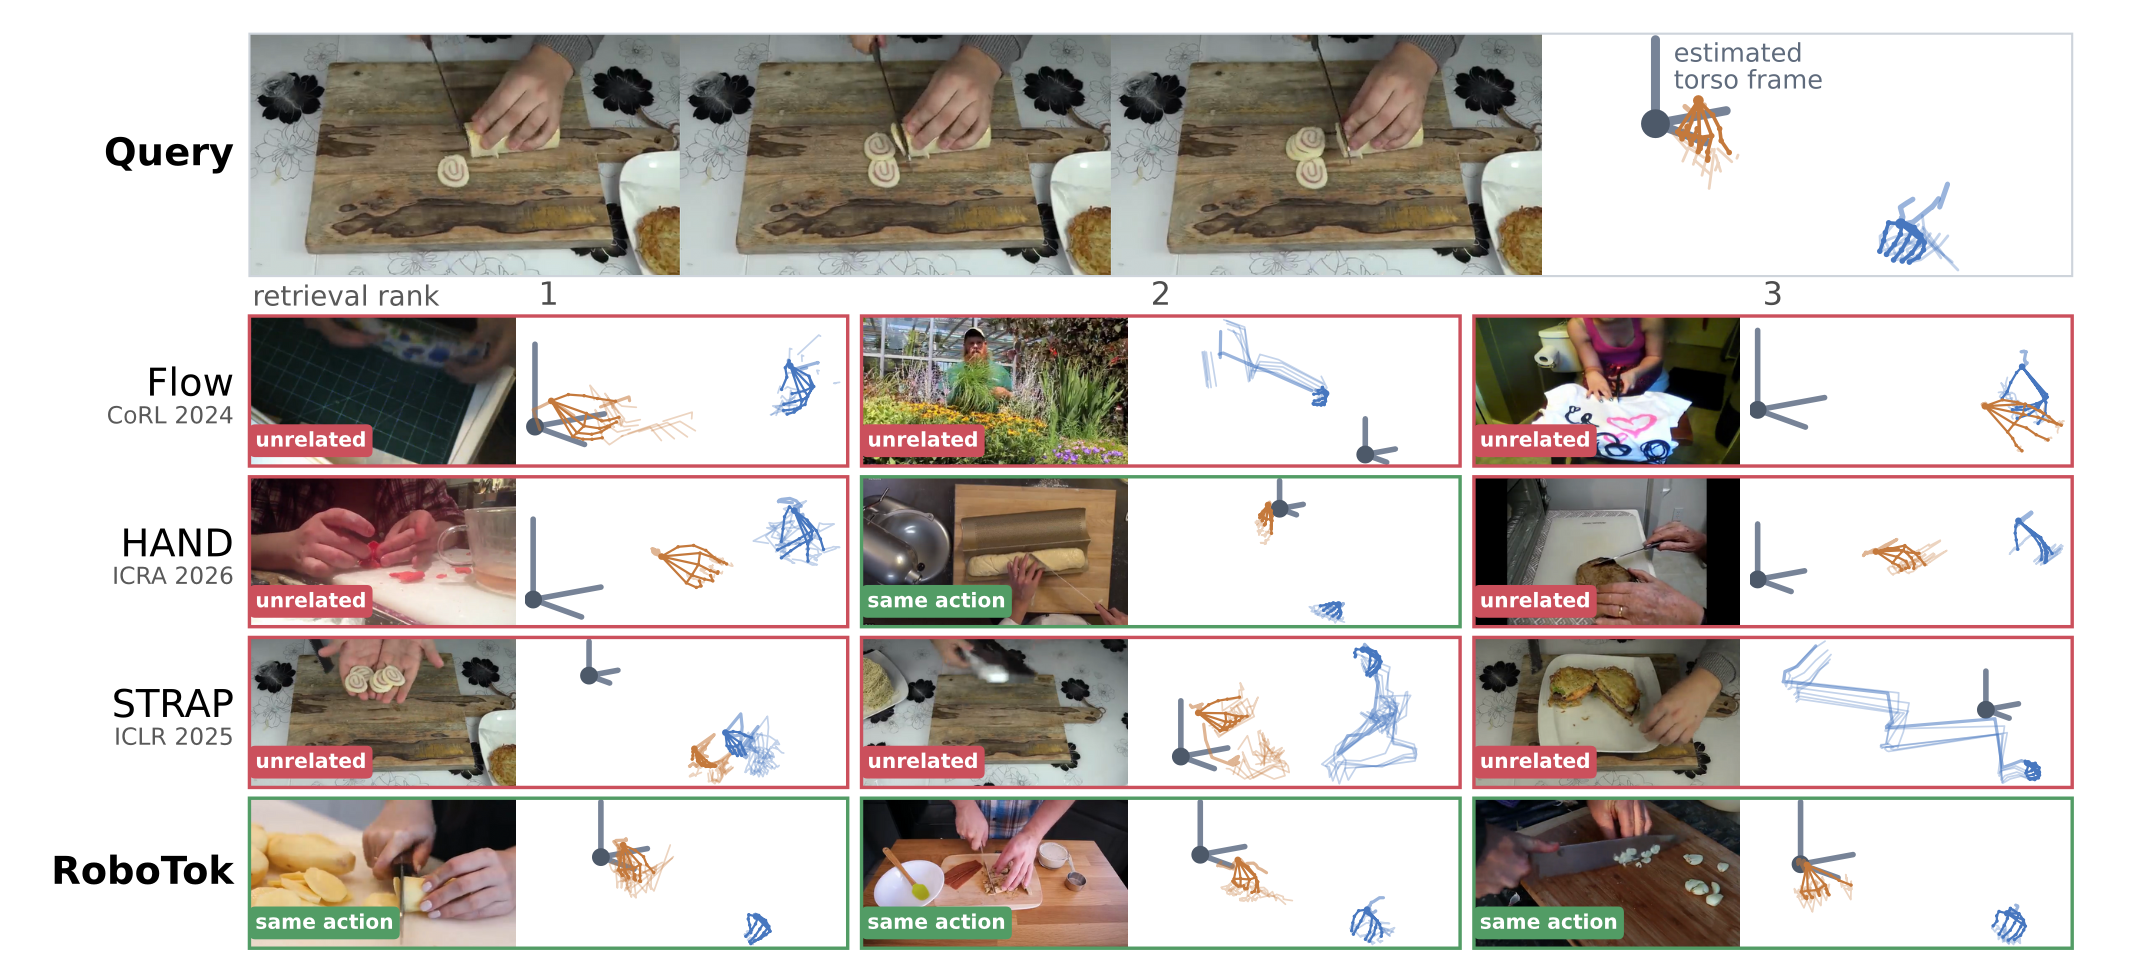
如图 4 所示针对一段切菜动作的查询演示视频,展示 RoboTok 与各基准方法分别检索的前 3 个视频。在每个检索的视频旁边,展示相应的手部轨迹以及估算的人体躯干框架。RoboTok 基于手部轨迹的自我中心表征进行检索,并根据操作行为检索出比基准方法更相关的演示视频。
三、 存在的局限与问题 (Limitations & Weaknesses)
1 依赖静态相机假设(Static Camera Assumption)
问题:在数据过滤阶段,RoboTok 过滤掉了视角移动剧烈的视频,仅保留“近乎静态相机(Near-static Camera)”的片段。但在实际互联网视频(如 GoPro 头戴视角、手机拍摄)中,相机经常发生大幅移动,这在一定程度上限制了可利用的数据规模。
2 物体交互与几何信息的缺失(Lack of Object-centric Information)
问题:RoboTok 目前的特征表征完全基于“手部关节轨迹”(21个关节点),未显式编码被操作物体的 3D 形状、物理属性或接触力(Contact Force)。如果两种操作的手部轨迹相似,但所交互物体的几何形状差异巨大,检索到的演示可能在物理上无法迁移给机器人。
3 复杂的预处理管线(Multi-Stage Pipeline Dependency)
问题:预处理链条过长,依赖多个开源视觉大模型的组合(WiLoR 手部姿态估计 + MoGe-2 深度估计 + HaWoR 缺失补全 + SMPL 躯干估计)。前级模型在野外视频(In-the-wild)中的估计误差或累计漂移会直接影响最终检索质量。
4 双手交互与极端遮挡下的鲁棒性瓶颈
问题:虽然文章评估了 AssemblyHands 等双手场景,但当手部发生严重自遮挡、与物体深度交叠或被工具挡住时,3D 关键点重建的质量会显著下降,进而导致躯干坐标系预测失败。
四、 综合评价
RoboTok 为利用互联网无标记视频进行机器人灵巧手学习开辟了一条极具前景的路径。它通过巧妙的“自我中心坐标变换”绕过了复杂的语义理解与外观干扰,直接抓住了“运动轨迹”这一本质特征。实验表明其在任务成功率上大幅超越现有的检索基线(如 STRAP、HAND、FlowRetrieval)。未来若能将相机运动补偿和物体几何感知进一步融入该框架,其通用性将得到进一步提升。


 扫一扫


 2644

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


