




26年8月来自京东探索研究院(Joy Future Academy)的论文“ZimaBlue: Evolving Generalizable World Action Models through Scalable Video Pre-training”。
一、核心方法
ZimaBlue 是面向机器人操纵的世界动作模型 WAM整套训练与部署框架,利用大规模无标注第一人称视频解决机器人泛化不足,整体分为三阶段课程式训练 + Slow‑Fast 异步双系统推理架构 + 统一跨本体状态‑动作表征,配合多项加速技术实现实时闭环控制。
- 统一 100 维状态‑动作表征
将不同机器人(单臂、双臂、灵巧手、移动基座、躯干)原生控制接口映射为100 维语义槽位空间,包含末端位姿、夹爪、关节、躯干、移动基座、灵巧手关节;
使用相对位姿编码,动作相对于每个动作块起始时刻本体姿态做变换,消除不同机器人绝对坐标差异;
配套有效性掩码 mask,对当前机器人不存在的维度做屏蔽,不参与损失计算,实现跨机器人本体数据混合训练。
- 三阶段训练流水线(数据金字塔)
如图 3所示数据金字塔。三阶段训练过程从广泛的视觉多样性逐步过渡到针对特定部署形态的具身化。第一阶段(预训练)在无动作监督的情况下,从多样化的视频源中学习通用的视觉动态;第二阶段(中期训练)引入来自多种形态的机器人动作,将视觉动态与跨形态控制相结合;第三阶段(后训练)针对目标形态对模型进行专门化训练,并进行部署基准测试。
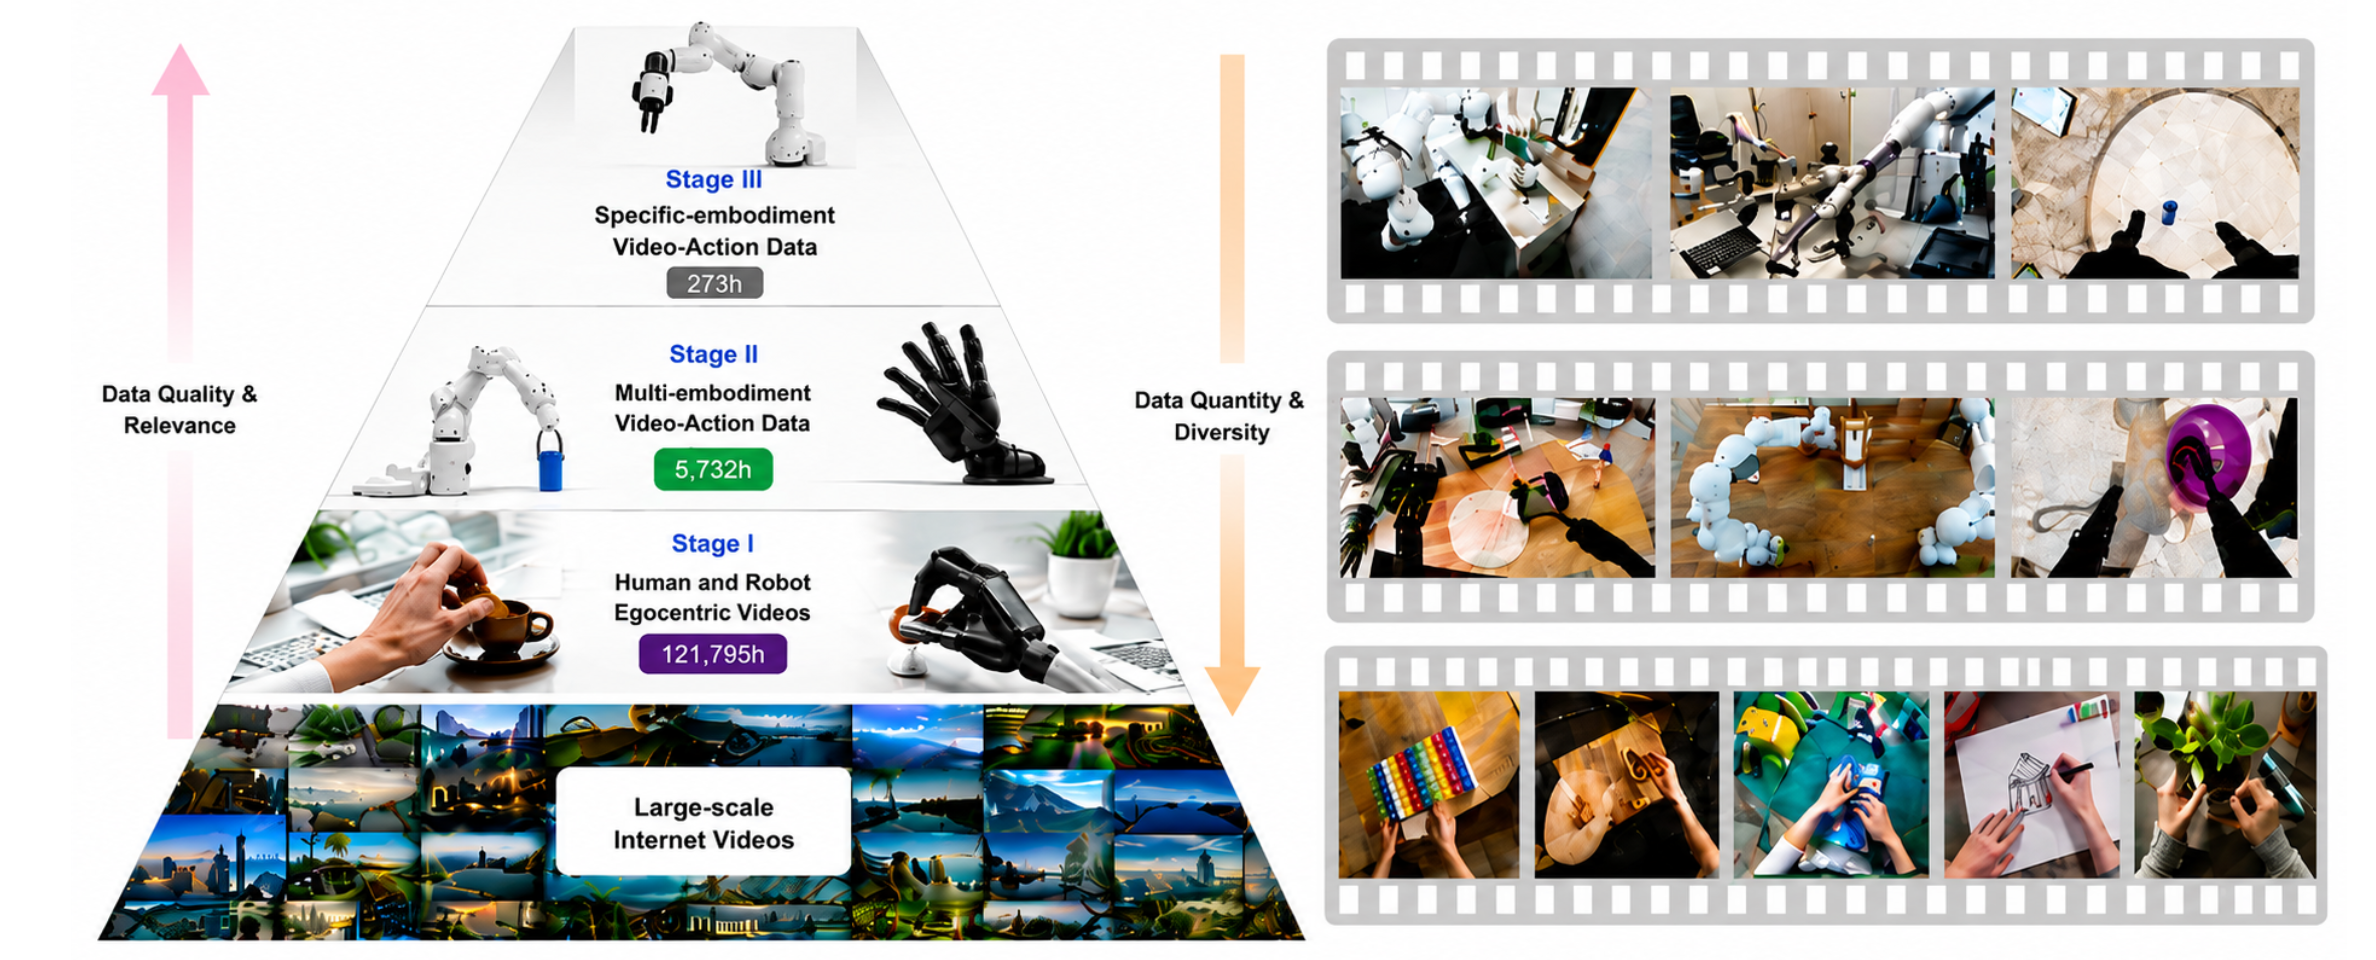
阶段 I:视频预训练(Video Pre‑training) 输入大规模无动作标签的人类第一人称视频、仿真、机器人视频(最大 120 000 小时),仅做因果视频动力学预测,学习物体交互、接触、物理先验,不使用动作监督;使用流匹配 loss 优化视频潜变量,建立时序因果先验。
阶段 II:跨本体视频‑动作中间训练(Video‑Action Mid‑training) 引入多类真实机器人轨迹数据,在统一 100 维动作空间下,同时预测未来视频潜变量与动作块;视频、动作噪声对齐,让视觉动力学表征和机器人控制对齐;Fast 分支此时不参与训练。
阶段 III:目标机器人后训练(Post‑training)
第一步:将 Slow 主干适配部署目标机器人;
第二步:冻结 Slow 分支,训练轻量化 Fast 分支;引入 RTC 实时块技术,模拟异步闭环,让 Fast 可以基于最新观测,复用 Slow 的时序 KV 缓存预测动作。
全部阶段底层目标:流匹配(Flow‑Matching)损失,视频损失与动作损失加权组合。
- Slow‑Fast 快慢双系统异步架构(推理部署核心)
如图 2 所示“慢-快”双系统架构。其中的“慢 DiT”处理观测信息、机器人状态、语言指令以及带噪的视频和动作 Token,旨在联合预测未来的视频潜在表征及其对应的动作(该过程仅作为视频-动作对齐的辅助监督信号)。与此同时,“快 DiT”接收更新后的观测与状态信息,并利用“慢 DiT”的视频 K/V 缓存作为条件,生成用于高频闭环控制的细粒度最终动作。
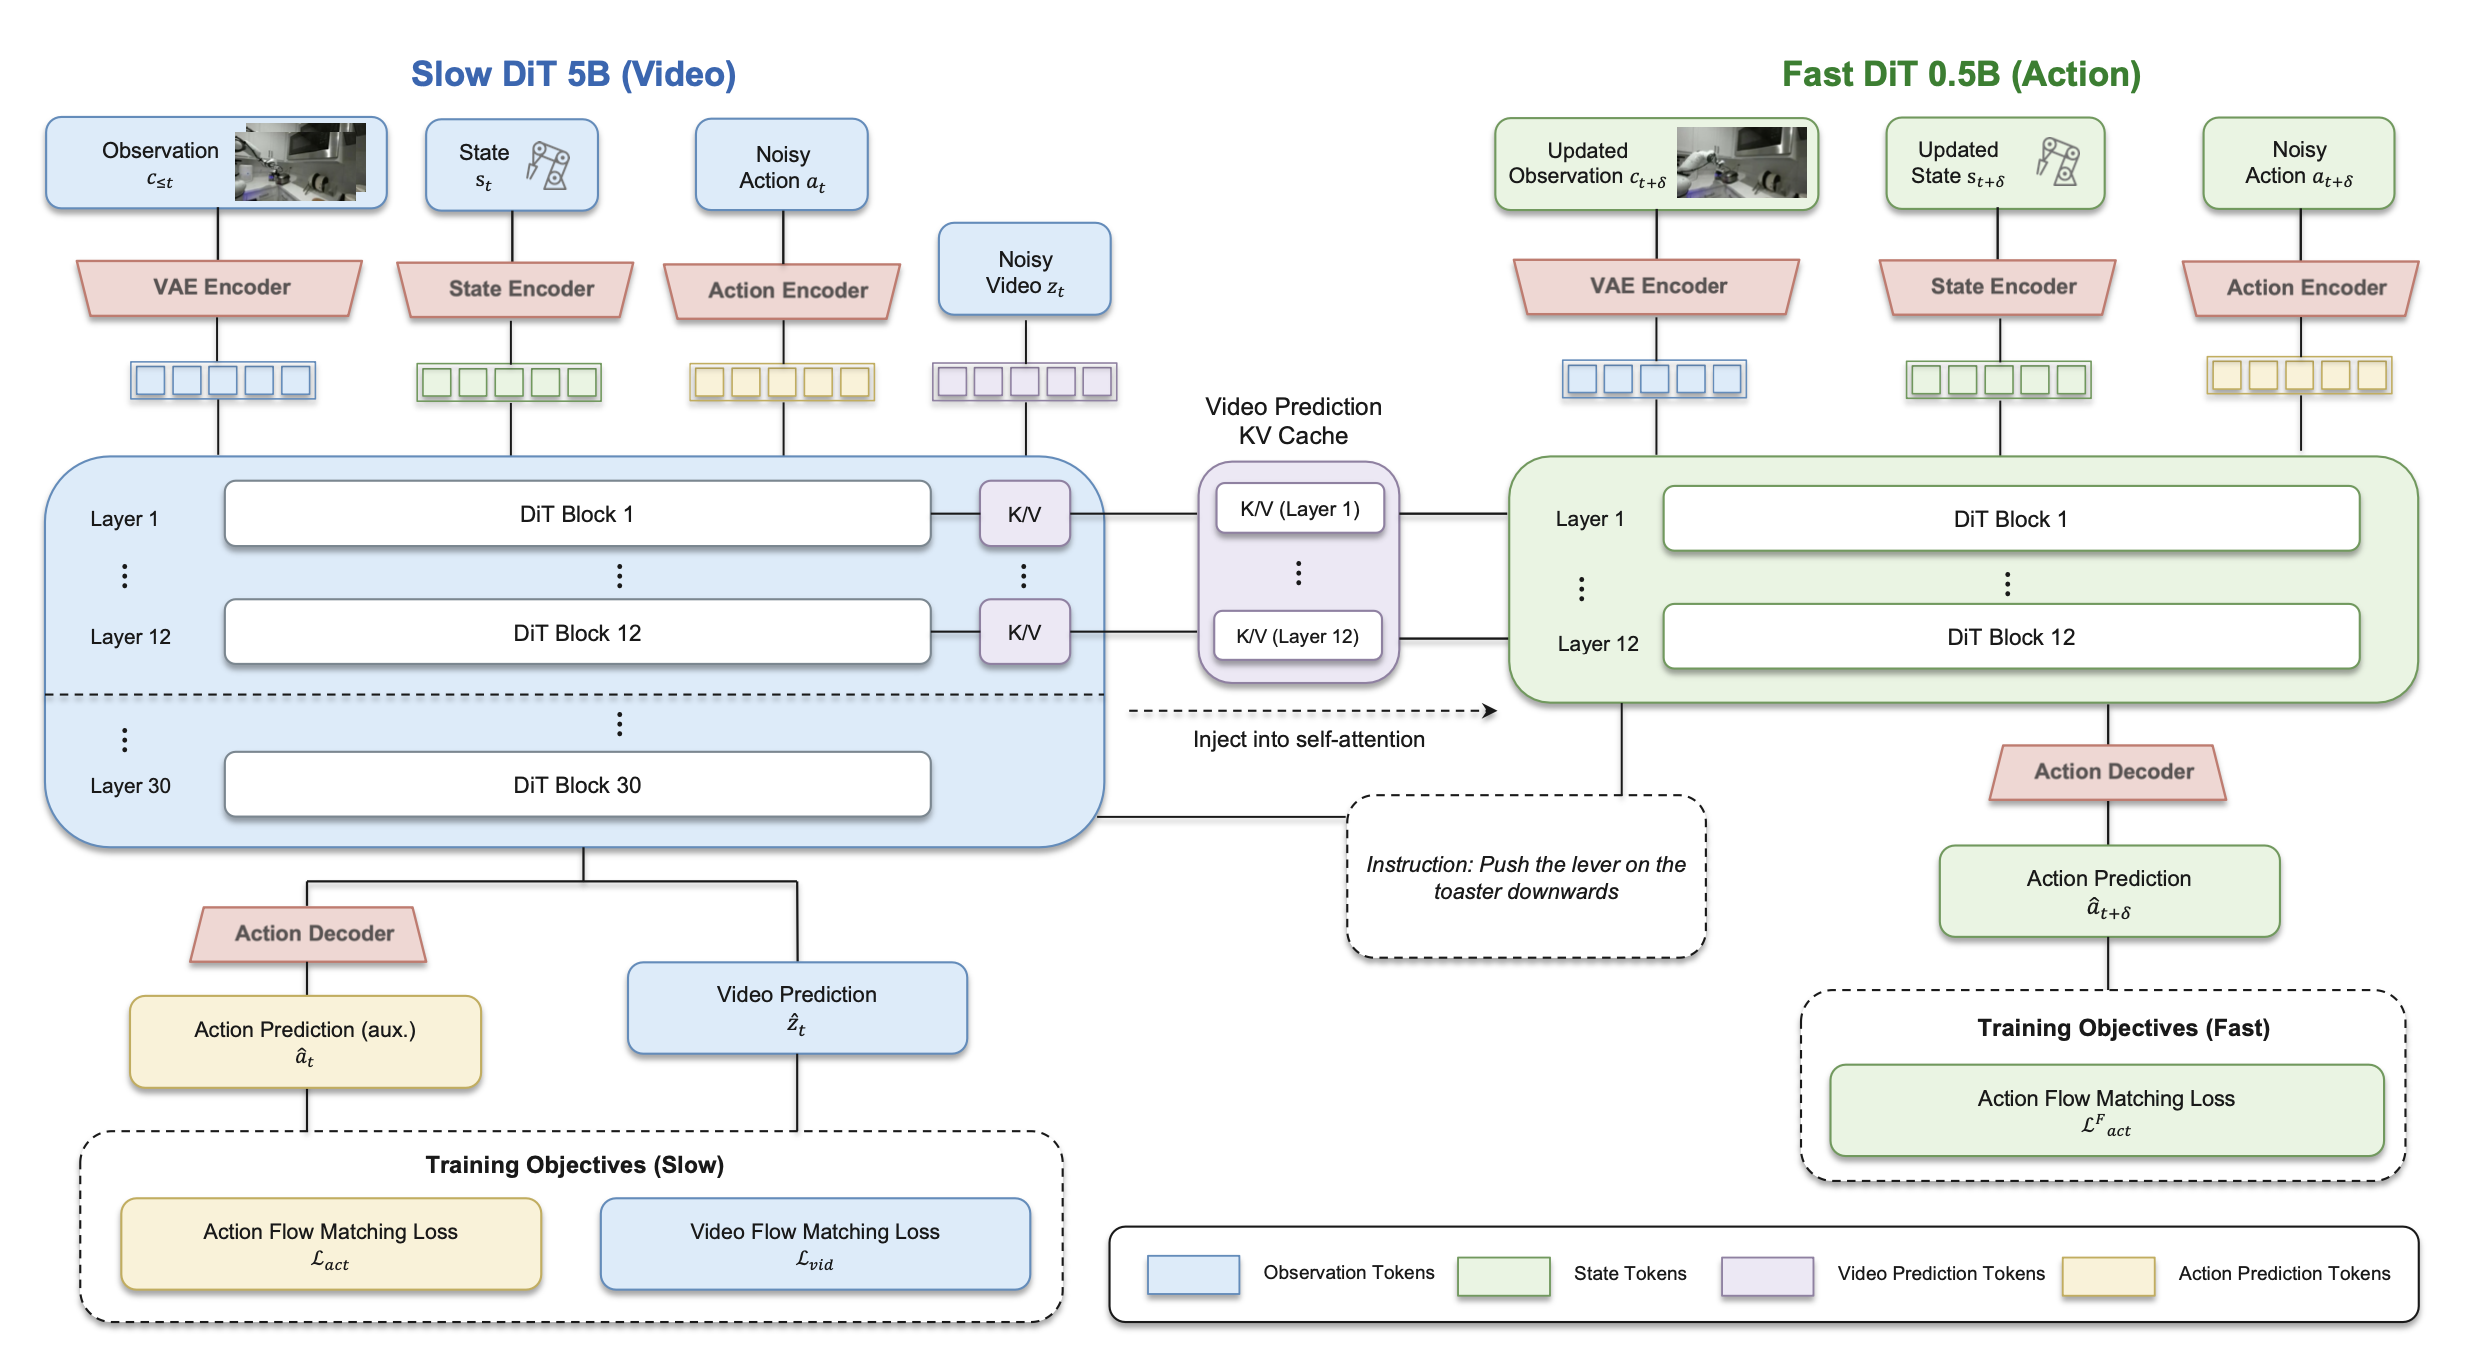
Slow 分支(5B DiT):大容量世界模型,低频运行,输出视频预测的多层 KV 缓存,学习时空与物理动力学;推理时不直接输出执行动作,输出表征给 Fast。
Fast 分支(0.5B DiT):轻量动作生成器,高频运行;不做完整视频生成,交叉注意力读取 Slow 输出的只读视频 KV 缓存,结合最新实时观测、本体状态,输出机器人执行动作。
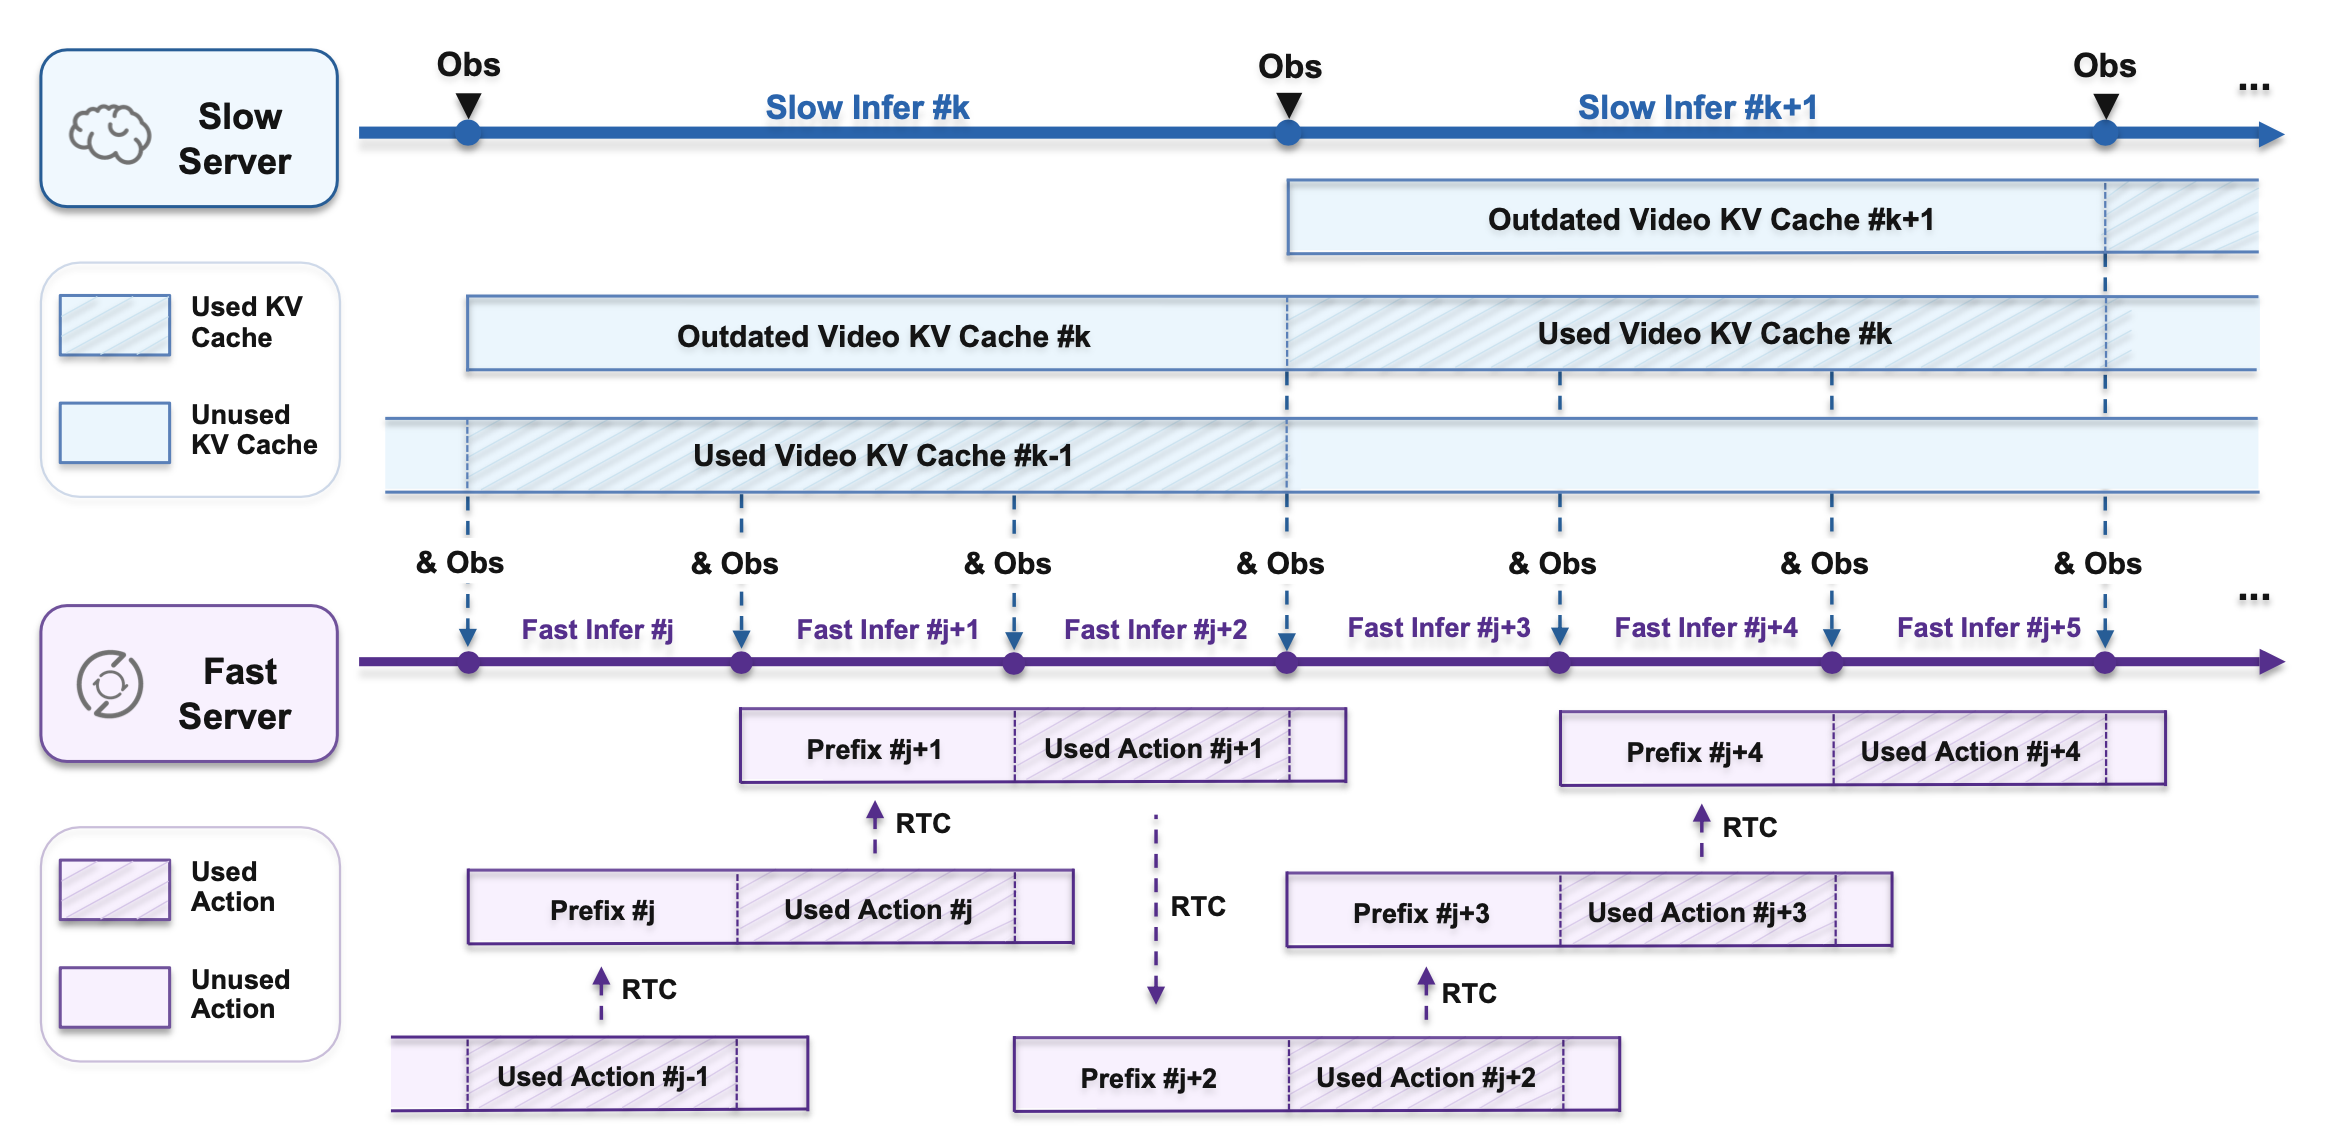
异步机制:Slow 更新频率低,Fast 持续高频生成动作,无需等待 Slow 每轮推理完成;RTC 技术保证相邻动作块之间执行连续性。
- 加速方案
如图 4 所示“慢-快”双系统中的异步推理。“慢”流以较低频率运行,生成未来的视频 K/V 缓存;“快”流以较高频率运行,利用更新后的观测、状态以及来自“慢”流的 K/V 引导信息来生成动作片段。生成的动作被持续执行,并为后续更新提供新的观测数据。图中标记为“过时(Outdated)”的是基于过去观测生成的视频 K/V 缓存,在当前时间步已失效;标记为“前缀(prefix)”的则是来自上一片段、已确定执行并为保持连贯性而保留的动作。(注:该图仅为示意图)
异步 Slow‑Fast 推理;
DMD 分布匹配蒸馏:Slow、Fast 分别从 8 步降噪压缩到 2 步 DiT 评估;
CUDA Graph 编译优化;
RTX4090 上端到端延迟从 449.6 ms 降到33 ms,达到 30 Hz 闭环控制,整体加速比 13.6×,仅小幅损失性能(成功率下降 2.8%)。
二、模型架构要点
主干基于 Wan2.2‑TI2V‑5B 视频 Diffusion Transformer 改造,专门面向具身因果预测,而非通用视频生成。
Slow‑Fast:Slow(5B)负责世界建模;Fast(0.5B)从 Slow 前 12 层初始化权重,只负责动作输出;Fast 不复制完整世界模型,复用 Slow 的 KV 缓存,大幅降低计算开销。
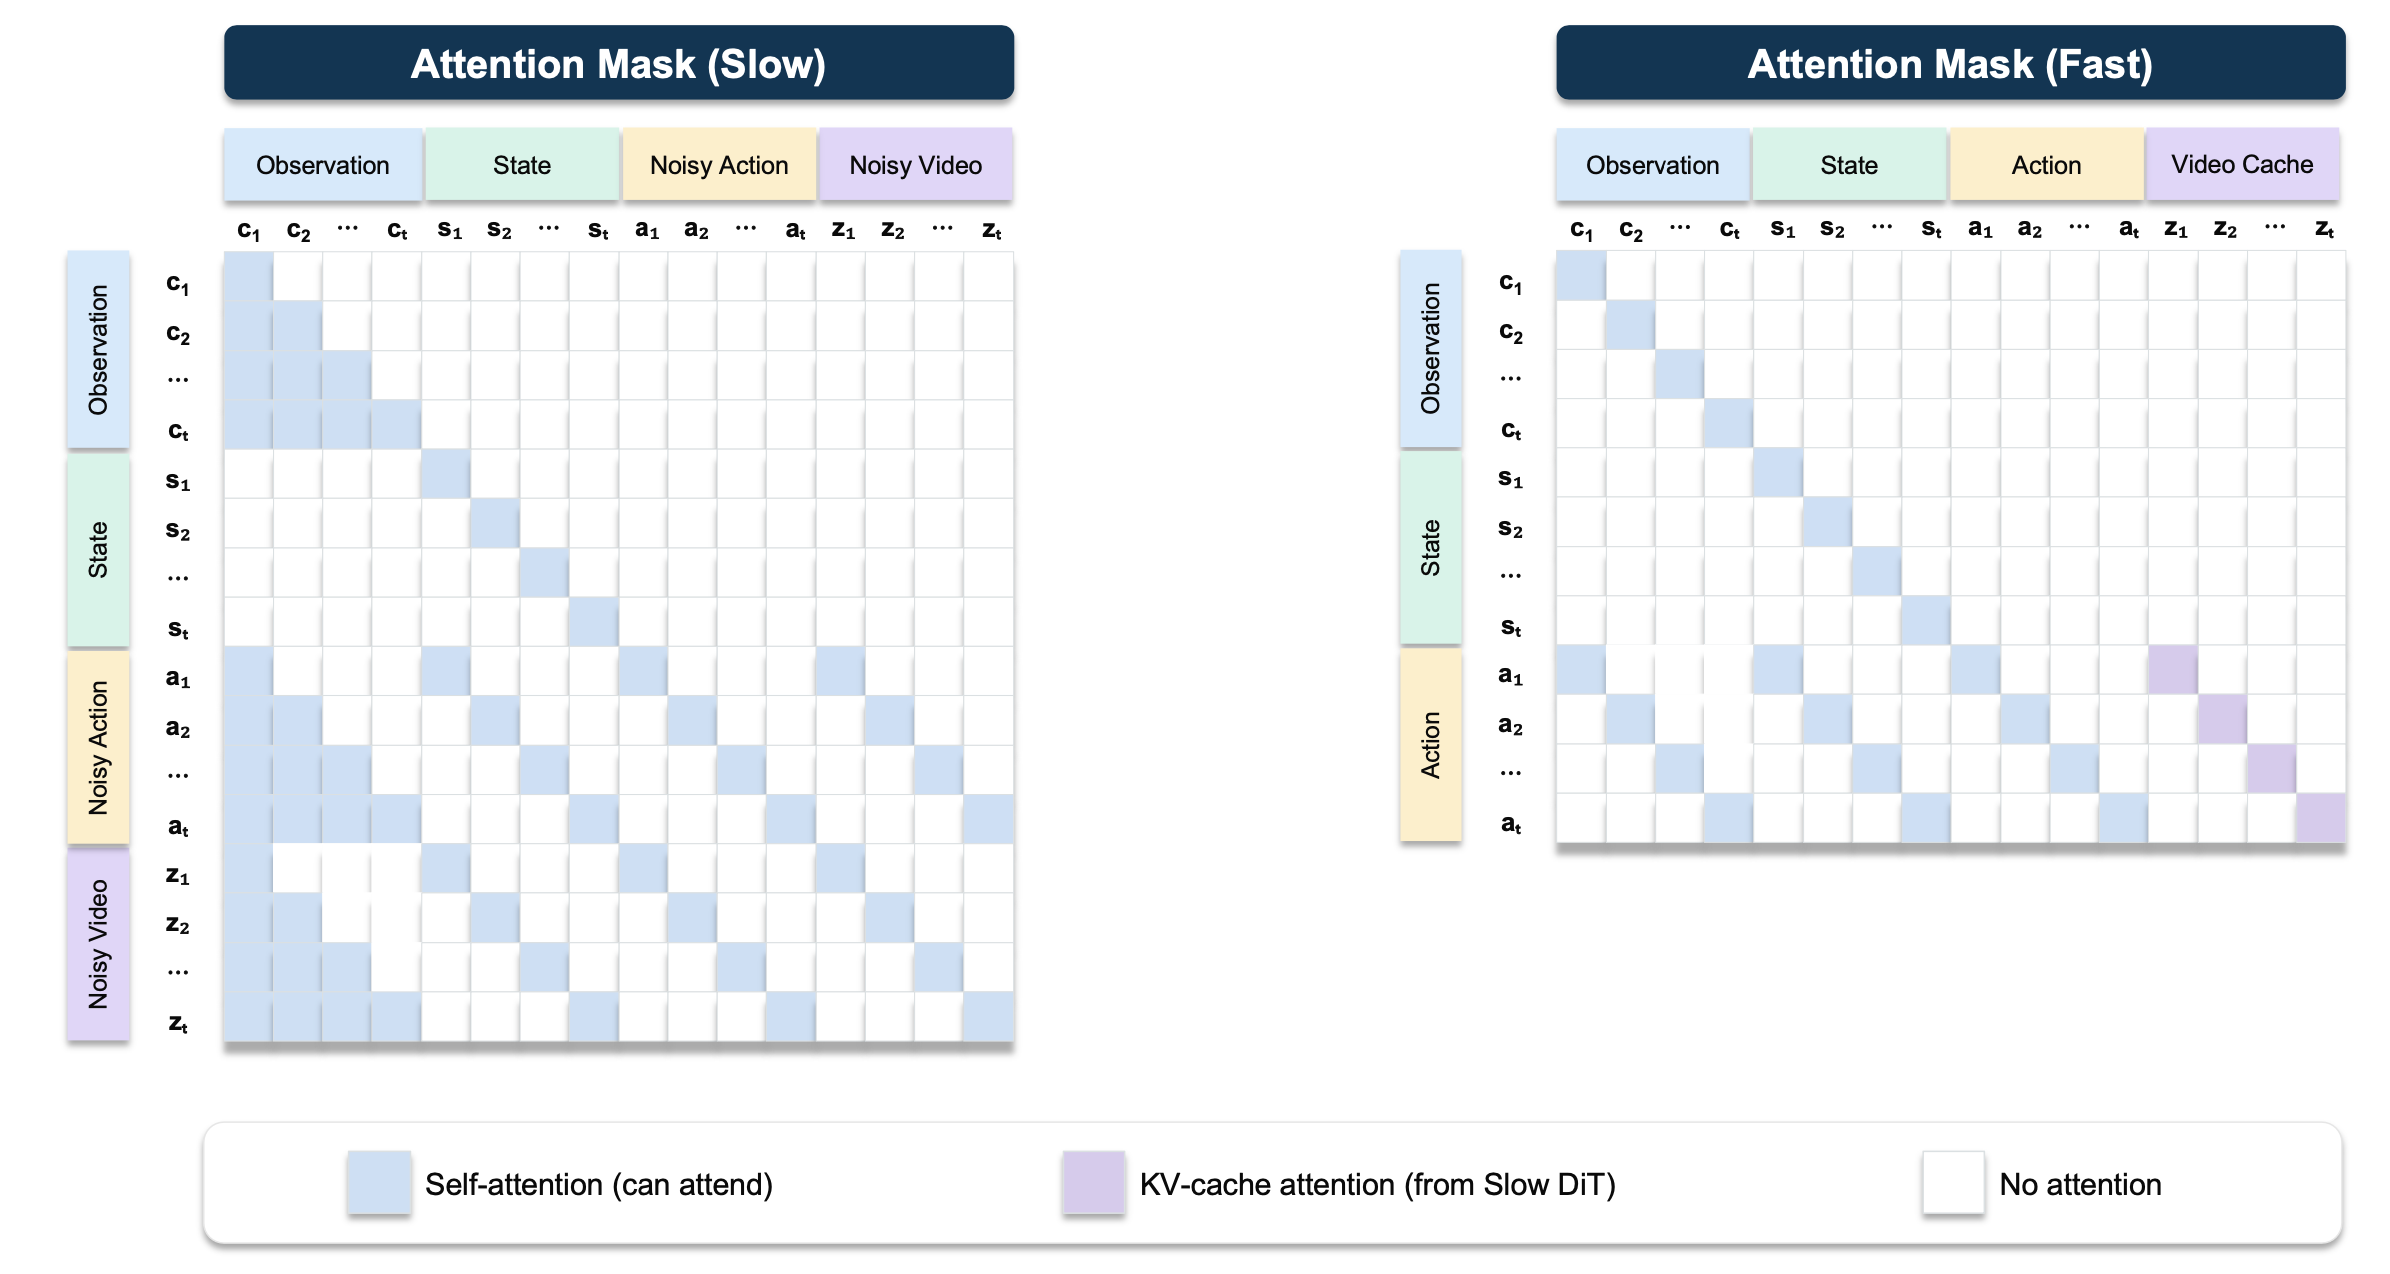
注意力机制:Slow 使用块因果注意力 mask,支持并行多块训练同时保持时序因果;Fast 的 Action Query 交叉注意力读取 Slow 只读 KV Cache,避免梯度回传 Slow。
输入支持多视图统一画布,缺失摄像头做 padding + 视图掩码,兼容单视角人类视频与多视角机器人数据。
输出:24 步长度动作块,相对姿态编码,部署阶段逆变换回机器人原生控制指令。
如图 10 所示Slow DiT 和 Fast DiT 的注意掩码。蓝色单元格表示在同一分支内生成的 K/V 块,紫色单元格表示从 Slow DiT 引入的视频 K/V 特征,白色单元格表示被屏蔽的依赖关系。行对应 Query(查询),列对应 Key(键)和 Value(值)。在 Slow 掩码中,c_i、z_i、s_i 和 a_i 分别表示步骤 i 的清晰视频上下文、加噪的未来视频潜表示(latent)、本体感觉状态以及加噪的动作片段。在 Fast 掩码中,c_i、s_i 和 a_i 分别表示步骤 i 的更新观测、状态以及基于前缀条件的动作片段,而 K_slow 则是只读的 Slow 视频 K/V 缓存。语言条件 l 通过交叉注意机制(cross-attention)引入,为保持图示清晰,未在自注意(self-attention)示意图中画出。
三、主要贡献
验证大规模具身视频预训练对 WAM 的缩放效应:仅目标机器人数据零‑shot 成功率 36.1%;叠加 12 万小时第一人称视频后提升至77.8%,尤其对未见任务、环境扰动场景增益巨大;证明无标签人类视频是机器人泛化重要数据源。
提出完整三阶段训练范式:视频预训练→跨本体视频‑动作中间训练→目标本体后训练,搭配 100 维统一状态‑动作表征,实现异构机器人数据联合学习。
提出 Slow‑Fast 异步 WAM 架构,解决传统生成式世界模型推理速度慢、无法高频闭环控制痛点,实现 30Hz 真实机器人控制,兼顾世界模型泛化能力与实时执行性能。
在 LIBERO‑Plus、RoboTwin2.0、RoboCasa365、真实机器人零‑shot 操纵取得 SOTA;在 RoboCasa365 复合未见任务上,相比之前 WAM 基线,成功率从 7.9% 提升至 16.5%,大幅提升长时序未见任务泛化能力。
开源项目、代码仓库,为 WAM 类机器人学习提供工程基线。
四、现存问题 / 局限性
相机视角泛化瓶颈:零‑shot 下相机视角变化鲁棒性偏弱,需要 SFT 微调才能大幅提升。
扰动场景(光照闪烁、未知背景、杂物干扰)性能仍明显低于标准场景:完整模型扰动集只有 57.5% 成功率;故障模式包括物体偏移、接触打滑、桌布拖拽、抓取失败后无法有效恢复。
长时序复合未见任务绝对性能依然不高(RoboCasa365 Composite‑Unseen 仅 16.5%),复杂多步骤任务仍然容易发生子任务失败、过早跳转到下一子步骤。
依赖高质量大规模视频预训练数据;视频数据质量、非物理网络视频会损害模型效果,需要人工筛选具身操纵视频子集。
蒸馏会带来少量性能损失;虽然做到 33ms 延迟,但模型整体参数量仍然较大,硬件依赖高(RTX4090),难以部署在嵌入式端。
没有集成高层规划推理模块,完全依靠模型内部时序建模,面对超长期开放任务能力有限。
五、未来工作(下一步)
评测拓展:构建更多样、跨机器人本体的基准测试集,充分测试模型真实泛化边界。
数据 & 模型规模继续放大:扩充更多样的第一人称人类视频,同时增大模型参数量,进一步学习物理先验。
增强高层推理能力:接入层级规划、自我纠错模块,解决复杂长时序任务,提升失败恢复。
上下文学习能力:支持推理阶段输入少量物理演示作为 prompt,实现新技能快速习得,不需要梯度更新微调。
进一步降低硬件门槛,面向端侧设备优化 WAM 推理。
改善视角泛化、接触‑交互故障恢复,提升扰动环境下操纵鲁棒性。


 扫一扫


 398

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


