RAGの回答精度が上がらない原因は?検索・データ・生成を見直す改善手順【2026年8月最新】

社内規程やマニュアルを登録し、RAGを動かしてみた。それなのに、答えが的外れになる。古い文書を参照する。質問によって回答が変わる。モデルを新しくしても、あまり改善しない。
この状態でプロンプトだけを直し続けても、原因が検索側にあれば精度は上がりません。RAGの回答は、元データ、文書の分割、検索、並び替え、回答生成という複数の工程を通って作られるからです。
この記事では、すでにRAGや社内AIを作った企業に向けて、精度が出ない原因を工程別に切り分け、改善前後を同じ条件で比較する方法を解説します。
この記事の要点
✅ RAGの精度改善は、モデル交換より先に「正しい情報を検索できたか」を確認します
✅ 元データ、分割、検索、生成、権限、評価のどこで失敗したかを分けると、直す場所が見えます
✅ 実際の質問からテストセットを作り、1回の印象ではなく同じ条件で改善前後を比較します
RAGの精度が上がらないのは、AIモデルだけの問題ではない
RAGは、質問に関係する資料を探し、その内容を生成AIへ渡して回答を作る仕組みです。基本的な流れは次のようになります。
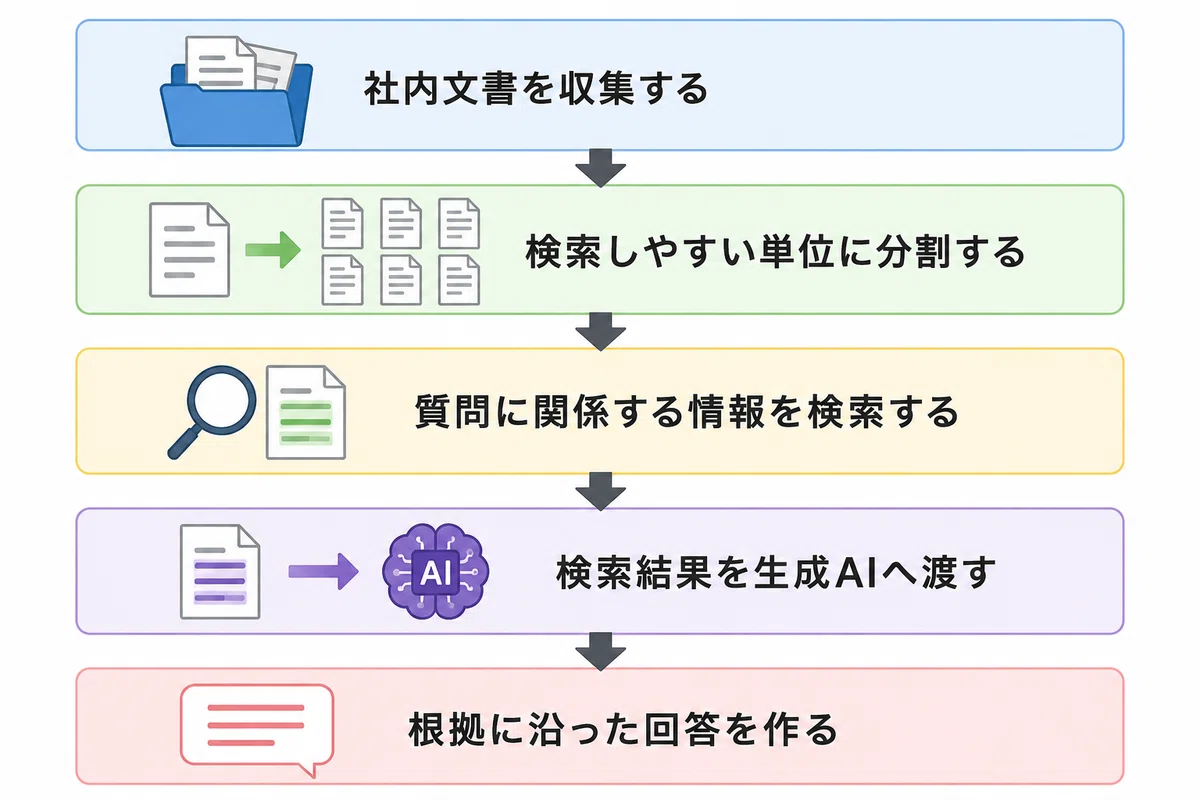
AWSのRAGに関する公式ガイドでも、文書の取り込み、検索、コンテキストの追加、回答生成を別の工程として説明しています。つまり、最終回答だけを見ても、どの工程で問題が起きたかは分かりません。
たとえば「出張の宿泊費上限はいくらですか」と質問し、誤った回答が返ったとします。原因は少なくとも次のように分かれます。
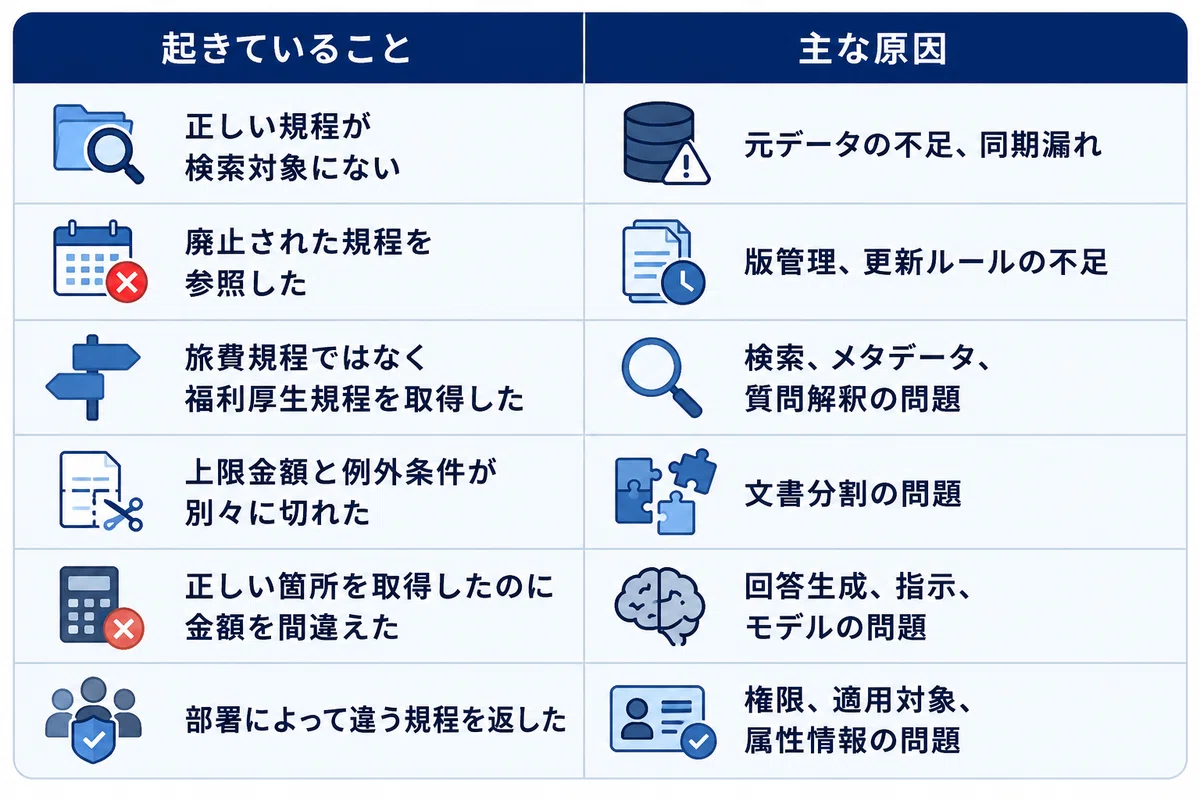
最初にやるべきことは、モデルを替えることではなく、正しい根拠が生成AIへ渡ったかを確認することです。
RAGの基本から確認したい場合は、先に「RAGとは?中学生にもわかるように解説」をご覧ください。本記事は、RAGを構築した後の改善に絞っています。
まず「回答精度」を4つに分ける
「精度が低い」という言葉だけでは、チーム内で同じ問題を見ているとは限りません。検索結果が悪いのか、回答が根拠から外れているのか、必要な情報が足りないのかを分けます。
MicrosoftのRAG評価ガイドでは、RAGの回答を評価する主な観点として、Groundedness、Completeness、Utilization、Relevance、Correctnessを挙げています。企業で最初に使うなら、次の4項目に整理すると運用しやすくなります。
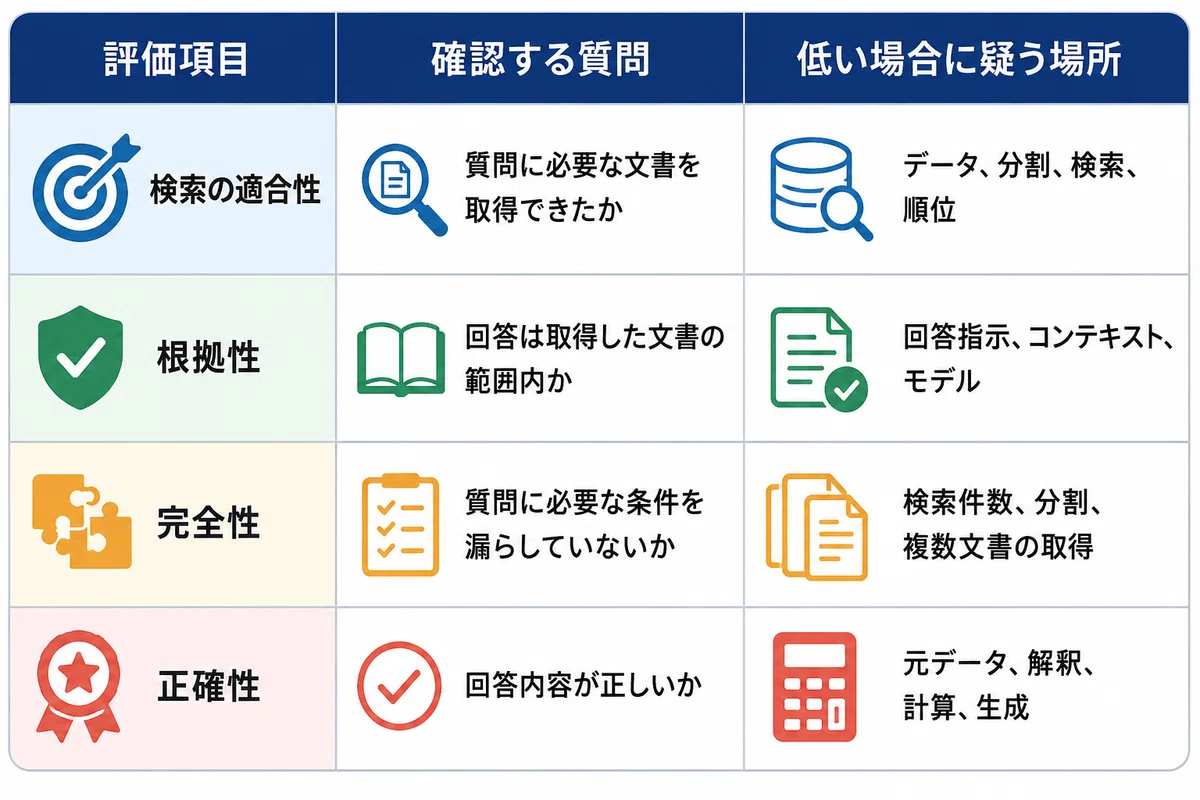
この4項目は似ていますが、同じではありません。
正しい資料を取得しても、回答が資料にない説明を加えれば根拠性が下がります。資料に沿って回答していても、元の規程が古ければ正確ではありません。回答した内容が正しくても、例外条件を落としていれば完全性が不足しています。
「正しい答えだったか」だけでなく、「正しい資料を取れたか」と「資料を正しく使えたか」を別々に記録してください。
RAGの精度が出ない7つの原因
原因1|検索対象のデータが不足している
必要な文書が登録されていなければ、検索方法を変えても正解には届きません。よくあるのは、共有フォルダの一部だけを取り込んだ、PDFは入っているが社内Wikiは対象外、添付資料を取得していない、といった状態です。
最初に、質問に答えるための正本が本当に検索対象に入っているかを確認します。
正式な文書はどれか
保存場所はどこか
RAGへ同期されているか
添付ファイルや表も取り込めているか
文書を更新した後、索引も更新されたか
ここで重要なのは、登録したファイル数ではありません。利用者が実際に聞く質問に答えられる文書がそろっているかです。
原因2|古い文書と新しい文書が混在している
同じ規程の旧版と新版が並んでいると、検索結果の意味は近いため、古い文書が上位に出ることがあります。ファイル名の末尾に「最新版」と付けるだけでは、検索時の優先順位を確実に制御できません。
文書ごとに次の情報を持たせます。
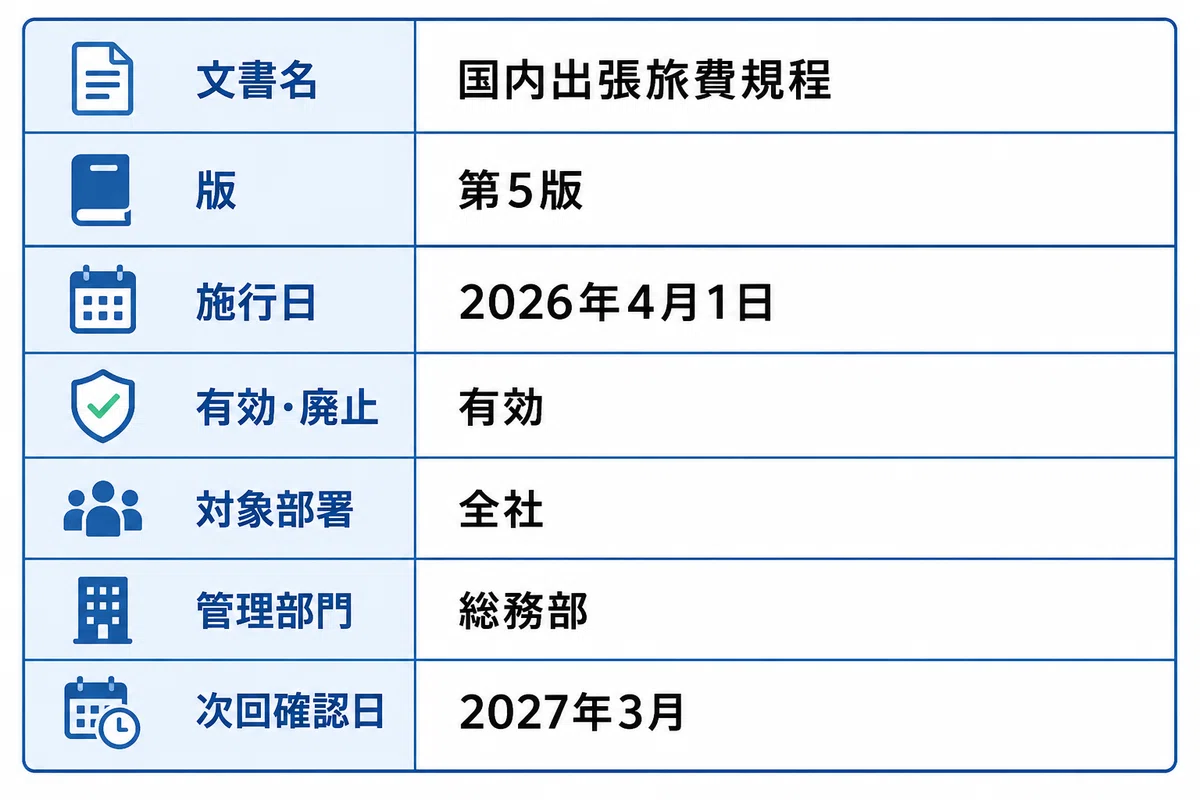
廃止文書は検索対象から外すのが基本です。 監査上残す必要がある場合は、通常検索と履歴検索を分けます。
原因3|文書の分割で意味が切れている
RAGでは、長い文書を小さな単位に分けて検索します。この分割をチャンクと呼びます。
小さく分けすぎると、金額と適用条件、本文と注記、質問と回答が別々になります。大きすぎると関係のない情報が多く入り、必要な箇所が埋もれます。
AWSの文書作成ガイドは、見出しと小見出しを適切に使い、文書構造を明確にすることを推奨しています。文字数だけで一律に切る前に、文書の意味構造を利用してください。
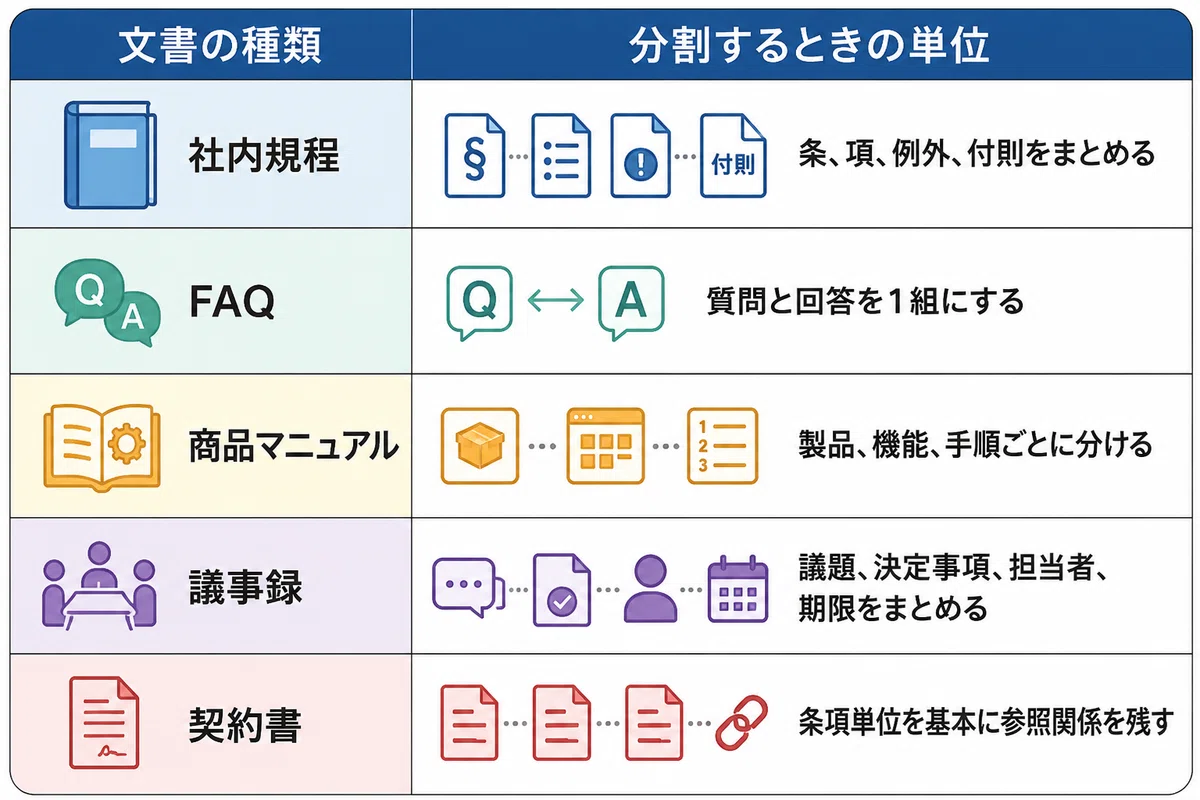
PDFの見た目では隣にある表や注記が、抽出後のテキストでは離れていることもあります。分割前の抽出結果を人が確認する工程が必要です。
原因4|検索方式が質問に合っていない
意味の近さを使うベクトル検索は、言い換えに強い一方、製品番号、条文番号、略称、固有名詞、正確なコードの検索では弱くなることがあります。キーワード検索は固有語に強いものの、表現が違う質問を取りこぼします。
そのため、企業内検索では次の方法を比較します。
ベクトル検索
キーワード検索
両方を組み合わせるハイブリッド検索
検索結果を再評価するリランキング
部署、文書種別、施行日などによるメタデータ絞り込み
検索方式は製品の推奨設定だけで決めず、実際の質問で比較します。 「規程12条」のような質問と、「育児中の社員は在宅勤務を増やせますか」のような質問では、適する検索が異なります。
原因5|取得件数を増やしすぎている
検索結果を多く渡せば安心に見えます。しかし、関係の薄い文書まで生成AIへ渡すと、回答の焦点がぼやけます。反対に、取得件数を絞りすぎると、例外条件や関連規程を落とします。
Microsoftの評価ガイドでは、回答の完全性と取得情報の利用度を組み合わせて判断しています。必要な情報が足りなければ取得範囲を広げ、不要な情報が多ければ絞るという考え方です。
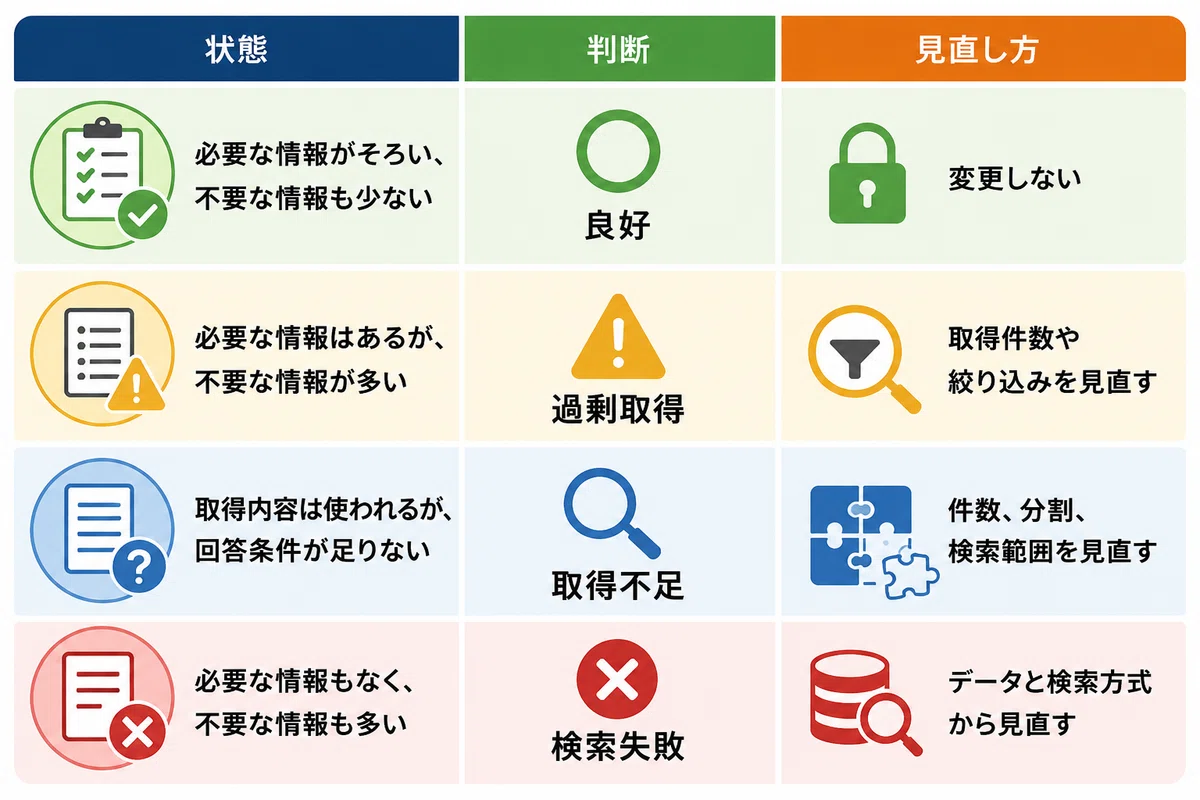
数値を先に固定するのではなく、質問群に対して最も安定する設定を選びます。
原因6|回答指示が検索結果の使い方を定めていない
正しい情報を取得しても、生成AIへ渡す指示が曖昧なら、一般知識を混ぜたり、複数文書を誤って結びつけたりします。
少なくとも次のルールを決めます。
回答は、提示された社内資料の範囲で作成してください。
根拠が見つからない場合は、推測せず「資料から確認できません」と回答してください。
回答には、参照した文書名と該当箇所を示してください。
複数の文書が矛盾する場合は、結論を断定せず、文書名と相違点を示してください。
金額、日付、対象者、例外条件は省略しないでください。ただし、プロンプトで禁止すれば必ず守られるわけではありません。検索結果、出典表示、回答後の検証、人の承認を組み合わせます。「生成AIのハルシネーションを防ぐ方法」でも、RAGを使っても誤回答がゼロになるわけではない理由を解説しています。
原因7|評価用の質問がない
開発担当者が数問試し、「前より良くなった気がする」で終えると、改善したか判断できません。質問を変えるたびに結果が変わるため、設定Aと設定Bの比較もできなくなります。
実際の利用者が聞く質問を集め、期待する根拠と回答条件を付けたテストセットを作ります。
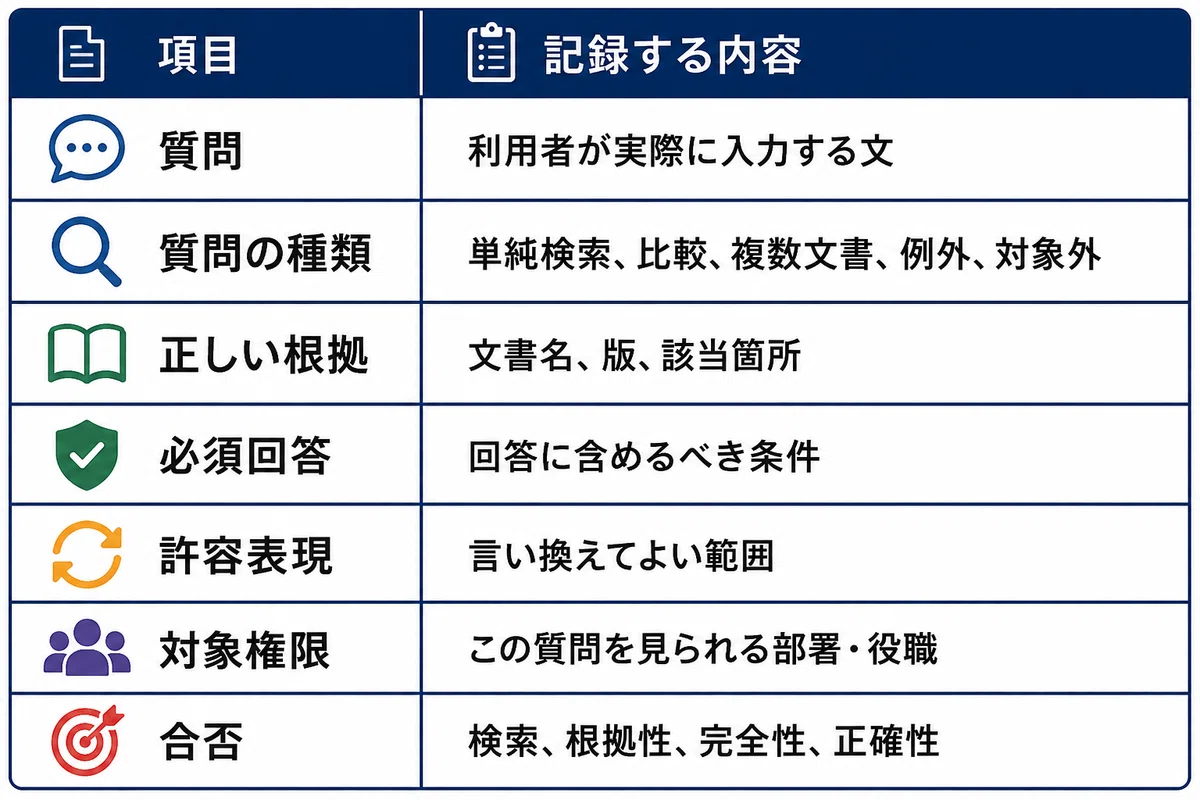
Microsoft FoundryのRAG評価機能でも、検索工程と最終回答を分け、Retrieval、Groundedness、Relevance、Response Completenessなどで評価します。専用サービスを使わない場合でも、この分け方は表計算シートで再現できます。
AI導入サービスの比較や、社内AIの改善範囲を整理したい方へ
RAGの精度、権限、運用担当、PoCの判定項目を整理したサービス資料をご用意しています。
▶️ AIworkerのサービス資料をダウンロードする
RAGの精度を改善する実務手順
改善は、変更しやすい場所から手当たり次第に進めるのではなく、原因を絞って1項目ずつ比較します。
1つ目|失敗した質問を集める
利用ログ、問い合わせ、現場へのヒアリングから、うまく答えられなかった質問を集めます。開発者が考えた質問だけでは、略称、曖昧な表現、現場固有の言い回しが不足します。
質問は次のように分類します。
文書に答えが明記されている質問
複数の文書を組み合わせる質問
部署や役職で答えが変わる質問
例外条件を含む質問
文書に答えがない質問
回答してはいけない質問
「答えがないときに、答えがないと言えるか」も精度の一部です。
2つ目|正しい根拠が取得されたかを見る
最終回答を読む前に、検索結果を確認します。
正しい文書が検索対象に存在するか
正しい箇所が分割後のデータに残っているか
正しい箇所が検索結果へ入ったか
上位に並んでいるか
生成AIへ渡されたか
正しい箇所が取得されていないなら、プロンプトやモデルを変更する段階ではありません。
3つ目|失敗を工程へ割り当てる
失敗を「回答が悪い」でまとめず、担当する工程を決めます。
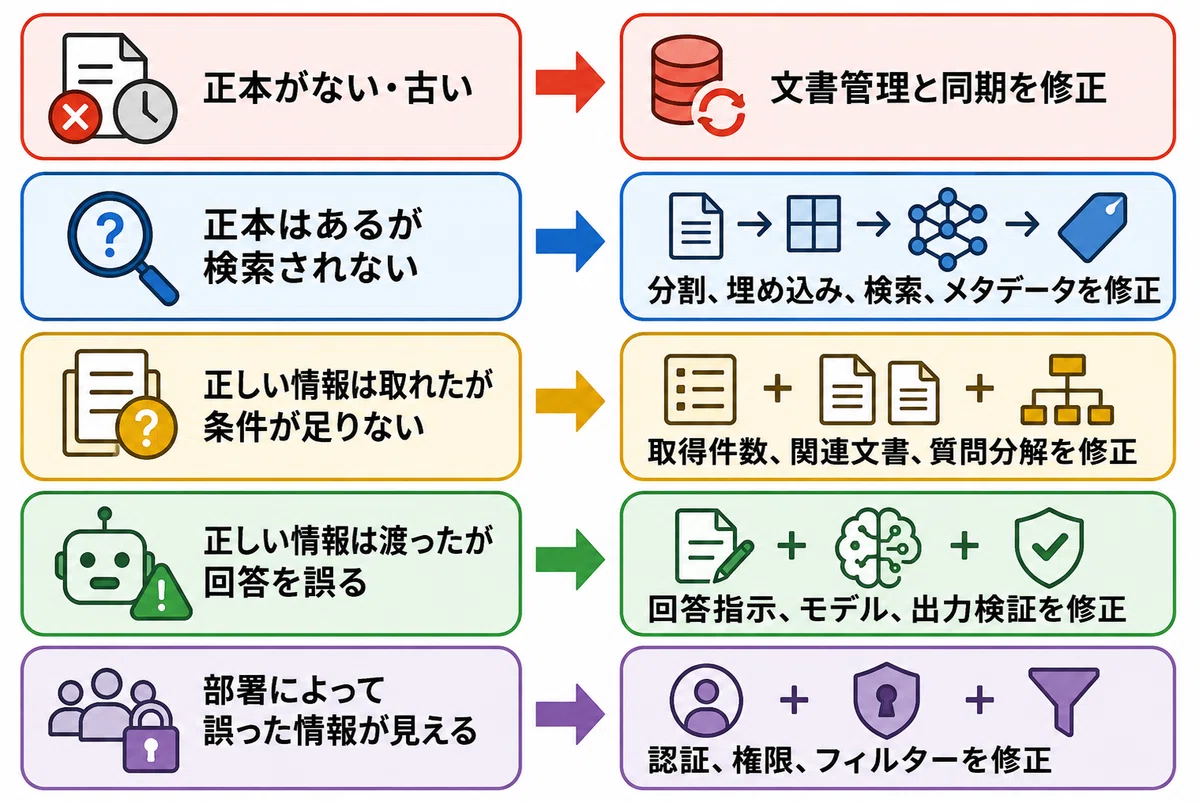
4つ目|一度に1つだけ変更する
チャンク、検索方式、取得件数、プロンプト、モデルを同時に変えないでください。 何が効いたか分からなくなるため、設定と結果を記録し、1つずつ比較します。
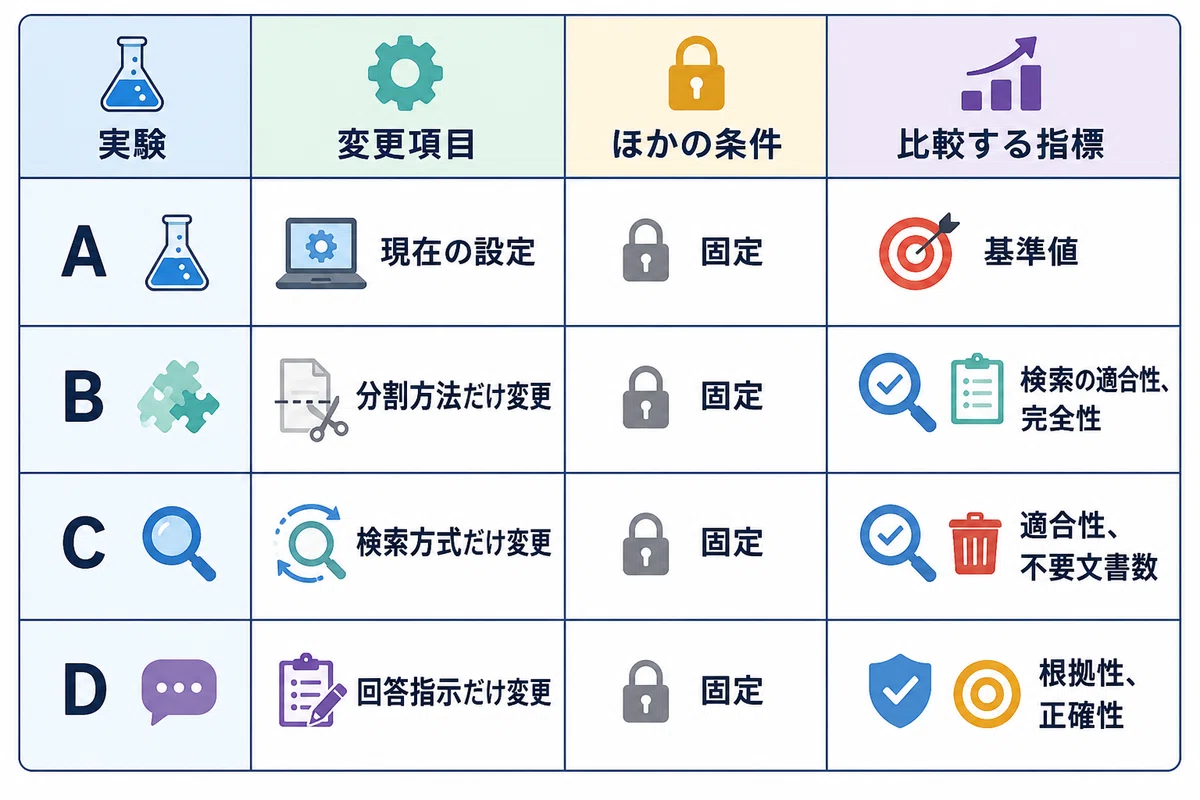
モデル変更は費用と回答傾向の両方を変えます。検索側を評価した後に比較すると、モデルへ支払う追加費用が本当に必要か判断できます。
5つ目|同じ質問群で再評価する
改善前後で同じ質問を使います。全体平均だけでなく、質問の種類別にも結果を見ます。
単純な社内検索は改善したか
複数文書の質問は改善したか
例外条件を落としていないか
答えがない質問で推測しないか
権限外の情報を返していないか
回答時間と利用費用が悪化していないか
精度を上げるために検索件数を増やし、回答時間と費用が大きく増えることもあります。品質、速度、費用を同時に記録してください。
6つ目|本番ログからテストセットを更新する
テストセットは完成品ではありません。新しい規程、新商品、組織変更、利用者の質問傾向に合わせて更新します。
Microsoftの評価ガイドも、文書と利用者の質問は時間とともに変わるため、評価を繰り返す必要があると説明しています。月次や文書更新時に、失敗質問をテストセットへ追加する運用が現実的です。
よくある改善策が効かない理由
とりあえず高性能なモデルへ替える
正しい文書を取得できていなければ、高性能なモデルも正解を知りません。検索結果が同じなら、文章が自然になるだけで誤りが見つけにくくなることもあります。
まず検索結果を確認し、正しい情報が渡っているのに回答生成で失敗している場合にモデルを比較します。
文書をすべて登録する
文書数を増やすほど、類似した旧版、下書き、重複資料も増えます。検索対象は多ければよいのではなく、正本、有効期間、対象部署、管理責任者が分かる状態が必要です。
チャンクを細かくする
細かくすれば検索しやすくなるとは限りません。条件と例外、表と注記、質問と回答が離れると、回答の完全性が下がります。文書ごとの構造に合わせて分割します。
プロンプトを長くする
指示を増やしても、必要な根拠がコンテキストに入っていなければ答えられません。長い指示の中で優先順位が曖昧になることもあります。回答範囲、根拠表示、答えがない場合、矛盾時の処理に絞ります。
利用者の評価だけで判断する
満足度は重要ですが、詳しい説明ほど高評価になるとは限りません。文章が自然でも根拠が間違っている場合があります。利用者評価と、検索・根拠性・完全性・正確性を分けます。
RAGの精度改善を止める判断も必要
すべての質問へ答えられるRAGを目標にすると、データ整備と評価の範囲が広がり続けます。業務によっては、RAG以外の方法が適しています。
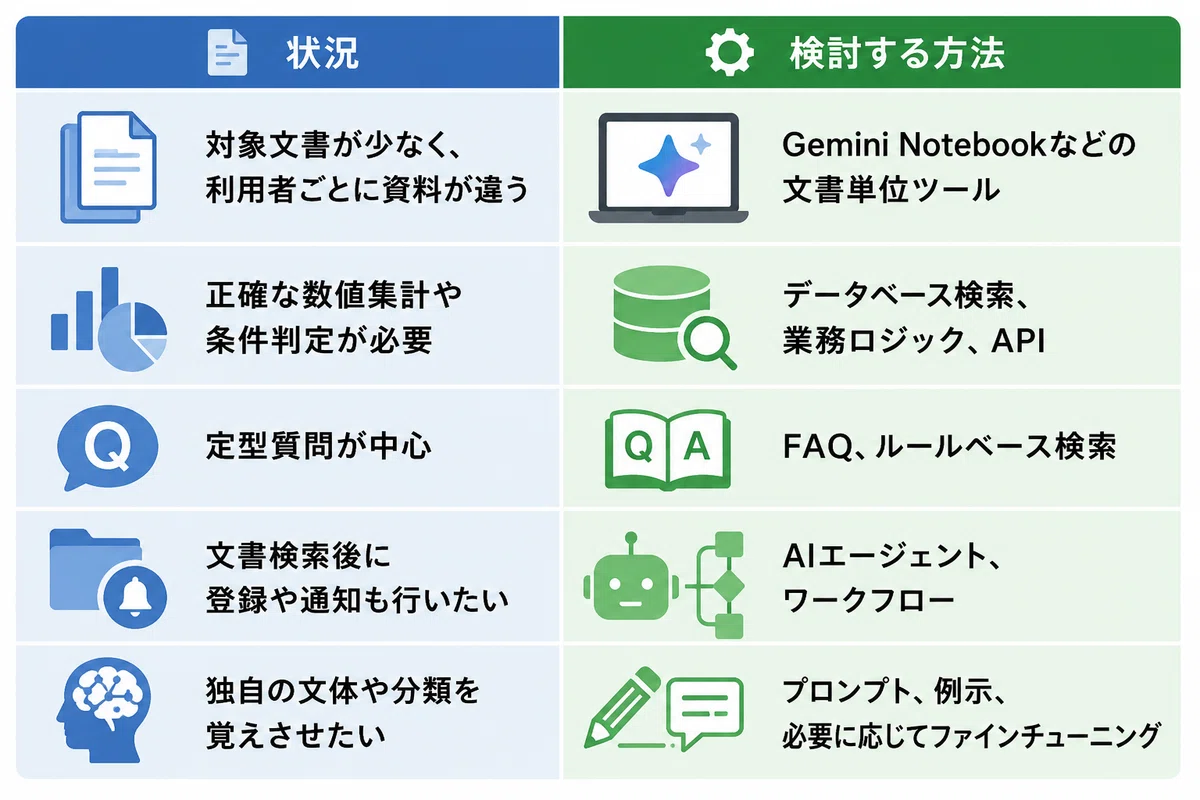
「Gemini Notebookで十分か、社内GPT・RAGを作るべきか」では、既製の文書ツールと個別RAGの選び方を比較しています。精度改善の工数が業務効果に見合わない場合は、構成を簡単にする判断も必要です。
RAGの周囲に複数の処理やツール実行が必要なら、「AIエージェントの作り方・導入手順」も参考になります。検索だけで解決しようとせず、計算や照合は専用の処理へ任せるほうが安定することがあります。
本番運用前のチェックリスト
正式な情報源と更新責任者が決まっている
旧版、下書き、重複文書の扱いが決まっている
PDFの表、注記、画像が正しく抽出されている
文書構造に合った分割方法を選んでいる
固有名詞と自然文の両方で検索を試している
検索結果と最終回答を分けて評価している
実際の質問を使ったテストセットがある
答えがない質問もテストしている
部署・役職ごとのアクセス権を確認している
回答に参照文書を表示している
人が確認すべき回答を決めている
品質、速度、利用費用を記録している
文書更新時の再取り込み手順がある
失敗ログを改善へ戻す担当者がいる
Go・改善・停止の判断日を決めている
独自環境でRAGを構築する場合は、「LlamaIndexとは?RAGの作り方とLangChainとの違い」で、取り込みから評価までの構成を解説しています。オンプレ環境を前提とする場合は、「オンプレ生成AIの要件定義ガイド」も合わせて確認してください。
よくある質問(FAQ)
Q. RAGの精度は何%あれば本番運用できますか?
A. 一律の合格率では決められません。社内規程の案内と、契約判断や医療情報の補助では誤りの影響が違います。質問の種類ごとに、許容できる誤り、人の確認、回答を止める条件を決めてください。平均値だけでなく、重大な質問がすべて合格しているかを見ます。
Q. RAGの精度改善では、最初に何を確認すべきですか?
A. 誤回答が出た質問について、正しい文書が検索対象にあり、その該当箇所が検索結果へ入ったかを確認します。入っていなければデータ、分割、検索を直します。入っているのに回答を誤った場合は、回答指示やモデルを見直します。
Q. チャンクサイズはどのくらいが適切ですか?
A. 文書の種類と質問によって変わります。固定文字数だけで決めず、規程なら条文と例外、FAQなら質問と回答、議事録なら議題と決定事項が離れない単位を試してください。同じテスト質問で複数設定を比較します。
Q. ベクトル検索とハイブリッド検索はどちらがよいですか?
A. 言い換えの多い自然文ではベクトル検索が役立ちます。製品番号、条文番号、略称などの完全一致が重要ならキーワード検索も必要です。企業内文書では両方を組み合わせ、メタデータとリランキングを加える構成が候補になります。
Q. 高性能な生成AIモデルへ替えれば精度は上がりますか?
A. 回答生成が原因なら改善する可能性があります。しかし、検索した文書が間違っていれば、モデルを替えても根本原因は残ります。先に検索結果を確認し、その後で同じ質問と同じコンテキストを使ってモデルを比較してください。
Q. LLMによる自動評価だけで十分ですか?
A. 評価件数を増やす補助にはなりますが、業務上の正解、適用条件、権限、重大な誤りは担当者が確認します。自動評価の判定基準も固定し、定期的に人の判定とずれていないか確認してください。
Q. RAGの改善は内製できますか?
A. 検索結果、ログ、評価データを確認できる担当者がいれば、小さな改善は内製できます。データ抽出、複雑な権限、検索基盤、評価自動化まで関わる場合は、外部支援を使いながら社内へ手順と判断基準を残す方法が現実的です。
RAGを「作って終わり」にしないために|AIworkerの支援
RAGの精度改善では、検索技術だけでなく、正本を管理する部門、実際に質問する利用者、アクセス権を管理する情シス、回答を確認する業務責任者をつなぐ必要があります。AIworkerでは、動いているRAGの診断だけでなく、対象業務、データ、評価、運用担当まで含めて改善範囲を整理します。
AIネイティブX研修|RAGを安全に使い、評価できる人を育てる
利用者向けには、質問の作り方、出典の確認、誤回答を見つけたときの報告方法を扱います。推進担当者向けには、検索結果と最終回答を分ける評価、テストセットの作成、改善記録の残し方まで実際の業務を題材に整理します。研修後も、確認手順と評価用のひな型が社内に残る形にします。
AIネイティブX伴走|失敗ログから改善サイクルを回す
現場の質問と失敗ログを集め、データ、検索、回答、権限のどこを直すべきかを一緒に判断します。月次で品質、速度、利用状況を確認し、文書更新や組織変更にも対応できる運用へ整えます。担当者だけに改善が集中しないよう、部門間の役割も決めます。
業務AIプロ|検索・権限・評価を本番運用に合わせて構築する
既存のRAGで改善が難しい場合は、文書抽出、検索方式、リランキング、出典表示、認証、権限、評価基盤を必要な範囲で構築します。モデルを替える前にボトルネックを診断し、1業務のテストセットで効果を確認してから対象を広げます。構成と評価方法を文書化し、社内で改善を続けられる状態を目指します。
「RAGへ資料を入れたのに回答が安定しない」「PoCを本番へ進めてよいか判断できない」「ベンダーへ何を修正依頼すればよいか分からない」という場合は、現在の質問、検索結果、回答、参照データ、権限、評価方法を確認し、最初に直す工程を整理します。
▶️ サービス資料のダウンロード(資料請求)
▶️ 無料カウンセリング・AI活用診断のご予約
この記事が参考になりましたら、今後の記事づくりの励みになるので、スキをお願いします。
参考資料
Understanding Retrieval Augmented Generation|Amazon Web Services(2026年8月18日閲覧)
Documentation best practices for RAG applications|Amazon Web Services(2026年8月18日閲覧)
Large language model end-to-end evaluation|Microsoft Learn(2026年8月18日閲覧)
Retrieval-Augmented Generation (RAG) evaluators|Microsoft Learn(2026年8月18日閲覧)
Run evaluations from the Microsoft Foundry portal|Microsoft Learn(2026年8月18日閲覧)
#RAG #生成AI #AI #社内AI #社内GPT #RAG精度 #RAG改善 #検索精度 #回答精度 #ハルシネーション #ナレッジ検索 #社内検索 #生成AI活用 #AI活用 #AI導入 #企業AI #法人向けAI #AIエージェント #AI開発 #業務AI #業務自動化 #業務効率化 #業務改善 #DX #DX推進 #PoC #要件定義 #テスト設計 #AI評価 #LLM評価 #ベクトル検索 #ハイブリッド検索 #リランキング #チャンク #埋め込み #データ整備 #権限管理 #AIセキュリティ #AIガバナンス #情報システム
