テンセントなど、世界モデル27種類の「三次元空間の記憶」を検証――Orbia、映像の美しさと空間の正確さは一致せず

[メンバーシップ限定]テンセント傘下のLightSpeed Studios、シンガポール国立大学、浙江大学、香港大学などの国際共同研究チームが、動画生成型世界モデルの三次元空間の一貫性を評価する新たなベンチマーク「Orbia」を開発した。研究論文「Orbia: Do Generated Videos Form a Consistent 3D World?」は、2026年10月14日にarXivで公開された。
今回の研究が取り組むのは、AIが生成した映像がどれほど自然に見えても、その映像の中に一貫した三次元世界が存在しているとは限らないという問題である。
例えば、世界モデルが生成した道路を進み、交差点を曲がり、建物の裏側を回って元の場所へ戻る。
そのとき、最初に存在した建物は、同じ場所に、同じ形状で存在しているだろうか。
途中でAIが生成した道路標識や店舗は、一度視界から消えた後、再び戻ってきたときにも存在しているだろうか。
さらに、異なる位置から生成した複数の映像を組み合わせた場合、一つの矛盾のない三次元空間を再構築できるだろうか。
Orbiaは、こうした問題を体系的に評価するために開発された。
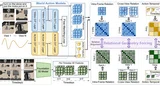
研究チームは、屋内外の720件の評価事例を構築し、カメラの移動と再訪を組み合わせた6種類の評価手順を用意した。
評価対象は、カメラ操作型、行動指示型、テキスト・画像入力型の合計27モデルである。
その結果、映像品質が高いモデルほど三次元空間の一貫性も高いとは限らないことが明らかになった。
また、最初に与えられた空間を保持する能力、AI自身が生成した物体を記憶する能力、複数の視点から矛盾のない三次元構造を生成する能力は、それぞれ異なることも確認された。
今回の研究が示したのは、世界モデルが美しい映像を生成できることと、その映像の中に持続的で整合した三次元世界を構築できることは、別の能力だということである。
自動運転やロボット向けの世界モデルを考えるうえでも、重要な研究である。
世界モデルは、戻ってきた場所を覚えているか
近年の世界モデルは、カメラ映像や自然言語による指示から、連続した未来映像を生成できるようになっている。
例えば、道路を前進する、交差点で右折する、建物の周囲を移動するといった指示に従って、視点が移動する映像を生成する。
こうした技術は、自動運転AIの学習環境、ロボットの行動予測、仮想空間の生成などへの応用が期待されている。
しかし、動画生成AIが自然な映像を生成できることと、その内部に安定した三次元空間を保持していることは同じではない。
ある瞬間の映像だけを見れば、道路や建物は自然に見えるかもしれない。
しかし、カメラが別の場所へ移動し、再び同じ場所へ戻ると、建物の形状が変化していたり、以前は存在しなかった物体が現れたりする場合がある。
また、異なる角度から見た建物の形状が一致しない可能性もある。
こうした問題は、通常の映像品質評価では十分に検出できない。
研究チームは、世界モデルが生成する映像を、単なる連続した画像ではなく、一つの三次元空間を異なる位置から観測した結果として評価する必要があると考えた。
そこで、カメラを移動させた後、同じ場所へ戻る「探索と再訪」を評価の中心に据えた。
Orbiaが評価する三つの能力
Orbiaは、三次元空間の一貫性を三つの能力に分けて評価する。
第一は「Input Preservation」である。
これは、最初に与えられた画像の内容を、世界モデルが正しく維持できるかという評価である。
例えば、最初の画像に建物、道路標識、樹木が写っていたとする。
カメラを移動させてから元の位置へ戻ったとき、それらの物体が同じ場所に存在し、外観や三次元形状が維持されているかを確認する。
第二は「Generated-Content Persistence」である。
これは、世界モデル自身が新たに生成した内容を記憶できるかという評価である。
最初の画像には写っていなかった建物の裏側へ移動すると、世界モデルはその場所の景色を新たに生成する。
その後、別の場所を探索してから同じ場所へ戻ったとき、以前に生成した内容が維持されているかを確認する。
第三は「3D Self-Consistency」である。
これは、異なる視点から生成した複数の映像が、同じ三次元空間を表現しているかという評価である。
例えば、建物を正面から見た映像と、横から見た映像が、それぞれ自然に見えていたとする。
しかし、その二つを三次元的に組み合わせると、建物の奥行きや壁の位置が矛盾している可能性がある。
Orbiaは、こうした矛盾を、奥行き、特徴点の対応、三次元再構築などによって検出する。
重要なのは、三つの能力を同じものとして扱わないことである。
最初の景色を覚えていること、自分で生成した景色を覚えていること、異なる視点で三次元構造が一致することは、それぞれ独立した評価対象なのである。
720件の評価事例、6種類の移動パターンを用意
研究チームは、実際に撮影した映像、公開データセット、シミュレーション環境を組み合わせ、720件の評価事例を構築した。
利用したデータには、ScanNet++、SpatialVID、Sekai、MiraDataなどが含まれる。
さらに、Unreal Engineで構築した48種類の仮想環境も利用した。
元となる11万件以上の候補から評価事例を選び、データの確認や注釈付けには300時間以上を費やした。
評価対象は、屋内と屋外の両方である。
これは重要である。
屋内では、部屋の壁、家具、扉などの位置関係を保持する必要がある。
屋外では、道路、建物、樹木など、より広い空間に存在する物体の位置関係を維持する必要がある。
研究チームは、次の6種類のカメラ移動を設定した。
前進してから後退し、元の位置へ戻る
左右へ移動して元の位置へ戻る
カメラの向きを回転させる
円弧状の経路を移動する
対象物の周囲を回り込む
一度別の場所をのぞき込み、元の位置へ戻る
それぞれの移動パターンは、三次元空間の異なる性質を検証する。
例えば、前進と後退では、距離の変化によって物体の大きさや位置が正しく変わるかを確認できる。
対象物の周囲を回り込む場合には、正面から見た形状と、側面や背面から見た形状が矛盾していないかを検証できる。
さらに、短時間の移動だけでなく、約1分間の探索と再訪も用意した。
720件のうち、480件は約22秒の短時間評価、240件は約1分間の長時間評価である。
長時間評価では、複数回の再訪を行う。
これによって、世界モデルが一度生成した空間を、時間が経過しても保持できるかを検証する。
最初の画像だけでは、三次元空間の正解は分からない
Orbiaの評価で難しいのは、世界モデルへ最初に与える画像が、基本的に一つの視点から観測したものだということである。
例えば、建物の正面を撮影した画像だけでは、建物の裏側がどうなっているかは分からない。
世界モデルは、その裏側を新たに生成する必要がある。
しかし、最初の画像に存在しない部分については、唯一の正解があるとは限らない。
そこでOrbiaは、最初から存在する空間と、AIが新たに生成した空間を区別して評価する。
最初の画像に写っていた領域については、実際に撮影された別視点の画像や奥行き情報を参照できる。
一方、AIが新たに生成した領域については、最初に生成した内容と、再訪時に生成した内容を比較する。
つまり、最初に生成した建物の裏側が、現実の建物と完全に一致しているかを問うのではない。
AI自身が一度作った世界を、その後も同じ世界として維持できるかを評価する。
この区別は、生成型世界モデルを評価するうえで重要である。
Depth Anything 3で、生成映像を三次元的に検査
Orbiaでは、生成された映像から三次元的な情報を取り出すため、Depth Anything 3を利用している。
Depth Anything 3は、画像や映像から奥行きやカメラの位置関係を推定するモデルである。
研究チームは、この推定結果を利用し、異なる視点から見た物体の奥行きや形状が一致するかを検証する。
例えば、ある建物の壁が、最初の視点では10m先に存在していたとする。
別の視点へ移動した後、その壁が三次元的に矛盾する位置へ現れていないかを確認する。
また、画像内の特徴情報を異なる視点間で対応付けることで、同じ物体が一貫した形状で存在しているかを評価する。
さらに、生成映像から三次元空間を再構築し、その空間を別の視点から描画する評価も導入した。
ここでは、3D Gaussian Splattingを利用する。
複数の生成映像から三次元空間を再構築し、再構築に使っていない視点の画像を描画する。
その描画結果と、世界モデルが生成した対応する映像を比較する。
もし、生成映像が一貫した三次元空間を表現していれば、異なる視点から描画した結果も一致しやすい。
逆に、映像ごとに建物の形状や位置が変化していれば、一つの三次元空間として再構築することが難しくなる。
この方法によって、個々の画像が自然に見えるかどうかだけでは検出できない、三次元的な矛盾を評価する。
ただし、Depth Anything 3による奥行き推定にも誤差は存在する。
したがって、Orbiaの三次元評価得点は、生成モデル自身の性能だけでなく、評価に使用した三次元推定モデルの精度にも影響される可能性がある。
27モデルを六つの評価軸で比較
研究チームは、合計27モデルを評価した。
内訳は、カメラ操作や行動指示に対応する世界モデル19種類と、テキスト・画像から動画を生成するモデル8種類である。
評価には、三次元空間の一貫性に関する三つの能力に加え、操作指示への追従、映像品質、時間的な安定性を含めた六つの評価軸を利用した。
総合評価における重みは、操作指示への追従が25%、映像品質が25%、入力空間の保持が10%、生成内容の記憶が10%、三次元的な自己整合性が10%、時間的な安定性が20%である。
つまり、総合得点は三次元空間の一貫性だけを評価したものではない。
映像品質や操作への追従性も含む。
この点を踏まえて、研究チームの比較結果を見る必要がある。