引望智能、世界モデル・言語理解・走行判断を一体化――華中科技大学とDriveWLA開発、NAVSIM v2で90.1

[メンバーシップ限定]華為(Huawei=ファーウェイ)の自動車向けスマート技術事業を継承した、乾崑の実質運営会社である引望智能(Yinwang Intelligent Technology)が、華中科技大学と共同で、世界モデル、言語理解、走行判断を一つのAIアーキテクチャーに統合する「DriveWLA」を開発した。2026年10月13日、研究論文をarXivで公開した。
今回の研究が取り組むのは、自動運転AIが交通状況を理解し、周囲の変化を予測し、実際の走行軌跡を決定するまでの処理を、どのように一体化するかという問題である。
近年の自動運転研究では、カメラ映像から直接走行軌跡を生成するEnd-to-End(E2E)方式に加え、VLM(Vision-Language Model)による交通状況の意味理解や、世界モデルによる未来予測を組み込む研究が進んでいる。
しかし、これらを別々のモデルとして開発すると、相互の情報共有が不十分になったり、予測した未来が実際の走行判断に十分反映されなかったりする問題がある。
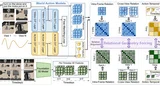
DriveWLAは、三つの専門ネットワークを共通のAIアーキテクチャーに組み込み、相互に情報を交換させることで、この問題に対応する。
研究チームによると、自動運転ベンチマークNAVSIM v1でPDMS 92.3、NAVSIM v2でEPDMS 90.1を記録した。
注目されるのは、単に世界モデルを追加したのではなく、未来予測、交通状況の意味理解、走行判断を相互に連携させる設計を採用した点である。
自動運転AIに必要な三つの能力
自動運転AIには、大きく三つの能力が求められる。
第一は、現在の交通状況を理解する能力である。
周囲にどのような車両や歩行者が存在するのか、道路構造がどうなっているのか、信号機や標識が何を意味しているのかを把握する必要がある。
第二は、これから何が起きるかを予測する能力である。
前方の車両が減速する可能性、隣接車線の車両が割り込む可能性、交差点で歩行者が横断する可能性など、現在の映像だけでは分からない未来の変化を推定する。
第三は、その状況に応じて自車がどう動くべきかを決定する能力である。
減速するのか、停止するのか、車線変更するのか。複数の候補から、安全性と走行効率を考慮して適切な走行軌跡を生成する。
従来の自動運転システムでは、こうした機能を個別のモジュールとして設計する方式が広く利用されてきた。
一方、E2E方式では、センサー入力から走行軌跡までを一体的に学習する。
しかし、E2E方式にも課題がある。
画像から直接走行軌跡を生成するだけでは、交通状況の意味や将来の変化を十分に理解できない場合がある。
反対に、世界モデルやVLMを単純に追加すると、モデル間の情報共有や学習の整合性が新たな課題になる。
DriveWLAは、これらの能力を一つの枠組みで学習することを目指した。
World・Language・Actionの三つの専門ネットワーク
DriveWLAの名称は、World、Language、Actionの頭文字に由来する。
研究チームは、それぞれの機能を担当する三つの専門ネットワークを設計した。
World Expertは、現在の交通状況から将来の環境変化を予測する。周囲の車両や道路環境が今後どのように変化するかを学習する役割を持つ。
Language Expertは、交通状況の意味を理解する。映像から得られる情報を、言語的・意味的な知識と結び付け、複雑な交通場面の解釈を支援する。
Action Expertは、実際の走行軌跡を生成する。周囲の状況、未来予測、交通場面の意味を利用し、自車がどのように動くべきかを決定する。
重要なのは、三つのネットワークが完全に独立して動作するわけではないことである。
DriveWLAでは、共通のTransformer構造の中で、それぞれの専門ネットワークが情報を交換する。
これによって、未来予測で得られた情報を走行判断へ反映し、交通状況の意味理解も同じ判断過程へ組み込む。
「何が起きるか」「それは何を意味するか」「自車はどう動くか」を、一体的に学習する構造である。
Cross-Expert Attentionで三つのAIを連携
DriveWLAの技術的な中心となるのが、「Cross-Expert Attention」である。
三つの専門ネットワークを単純につなぐだけでは、十分な効果が得られるとは限らない。
世界モデルは、将来の映像や環境変化を予測するように学習されている。一方、VLMは画像と言語の関係を理解するように学習されている。
両者は学習目的が異なるため、内部で表現される情報も異なる。
DriveWLAでは、Mixture-of-Transformers(MoT)と呼ばれる構造を利用し、それぞれの専門ネットワークを維持したまま、Transformerの各層で情報を交換する。
ただし、情報を無制限に共有するわけではない。
World ExpertとLanguage Expertは双方向に情報を交換する。これによって、未来予測と交通状況の意味理解を相互に補完する。
一方、Action Expertは両者の情報を参照して走行軌跡を生成するが、Action Expert側の情報はWorld ExpertやLanguage Expertへ逆流しない。
つまり、世界モデルと言語モデルは互いに情報を交換し、その結果を走行判断モデルが利用するという構造である。
この情報の流れを制御することで、異なる目的で学習されたAIモデルの知識を、走行判断に適した形へ統合している。
世界モデルは未来映像を毎回生成しない
今回の研究には、もう一つ重要な工夫がある。
DriveWLAのWorld Expertは、走行映像で事前学習された動画生成モデルを基礎としている。
しかし、実際の走行判断時に、未来の映像を最後まで生成するわけではない。
現在と過去のカメラ映像を内部表現へ変換し、将来の環境変化に関する特徴を抽出する。
その未来予測情報を、Action Expertが走行軌跡の生成に利用する。
動画生成モデルを利用する世界モデルでは、未来映像を繰り返し生成する処理が計算負荷になる場合がある。
DriveWLAは、動画生成モデルが内部で獲得した未来予測能力を利用しながら、未来映像そのものの生成・復元処理を省略する。
また、Language Expertでも、判断理由を文章として逐次生成する方式は採用していない。VLMの内部特徴を直接利用している。
したがって、今回の研究は、世界モデルとVLMの能力を走行判断へ組み込む一方、映像や文章を明示的に生成する負担を抑える構造となっている。