引望智能、AIの3D空間理解と4D動作理解を統合――DynThinker、二つの能力の干渉を抑制

[メンバーシップ限定]華為(Huawei=ファーウェイ)の自動車向けスマート技術事業を継承した、乾崑の実質運営会社である引望智能(Yinwang Intelligent Technology)が、中山大学深圳校、南洋理工大学、MBZUAIなどと共同で、三次元空間の理解と、時間とともに変化する四次元の動作理解を一つのAIモデルへ統合する「DynThinker」を開発した。2026年10月14日、研究論文をarXivで公開した。
今回の研究が取り組むのは、マルチモーダル大規模言語モデル(MLLM)に異なる空間理解能力を学習させた際、それぞれの能力が互いに干渉するという問題である。
AIが現実世界を理解するには、物体の位置や形状を三次元空間で把握する能力が必要になる。しかし、現実世界は静止していない。自動車や歩行者、ロボットのアームなどは時間とともに動くため、空間構造だけでなく、その変化も理解しなければならない。
研究チームは、静的な3D空間理解と、時間を含む動的な4D理解を一つのモデルで学習すると、一方の能力を高める学習が、もう一方の能力を低下させる場合があることを確認した。
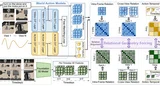
DynThinkerは、この問題に対して、学習時のパラメータ更新を制御する「D-EMA」と、空間情報と時間情報を統合する「Spatial-Dynamic Fusion」を組み合わせた。
研究チームによると、静的3Dと動的4Dを含む9種類のベンチマーク、計10指標で評価し、複数の主要指標で従来のオープンモデルを上回った。
今回の研究の核心は、AIに新しい空間理解能力を追加する際、すでに獲得した別の能力を失わないようにすることである。
自動運転やロボットのように、三次元空間と時間的な変化の両方を理解する必要があるPhysical AIにとって、基礎的な意味を持つ研究である。
静的3Dと動的4Dは、何が違うのか
三次元空間の理解とは、物体がどこにあり、どのような形状を持ち、互いにどのような位置関係にあるかを理解する能力である。
例えば、道路の右側に駐車車両があり、その手前に歩行者がいるという状況を考える。
静的3D理解では、駐車車両や歩行者の位置、道路との距離、カメラから見た奥行きなどを推定する。
一方、動的4D理解では、時間の経過とともに、それらの位置関係がどう変化するかを把握する。
歩行者が道路へ踏み出した場合、その移動方向や速度、周囲との位置関係の変化を理解する必要がある。
さらに、自車が動いている場合には、カメラの移動によって物体の見え方も変化する。
つまり、動的4D理解では、物体そのものの移動と、観測者であるカメラの移動を区別することも重要になる。
これは、自動運転における交通環境の理解だけでなく、ロボットが物体をつかんだり、移動させたりする際にも必要な能力である。
ただし、DynThinkerが扱う4D理解は、主に映像から時間的な変化や三次元的な位置関係を推論する能力である。
未来の交通環境を長時間にわたって生成する世界モデルや、走行軌跡を直接出力する自動運転VLAとは異なる。
3D理解を強化すると、4D理解が低下する
研究チームが最初に確認したのは、空間理解AIの学習における能力の干渉である。
基礎モデルには、Alibaba系のQwen3-VLなどを利用した。
研究チームは、三次元空間理解を強化したGeoThinkerと、学習前のVLMを比較した。
その結果、三次元空間の理解能力が向上する一方で、動的な映像理解能力が低下する現象を確認した。
特に興味深いのは、学習前のモデルと学習後のモデルのパラメータを、異なる比率で混合した実験である。
三次元空間理解を強化したモデルの比率を高めると、静的3Dベンチマークの得点は改善した。
しかし、動的4Dベンチマークの得点は反対に低下した。
しかも、3D理解の改善が頭打ちになった後も、4D理解の低下が続く場合があった。
つまり、単純に三次元空間理解の学習を強化し続けても、総合的な空間理解能力が向上するとは限らない。
研究チームは、この現象を「Spatial-Dynamic Interference」と呼んでいる。
日本語では、空間理解と動的理解の干渉と捉えられる。
一つの能力を高める学習が、別の能力に必要な知識まで書き換えてしまう可能性があるという問題である。
問題はAIモデル全体ではなく、特定の層に集中
研究チームは、さらに一歩進んで、AIモデルのどの部分で干渉が発生しているのかを調べた。
Transformerは、AttentionやMLPなどの複数の処理層から構成される。
MLPは、多層パーセプトロンと呼ばれるネットワークであり、Transformer内部の特徴情報を変換する役割を持つ。
研究チームは、三次元空間理解を強化したモデルの一部パラメータを、学習前の状態へ戻す実験を行った。
その結果、MLPの後段部分にあるパラメータを学習前の値へ近づけると、低下していた動的4D理解能力が大きく回復することが分かった。
一方、その操作によって、強化した三次元空間理解能力の一部は失われた。
この結果は、二つの能力の干渉が、AIモデル全体に均等に分布しているわけではないことを示している。
特定のパラメータ群が、静的3Dと動的4Dの能力のバランスに大きく影響しているのである。
研究チームは、特に初期の4層より後に位置するMLP群の変化が重要であると分析した。
この発見が、DynThinkerの第一の技術であるD-EMAにつながっている。
D-EMA――学習した知識を、すべて同じように更新しない
D-EMAは、「Decoupled Exponential Moving Average」の略である。
EMAは指数移動平均を意味し、AIの学習中に更新されるパラメータを、過去の値も考慮しながら平均化する方法である。
通常の学習では、モデルのパラメータは新しい学習データに応じて更新される。
しかし、新しい能力を強化するためにパラメータを大きく変更すると、以前に獲得した別の能力が失われる可能性がある。
EMAを利用すると、過去のパラメータの影響を残しながら、新しい学習結果を取り込むことができる。
ただし、従来のEMAでは、モデル内の異なるパラメータ群に対して、同じ平均化の強さを適用することが多い。
DynThinkerでは、この方法を変更した。
能力の干渉が大きいパラメータ群には、過去の状態をより強く保持する設定を適用する。
一方、干渉が小さいパラメータ群には、新しい学習による変更を比較的大きく許容する。
つまり、守るべき知識を持つ部分と、新しい能力を獲得する部分を区別して学習するのである。
D-EMAは、パラメータを完全に固定する方式ではない。
学習中の更新は継続しながら、評価に利用するパラメータの時間的な平均化を調整する。
これによって、既存の能力を保持しながら、新しい空間理解能力を獲得しようとしている。
また、研究チームは、学習ステップ数が変わっても同等の平均化効果を維持できるように、EMAの係数を調整する仕組みも導入した。
D-EMAだけで、低下した4D理解が回復
研究チームは、D-EMAの効果を確認するため、同じ学習条件で構成要素を比較した。
Qwen3-VL-4Bを基礎モデルとした場合、学習前のVSI-Benchは54.90、VLM4Dは57.10だった。
これに対して、従来のGeoThinker方式で追加学習すると、VSI-Benchは51.31、VLM4Dは45.20となった。
この条件では、静的3Dと動的4Dの両方で性能が低下している。
ここへD-EMAを追加すると、VSI-Benchは53.14、VLM4Dは53.57まで回復した。
特にVLM4Dでは、45.20から53.57へ8.37ポイント改善した。
この結果は、D-EMAが学習時の能力干渉を抑えるうえで有効であることを示している。
ただし、D-EMAだけでは、静的3Dと動的4Dの両方を十分に高められたわけではない。
そこで研究チームは、二つの能力を同時に強化するため、もう一つの技術を導入した。
それがSpatial-Dynamic Fusionである。
Spatial-Dynamic Fusion――三次元構造と時間変化を別々に抽出
Spatial-Dynamic Fusion(SDF)は、三次元の空間情報と時間的な変化をVLMの内部へ統合する仕組みである。
研究チームは、外部の動的幾何学モデルとして「VDPM」を採用した。
VDPMは、複数フレームの映像から、三次元空間の構造と時間的な変化を推定するモデルである。
その内部には、二種類の情報が存在する。
一つは、三次元の形状や位置関係を表す空間的な特徴である。
もう一つは、時間の経過に伴う変化を表す動的な特徴である。
DynThinkerは、この二つを別々に抽出する。
空間的な特徴は、物体の形状や位置関係を理解するために利用する。
動的な特徴は、物体やカメラの移動によって、三次元空間がどのように変化するかを理解するために利用する。
そして、VLMが持つ意味情報を参照しながら、それぞれの特徴をどの程度利用するかを調整する。
例えば、画像に写る物体の位置関係を問う質問では、空間的な特徴が重要になる。
一方、映像の中で物体がどの方向へ移動したかを問う質問では、時間的な特徴が重要になる。
DynThinkerでは、こうした違いに応じて、二種類の情報を選択的に統合する。
重要なのは、三次元構造と時間変化を一つの特徴へ単純に混合するのではなく、別々の情報として保持しながら利用することである。