中国AIV、実車で走る前に「世界」を作り始めた――哈囉系HelloWorld、7カメラ+LiDARまで生成

[日刊]中国の自動運転AI開発で、実車を道路に走らせてデータを集めるだけではない競争が本格化し始めた。AIが走るための「世界」そのものを、AIで生成する競争である。
2026年9月24日、arXivに自動運転向け世界モデル「HelloWorld」に関する論文が公開された。正式名称は「HelloWorld: Towards Practical Applications of Generative Driving World Models」。
著者群には上海交通大学と中国モビリティ企業Hello Inc.(哈囉出行) の自動運転研究者と重なるメンバーが多数含まれる。
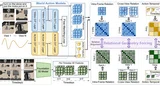
約20億パラメータの生成型世界モデルで、単に前方の走行映像を生成するのではなく、車両を取り囲む7台のカメラ映像を同期して作り、さらにLiDARの点群データまで生成する。
狙っているのは、見栄えの良い「AI動画」ではない。
現実にはまだ走っていない道路状況や車両の動きを作り、その仮想世界の中で自動運転AIを学習・評価するための基盤である。
実車で遭遇していない状況は、実車データには存在しない
現在の自動運転開発を支えている最大の資産の一つが実走行データである。多数の車両を道路に走らせ、カメラやLiDARなどからデータを集め、それを使って認識やPlanning、End-to-Endモデルを学習させる。
しかし、実走行データには根本的な限界がある。
記録されているのは、実際にそのクルマが走った軌跡と、そのとき偶然存在していた交通環境だけだからである。
同じ交差点で自車が違う進路を取ったら何が見えたのか。前方車両が突然停止したらどうなったのか。歩行者が違うタイミングで道路に出てきたらどうなったのか。
現実に起きなかったことは、走行ログには残らない。
HelloWorldが狙うのは、この制約を生成AIによって突破することである。
既存の走行ログを再生するのではなく、「もし別のことが起きていたら」という反実仮想の交通世界を生成する。
自動運転AIは、現実世界で危険な状況が十分な回数発生するのを待つ必要がなくなる可能性がある。
HelloWorldは「映像生成AI」から出発する
HelloWorldは約20億パラメータの世界モデルで、基盤にはNVIDIAの世界モデル「Cosmos-Predict2.5」を利用している。
ただし、一般的な動画生成モデルをそのまま自動運転に使うわけではない。
まず幅広い動画から、物体の見え方や動き、カメラ移動などの一般的な視覚・運動の知識を学び、その後、自動運転に必要な構造化された情報を段階的に与えていく。
HelloWorldが入力として扱うのは、自車の位置・姿勢、HDマップ、周囲の車両などを表す3Dボックスである。
これによって「カメラから見える世界」を作るだけでなく、「自車をこちらへ動かす」「周囲の車両配置を変える」といった条件を与え、それに応じた世界を生成できるようにする。
一般的な生成AIとの決定的な違いはここにある。
必要なのは、それらしい道路映像ではない。指定された自車の動きや道路構造、交通参加者の配置に従って、物理世界として整合した観測結果を生成することである。
7台のカメラを同時に生成する
HelloWorldの特徴の一つが、同期した7カメラ映像を生成することである。
一般的な動画生成AIであれば、一つの視点から見た映像が自然であればよい。
しかしAI Vehicle(AIV)ではそうはいかない。
実際の車両には前方、側方、後方など複数のカメラが搭載されている。それぞれのカメラは異なる方向を向いているが、当然ながら見ている現実世界は一つである。
前方カメラに映っていた車両が横方向へ移動すれば、次には側方カメラに現れなければならない。道路、建物、歩行者、他車なども、各カメラの位置関係に従って整合していなければならない。
HelloWorldは、固定された車載カメラの位置関係を前提として、7方向の映像を同期生成する。
これは「きれいな360度動画を作る」という話ではない。
実際の自動運転システムに近いセンサー構成の入力を、生成AI側から作り出そうとしている。