北京大学・NVIDIA、ロボットAIに「動作を表す言葉」を導入――PhysWord、長時間操作の成功率99.6%

[メンバーシップ限定]北京大学、NVIDIA、カリフォルニア大学バークレー校の共同研究チームが、ロボットAIに「つかむ」「置く」「押す」「回す」といった動作を表す言葉を組み込み、言語による推論と物理世界の状態予測を結び付ける新技術「PhysWord」を開発した。
研究論文「Physical Words: A Vocabulary for Structuring Latent Reasoning in Robot Manipulation」は、2026年10月19日にarXivで公開された。
今回の研究が取り組むのは、ロボットが作業の目的を言葉として理解していても、その作業を実行する過程で、物体がどのように動き、いつ接触し、次に何をすべきかを正確に予測することは難しいという問題である。
例えば、人間がロボットへ「机の上にある紙を取って、別の場所へ置いてください」と指示したとする。
ロボットは、紙を取るという作業の意味を理解できるかもしれない。
しかし、薄い紙を机から持ち上げるためには、指をどこへ近づけ、どのように接触させ、どの時点で持ち上げるかを判断する必要がある。
また、一枚の紙を移動させた後、次の紙が置かれた場合には、作業が新しい段階へ移ったことを認識しなければならない。
従来のロボットAIでは、言語モデルによって作業手順を推論する方法と、将来の映像や触覚などをAI内部の特徴情報として予測する方法が研究されてきた。
しかし、言語による推論は物理的な変化を細かく表現しにくく、内部特徴による予測は、異なる場面に共通する動作の意味を整理しにくいという課題がある。
PhysWordは、この二つを結び付けた。
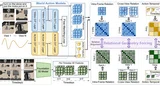
研究チームは、16種類の基本動作を表す言葉を用意し、それぞれの言葉に、将来の映像や触覚の変化を表す内部特徴を対応付けた。
ロボットは、次に実行する動作を生成する前に、これから起こる動作の段階と、その結果として生じる物理的な変化を予測する。
この方法によって、視覚と触覚を利用するロボット操作ベンチマーク「UniVTAC」で平均成功率90.3%を記録した。
さらに、視覚情報を利用する長時間操作ベンチマーク「LIBERO-Long」では99.6%を達成した。
実際のロボットを利用した4種類の作業でも、平均成功率71.7%を記録した。
今回の研究が示したのは、ロボットAIに必要なのは作業を言葉で説明する能力だけではなく、その言葉が表す動作と、現実世界で起こる変化を結び付ける能力だということである。
ロボットは「何をするか」を理解しても、「どう変化するか」を理解できるとは限らない
近年のVLA研究では、カメラ映像と自然言語による指示から、ロボットの操作指令を直接生成する方法が進んでいる。
例えば、ロボットが「赤い物体をつかむ」という指示を受けた場合、カメラ映像から赤い物体を識別し、その位置へ手を移動させる。
このような技術によって、従来は作業ごとに専用のプログラムが必要だったロボット操作を、自然言語で指示できるようになりつつある。
しかし、実際の物体操作では、単に目的の物体を認識するだけでは不十分である。
物体に近づく、接触する、つかむ、持ち上げる、移動する、置くという一連の過程では、周囲の状態が連続的に変化する。
特に、物体に触れる瞬間や、つかんだ物体を持ち上げる瞬間には、わずかな操作の違いが成功と失敗を分ける。
そこで研究されてきたのが、ロボットが行動する前に、将来の状態を予測する方法である。
一つは、言語を利用する方法である。
AIが「近づく」「つかむ」「持ち上げる」といった作業手順を推論し、その結果に基づいて動作を生成する。
もう一つは、世界モデルなどを利用して、将来の映像や物体の状態を内部特徴として予測する方法である。
言語による推論は、作業の意味や段階を表現しやすい。
一方、内部特徴による予測は、物体の位置や接触状態など、言葉だけでは表現しにくい情報を扱いやすい。
PhysWordは、両者を別々に利用するのではなく、一つの動作表現として結び付ける。
16種類の「Physical Words」を定義
研究チームは、ロボットの物体操作を構成する基本的な動作として、16種類の言葉を設定した。
移動に関する2種類
Approach(近づく)、Move(移動する)
物体操作に関する14種類
Pick(つかんで持ち上げる)、Place(置く)、Flip(裏返す)、Rotate(回す)、Toggle(切り替える)、Open(開ける)、Close(閉じる)、Push(押す)、Pull(引く)、Insert(挿入する)、Press(押し込む)、Click(クリックする)、Strike(打つ)、Handover(受け渡す)
これらの言葉は、ロボットが実行する作業の基本単位として利用される。
例えば、机の上の物体を別の場所へ移す場合には、「近づく」「つかむ」「移動する」「置く」という一連の動作に分解できる。
重要なのは、PhysWordが、これらの言葉を単なる作業ラベルとして利用しているわけではないことである。
それぞれの言葉には、実際の作業場面に応じたAI内部の特徴情報が対応付けられる。
例えば、同じ「つかむ」という言葉でも、紙をつかむ場合と、硬い部品をつかむ場合では、必要な動作や接触状態が異なる。
PhysWordは、「つかむ」という共通の意味を保持しながら、その場面で将来どのような映像や触覚の変化が起こるかを学習する。
つまり、動作を表す言葉が共通の意味を与え、AI内部の特徴情報が、その場面に固有の物理的な変化を表現する。
これが今回の研究の中心的な考え方である。
「つかむ」という言葉に、未来の映像と触覚を結び付ける
PhysWordでは、各動作に視覚情報を利用する表現と、触覚情報を利用する表現を用意した。
例えば、物体をつかむ動作には、視覚に対応する「pick_v」と、触覚に対応する「pick_t」が存在する。
視覚側では、物体をつかんだ後にカメラ映像がどのように変化するかを学習する。
触覚側では、物体に接触した際に、触覚センサーの情報がどのように変化するかを学習する。
この二つは、同じ基本動作を表す言葉から出発するが、異なる感覚情報に対応する内部表現として学習される。
例えば、薄い紙をつかむ場合を考える。
カメラ映像からは、ロボットの指が紙へ近づき、紙が持ち上がる様子を確認できる。
一方、触覚センサーからは、指が紙に接触したことや、把持状態が変化したことを把握できる。
PhysWordは、これらを別々の情報として処理するだけでなく、「つかむ」という動作の意味と結び付ける。
これによって、視覚情報だけでは分かりにくい接触状態も、動作の予測に利用できる。
ただし、PhysWordが物理法則を明示的な数式として学習しているわけではない。
将来の視覚・触覚情報をAI内部の特徴表現として予測することで、動作と結果の関係を学習している。
将来の画像そのものではなく、内部特徴を予測する
PhysWordの学習では、将来の映像や触覚データを利用する。
ただし、動作を表す言葉から、将来の画像を直接生成することが目的ではない。
研究チームは、将来の画像や触覚データをエンコーダーによって数値的な特徴表現へ変換する。
そして、Physical Wordに対応するAI内部の特徴が、その将来の特徴表現と一致するように学習する。
例えば、ロボットが紙へ近づく場面では、「近づく」という動作を表す内部特徴が、その後の映像の特徴と対応するように学習する。
物体をつかむ場面では、「つかむ」という動作を表す内部特徴が、その後の視覚・触覚情報と対応するように学習する。
学習には、動作を表す言葉を正しく予測するための分類損失と、将来の感覚情報の特徴へ近づけるための損失を組み合わせる。
これによって、AIは、単に次の動作の名称を予測するのではなく、その動作によって何が起こるかという情報を内部に保持できるようになる。
なお、実際の推論時には、未来の画像や触覚データが与えられるわけではない。
将来のデータは学習時の正解情報として利用する。
実際にロボットを動かす際には、現在までの観測から、Physical Wordsと将来の状態を予測する。
Qwen3-VLとCosmos-Predict2.5を組み合わせる
PhysWordは、中国の視覚言語モデルとNVIDIAの世界モデル技術を組み合わせている。
研究チームは、言語推論と行動生成の基盤としてQwen3-VL-2Bを採用した。
また、時間的な映像予測には、NVIDIAのCosmos-Predict2.5-2Bを利用した。
Qwen3-VLは、現在の映像や自然言語の指示から、作業の意味や次の動作を推論する役割を担う。
Cosmos-Predict2.5は、映像の時間的な変化を予測するために利用される。
さらに、触覚情報を扱う場合には、既存のFTP-1に由来する触覚処理機構を組み合わせる。
PhysWordでは、言語・行動を扱う部分と、映像の時間的な変化を扱う部分を、それぞれ独立した構造として保持しながら、Attentionによって情報を共有する。
これによって、作業の意味と、映像や触覚の変化を相互に参照できるようにした。
重要なのは、単に二つのモデルを接続したことではない。
両者の間に、Physical Wordsという共通の動作表現を導入したことである。
その結果、AIは、将来の動作の段階を言葉として予測しながら、その段階に対応する物理的な変化も内部で表現できる。
一度に16ステップの行動を考え、4ステップごとに未来を予測
PhysWordでは、将来の動作を一つずつ独立して生成するのではなく、一定の長さを持つ行動のまとまりとして扱う。
今回の実験では、16ステップの行動を一つの予測対象とした。
その中で、4ステップごとにPhysical Wordを予測する。
例えば、最初は「近づく」、次に「つかむ」、その後に「移動する」といった具合である。
これらを時間順に予測し、それまでの予測結果を参照しながら次の動作段階を決定する。
両手を使用する場合には、左右の手について、それぞれ独立した動作の流れを保持する。
そのうえで、予測した動作段階と将来の状態に関する情報を利用し、実際のロボット操作指令を生成する。
研究チームは、動作段階を予測する間隔についても比較した。
2、4、8、16ステップごとの予測を評価し、性能と計算負荷のバランスから4ステップを採用した。
これは、今回のモデルと評価条件で得られた結果であり、すべてのロボットで4ステップが最適という意味ではない。
人間とロボットの操作データ、7400時間以上で事前学習
PhysWordの事前学習には、人間の手による作業と、実際のロボット操作を記録した合計7400時間以上のデータを利用した。
内訳は、人間の手による作業動画が2000時間以上、DROIDが350時間、OpenNeoDataが5000時間以上、Sharpaの操作データが100時間以上である。
視覚情報だけを持つデータと、視覚・触覚の両方を持つデータを組み合わせている。
ここで重要なのが、動作を表す言葉の注釈付けである。
研究チームは、VLMを利用して操作データを基本動作の段階へ分割し、16種類の言葉を割り当てた。
これによって、大量の作業データを、共通する動作の意味に基づいて整理した。
500件の注釈を人手で確認した結果、自動注釈の正確率は95%だった。
ただし、すべてのデータに正しい動作ラベルが付与されたわけではない。
また、PhysWordは人間の手の動きをロボットへ変換する処理を完全に排除したわけではない。人間の手のデータの前処理では、22自由度のロボットハンドに対応させる変換も使用している。
この点では、先日報告したEgoJEPAとは技術的な重点が異なる。
EgoJEPAが、特定のロボットに依存しない動作表現の獲得に重点を置くのに対し、PhysWordは、動作を表す言葉と将来の物理的な変化を結び付け、推論を構造化することに重点を置いている。
LIBERO-Longで成功率99.6%、従来最高を1.2ポイント上回る
研究チームは、まずシミュレーション環境でPhysWordを評価した。
視覚情報を利用するLIBERO-Longでは、10種類の長時間操作タスクを使用した。
PhysWordの平均成功率は99.6%だった。
比較対象の主な結果は、π₀.₅が92.4%、LaST₀が95.6%、Cosmos 3が97.4%、UniWAMが98.4%だった。
今回比較した中で最も高かった既存方式のUniWAMに対し、PhysWordは1.2ポイント上回った。
この結果は、Physical Wordsを利用することで、複数の動作段階を含む作業を高い成功率で実行できたことを示している。
ただし、99.6%はシミュレーション環境の10タスクにおける平均成功率であり、実際のロボットによる成功率ではない。
また、既存方式も98.4%に達しているため、99.6%という数値だけで大幅な技術的飛躍と判断するのは適切ではない。
今回の研究の重要性は、単に成功率を高めたことよりも、言語と物理的な状態予測を結び付ける仕組みを導入し、その有効性を確認したことにある。
触覚を利用するUniVTACでは83.1%から90.3%へ
次に、視覚と触覚を利用するUniVTACで評価した。
このベンチマークには、ボトルの持ち上げ、チューブの挿入、穴への挿入、物体の分類、鍵の引き抜き、HDMI端子の挿入など、8種類の操作タスクが含まれる。
PhysWordの平均成功率は90.3%だった。
従来の最も高い比較対象であるN0-VTLAは83.1%だった。
改善幅は7.2ポイントである。
特に、ボトルを棚へ置く作業では93%、缶を持ち上げる作業では95%を記録した。
一方、HDMI端子の挿入では34%にとどまった。
つまり、触覚を利用する操作全般で高い平均成功率を記録したものの、精密な位置合わせを必要とするすべての作業を解決したわけではない。
また、研究チームは、実際の触覚情報を入力する代わりに、AIが予測した触覚の内部特徴を利用する方法も評価した。
この方式の平均成功率は89.0%だった。
実際の触覚を利用した90.3%との差は1.3ポイントである。
これは、学習した触覚の予測情報が、ロボット制御にも利用できる可能性を示している。
ただし、触覚センサーが完全に不要になったことを意味するわけではない。学習には触覚データを使用しており、評価条件も限定されている。