Huawei関連の引望智能、車載AIの画像処理を2倍高速化――華中科技大学と共同研究、NAVSIM v2で90.8

[メンバーシップ限定]華為(Huawei=ファーウェイ)の自動車向けスマート技術事業を継承した、乾崑の実質運営会社である引望智能(Yinwang Intelligent Technology)が、華中科技大学と共同で、自動運転AIの画像処理を高速化する新たな技術「ConDenseDrive」を開発した。2026年10月12日、研究論文をarXivで公開した。
今回の研究が取り組むのは、自動運転AIが大量のカメラ映像を理解する際の計算負荷である。
近年のEnd-to-End(E2E)自動運転では、画像から走行軌跡までをAIが一体的に学習する方向が進んでいる。しかし、高度な視覚理解能力を持つAIモデルほど、画像を処理するための計算量が大きくなる。
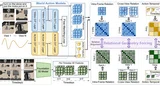
ConDenseDriveは、この問題に対して、複数の画像基盤モデルが持つ知識を一つの軽量な画像エンコーダーへ集約し、さらに走行判断に必要な情報だけを選別する方式を採用した。
研究チームによると、画像エンコーダーの処理速度を2.0倍に高めながら、自動運転ベンチマークNAVSIM v1で94.5、NAVSIM v2で90.8を記録した。
注目されるのは、単にAIモデルを小さくするのではなく、複数の大規模モデルから獲得した知識を維持しながら、車載AIが処理する情報量を削減している点である。
自動運転AIの負担は、走行判断の前から始まっている
自動運転AIでは、カメラが撮影した映像をそのまま走行判断へ利用するわけではない。
まず画像エンコーダーと呼ばれるAIが映像を解析し、車両、歩行者、道路構造、信号機、車線などの情報を抽出する。その結果を利用して、後段のAIが交通状況を理解し、走行軌跡を生成する。
近年のVLM(Vision-Language Model)やE2E自動運転モデルでは、この画像理解に大規模なTransformerが利用されている。
Transformerでは、画像を多数の小さな領域に分割し、それぞれをトークンとして処理する方式が一般的である。
しかし、自動車には複数のカメラが搭載されている。さらに、周囲の物体の動きを理解するためには、一枚の画像だけでなく、過去の映像も利用する必要がある。
その結果、処理すべき画像トークンの数が膨大になる。
画像理解能力を高めようとすれば、モデルの規模や処理量が増加する。一方、単純にトークン数を減らせば、小さな障害物や遠方の車両など、走行判断に必要な情報を失う可能性がある。
ConDenseDriveが解決しようとするのは、この問題である。
画像を理解する能力を維持しながら、AIが実際に処理するトークン数を減らす。
これによって、自動運転AI全体の計算効率を高めようとしている。
三つの画像基盤モデルから知識を集約
ConDenseDriveの第一の特徴は、複数の画像基盤モデルが持つ知識を、一つの画像エンコーダーへ集約することである。
画像を理解するAIには、それぞれ異なる得意分野がある。
一般的な画像基盤モデルは、画像全体の特徴や物体の外観を理解する能力に優れる。
意味理解を重視したモデルは、画像の中に何が存在するか、物体や領域がどのような意味を持つかを捉える。
幾何学的な理解を重視したモデルは、物体の位置関係、奥行き、三次元空間の構造などを扱う。
これらの能力は、自動運転においていずれも重要である。
例えば、前方の車両を認識するだけでは不十分である。その車両がどの位置にあり、周囲の道路構造とどのような関係にあるかを理解する必要がある。
ConDenseDriveでは、三つの画像基盤モデルから視覚的特徴、意味的特徴、幾何学的特徴を抽出し、知識蒸留によって一つの画像エンコーダーへ統合する。
知識蒸留とは、大規模なAIモデルが獲得した能力を、別のモデルへ学習によって移す技術である。
重要なのは、実際の走行時に三つの大規模モデルを同時に動かす必要がないことである。
学習時に複数モデルの知識を集約し、実行時には統合された画像エンコーダーを利用する。
これによって、画像理解能力と計算効率の両立を目指している。
走行判断に重要な情報を「レジスタートークン」へ集約
第二の特徴は、複数カメラと過去の映像から得られる情報を、走行判断に適した形へまとめることである。
ConDenseDriveでは、「レジスタートークン」と呼ばれる特殊なトークンを利用する。
通常の画像トークンが画像内の局所的な情報を表すのに対し、レジスタートークンは、画像全体から走行判断に必要な情報を集約する役割を持つ。
研究では、カメラごと、フレームごとに16個のレジスタートークンを配置した。
さらに、過去のフレームと現在のフレームを結び付け、自車の移動情報も利用して、時間的な変化を理解させる。
これによって、一枚の画像だけでは判断しにくい車両や歩行者の動きも、走行軌跡の生成に反映できるようにする。
重要なのは、このレジスタートークンが、単に画像を要約するためのものではないことである。
最終的な走行判断に必要な情報を集約するよう、End-to-End学習によって最適化されている。
この仕組みが、次のトークン削減技術の基礎となる。
重要なトークンだけを残し、残りは統合
ConDenseDriveの第三の特徴が、レジスタートークンを利用した画像トークンの圧縮である。
画像エンコーダーでは、すべての画像トークンが走行判断に同じ程度重要なわけではない。
例えば、道路上の車両や歩行者、信号機などは重要な情報となり得る。一方、背景の一部には、走行軌跡を決めるうえで相対的に重要性が低い情報も含まれる。
ConDenseDriveでは、レジスタートークンが各画像トークンへ向けるAttentionの強さを利用して、重要度を評価する。
重要度が高いトークンは残し、低いトークンは一つの統合トークンへまとめる。
単純に不要と判断した情報を削除するのではなく、重要度の低い情報も圧縮して保持する点が特徴である。
研究チームは、画像トークンの保持率を変えながら性能と処理速度を評価した。
代表的な設定では、圧縮対象トークンの40%を保持する方式を採用している。
さらに、この選別のために新たな専用AIネットワークを追加する必要がない。すでに走行判断のために学習したレジスタートークンのAttentionを、そのまま利用する。
これによって、トークン選別そのものが新たな計算負荷を生む問題も抑えている。